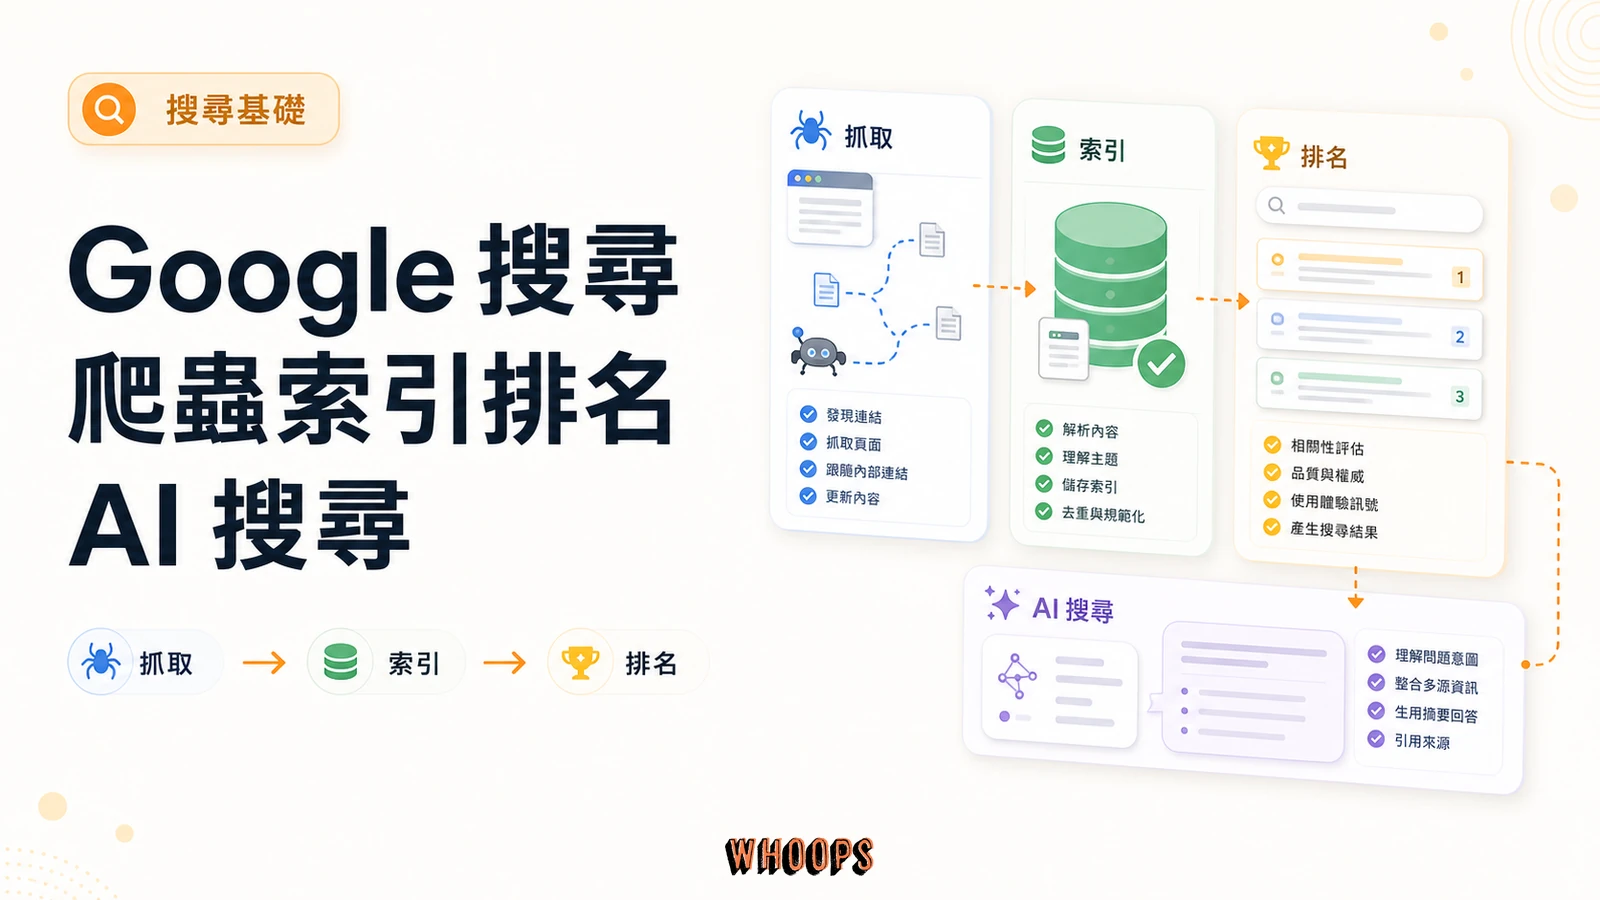
Google 搜尋包含抓取、建立索引、提供搜尋結果三個階段:Googlebot 先發現並下載網頁,Google 再分析內容與標準網址;有人搜尋時,系統從索引中選出與查詢相關的結果並排序。Google 官方搜尋運作說明指出,抓取、索引與顯示都不保證發生。網站搜不到時,先確認卡在哪個階段,才能選對修正方法。
TL;DR:先確認 Google 能否抓取與索引頁面,再評估搜尋內容與排名。Google 不接受付費來增加抓取頻率或提高自然排名,見 官方搜尋運作說明。
Google 搜尋到底是怎麼運作的?先把 3 個階段講清楚
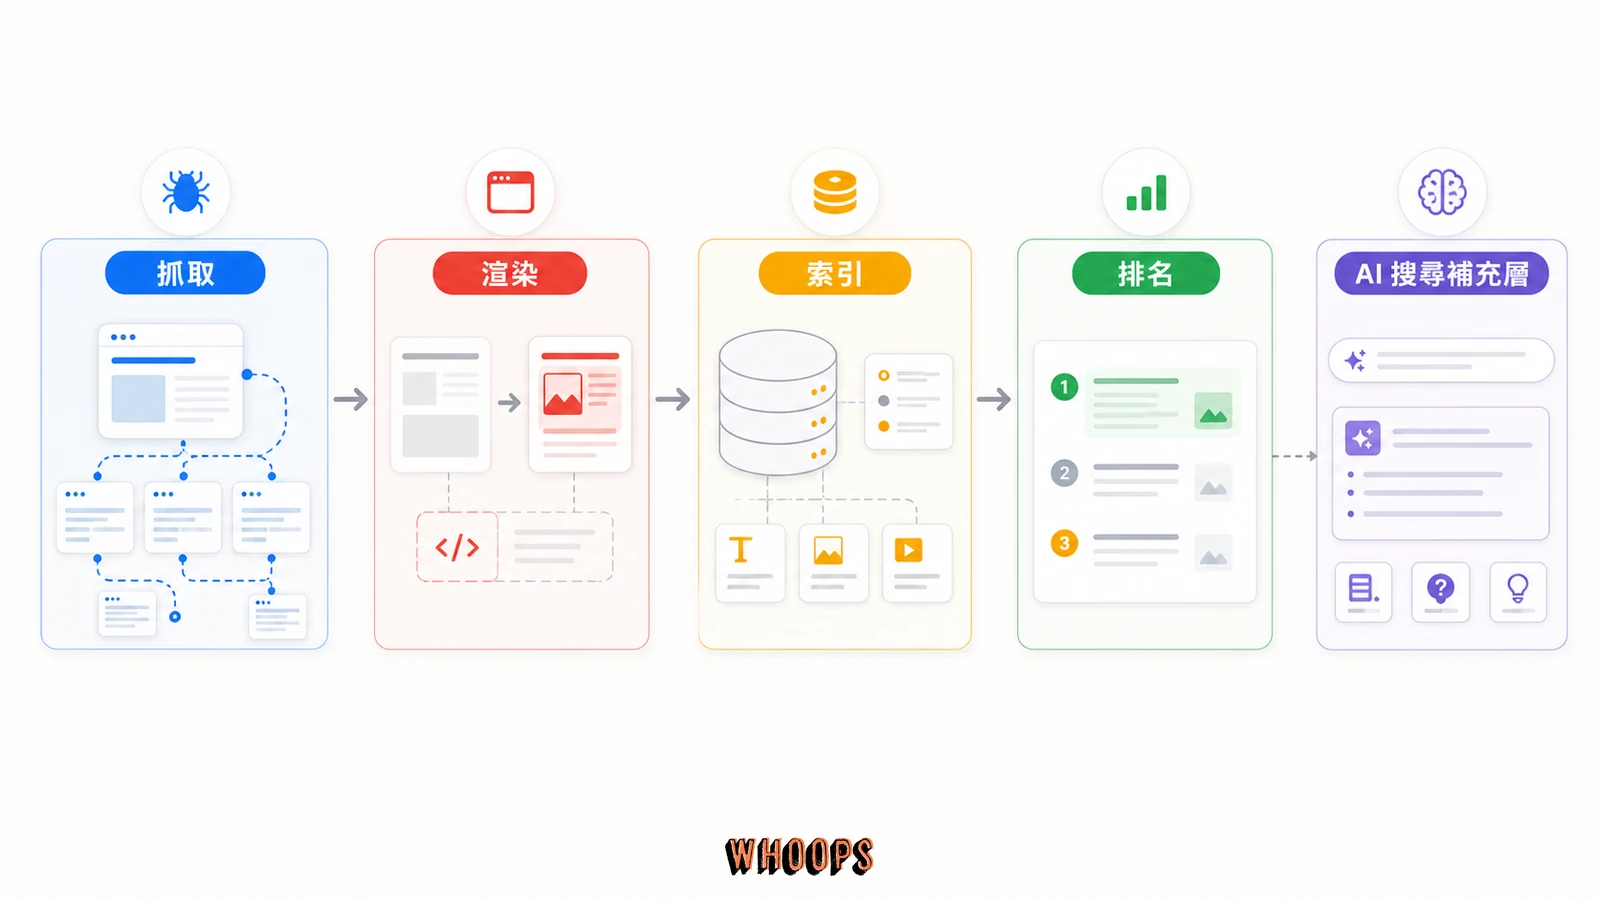
Google 的三個階段由自動化系統執行,不需要站長逐頁人工登錄。抓取階段要解決的是「Google 找不找得到、能不能下載」;索引階段要看「內容能否被理解、哪個網址是正本」;提供搜尋結果時,才會依查詢、內容與情境決定顯示與排序。
可以把索引想成圖書館目錄:書已送到館內,還要完成分類;已在目錄裡,也不表示每位讀者查詢時都會看到它。把這套流程跟 SEO 的運作原理一起看,就能分辨網站需要修正抓取設定、索引問題,還是搜尋意圖與內容。
診斷時先用 Search Console 的網址審查確認狀態。若是「網址不在 Google 服務中」,查看索引原因與抓取資訊;若已索引,再看 Google 選定的 canonical、查詢曝光與排名。不要把「搜尋某個關鍵字看不到」直接當成「Google 沒收錄」。
三階段對照表:一句話定位每個步驟
| 階段 | 在做什麼 | 可檢查與改善的項目 |
|---|---|---|
| 爬蟲(檢索) | Googlebot 沿連結發現並下載頁面 | robots.txt、Sitemap、伺服器穩定度 |
| 建立索引 | 分析內容、判斷主題、存進索引庫 | noindex、canonical、內容品質、渲染結果 |
| 排名 | 從索引挑出相關頁面綜合排序 | 查詢意圖、內容相關性與可靠性、頁面體驗 |
第 1 階段:爬蟲(檢索),Google 怎麼找到你的網站
抓取階段的核心是發現與下載。Google 用 Googlebot 等爬蟲,從已知網址的連結與 Sitemap 發現新網址,再排程下載。回訪頻率會受抓取需求與伺服器容量影響,包括內容變動、頁面品質、受歡迎程度及回應狀態,沒有全站通用的固定週期。
重要頁面應有可抓取的站內連結,並列在 XML Sitemap 中;其他網站的 相關連結也能協助 Google 發現網址。對少量新增或已修改的重要頁面,可在 Search Console 使用網址審查的「要求建立索引」。這些是發現與重新處理的途徑,不保證索引或排名。
robots.txt 控制能否抓取;連結上的 rel="nofollow"、rel="sponsored"、rel="ugc" 則標示連結關係。Google 將這些屬性視為提示,通常不沿這類連結追蹤,但目的頁仍可能從 Sitemap 或其他連結被發現與抓取。需要排除索引時,不能只靠連結屬性,應使用 noindex 並允許抓取。詳見 Google 的連結屬性說明與 nofollow、sponsored、ugc 解析。
新站最常卡的關:沒路可走
新網站可以先驗證 Search Console 所有權,提交 Sitemap,並確認首頁與分類頁能連到重要內容。若頁面只能靠站內搜尋或點按按鈕才能開啟,Google 可能不容易發現它。WordPress 站可搭配 WordPress SEO 最佳化檢查網站導覽與 Sitemap。
重要連結最好使用帶有 href 的 <a> 元素。Google 可以處理 JavaScript 產生的連結,但仍須符合 可抓取連結的規則;只有點擊事件、缺少網址的按鈕,不能當成可靠的發現路徑。檢查 網站架構時,也要確認重要頁面沒有成為孤兒頁。
爬蟲預算:不是每個頁面都會被等比例照顧
爬蟲預算(crawl budget)由抓取容量與需求共同決定。Google 的 官方管理指南主要針對大型、更新頻繁,或大量網址停在「已發現,目前未建立索引」的網站。大量重複參數網址確實可能浪費抓取;應先整併不必要的網址,再評估哪些路徑不需要被抓取,相關問題可對照 容易忽略的技術 SEO 問題。noindex 不能用來節省抓取預算,因為 Google 必須下載頁面才讀得到它;robots.txt 封鎖也不會保證把預算轉給其他頁面。
為什麼 Google 搜不到?先檢查 5 個發現與索引問題
Google 搜不到網站時,先從這五類問題排查:robots.txt 或 CDN 擋住抓取、頁面有 noindex、重要網址缺少發現路徑、伺服器錯誤,以及新網址尚未處理。noindex 屬於索引控制,不是抓取封鎖。開啟 Google Search Console 的網址審查,先看單頁狀態,再用「網頁索引」報表確認是否有同類問題。
網站開發或搬家後,應特別檢查測試環境留下的封鎖設定。不要只看後台勾選框;同一頁面也可能受伺服器回應標頭、SEO 外掛或 CDN 規則影響。
原因 1:robots.txt 封鎖 Googlebot
若適用於 Googlebot 的 robots.txt 規則含有 Disallow: /,就會封鎖整站抓取。先看 Search Console 的 robots.txt 報表,再以網址審查的「測試實際網址」檢查重要頁面。若規則複雜,可搭配 讓 Google 容易理解網站的策略整理需要開放的路徑。
原因 2:頁面或範本被加上 noindex
檢查頁面原始碼的 robots meta,以及 HTTP 回應的 X-Robots-Tag 是否含有 noindex。WordPress 的搜尋引擎可見度設定、SEO 外掛與頁面範本都可能影響輸出。若 GSC 顯示 已建立索引但未包含內容,也要核對抓取是否被阻擋,不能把不同原因都歸為 noindex。
原因 3:重要網址缺少發現路徑
缺少外部連結與 Sitemap 會減少發現機會,但不能據此斷言 Google 一定不知道網站存在。先讓首頁、分類與相關文章用可抓取連結連到重要網址,再提交 Sitemap。建立外部連結應以讀者與主題相關性為目的;不要為了讓爬蟲來訪去購買連結。相關做法可參考 外部連結建立方法。
原因 4:伺服器穩定性差
Googlebot 遇到持續的 5xx、逾時或 429 回應時,可能降低抓取量。先比對伺服器紀錄與 Search Console 抓取統計,再確認 CDN、WAF、主機資源是否影響 Googlebot。網站速度值得改善,但不能只憑主機價格或方案名稱判斷抓取穩定性。
原因 5:網站太新,爬蟲還沒排到
Google 官方表示,要求重新抓取後,處理可能需要數天至數週,仍不保證索引;重複提交同一網址也不會讓抓取更快。可用 要求重新抓取的官方方法追蹤重要網址,並參考 公開提交網址服務的歷史變化。若同時經營 Bing,可另了解支援搜尋引擎的 IndexNow;它不能取代 Google Search Console 的索引要求。
可執行檢查清單
- 用 Search Console 網址審查確認單頁索引狀態與 Google 選定 canonical;
site:僅供輔助查看。 - 開 Search Console 網頁索引報告,看「未編入索引」的原因清單。
- 用 robots.txt 報表與「測試實際網址」確認重要頁面可供 Googlebot 存取。
- 檢查頁面 robots meta 與 HTTP
X-Robots-Tag是否有非預期的noindex。 - 確認 Sitemap 包含希望索引的 canonical 網址,且連結能正常回應;提交不保證索引。
第 2 階段:建立索引,被爬到之後 Google 怎麼看懂你的內容
Google 取得頁面後,會分析文字、圖片、影片等內容,處理重複網址並選出 canonical,再判斷是否建立索引。被抓取不代表一定收錄。若 內容重複而其他版本被選為正本,這個網址可能不獨立索引;也可能因存取、品質或處理進度而暫未索引,應依網址審查顯示的原因判斷。
標題、正文、圖片說明與周圍文字,都能幫讀者與 Google 理解頁面。圖片替代文字要描述圖片內容;meta description可供搜尋摘要使用,並不是直接排名加分項。標題層級應反映內容關係,不需要把同一個關鍵字塞進每個 H2、H3。
Google 的 排名系統說明列出 RankBrain、BERT、神經比對等理解字詞與概念的系統。因此 語意搜尋不只比對頁面有沒有出現某個字;內容要能回答問題、說明條件與差異,重複關鍵字不能取代資訊。
結構化資料:幫 Google 更精準理解內容類型
結構化資料用來描述內容類型,例如文章、產品或食譜;符合 Google 支援功能與規範時,可取得 rich results 的顯示資格,仍不保證顯示或提高點擊率。可從 結構化資料是什麼與 產品結構化資料開始。特別要分清楚:QAPage 適用於單一問題且允許使用者提交答案的頁面,不適用於一般 FAQ 或部落格教學;站內 QAPage 說明也應依此判斷。Google 已於 2026 年 5 月 7 日停止 FAQ rich results,並於 6 月移除文件,見 官方更新紀錄。
未索引時需要檢查的常見狀況
- 頁面與其他網址高度相似,Google 選了其他 canonical,應核對是否符合預期。
- 主要內容不足以解決讀者問題,缺少有用或原創資訊;不能只用字數判斷品質。
- 不符合 Google 搜尋規範,或因其他索引處理原因而未收錄;以 GSC 狀態進一步排查。
- JavaScript 內容在渲染時出錯、被封鎖或需要互動才載入。Google 能處理 JavaScript,初始 HTML 空白本身不等於無法索引。
canonical 標籤:告訴 Google 哪一頁才是正本
當多個網址提供重複或高度相似的內容,rel=”canonical” 是指定偏好版本的強烈訊號,可協助整併連結與其他訊號,但 Google 仍會自行選擇 canonical。不同顏色商品若有需要獨立呈現的資訊,不應只因網址相似就一律合併;先判斷內容與讀者用途,再設定正本。
索引常見錯誤:robots.txt、noindex、canonical 三個一起用反而出事
robots.txt 決定能否抓取,noindex 要求不建立索引,canonical 指出重複或相似內容的偏好網址。若目的是排除索引,必須允許 Googlebot 抓取,才讀得到 noindex。canonical 來源與目標也應可存取,並避免訊號互相矛盾;不要用 robots.txt 當作指定正本的方法。
即使 robots.txt 封鎖頁面,Google 仍可能根據外部連結知道該網址,並在沒有頁面內容的情況下顯示它。因此,要從搜尋結果移除仍公開存在的頁面,應使用可被抓取的 noindex;敏感內容則應採用存取權限或密碼保護。
三個致命錯誤對照
| 錯誤組合 | 結果 | 正確做法 |
|---|---|---|
| robots.txt 封鎖 + noindex | Googlebot 無法讀到該頁的 noindex | 放行爬蟲,單獨用 noindex |
| canonical 目標頁被封鎖 | 目標內容無法供 Google 評估 | 目標頁保持可抓取 |
| 封鎖 robots.txt 想移除已收錄頁 | 網址仍可能留在索引 | 用 noindex + 放行,等重新抓取 |
正確移除已收錄頁面的四步驟
- 先解除 robots.txt 封鎖,讓爬蟲能重新抓到那個頁面。
- 依 Google noindex 說明,在頁面 robots meta 或 HTTP 回應標頭設定
noindex。 - 等待 Google 重新抓取並移除,可在 Search Console 觀察狀態。
- 要持續排除索引,就保留可被抓取的 noindex;敏感內容改用登入或密碼保護。
noindex 控制搜尋可見度,不能保護機密資料。需要限制誰能讀取時,應使用登入或密碼保護。網站搬家與舊網址替換則是另一個問題,可依 301 與 302 重定向的用途選擇,並核對 重新導向對 SEO 的影響,不要拿 noindex 代替搬家設定。
第 3 階段:排名,使用者搜尋時 Google 怎麼決定誰排前面
使用者搜尋時,Google 從索引找出相關內容,依查詢意義、相關性、品質、可用性與情境提供結果。官方搜尋運作說明也指出,Google 不接受付費來提高自然排名,購買 Ads 與自然排序分開。若需要比較兩者,可看 廣告與自然排名的關係。
SEO 服務可以協助改善網站,但不能保證 Google 的自然排序。評估 爭取 Google 前段排名與 付費搜尋預算時,要分開看成效。Google Ads 合作夥伴身分也不等於獲得 Google 自然排名保證,相關 SEO 認證說明與 SEO 廠商篩選指標可供核對。
排名訊號的四大類別
- 內容相關性與品質:標題、內文、標題層級是否真實回應搜尋意圖,是不是 搜尋意圖 要的答案。
- 可靠性:資訊、來源與作者經驗是否可信。E-E-A-T 是品質評估觀念,不是可填滿的排名分數;會影響健康、財務或安全的 YMYL 主題尤其需要謹慎查證。
- 頁面體驗:Core Web Vitals 會被排名系統使用;也應照顧行動裝置可讀性與傳輸安全,不能用單一速度分數預測排名。
- 查詢情境:位置、語言、裝置與適用的個人化設定可能改變結果;同一查詢 在不同位置不一定顯示相同頁面。
Google 官方指出 E-E-A-T 本身不是單一排名因素,系統會綜合能反映經驗、專業、權威與信任的訊號。頁面體驗也沒有單一總分;Core Web Vitals 會被排名系統使用,但分數良好不保證高排名。改善方向應是解決讀者的實際問題,而非把這些概念當成可直接累加的權重表。
Google 公開的系統概覽沒有提供完整權重公式。Navboost 的相關討論與 Google 工程師證詞可以補充研究背景,但不能把網站自己的停留時間直接換算成排名分數,也不能據此保證某項改動會提升排名。
Google 排名的核心訊號拆解:內容、權威、體驗,到底哪個最重要
Google 沒有公布適用所有查詢的「內容、權威、體驗」固定權重排序。系統會依查詢尋找相關、可靠的結果;若多個頁面都能回答問題,良好體驗也可能有幫助。過去 排名因素的訪談與 前三因素的歷史討論,不能當成現在或未來所有搜尋的完整公式。
實作時先看讀者任務:想知道定義、比較選項,還是直接購買?頁面需要提供的資訊不同。如果讀者要價格與規格,只有概念介紹就可能不夠;若讀者想理解原理,只放銷售訊息也難以解答。這比按想像中的權重表逐項加分更有用途,相關判斷可看 為什麼好內容不等於排名第一。
內容相關性:標題與內文要對到搜尋意圖
常見意圖包括資訊、商業調查、交易與導航。可檢查目前搜尋結果的頁型、比較重點與未解問題,再安排內容;結果頁可能同時包含多種意圖,不必硬選一種。關鍵字最佳化、長尾關鍵字與 主題群集應協助讀者找到相關答案,而非為每個近似詞複製一篇文章。
內容品質:原創、有實質資訊量的 People-First Content
Google 的實用內容系統自 2024 年起已納入核心排名系統,不能再當成獨立開關。以人為本的內容指南要求檢視原創資訊、完整解答、來源與作者經驗;沒有偏好的固定字數。站內 實用內容介紹、字數與排名的關係與 字數不等於品質可作延伸閱讀。
權威性:連結品質與品牌訊號
Google 的連結分析系統會利用頁面之間的連結,理解主題與哪些內容可能有幫助。評估 高品質反向連結時,應看來源與文章是否相關、連結是否有實際閱讀用途;沒有「一條等於一百條」的通用換算。錨文字要讓人知道目的頁內容,連結建立也不應以操縱排名為目標。
體驗:依實際問題改善 Core Web Vitals
Google 的頁面體驗說明明確指出 Core Web Vitals 會被排名系統使用,但追求滿分不一定是 SEO 最佳投入。可先檢查載入速度、互動延遲、版面位移,以及 行動優先索引下的手機版內容是否完整;相關細節可看 Mobile-First Indexing 的影響與 檢查清單。HTTPS則保護傳輸安全,應一併維護。
| 網站狀態 | 先檢查什麼 | 確認方式 |
|---|---|---|
| 重要頁面未索引 | 抓取、noindex、canonical 與頁面內容 | 網址審查、網頁索引報表、伺服器紀錄 |
| 已索引但曝光不符預期 | 搜尋需求、查詢意圖、內容是否提供足夠資訊 | 依頁面與查詢比較搜尋成效 |
| 讀者載入或操作不順 | Core Web Vitals 與手機使用問題 | 真實使用者資料搭配實際操作 |
優先順序應依網站現況決定:頁面抓不到,先修存取;已索引卻答非所問,先補內容;答案完整但操作困難,先修體驗。可對照 實用內容相關指南與 頁面體驗指引安排工作,不需要為三類問題設定固定排名權重。
3 步驟實戰:讓你的網站被 Google 正確爬、正確索引、排得上
先驗證網站與提交重要網址清單,再檢查抓取、索引及 canonical,最後改善對應查詢的內容與體驗。每次記錄修改日期與範圍;技術錯誤修好後,用實際網址測試確認,再追蹤 Google 是否重新抓取。內容調整則比較相關頁面與查詢的曝光、點擊及轉換,不必等固定天數才處理已知錯誤。
步驟 1:提交 Sitemap,讓爬蟲找得到你
在 Search Console 驗證所有權後提交 XML Sitemap,參考 官方 Sitemap 說明。清單應包含希望索引的 canonical 網址,避免放入 noindex、錯誤或重新導向網址。少量重要頁面更新後,可依 單一網址提交說明,在網址審查選「要求建立索引」。若另收到 PageSpeed 或體驗相關通知,應回到對應報表處理,不要與索引要求混在一起。
步驟 2:檢查 robots.txt 與索引報告
以網址審查確認 Google 記錄的抓取、索引與 canonical,再查看 網頁索引報表中的同類問題。robots.txt 另用現行報表檢查;必要時測試實際網址。遇到 noindex、封鎖或重複網頁,先判斷是否符合原本用途,再決定是否修正,不需要讓所有網址都索引。進階排查可參考 技術 SEO與 簡化網站的建議。
步驟 3:內容對齊、補結構化資料、修體驗
- 確認內容回答目標讀者的問題,補足規格、比較、步驟或來源中實際缺少的資訊。
- 依實際頁型加入 Google 仍支援的結構化資料,並驗證標記與可見內容一致;一般教學頁不套 QAPage。
- 依真實使用者資料修正 載入速度、互動延遲與版面位移,也確認手機可讀性。
- 用符合圖片內容的 alt 文字與圖說協助理解;裝飾圖片不必硬塞關鍵字。
site: 可快速查看部分已顯示結果,但 官方明確說明它不會列出全部索引網址,也不能用結果筆數當收錄總量。單頁用網址審查,整站用網頁索引報表;免費 SEO 工具、Site Kit by Google與 Google Analytics則協助整理資料。入門可讀 Google 線上課程及 SEO 入門指南;排名因素整理應當作概念索引,不能取代當下官方文件。
要求重新抓取可能需要數天至數週,沒有索引或排名完成期限。排名變化也可能來自查詢需求、競品、網站變更與核心更新;不能看到短期波動就歸因為 Google Dance。先記錄時間與受影響頁面,再依 排名變化排查方式檢查原因,並確認是否有已公布的 核心更新。
若目標是增加 自然流量與 自然搜尋可見度,還要確認這些查詢能否帶來合適的讀者與業務成果。可用 是否需要 SEO 的評估方式判斷投入,不必把「更多頁面被索引」本身當成成效。
AI Overviews 與 AI Mode 如何使用搜尋內容
AI Overviews 與 AI Mode 使用 Google 的搜尋索引與核心搜尋系統,但會以生成式回答搭配支持連結呈現。依 Google 的 AI 功能說明,兩者可能透過 query fan-out,同時搜尋相關子題與資料來源,再找出支持回答的網頁。搜尋一個廣泛主題時,因此可能看到同一頁支援多個子題。
AI Overviews 在適合的搜尋中提供摘要;AI Mode則支援更深入的問答與比較。頁面要成為支持連結,須已索引且可在搜尋顯示 snippet,並未被排除於生成式 AI 功能。符合資格不保證被引用,傳統搜尋的名次也不能直接當作引用順位。流量評估可搭配 零點擊搜尋與 搜尋使用行為的變化,但仍需看自己的網站資料。
下圖可以看到來源標籤與文章卡片的實際呈現:搜尋「seo」的 AI 摘要,在 SEO 定義、內容 SEO 與技術 SEO 三處顯示 Whoops SEO 標籤,右側來源清單列有本站〈SEO 是什麼?〉指南。可開啟原始截圖對照引用位置與文章標題。
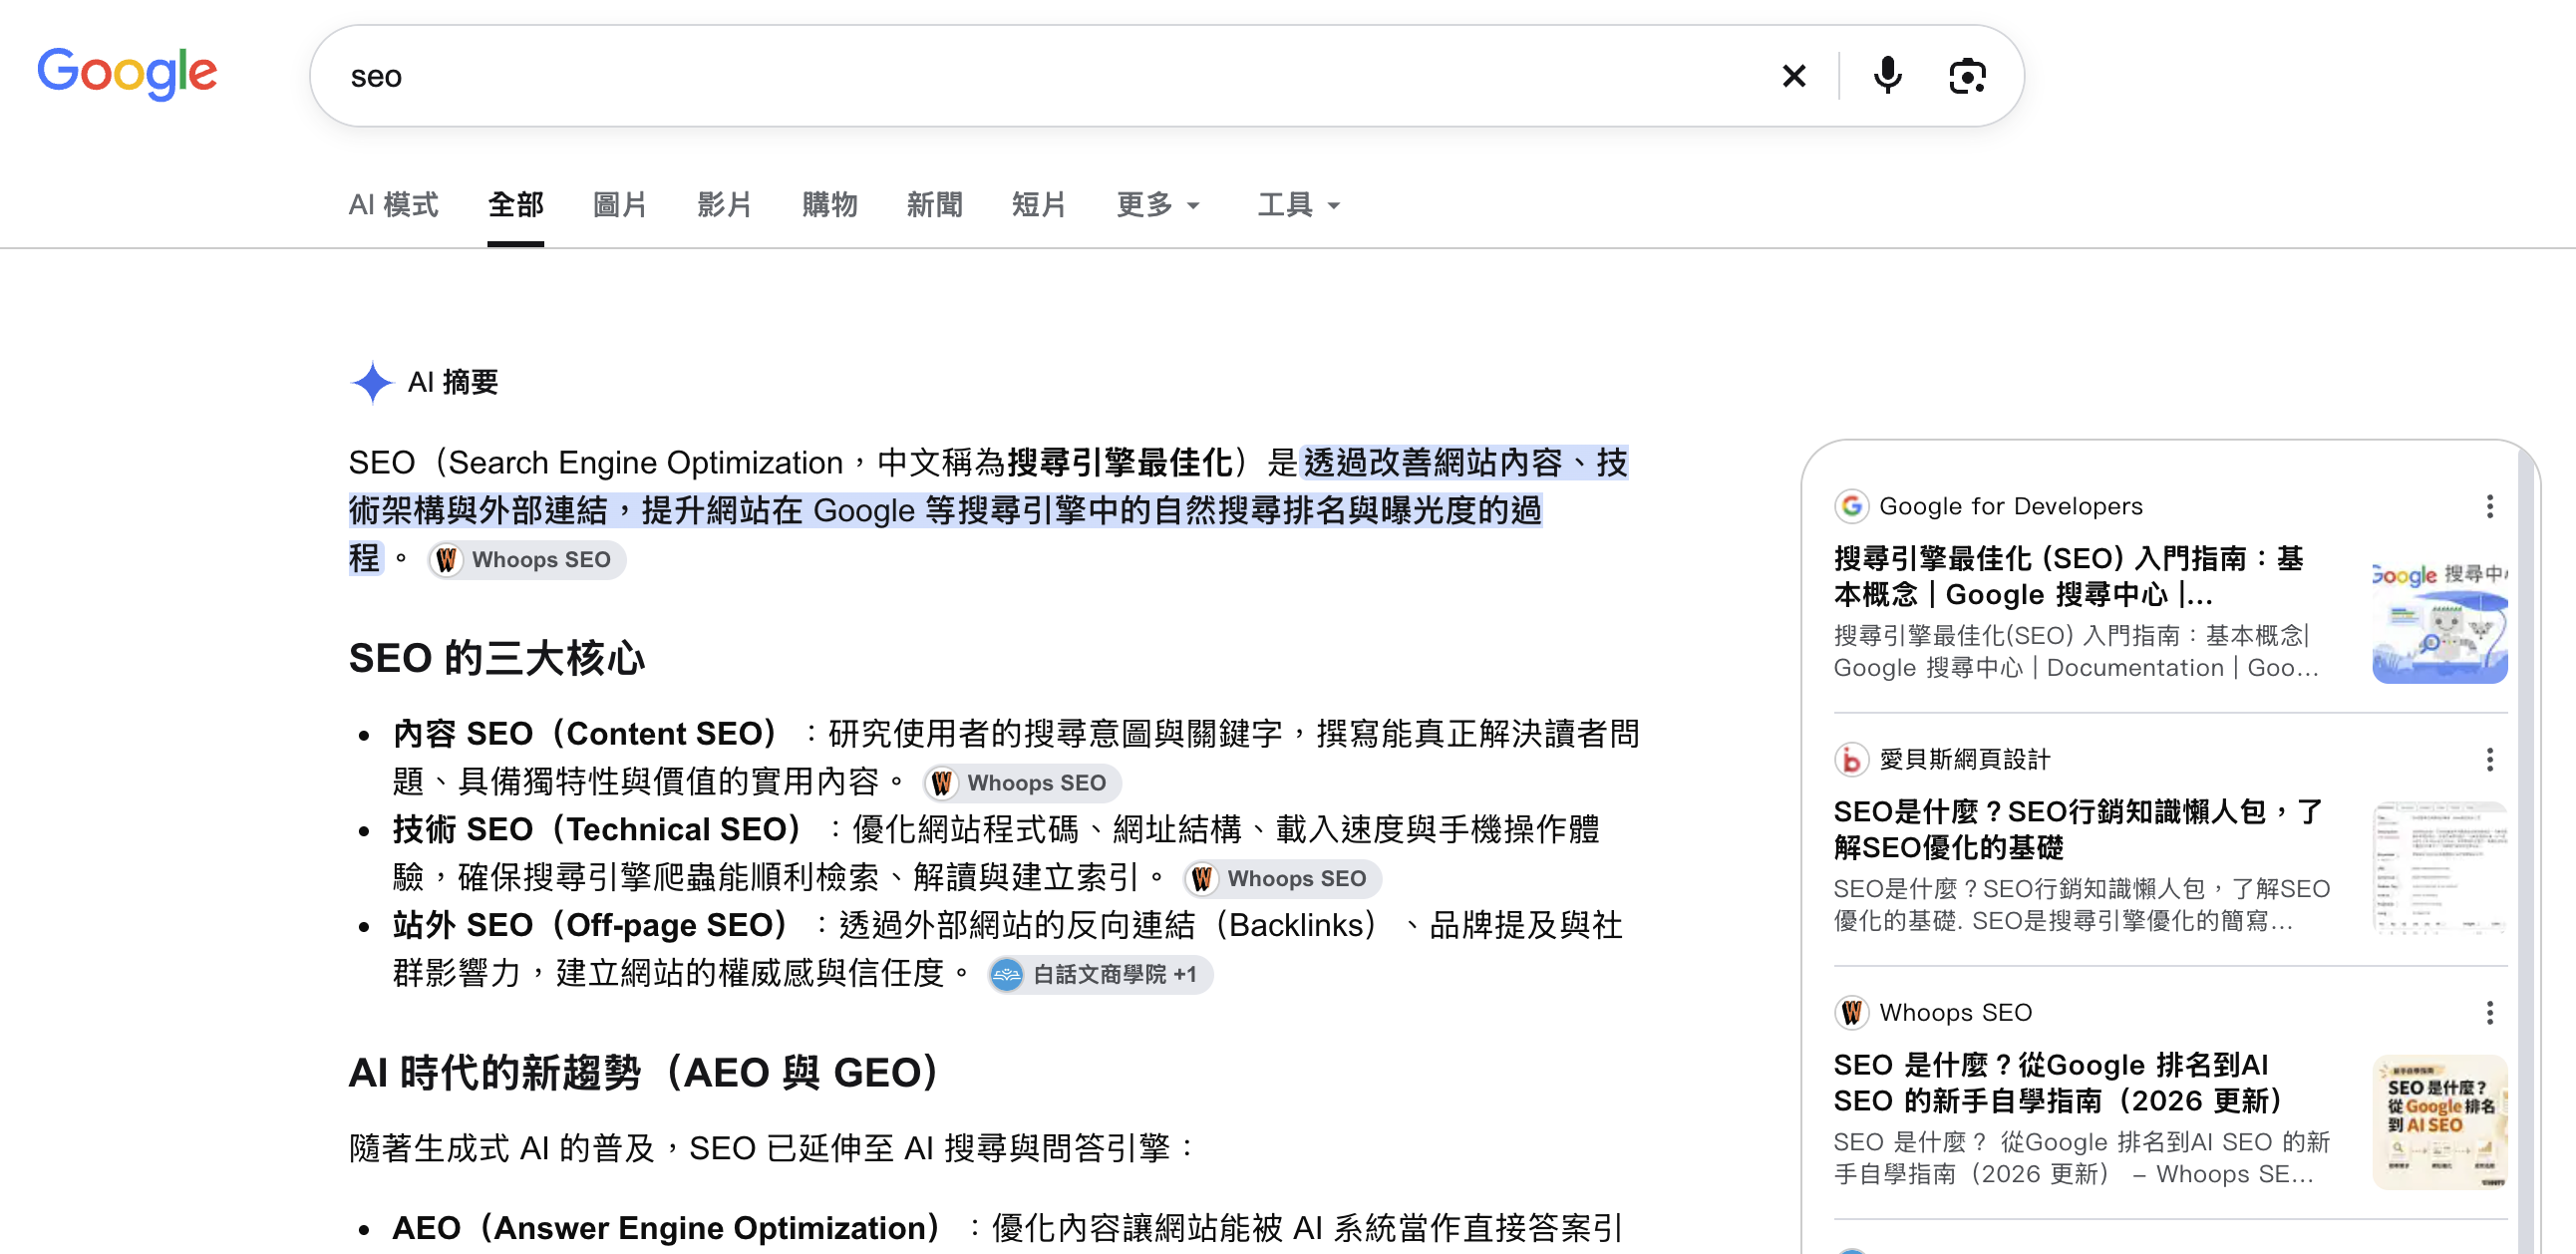
同一網站在不同段落出現來源標籤時,仍要逐一展開卡片核對網址,才能確認是否引用同一篇文章;單次畫面不能推定長期引用率或排名原因。
從「爭排名」到「爭 AI 可見度」
除 Search Console 原有的搜尋成效外,現在可使用 Generative AI performance report查看 AI Overviews 與 AI Mode 的曝光,以及頁面、國家、裝置與日期。官方已於 2026 年 8 月 31 日全球推出;未看到報表可能是 AI 曝光尚不足。未篩選單一網址時,同站多個連結在圖表中按資源彙總;加入網址篩選後則按網址彙總,不能把多個引用標記直接當成多次曝光。這也讓 AEO與 GEO的調整可回到頁面可見度量測。
Google 官方立場與應對動作
Google 的 生成式 AI 搜尋優化指南仍以基本 SEO、原創資訊與讀者用途為重點。它沒有要求固定段落字數、FAQ、特殊 Schema 或 llms.txt。可用清楚標題、來源與實際經驗協助讀者理解,再參考 AI 搜尋 SEO 指南、AI agent 與搜尋的討論、SEO 趨勢分析及 AI SEO 指南,但不要把格式建議當成引用保證。
網站管理者也可在 Search Console 的 Settings → Search generative AI,確認 生成式 AI 顯示控制為 Include 或繼承允許的父層設定。做 AI SEO或 AISO前,先排除資格與存取問題;內容再補可核實的作者背景、經驗與來源,避免以虛構身分包裝專業。相關品質觀念可參考 動機與原創的說明、虛假 E-E-A-T 的警示與 Google Web Guide。
歷史脈絡:從 RankBrain、BERT 到 AI Overviews
Google 的 排名系統指南將 RankBrain描述為理解字詞與概念關係的系統,BERT則協助理解詞語組合的意義與意圖。蜂鳥演算法屬於歷史脈絡;生成式 AI 搜尋是另一種提供答案與探索連結的方式,不能把這些名稱排成一套可逐項最佳化的加分清單。追蹤 2025 年 3 月核心更新或 2026 年 3 月核心更新時,也要分開看已公布事件與自己網站的變化。
Google 搜尋常見問題
以下是檢查網站時容易混淆的幾個問題。
Q1 我的網站為什麼 Google 搜不到?
先用 Search Console 網址審查區分「未索引」與「已索引但目標查詢沒顯示」。未索引時查看抓取、noindex、canonical 與品質相關狀態;已索引時再檢查查詢意圖、內容及搜尋成效。沒有提交 Sitemap 不能單獨證明 Google 未發現網站。
Q2 買 Google Ads 會不會幫自然排名加分?
不會。Google 官方說明自然排名不接受付費提升。購買 Ads 可以投放廣告,但不會買到自然排名;SEO 服務也不能保證第一名。
Q3 Google 爬蟲多久來抓一次?
沒有固定週期。抓取需求受內容變動、品質、受歡迎程度等影響,抓取容量也受伺服器狀態限制。可在 Search Console 抓取統計查看紀錄;新增或修改的重要頁面可要求重新抓取,重複要求不會加速。
Q4 怎麼確認網頁被索引了?
以 Search Console 網址審查的索引結果與 Google 選定 canonical 為主要依據,再用網頁索引報表看整站趨勢。site: 只適合輔助檢查;沒有出現在結果中,不代表一定未索引。
Q5 robots.txt 跟 noindex 差在哪?
robots.txt 控制抓取,noindex 控制索引。若要 Google 處理頁面上的 noindex,該頁就不能被 robots.txt 擋住。需要長期排除索引時,維持可抓取的 noindex;敏感資料另用登入或密碼保護。
Q6 AI 搜尋會讓 SEO 失效嗎?
基本 SEO 仍適用。AI 功能使用搜尋索引與核心搜尋系統,站長應先確保可抓取、可索引與內容可靠,再觀察 AI 曝光及實際成果。Google 沒有要求為 AI 搜尋使用特殊文字格式或 Schema,也不保證引用。
Q7 新文章多久才會出現在 Google?
Google 表示重新抓取可能需要數天至數週,要求索引不保證一定收錄。用網址審查追蹤實際抓取與索引狀態;若有已知封鎖、錯誤或 noindex,應直接修正,不必等待固定的觀察期。
網站搜不到時,從哪一步開始
網站搜不到時,先在網址審查確認抓取、索引與 canonical;已索引卻沒有合適查詢曝光時,再回到內容與搜尋需求。這能避免把伺服器問題當成內容問題,或在尚未確認索引前就反覆改標題。
需要補完整 SEO 概念,可從 SEO 是什麼開始;已有網站且想改善搜尋表現,再依 Google 排名改善方式安排工作。AI 搜尋的評估也沿用這些基礎,另外記錄頁面在生成式 AI 功能中的曝光與成果。
若需要協助,先整理受影響網址、網址審查狀態、最近修改時間與搜尋成效,再依 SEO 廠商篩選指南評估服務,或到 聯絡我們討論具體問題。
討論與提問