
本篇內容
Googlebot 是 Google 搜尋用來檢索網頁的自動程式,也就是一般常說的網路爬蟲(web crawler),正式文件把它定義為兩種檢索器的通稱:模擬手機使用者的 Googlebot Smartphone,以及模擬電腦使用者的 Googlebot Desktop。它順著連結和 Sitemap 找出網址、向你的伺服器發出 HTTP 請求抓取內容、用無頭 Chromium 執行 JavaScript 產生最終畫面,再把結果交給索引程序。一個網頁要出現在 Google 搜尋結果,第一個前提就是 Googlebot 檢索得到它。
要真正搞懂 Googlebot,得先把它跟三件常被混為一談的事分開:檢索不等於索引、Googlebot 不等於 Google 使用者、控制檢索的工具不等於控制索引的工具。自從 Google 改用行動優先索引,大部分檢索請求來自 Smartphone 版本;而 robots.txt 擋的是「抓取」這個動作,不是「出現在搜尋結果」這個結果。這三個區分貫穿全文,也是多數檢索問題的答案所在。
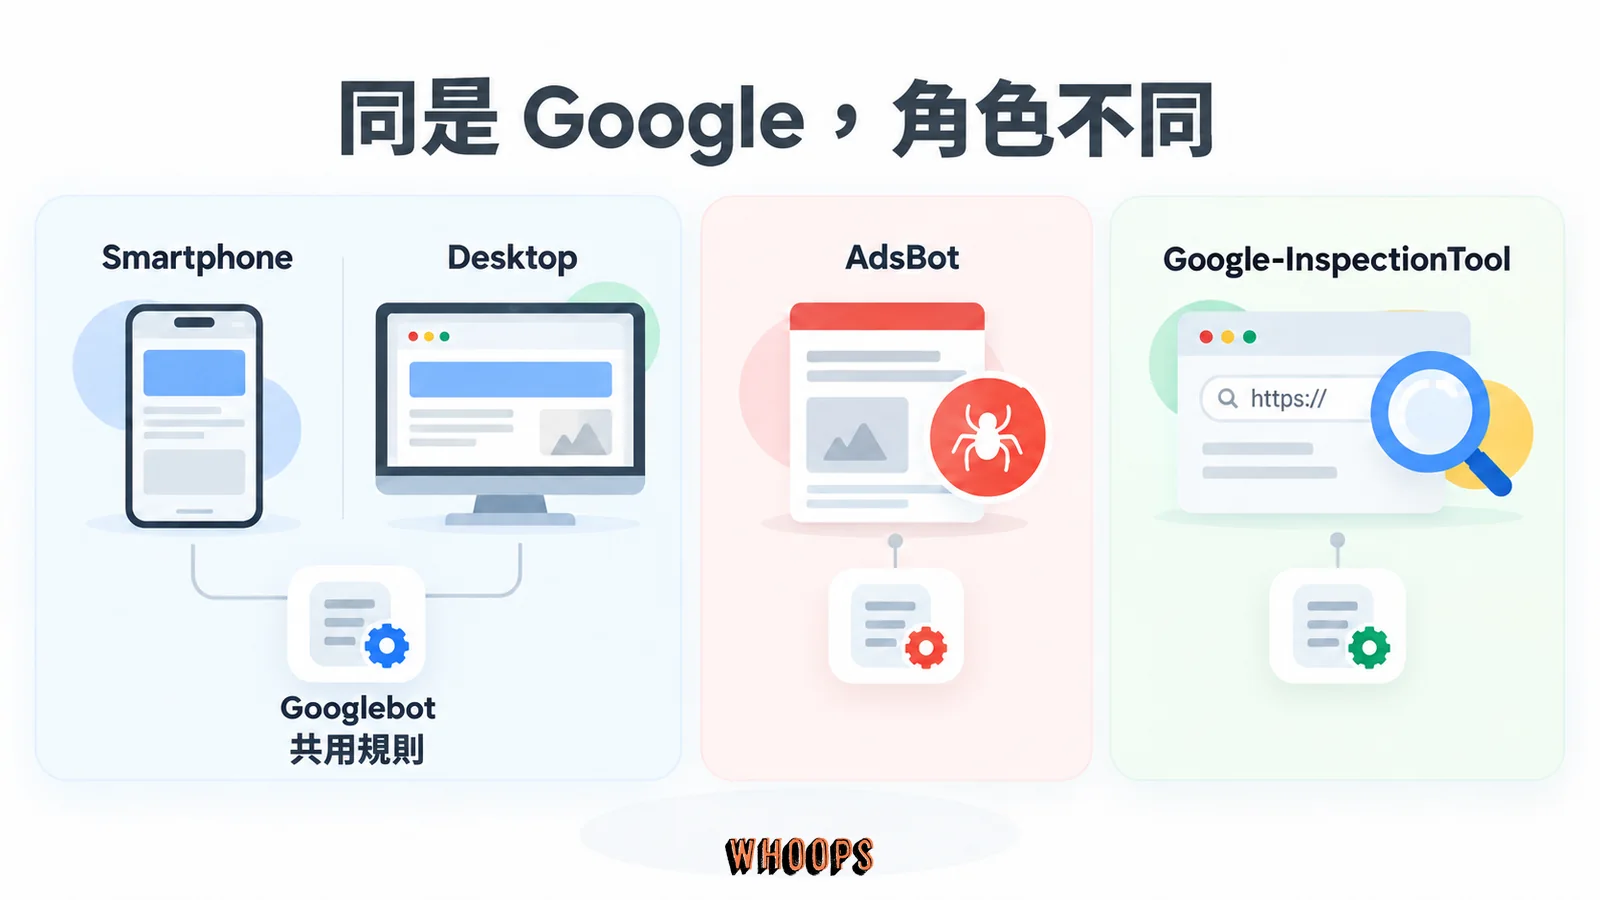
Googlebot 是通稱,不是單一機器人。實際上是 Smartphone 與 Desktop 兩種檢索器,共用 Googlebot 這個 robots.txt token,無法只封鎖其中一種。
它的工作分四步:發現網址、排入檢索佇列抓取 HTML、排入渲染佇列執行 JavaScript、用渲染後的畫面建立索引。
Googlebot-News 沒有獨立的使用者代理字串。新聞檢索用的是一般 Googlebot 字串,伺服器日誌看不出差別。
驗證真假 Googlebot 的標準做法是反向 DNS:IP 反查出主機名稱、確認落在 googlebot.com、google.com 或 googleusercontent.com、再正向反查回同一個 IP。只看使用者代理字串不可信,因為那是一行任何人都能偽造的文字。
不同工具管不同層:robots.txt 管檢索、noindex 與 X-Robots-Tag 管索引、密碼保護管存取、伺服器回應碼管檢索速率。用錯工具是 SEO 實務裡最常見的意外之一。
Google-Extended 控制的是 Gemini 的訓練與接地,不是 Google 搜尋。在 robots.txt 封鎖 Google-Extended,不會讓網站退出搜尋結果。
檢索量是健康指標,不是成績單。Google 明講檢索與排名不接受付費加速,檢索頻繁也不會讓排名變好,該盯的是索引涵蓋率與內容品質。
檢索、索引、供給:Googlebot 在搜尋流程裡的位置
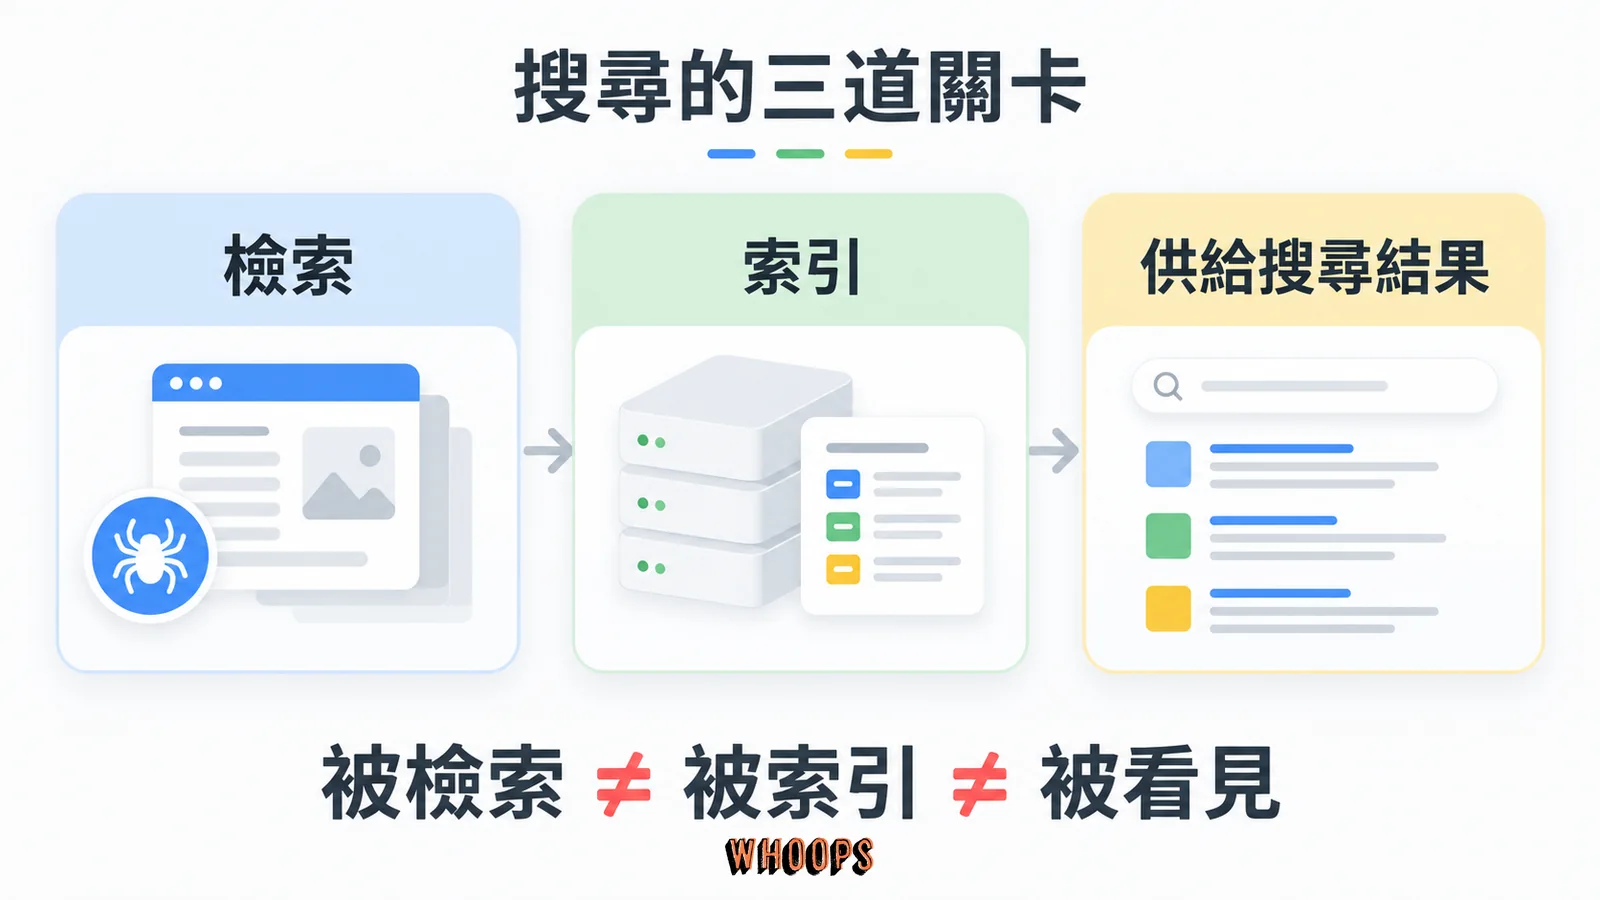
Google 官方把搜尋運作分成三個階段:檢索、索引,以及供給搜尋結果。Googlebot 只負責第一個階段,但它做的事決定後面兩個階段有沒有材料可用。檢索階段下載頁面上的文字、圖片與影片;索引階段分析內容、處理重複網址與標準化(canonical);供給階段才在使用者搜尋時從索引裡挑選與排序。Google 在官方對搜尋三階段的說明裡講得很直白:不是每個頁面都能走完三個階段,Google 不保證一定檢索、索引或供給某個頁面,也不接受付費換取更頻繁的檢索或更高的排名。
索引階段做的工比多數人想像的多。Google 會分析文字與重要標記、處理圖片與影片資訊,並檢查這個頁面是不是網路上另一個頁面的重複版本:相似頁面會被群集起來,選出一個最具代表性的標準網址放進結果,其餘版本成為替代版本,只在特定情境(例如行動搜尋)出場。供給階段則在查詢發生的當下,從索引裡挑出符合意圖的頁面,使用者的地區、語言與裝置都會影響結果。所以「被檢索了」「被索引了」「出現在結果裡」是三道各自獨立的關卡,每一關都有頁面落選,這也解釋了那個常見困惑:Search Console 說頁面已建立索引,搜尋結果裡卻找不到,常見原因包括內容與查詢不相關、品質不足,或被 robots meta 的規則擋下供給。三個階段怎麼串成一輪完整的搜尋運作,站內另有Google 搜尋運作方式的三階段拆解可以對照。
這三個階段也回答了一個常見困惑:Googlebot 和使用者在搜尋框打字,是兩個不同世界的事。使用者在輸入時看到的Google Autocomplete 自動建議,屬於查詢理解與供給那一端;Googlebot 屬於檢索與索引這一端。搜尋建議不會因為 Googlebot 多來幾次而改變,索引內容也不會因為熱門查詢而自動補上。
把 Googlebot 的行為照顧好,本質上是技術性工作:伺服器回應、重新導向、robots.txt、渲染資源、網址結構,每一項都會影響檢索的成敗。這些環節的系統性整備,屬於技術 SEO 的範圍;本文聚焦在 Googlebot 這個角色本身,講清楚它做什麼、怎麼辨認它、以及每種控制手段實際管到哪一層。
Googlebot 不是什麼:三條容易踩混的界線
Googlebot 是自動程式,不登入、不執行交易,抓的是公開可及的內容;需要帳號或處於付費牆後的內容它拿不到,這也是密碼保護之所以是最徹底拒絕的原因。檢索流量是機器流量,不是使用者造訪,Googlebot 來得勤不代表內容受歡迎,也不代表搜尋表現變好,兩者之間沒有直接關係。
Googlebot 也不等於 Google 的其他服務機器人。廣告品質檢查、API 推播、安全掃描各有自己的爬蟲,行為與 robots.txt 對待它們的方式都不同,後面的家族表會細看。決策本身則是程式化流程:Google 明講檢索與排序不接受付費加速,也不存在人工插隊的管道,所謂「讓 Googlebot 多來」的偏方,幾乎都建立在對這套流程的誤解上。
檢索與排名之間也有一條清楚的線。Googlebot 來得頻繁,只代表 Google 更常更新它對你網站的認識,讓索引裡的版本跟上現況;排名好不好,是供給階段另一套評估的事。把檢索頻率當成 KPI 經營,方向就偏了,該盯的是索引涵蓋率與內容品質,檢索量只是健康指標,不是成績單。
Google Search Central 在這則官方 LinkedIn 貼文中,說明 Googlebot 背後的共用檢索基礎設施,以及避免讓網站過載的限速機制。
Googlebot 怎麼工作:從發現網址到抓取內容
Googlebot 的工作是一個不斷循環的流程:從連結與 Sitemap 發現網址、把新網址排進檢索佇列、依排程發出請求抓取 HTML,結果再交給渲染與索引程序接手。每一步都有各自的條件與極限,也是檢索問題最常見的源頭。
網址從哪裡來:連結、Sitemap 與手動提交
網路上沒有一份「全部網頁」的中央名冊,Google 必須自己發現網址。來源有三類:Google 已檢索過的頁面上的連結、網站提交的 Sitemap,以及 Search Console 裡的個別網址提交。其中連結是最核心的機制,Googlebot 抓回一個頁面後,會解析 HTML 連結的 href,把新網址加進檢索佇列,之後再依排程逐一造訪。這也是為什麼新頁面上線後,最好從既有的重要頁面連過去,或提交 Sitemap 加速被發現。Google 已停止公開提交網址的索引服務,站長現在怎麼提交網址給 Google 收錄,做法跟幾年前已經不同。
提交不等於馬上檢索。Google 用一套演算流程決定要檢索哪些網站、多久檢索一次、每次抓多少頁,會考慮伺服器的承受能力,也會依照回應狀況調整。網站回應大量伺服器錯誤時,Google 會自動放慢檢索;這個分配機制的完整討論屬於檢索預算的範圍,本文先記住一件事:你能影響的是供給 Google 判斷的訊號,不是檢索排程本身。
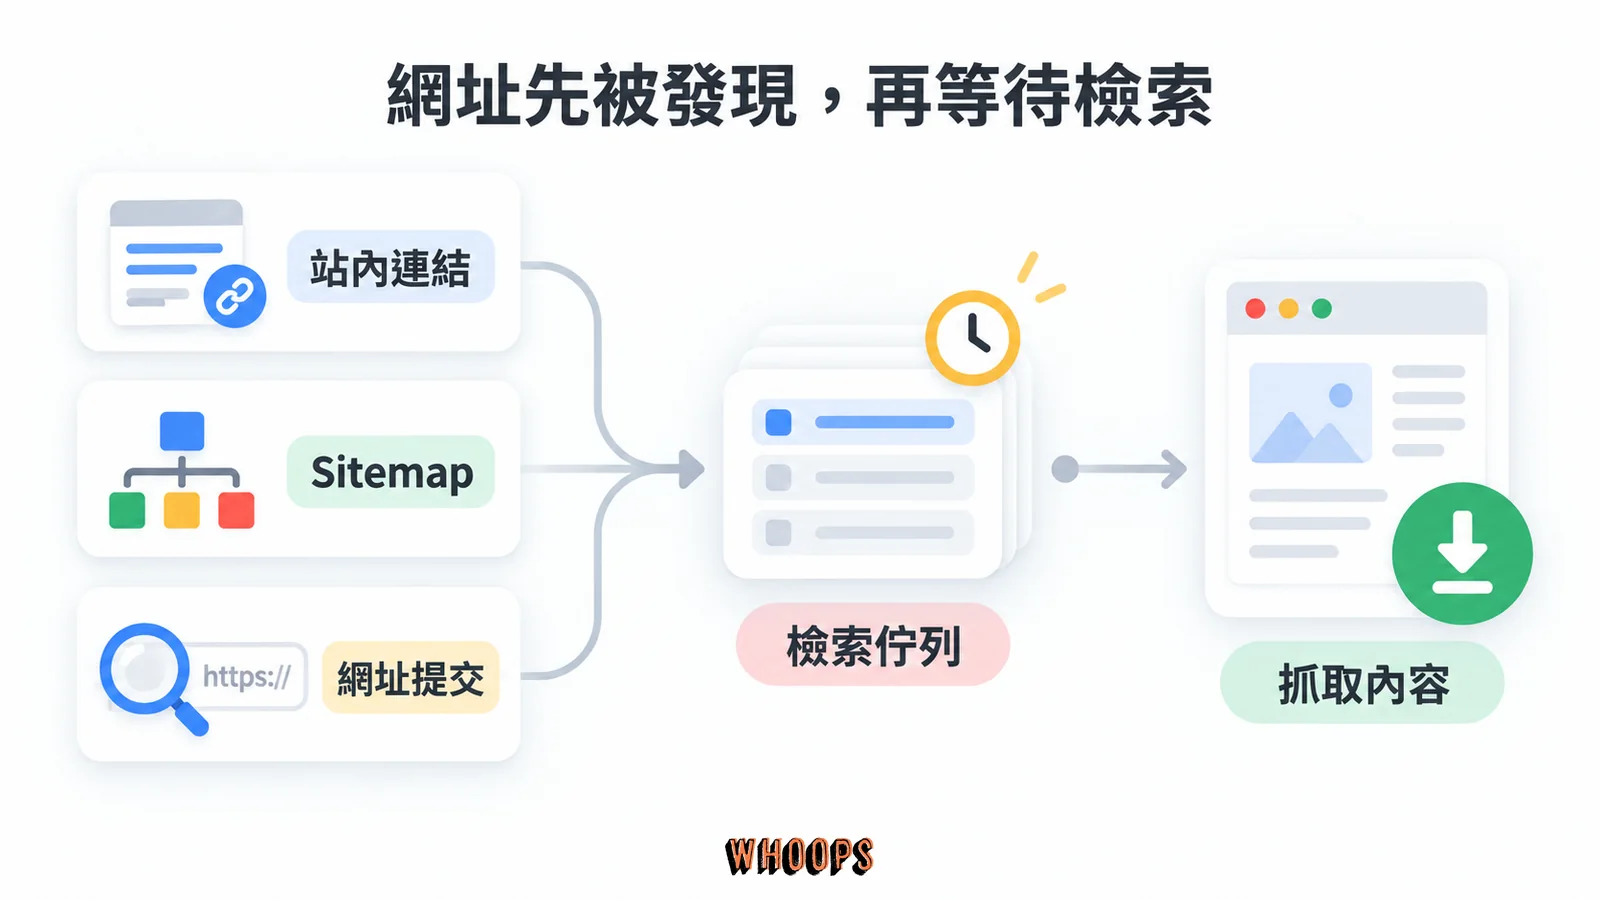
被發現的網址不會立刻被檢索,而是進入檢索佇列,由排程系統決定先後。排程的完整邏輯官方沒有公開,但文件至少確認了幾個影響因素:網站回應的速度與穩定度、內容的變動頻率與重要性,以及 Google 對整個網站設下的負載上限。換句話說,「多久會被檢索」沒有保證值,能做的是讓網站保持健康,讓內容有被優先處理的理由。
首次檢索之後,故事還沒結束。Google 會持續重新檢索既有頁面,更新索引裡的版本,回訪頻率同樣由排程決定:越常實質變動、越重要的頁面,回訪越勤。Sitemap 裡的 lastmod 是提示重新檢索的訊號之一,但只在真的反映內容變更時有用;為了觸發檢索而頻繁改日期,官方明說沒有價值。
參數、版本化與變體網址的常見疑問
網址層級有幾個疑問值得一次說清楚。Google 能檢索帶參數的網址,也不偏好所謂乾淨網址,把 ?id= 換成路徑寫法不會自動加分;真正要小心的是參數排列組合產生的大量相似頁面(篩選器、排序、日期跳轉),它們每個都是真實網址,都會被檢索、都計入 Google 願意分配的檢索量。為了促使重新檢索而做網址版本化(例如加上 v2、日期後綴)同樣要克制:新網址會被當成新頁面處理,內容沒變時,這只是把檢索資源花在同樣的東西上。
另一筆容易漏記的帳:Googlebot 抓的每個網址都算數,包括 AMP 或 hreflang 的變體網址,也包括頁面內嵌的 CSS、JavaScript 與 XHR 請求。統計「Google 檢索了多少頁」時如果把資源請求也算進去,數字會明顯膨脹;反過來說,精簡頁面資源、收斂無意義的變體網址,是實際會被感受到的檢索量節省。網址會長出多少變體、Googlebot 的路徑好不好走,最終由網站的URL 結構、導覽與資訊架構設計決定。
抓取時的技術細節:協定、大小上限與快取
Googlebot 發出的請求有一些值得知道的技術特性,整理自Google 檢索器的技術總覽:預設使用 HTTP/1.1,也支援 HTTP/2;接受 gzip、deflate 與 Brotli 壓縮,好好開壓縮對雙方都省頻寬。單一檔案預設最多下載前 15MB,部分產品更低,Googlebot 對某些檔案類型是 2MB,PDF 則允許到 64MB;超過上限時只有下載到的部分會進入索引。重新檢索時 Googlebot 支援 HTTP 快取,會用 ETag 或 Last-Modified 判斷內容有沒有變,兩者同時存在時以 ETag 為準,Google 也建議優先使用 ETag。
快取機制值得展開一點:重新檢索時 Googlebot 帶上條件請求,內容沒變就只收到未修改的回應而不重送內文,雙方都省資源。想讓這套機制發揮作用,回應要正確發出 ETag 或 Last-Modified,改版時讓它們真的變動;給資源檔案使用帶內容指紋的檔名,也是同一個思路的延伸。還有些冷門但真實存在的行為:Google 允許網站用 421 狀態碼婉拒 HTTP/2 連線,也仍能處理 FTP 位址,只是極少見。
另一組值得知道的細節:Google 的檢索流量主要來自美國的 IP 位址,但如果美國來源被擋,可能改從其他國家檢索;Googlebot 官方說明頁也提到,從美國 IP 檢索時,記錄上的時區採用太平洋時間。對解讀日誌裡的「上次檢索時間」有幫助。頻率方面,同一網站的兩次造訪平均間隔通常不低於幾秒鐘,實際節奏由前述演算流程決定。
狀態碼決定 Googlebot 接下來做什麼
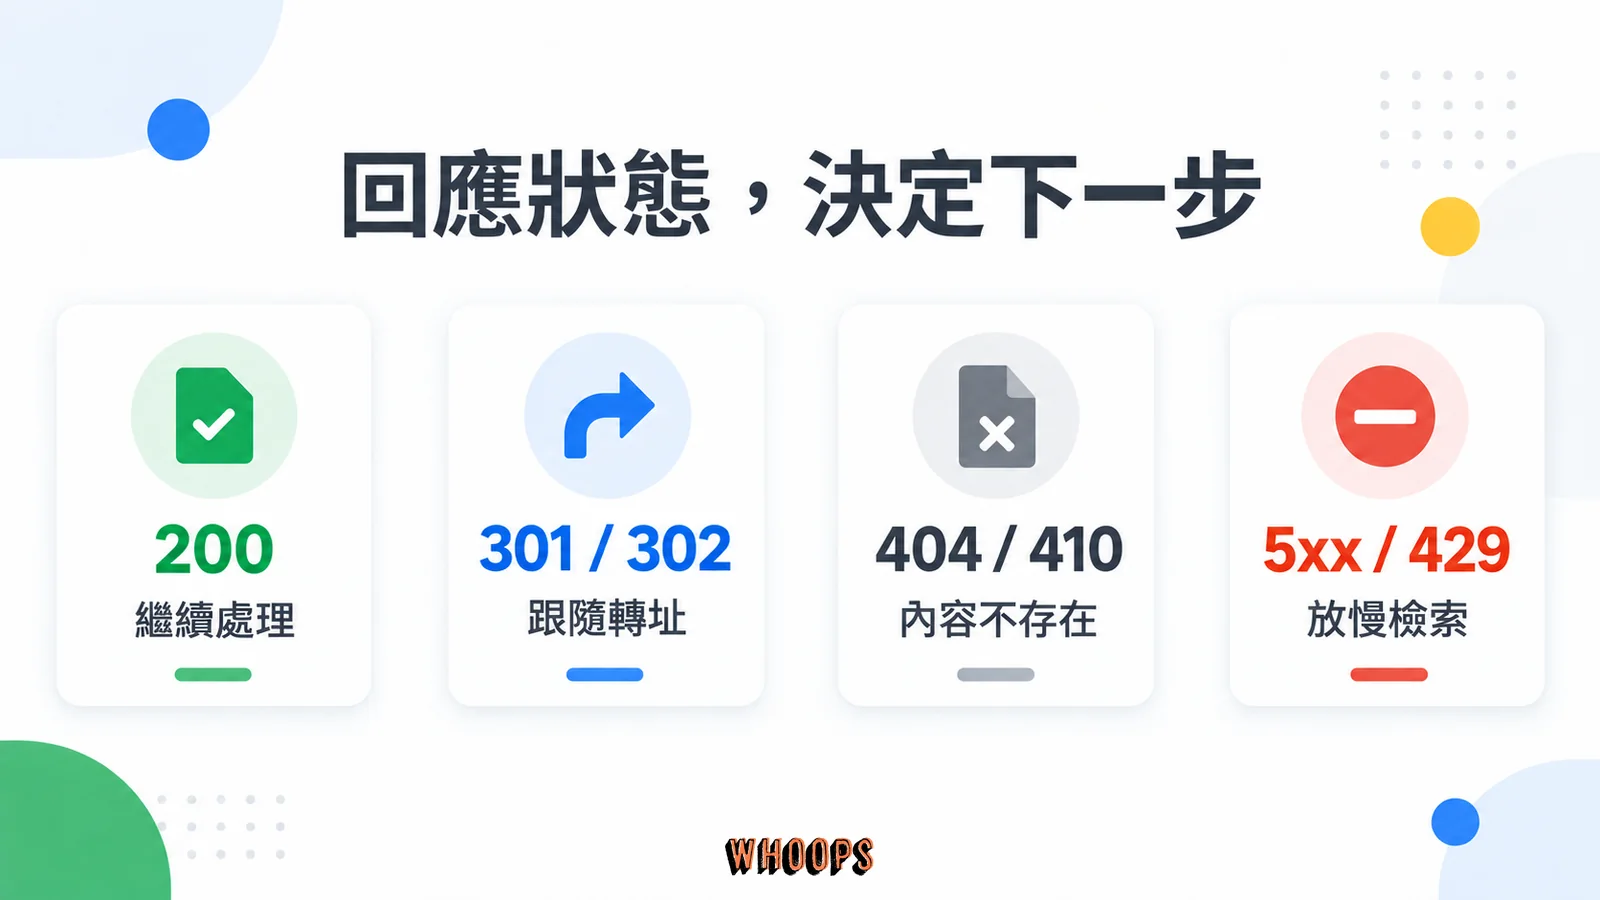
Googlebot 抓到什麼回應,會直接改變它後續的行為:200 代表內容進入下一關;301 與 302 告訴它改抓目標網址並更新索引;404 與 410 表示資源不存在,Google 會逐步減少回訪;500 級的錯誤與 429 會觸發降速保護,Google 會放慢對整個網站的檢索。也就是說,狀態碼不只是給使用者看的訊息,它是你與 Googlebot 溝通的正式語言。各代碼對 SEO 的完整影響,可參考HTTP 狀態碼對 SEO 的影響。
加速被發現:提交管道與 IndexNow 的位置
想讓新網址更快被發現,正規管道是 Sitemap(在 Search Console 提交,並讓 lastmod 反映真正的內容更新)與網址層級的提交。近年 Bing、Naver、Seznam、Yandex 與 Yep 支援的 IndexNow 協定,讓網站能主動推送網址清單,但IndexNow 官方網站列出的支援搜尋引擎裡沒有 Google。想了解這個協定的運作與設定方式可以參考IndexNow 的設定教學,但要清楚:對 Google 而言,Sitemap 與連結仍是主要的發現管道。Bing 端的對應入口則是Bing Webmaster Tools,IndexNow 的設定與推送後的收錄觀察都在裡面完成。
Google 的官方教學示範搜尋如何發現網址、抓取與渲染頁面,並說明 Sitemap 在其中的作用。(Google Search Central 官方影片)
渲染佇列:Googlebot 看到的是執行 JavaScript 後的頁面
根據 Google 的JavaScript SEO 基礎文件,Google 處理頁面分成三個階段:檢索、渲染、索引。多數文章講到「Googlebot 抓取頁面」就停了,但對現代網站來說,抓取只是上半場。Googlebot 先抓回原始 HTML 回應,接著所有回應 200 的頁面都會被排進渲染佇列,不管頁面上有沒有 JavaScript。等到 Google 的資源允許,一個無頭 Chromium 會載入頁面、執行 JavaScript,產生渲染後的 DOM。索引用的就是這份渲染後的內容,而且渲染完成後,Google 還會再解析一次頁面上的連結,把新發現的網址排入檢索佇列。
「等 Google 的資源允許」是這裡的關鍵,也是很多網站主人沒意識到的現實:渲染不是當場發生的。官方說法是頁面可能在渲染佇列裡停幾秒鐘,也可能更久,而且從外部無法分辨一個網址正在等檢索還是等渲染。實務上的意義是:倚賴 JavaScript 才出現的內容、連結與結構化資料,被處理的時間點會落在原始 HTML 之後,上線或改版後的索引延遲有一部分來自這裡。渲染服務(Google 內部稱為 WRS)有時還會忽略快取標頭,抓到舊版的 JavaScript 或 CSS 檔,官方建議給資源檔案使用帶內容指紋的檔名,讓改版後的新檔案不會被舊快取卡住。
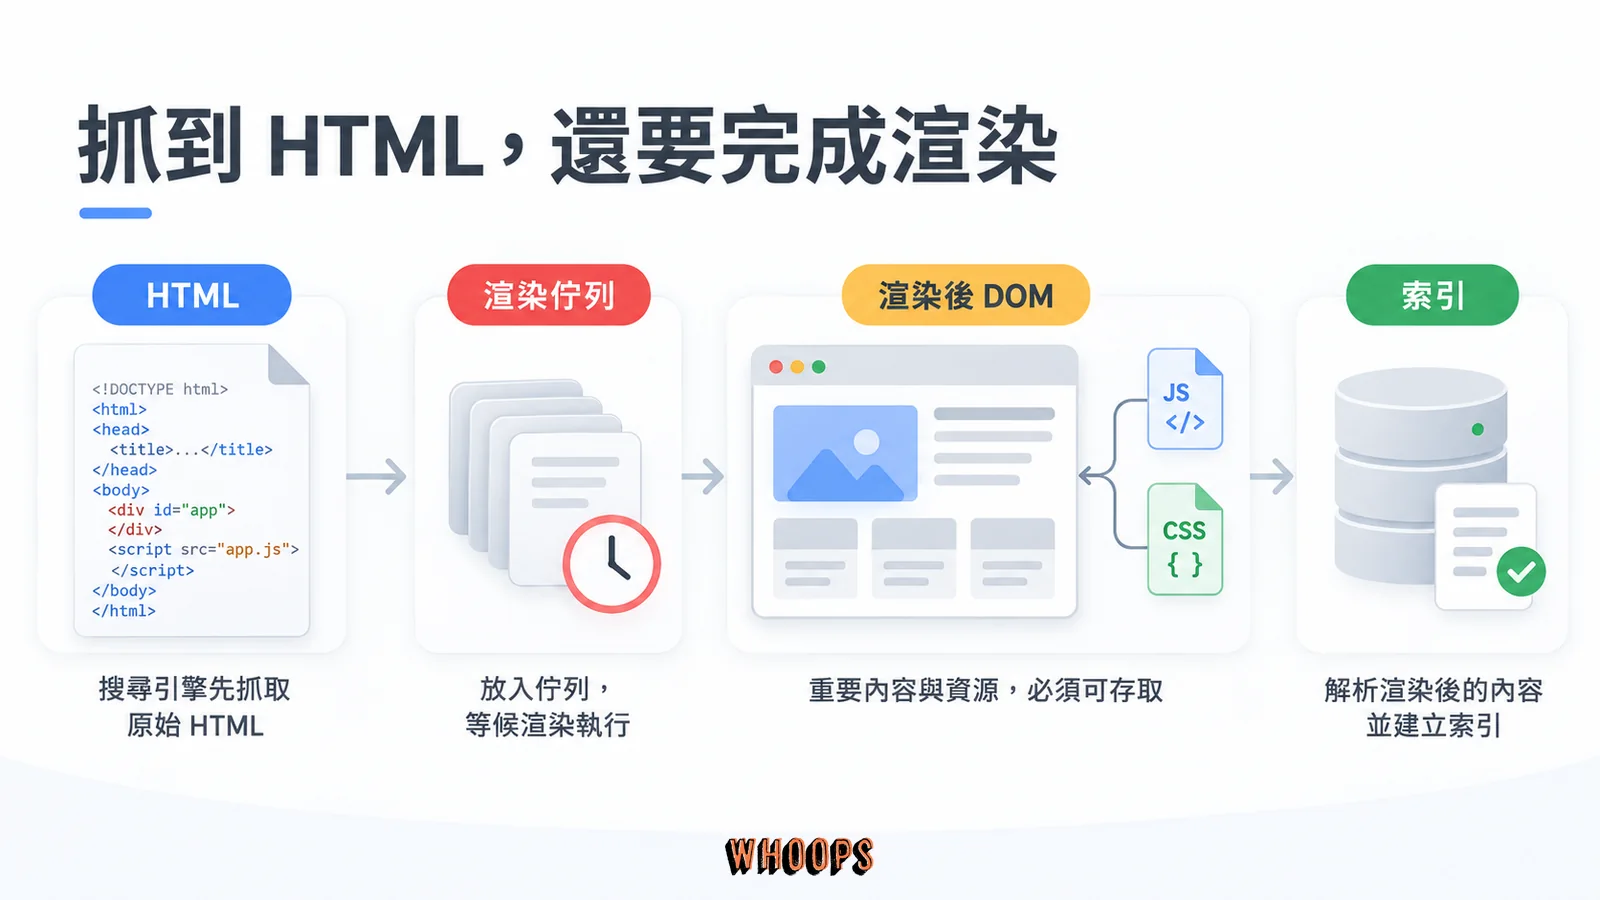
連結會被解析兩次:一次在原始 HTML,一次在渲染後的 DOM。如果導覽列或內文連結是 JavaScript 動態生成的,渲染完成前 Google 手上沒有這些連結;渲染一旦延遲或失敗,整批頁面的發現就跟著延遲。把關鍵連結放進伺服器端輸出的 HTML,是最穩的作法。
渲染環境的幾個特性也會影響實作決策。Google 用持續更新的 Chromium 執行頁面(也就是所謂的 evergreen Googlebot),新語法支援通常不是問題;要小心的是只在使用者互動後才載入的內容,這類延遲載入在渲染階段可能拿不到。標題與 meta 說明可以用 JavaScript 設定或修改,Google 讀的是渲染後的結果;canonical 同樣能用 JavaScript 注入,官方文件提醒要正確注入。非 200 回應的頁面則可能直接跳過渲染,重要的內容邏輯不要放在錯誤頁上。
想確認 Google 實際渲染出什麼,最快的入口是 Search Console 網址檢查工具的即時測試:它會當場檢索並渲染頁面,提供渲染後的截圖與檢視原始碼,被 robots.txt 擋掉的資源也會一併露出。這個工具的完整用法放在後面「觀察」一節一起談。
渲染也要放在行動優先的脈絡下看。Google 主要以行動版內容建立索引,而行動版頁面同樣要能被完整存取與渲染:不能把主要內容放在使用者互動之後才載入、兩種版本的 robots meta 要一致、結構化資料與詮釋資料要對等。電腦版做得再好,行動版渲染出來是空的,索引拿到的就是空的。想親自確認兩種版本被看到的內容是否一致,手機切換 User-Agent 的實測方法是很快的自查路徑。
渲染也放大了 robots.txt 的影響範圍。Googlebot 對頁面上參照的每個資源(CSS、JavaScript、圖片)是分開抓取的,每個請求都受同樣的規則與大小限制約束;被 robots.txt 封鎖的指令碼不會被執行,被遮蔽的樣式不會被套用。後果不一定馬上看得見:頁面可能照樣被索引,但 Google 讀到的版面與真實使用者看到的差距越來越大,內容判讀跟著出偏。Search Console 裡的「已建立索引,但未包含內容」狀態,常見原因之一就是這類資源被擋,可以照已建立索引但未包含內容的排查流程逐項檢查。
兩個延伸主題值得知道。其一,放在 JavaScript 裡的連結 Google 能不能檢索?能,Google 檢索 JavaScript 連結的行為已有專文討論,重點是連結要用真正的 HTML 元素與 href,不要倚賴點擊事件。其二,結構化資料裡被二次跳脫的 JSON 在 Googlebot 解析時有一段變更史,處理細節另有一篇Googlebot 解析 JSON-LD 雙重跳脫的筆記,這裡不展開。
儘管 Google 能執行 JavaScript,官方仍然建議伺服器端渲染或預渲染,理由很實際:頁面對使用者更快,對其他搜尋引擎與不執行 JavaScript 的機器人也友善。Googlebot 會執行 JavaScript 這件事,解釋的是「可以被索引」,不是「不需要最佳化」;能被渲染與每次都被即時、完整地渲染,中間仍然有距離。
Googlebot 家族成員與使用者代理字串
日誌裡會出現一堆 Google 相關的機器人,它們不是同一個東西。Google 把自家的檢索器分成常見檢索器、特殊用途檢索器與使用者觸發的抓取器三類:常見檢索器完全遵守 robots.txt;特殊用途檢索器(多半與廣告、API 推播、安全有關)可能忽略全域規則,而且跑在另一組 IP 範圍上;使用者觸發的抓取器則由終端使用者的動作引發,例如驗證網站所有權的請求,不屬於常規檢索。這個分類不只是清單整理,它決定 robots.txt 對誰有效、驗證時該比對哪一份 IP 清單。下表整理與網站管理者最相關的成員:
| 名稱 | robots.txt token | 用途 | robots.txt 行為 |
|---|---|---|---|
| Googlebot(Desktop/Smartphone) | Googlebot | 建立 Google 搜尋索引,含 Discover、新聞、圖片、影片 | 完全遵守 |
| Googlebot News | Googlebot-News(也受 Googlebot 規範) | Google 新聞 | 遵守 |
| Googlebot Image | Googlebot-Image | 圖片搜尋與搜尋裡的圖片功能 | 遵守 |
| Googlebot Video | Googlebot-Video | 影片搜尋與影片功能 | 遵守 |
| Google-InspectionTool | Google-InspectionTool | Search Console 網址檢查與複合結果測試 | 遵守 |
| GoogleOther/GoogleOther-Image/GoogleOther-Video | GoogleOther | 內部產品團隊的通用檢索與研究用途 | 遵守 |
| Storebot-Google | Storebot-Google | Google 購物相關介面 | 遵守 |
| AdsBot-Google/AdsBot-Google-Mobile | 同名 | Google Ads 廣告品質檢查 | 忽略全域 * 規則 |
| Mediapartners-Google | Mediapartners-Google | AdSense 廣告比對 | 忽略全域 * 規則 |
| APIs-Google | APIs-Google | Google API 推播通知 | 忽略全域 * 規則 |
| Google-Safety | Google-Safety | 濫用與安全相關檢查 | 忽略 robots.txt |
從這張表能推出幾個實務結論。在 robots.txt 封鎖 Googlebot,等於同時影響網頁、新聞、圖片、影片與 Discover 的檢索,因為新聞、圖片、影片檢索器也認 Googlebot 這個 token;反過來說,想單獨禁止新聞檢索,擋 Googlebot-News 就好,不必動到整個 Googlebot。廣告相關的 AdsBot 與 AdSense 的 Mediapartners-Google 則不吃全域規則,要擋就必須明確寫出它們的 token。
Google 官方清單裡還有兩個成員值得一提。GoogleOther 是 Google 內部產品團隊做研究與一次性檢索用的通用爬蟲,有自己的 token,可以單獨控制,通常不需要站方操心。Google-CloudVertexBot 則為 Vertex AI 代理的委託檢索而來,只影響該服務,不影響 Google 搜尋;要注意它的規則也認 Googlebot 這個上層 token,把 Googlebot 整個擋掉時它會跟著失效。
日誌裡如果看到 Google-InspectionTool,那多半是團隊自己在 Search Console 跑了網址檢查或複合結果測試;它不是 Googlebot 的常規檢索,對搜尋本身沒有影響。把它跟 Googlebot 分開統計,檢索量數字才不會被自己的測試行為干擾。
官方清單裡還有一批已經除役的名字,讀舊文章時可能會遇到:DuplexWeb-Google(網頁助理功能,已停用)、googleweblight(低速網路轉譯服務,已停用)等。它們不再出現在現在的檢索流量裡,看到相關的「封鎖建議」可以直接略過。
Googlebot 兩種檢索器的完整使用者代理字串如下,版本號中的 W.X.Y.Z 會隨 Googlebot 內部使用的 Chromium 版本變動:
Googlebot Smartphone:
Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)

Googlebot Desktop:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Googlebot/2.1; +http://www.google.com/bot.html) Chrome/W.X.Y.Z Safari/537.36
Googlebot 使用者代理字串裡真正可靠的識別是括號裡的 compatible; Googlebot/2.1 片段,前段的瀏覽器描述只是模仿。也因為使用者代理是一行文字,任何爬蟲都能貼上這段字串假冒 Googlebot,日誌分析與防火牆規則都不能只靠它判斷,這就是下一節要講的驗證問題。版本號會變這件事還有個工程意義:不要用完整使用者代理字串做精確比對,今天寫的規則明天就失效;以 token 片段或官方 IP 清單為準,規則才活得下去。
還有一個家族知識點:兩種 Googlebot 在 robots.txt 共用同一個 token,所以無法只封鎖 Desktop、放行 Smartphone,或反過來。而行動優先索引意味著 Google 主要以行動版內容建立索引,多數檢索請求來自 Smartphone;回應式網站兩種版本內容一致,影響不大,但桌面與行動分開網址(m 站)或動態服務的網站,就得照行動優先索引的最佳做法文件確保行動版的內容、結構化資料與詮釋資料完整。
真假 Googlebot:用反向 DNS 驗證的完整步驟
假冒 Googlebot 是真實存在的問題:蒐集資料的爬蟲、探測弱點的掃描器,都可能貼上 Googlebot 的使用者代理字串混進你的日誌。如果你打算根據「是不是 Googlebot」決定放行或封鎖,辨別真偽就是必要條件。Google 的說明是,自家爬蟲用三種方式表明身分:使用者代理標頭、來源 IP 位址,以及來源 IP 反向解析出來的主機名稱;三者交叉驗證才有可信度,單看任何一種都可能被蒙混。Google 官方的驗證說明給出手動驗證的四個步驟:
- 從日誌裡找出請求的來源 IP,對它執行反向 DNS 查詢(例如用 host 指令)。
- 確認查得的主機名稱落在 googlebot.com、google.com 或 googleusercontent.com 這三個網域。
- 對步驟一查得的主機名稱執行正向 DNS 查詢。
- 確認正向查詢回來的 IP,跟日誌裡的來源 IP 是同一個。
以官方文件列出的範例 IP 來操作會是這樣:
host 66.249.66.1
host 35.247.243.240
host 66.249.90.77
# Windows 沒有 host 指令,可用 nslookup 35.247.243.240 或 dig -x 35.247.243.240
真的 Googlebot 反查後會得到 crawl 開頭、結尾是 googlebot.com 的主機名稱(型態如 crawl-*-*-*-*.googlebot.com 或 geo-crawl 開頭的變體);AdsBot 這類特殊用途檢索器則會落在 rate-limited-proxy 開頭的 google.com 名稱上;使用者觸發的抓取器常見 gae.googleusercontent.com 或 google-proxy 開頭的名稱。反向查完再正向確認這一步不能省,因為反向查詢的結果可以被偽造,正反兩次都吻合才算過關。
手動查適合偶爾抽查,要寫進防火牆或監控規則,官方另提供機器可讀的 IP 範圍清單(JSON 格式,涵蓋常見檢索器、特殊用途檢索器與使用者觸發抓取器各自的 CIDR 範圍),比對清單比逐 IP 反查更適合自動化。要注意特殊用途檢索器跑在獨立的 IP 範圍上,所以清單要用對組,拿常見檢索器的清單去驗 AdsBot 會誤判成假的。
遇到假的 Googlebot 該怎麼辦?直接擋。冒用身分的請求不是 Google 來的,封鎖它不會影響真正的 Googlebot,也不會影響搜尋表現;比較務實的做法是在 CDN 或防火牆層做自動驗證,把反查失敗的「Googlebot」當成一般爬蟲處理。真正要留意的是別誤殺:驗證邏輯寫得太窄(例如只認 googlebot.com、漏了 google.com 或 googleusercontent.com),第一個受害的會是真 Googlebot。
往前看,驗證機制正在演化。Google 正在實驗稱為 Web Bot Auth 的密碼學協定,用 RFC 9421 HTTP Message Signatures 讓機器人對請求簽章,站台用公鑰驗證簽章而不必倚賴 IP。但Web Bot Auth 說明頁講得很清楚:這個協定還在實驗階段,目前帶簽章的是 Google 架構上託管的 AI 代理(Google-Agent),不是 Googlebot,而且不是每個請求都帶簽章。在可預期的未來,反向 DNS 加 IP 比對仍是主要驗證方式。
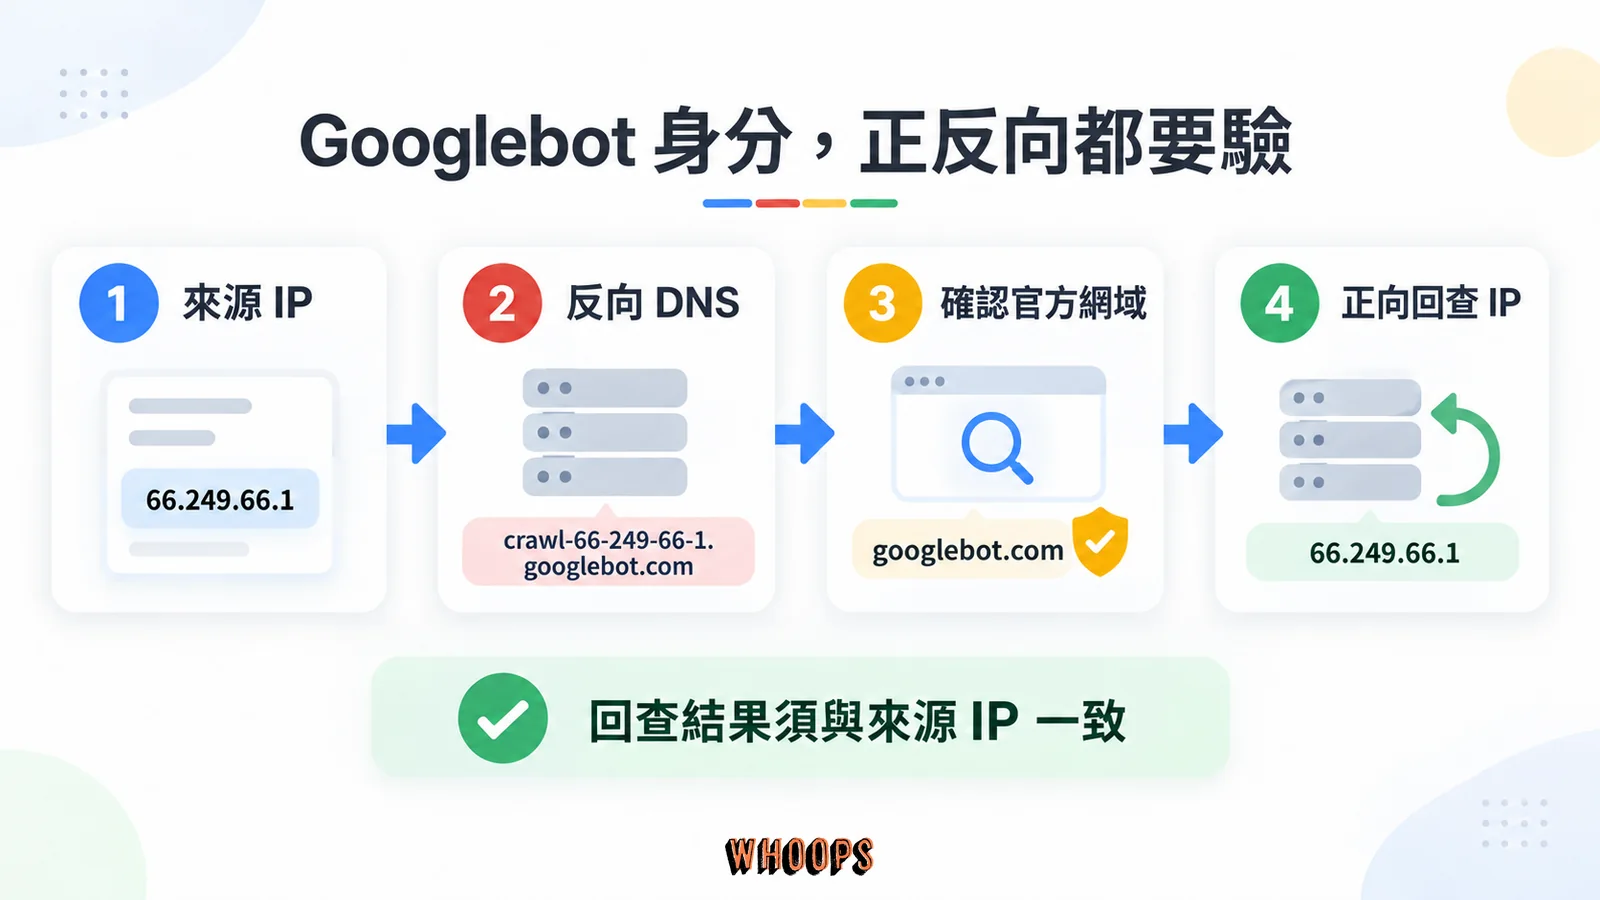
圖中的 IP 與主機名稱採用 Google 官方驗證文件的 Example 1;實際判斷時,請比對自己的請求記錄與官方公布的 IP 範圍。
控制 Googlebot 的常用手段,各自管到哪一層
「我要控制 Googlebot」其實是好幾個不同的願望:不要來抓、不要被索引、摘要不要被引用、來得太頻繁,或是特定檢索器別來。手段選錯,願望就會落空。先看對照表:
每個願望對應的手段是:想讓網址從搜尋結果消失,用 noindex,非 HTML 資源改用 X-Robots-Tag;想省下檢索流量、不在意是否被索引,用 robots.txt 的 Disallow;想控制摘要與 AI 引用,用 nosnippet 或 max-snippet;想完全拒絕存取,上密碼;只是短期被檢索壓垮,用 5xx 或 429 應急並回報。先確定願望是哪一個,再挑手段。
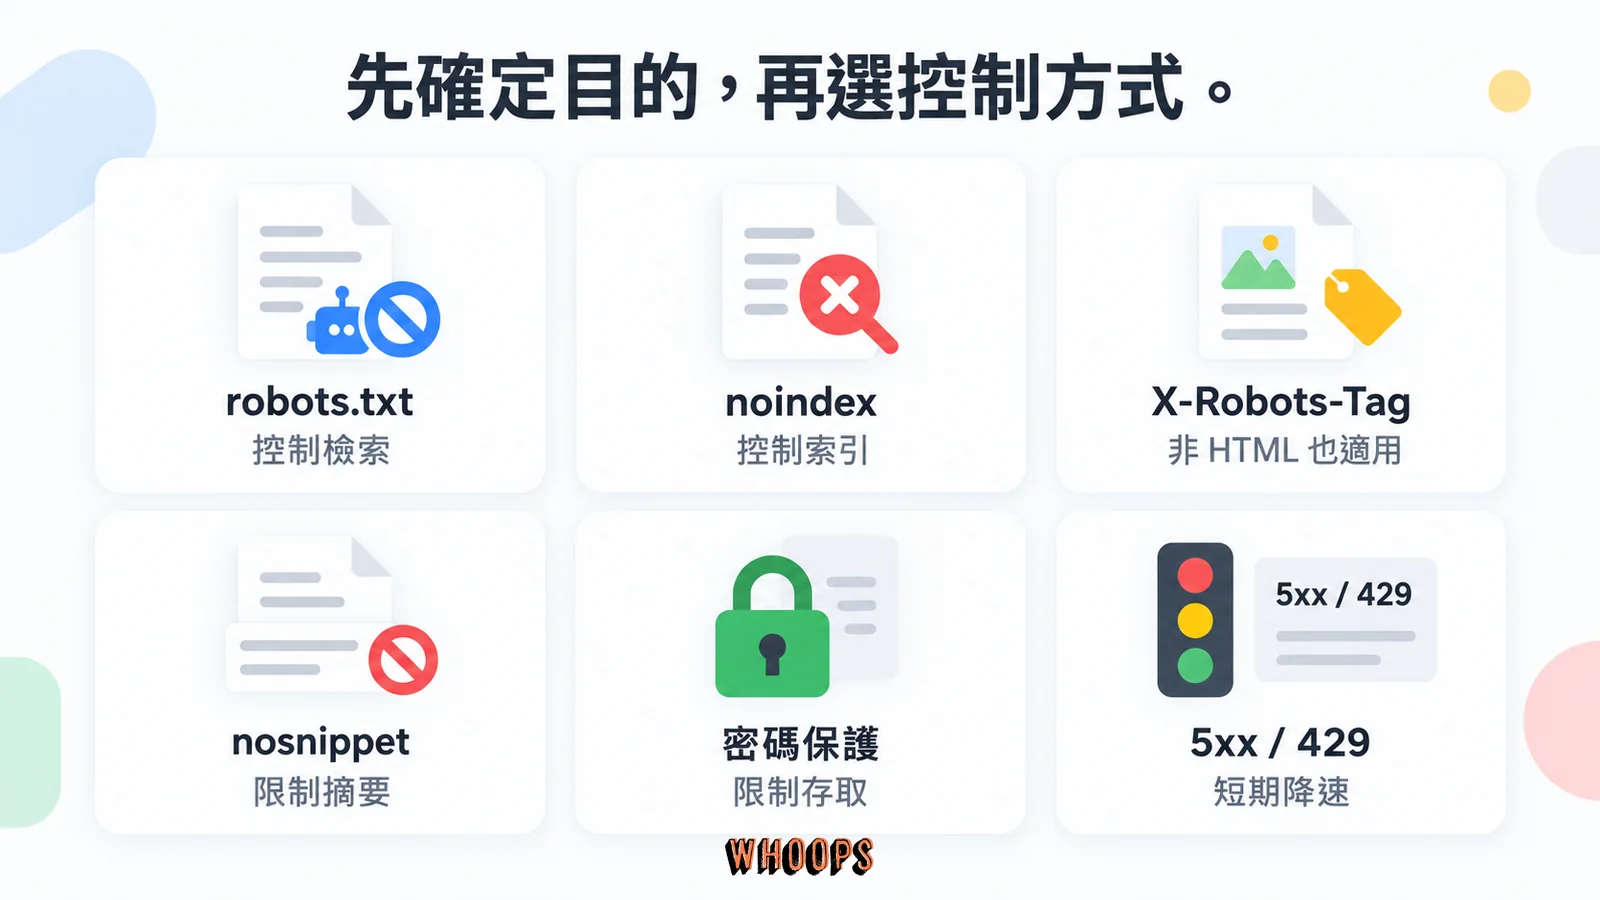
| 手段 | 實際控制的事 | 設定位置 | 關鍵限制 |
|---|---|---|---|
| robots.txt Disallow | 是否檢索(流量層) | 網站根目錄的純文字檔 | 頁面仍可能因外部連結被索引;無法傳遞 noindex |
| noindex meta 標籤 | 是否索引 | 頁面 HTML 的 head | 必須允許檢索,Google 才看得到它 |
| X-Robots-Tag 標頭 | 是否索引(含非 HTML 資源) | HTTP 回應標頭 | 適合 PDF、影片、圖片;規則衝突時從嚴 |
| nosnippet/max-snippet | 摘要呈現與 AI 摘要輸入 | meta 標籤或標頭 | 影響搜尋、AI Overviews 與 AI Mode 的摘要使用 |
| 密碼保護 | 完全阻擋存取 | 伺服器 | 最徹底,等同對所有人關門 |
| 5xx/429 回應或特殊表單 | 檢索速率 | 伺服器回應 | 整個主機名稱一起降速,僅適合短期應急 |
表格裡的密碼保護值得單獨說明。它是唯一連「知道內容」都擋掉的手段:Googlebot 抓不到、索引不到,其他爬蟲也一樣。付費牆、會員區、內部文件區都用這一層;反過來說,如果某個頁面密碼保護只是為了擋索引,那用錯了工具,它擋掉的是所有訪客。
robots.txt:管流量,不是管搜尋結果
robots.txt 的正確理解是流量管理工具:告訴 Googlebot 哪些網址可以抓、哪些不要抓,避免伺服器被不重要的請求塞爆。它的語法、萬用字元與常見誤寫,robots.txt 怎麼寫有完整說明,這裡只講跟 Googlebot 有關的幾件事。第一,規則是按 token 對號入座的,前面提過擋 Googlebot 會連帶影響新聞、圖片、影片,而 AdsBot 這類不吃全域規則的漫遊器要逐一寫明。第二,robots.txt 裡沒有「控制檢索頻率」的有效指令:crawl-delay 這個非標準規則 Google 是直接忽略的。第三,結構上它由一組或多組規則構成,每組以 User-agent 開頭,配上若干 Disallow 與 Allow;沒被擋到的路徑就是預設允許。整個網站共用這一份檔案,任何規則失誤的影響都是全站級的,改動前先驗證語意是必要習慣。
User-agent: Googlebot
Disallow: /private/
這兩行就是最小可用單位:告訴 Googlebot 整個 /private/ 目錄不要抓。不過 Disallow 擋的只有檢索動作,被擋的頁面若被其他頁面連到,網址仍可能以無摘要的條列出現在搜尋結果裡,這條界線就是「禁止檢索不等於禁止索引」。
robots.txt 自己的回應狀態也有語義,而且跟直覺相反。Google 抓不到檔案時若收到 4xx(429 除外),會當成網站沒有任何檢索限制,等於不小心把門全開;若收到 5xx,前 12 小時 Google 停止檢索並持續重試,之後 30 天沿用上一份抓到的正常版本,超過 30 天仍在錯誤,就視為沒有 robots.txt,網站整體連不上時則會停止檢索。檔案本身有 500 KiB 的大小上限,超過的部分直接被忽略。還有一點,Google 通常會把 robots.txt 快取至多 24 小時(重新抓取失敗時可能更久),所以規則變更不會即刻生效,安排封鎖時程時要把這段緩衝算進去。
檢索速率:現在只剩應急手段
Search Console 曾經有檢索速率限制器,讓站方直接設上限,但這個工具已依2023 年 11 月的公告在 2024 年 1 月 8 日退場。現在要壓低檢索量,官方的降速做法是讓網站對檢索請求回應 500、503 或 429,Google 偵測到一定數量後會自動降低對整個主機名稱的檢索頻率,錯誤減少後頻率會自動回升;這招建議只用一兩天,撐太久網址可能被移出索引。沒辦法改伺服器回應時,也可以透過 Search Console 連結的特殊表單回報異常高的檢索量,但要等幾天處理,而且不能要求提高頻率。
降速之前,官方建議先找根因。常見的檢索量大增來源有三種:分面導覽(篩選與排序產生的參數排列)、自動產生大量日期網址的日曆功能,以及動態搜尋廣告的到達頁目標。對這些問題回應 5xx 只是把症狀壓下去,把產生無窮網址的機制收掉,才是讓檢索量回到正常範圍的辦法。這類問題平時幾乎沒有症狀,常常是被忽略的技術 SEO 盲點累積成排名傷害後才被發現。
降速是有代價的:Googlebot 發現新頁面會變慢、既有頁面的內容更新反映會延遲、已刪除的頁面在索引裡停留更久,廣告活動也可能受影響。至於「Google 願意花多少檢索量在你的網站上」這個整體分配,取決於容量與需求兩個軸,這套機制的完整討論在檢索預算一文,本文不重複展開;日常要做的其實就三件事:讓回應夠快、修掉大量 5xx、別讓參數排列組合產生無窮盡的網址。
禁止檢索不等於禁止索引
禁止檢索不等於禁止索引,這是檢索控制裡代價最高的一個誤解。網頁被 robots.txt 封鎖後,Googlebot 不會再抓它,但 Google 仍然可能從別的網站連到這個網址而「知道」它存在;抓不到內容時,搜尋結果裡有可能出現只有網址、沒有標題與描述的陽春條目。robots.txt 基礎說明對此寫得一點都不含糊:robots.txt 不是把網頁擋在 Google 之外的機制,它管的是流量。實務上這種誤會常見於兩種情境:開發中的網站用 robots.txt 擋全站,上線後忘了打開,頁面照樣以陽春條目出現;想下架的頁面被 robots.txt 擋住,noindex 永遠沒機會被讀到,下架遙遙無期。
真正要退出索引,用的是 noindex。但這裡有個先後關係容易搞反:robots meta 與 X-Robots-Tag 的文件說明,這類索引規則是 Googlebot 檢索頁面時才會讀到的;如果同一個網址先被 robots.txt 封鎖,Google 根本進不來,noindex 就像貼在門內的告示,外面的人永遠看不到。要 noindex 生效,該網址必須保持可以檢索。所以「先用 robots.txt 擋、再加 noindex」的組合是自相矛盾的,正確順序是:放行檢索、加上 noindex、等它被重新檢索並退出索引之後,如果不再需要這個網址參與任何檢索,才考慮收緊 robots.txt。
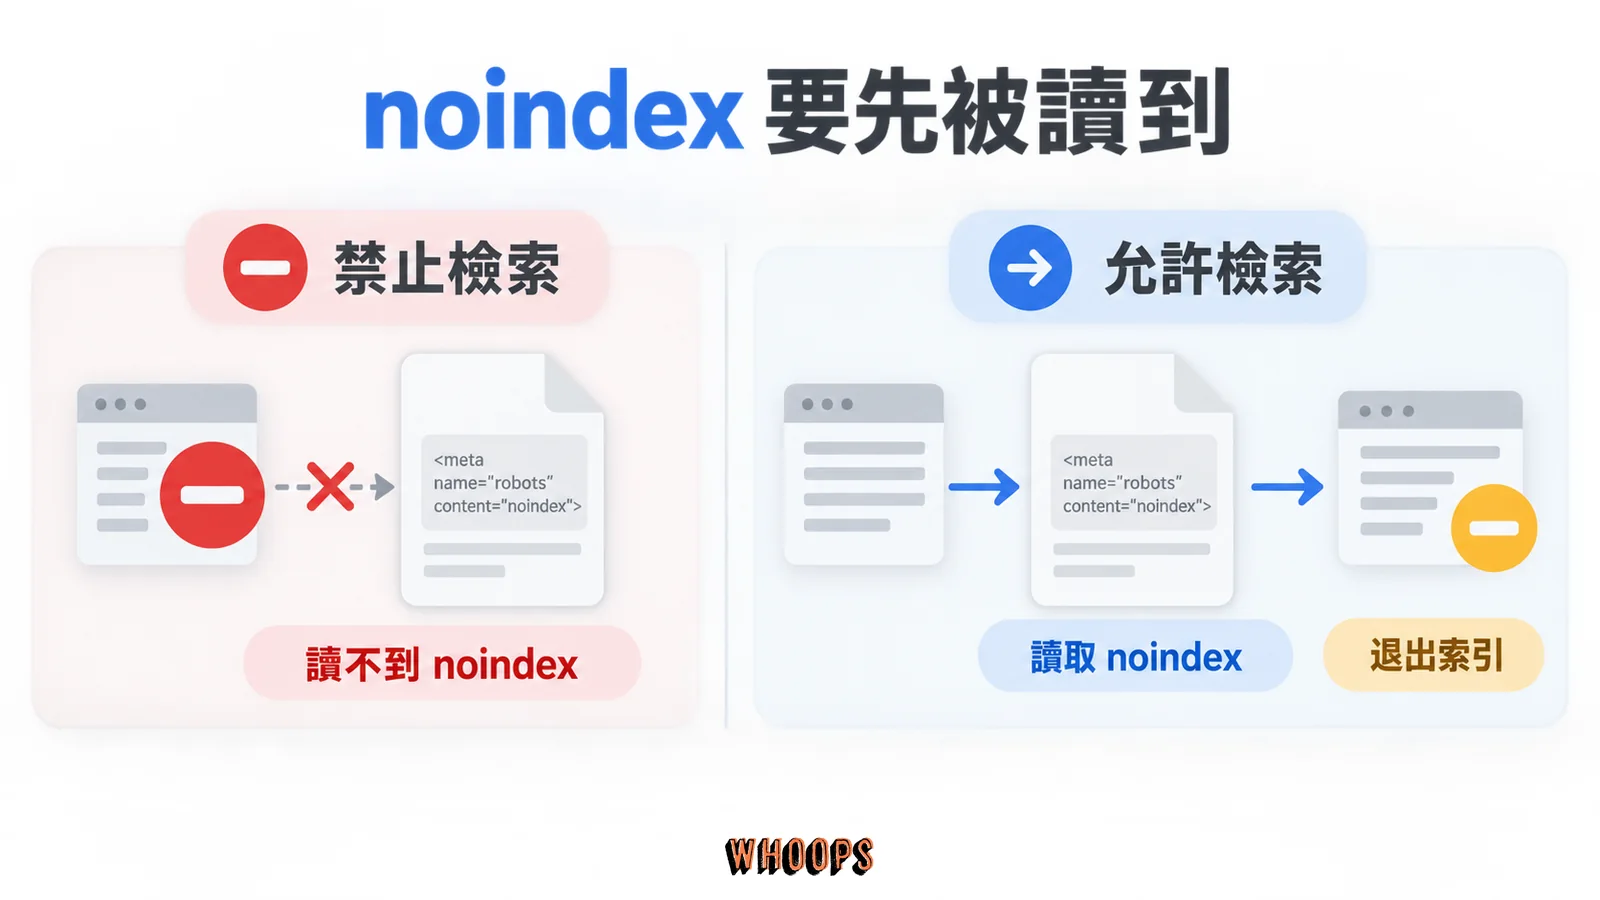
X-Robots-Tag 是 noindex 的另一種形式,差別在位置:它放在 HTTP 回應標頭,因此能管到 PDF、影片檔、圖片這些沒有 HTML head 的資源,也能在伺服器層一次套用到整批檔案。meta robots 通常寫在 head 裡,但 Google 不強制要求位置,出現在內文裡也會被讀到,這對無法改範本的情境是個退路。規則衝突時 Google 從嚴處理,例如同時出現 max-snippet 與 nosnippet,會套用 nosnippet。而當你連「被知道存在」都不想要時,手段就換成密碼保護或直接移除內容,那才是完整的拒絕存取。
noindex 生效需要重新檢索,等待長短取決於該網址平常被回訪的頻率;急著讓頁面消失時,可以移除指向它的內部連結、用網址檢查工具要求重新檢索,情況急迫時走正式的下架要求管道。索引報告裡還有一個跟檢索間接相關的狀態值得認識:替代版本。當 Google 認為某網址是另一個網址的重複或變體,它可能被索引但不會出現在結果裡;標準網址的宣告管道有三個,頁面裡的 rel=canonical 連結、Sitemap 與 HTTP 標頭,你的宣告與 Google 最終的選擇可以在網址檢查工具裡對照。
robots meta 家族裡還有幾個控制摘要呈現的成員。nosnippet 要求搜尋結果不要出現文字摘要與影片預覽,max-snippet 用字數上限控制摘要長度,數字給 0 等同 nosnippet,給 -1 則由 Google 決定;這兩個規則的作用範圍涵蓋網頁搜尋、圖片、Discover,也包括 AI Overviews 與 AI Mode 的摘要輸入。早期的 noarchive 則已經沒有作用,Google 說明快取連結功能下架後,這個規則不再被使用。多個規則可以合併在同一個 meta 或標頭裡;不同機器人的規則同時存在時,效果取所有負面規則的聯集,衝突時從嚴勝出。
Googlebot、GPTBot 與 Google-Extended:三種不同的爬蟲與開關
這幾年站長日誌裡多了 GPTBot、ClaudeBot、PerplexityBot、OAI-SearchBot 這些新訪客,它們跟 Googlebot 的關係常被講混。事實是:它們屬於不同公司、有各自的使用者代理與 robots.txt token、互不代表。以 OpenAI 為例,官方的爬蟲總覽把 GPTBot(模型訓練)與 OAI-SearchBot(搜尋產品)列為不同的機器人,要分開允許或封鎖;允許訓練不代表允許搜尋引用,反過來也一樣。robots.txt 是同一份檔案,但每個機器人只看自己的規則群組。
OpenAI 的清單裡還有兩個角色把這張圖補完整:ChatGPT-User 是使用者親自觸發的抓取,例如有人在對話裡問到某個網頁,這類請求因為由人發起,robots.txt 不一定適用;OAI-AdsBot 驗證廣告到達頁,抓到的內容不用於訓練。OpenAI 也提醒,robots.txt 的變更大約需要一天的時間生效。這些細節指向同一個結論:AI 時代的爬蟲治理是逐家檢視的工作,不存在一體適用的總開關。
Google 自己也有容易混淆的一對:Googlebot 與 Google-Extended。差別在於Googlebot 服務 Google 搜尋,Google-Extended 不是另一個爬蟲,而是 robots.txt 裡的一個控制開關。Google 的檢索器照常檢索你的網站,Google-Extended 這個 token 決定的是抓到的內容能不能用來訓練未來的 Gemini 模型、以及用於 Gemini 應用程式與 Vertex AI 的接地(grounding)。Google 常見檢索器清單明確寫著:它不影響網站在 Google 搜尋的收錄,也不是排名訊號。接地指的是 Gemini 回答時即時參考搜尋索引的機制,換句話說,Google-Extended 的兩個作用面都建立在「內容已經被 Google 檢索」的前提上;一個是做檢索的機器人,一個是決定檢索成果用途的許可開關,兩者寫在 robots.txt 的不同群組裡,各自生效。想退出 Gemini 生態又不影響搜尋,封鎖 Google-Extended 是正確的那一刀;想退出 Google 搜尋,動 Googlebot 才有效,而那也會同時影響新聞、圖片、影片與 Discover。
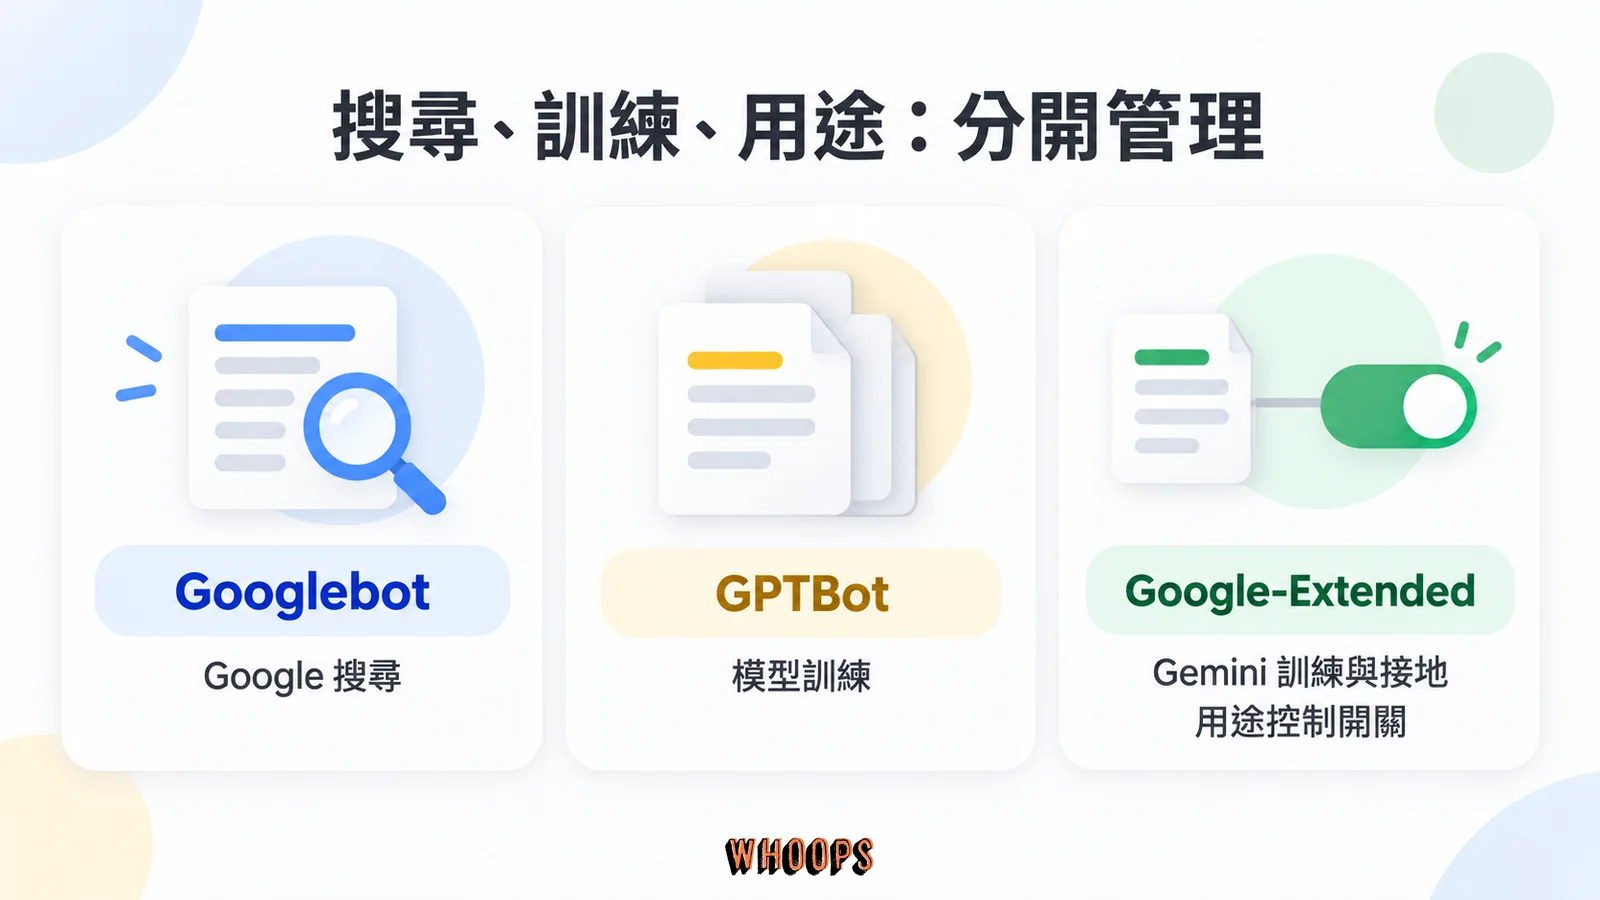
User-agent: Google-Extended
Disallow: /
在 robots.txt 加上這兩行,就是「允許 Google 搜尋、拒絕 Gemini 訓練與接地」的設定。方向相反的誤解也常見:以為擋了 Google-Extended 就不會出現在 AI 摘要裡,等了一個月才發現搜尋結果一切如常,其實兩者本來就不相干。Google 搜尋體系內的 AI 功能(AI Overviews、AI Mode)走的是 Google 搜尋的內容與許可框架,想控制摘要的使用,對應的工具是 robots meta 的 nosnippet 與 max-snippet,而不是 Google-Extended。這兩個題目可以再往Google AI Mode的介紹深入。
對站長來說,這波 AI 爬蟲潮的實際影響是可以觀測的:哪些機器人來、多久來一次、抓了多少流量,伺服器日誌與邊緣記錄都看得到。AI 爬蟲觀測報告整理了這類觀測的做法與發現,值得對照自己的日誌一起看。原則不變:每個機器人獨立驗證、獨立決策,不要用一條規則概括整個生態。
怎麼觀察 Googlebot 來過:伺服器日誌與 Search Console
伺服器日誌:唯一的第一手現場
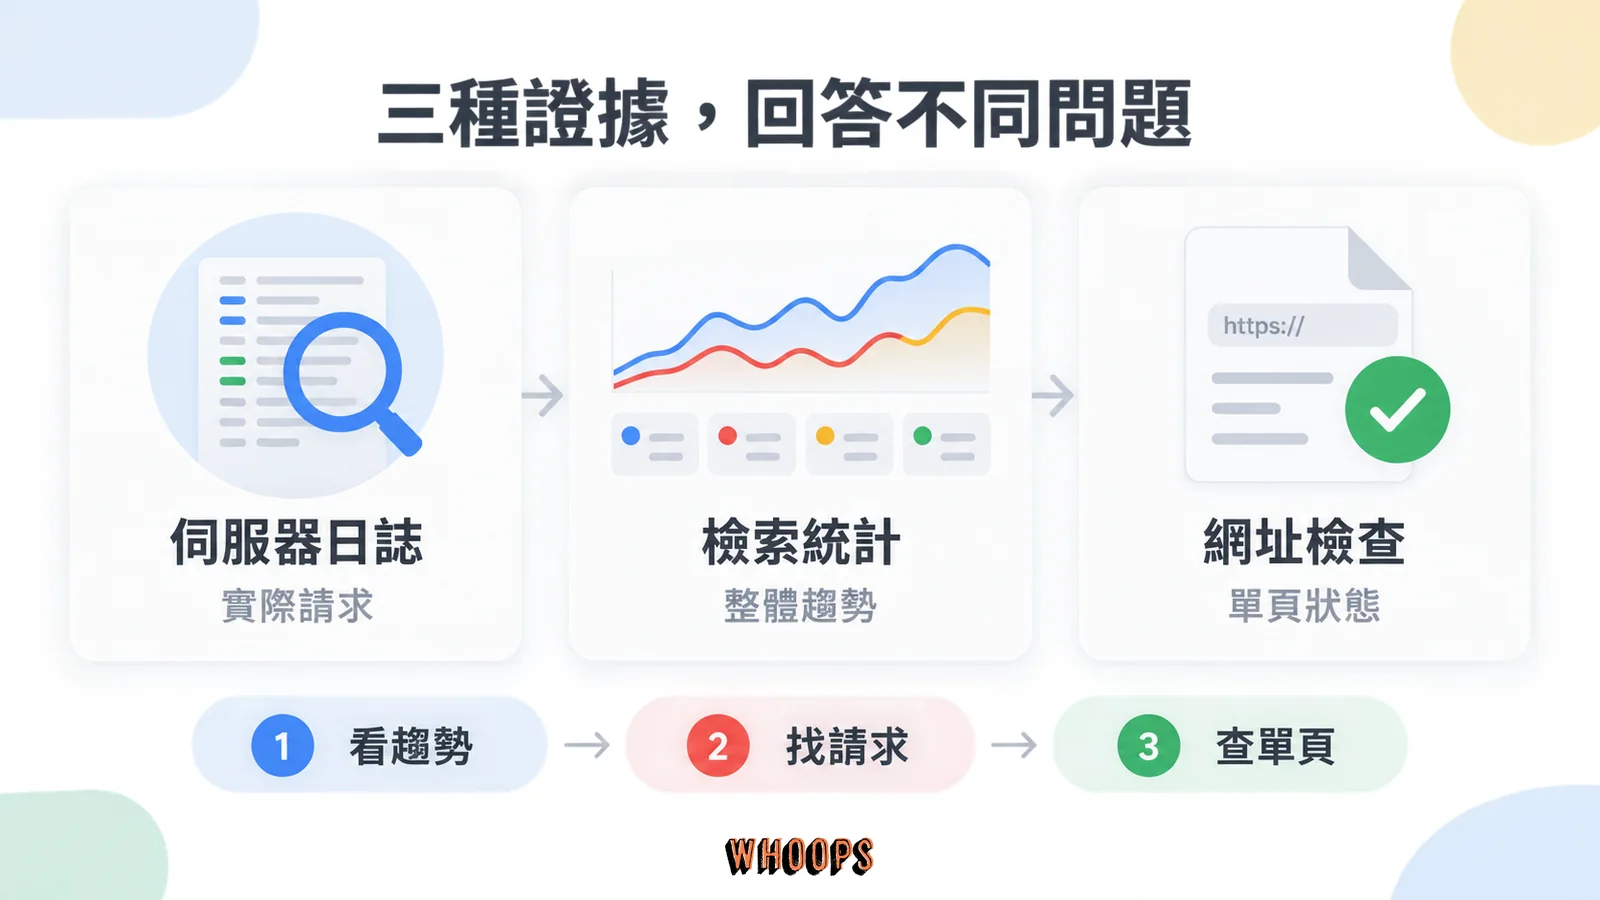
要知道 Googlebot 實際上對你的網站做了什麼,伺服器存取日誌是唯一的第一手資料,Nginx 或 Apache 的 access.log、CDN 的邊緣日誌都算。從日誌裡篩出使用者代理含 Googlebot 的請求,可以看到它抓了哪些網址、什麼時間、拿到什麼狀態碼、從哪個 IP 來。三個提醒:第一,代理字串可以偽造,要做進一步分析前先照前面的反向 DNS 流程過濾真假;第二,Googlebot-News 沒有獨立字串,日誌無法直接區分新聞檢索;第三,頁面資源(CSS、JS、圖片)的請求也會出現在日誌裡,統計頁面檢索量時要記得排除或分開計算。
實務上做日誌分析,取出的欄位至少要有時間戳、請求路徑、狀態碼、使用者代理與來源 IP。先驗證身分,再依路徑分組:哪些目錄被重複抓取、哪些網址回的不是 200、資源請求與頁面請求的比例多少。雲端主機與 CDN 通常都提供原始日誌匯出,拿得到日誌的話,固定頻率做一輪分析就能掌握趨勢。
檢索統計資料報表:官方版的 Googlebot 活動紀錄
沒有日誌權限也有官方替代方案。Search Console 的檢索統計資料報表顯示過去 90 天 Google 對你網站的檢索總量:請求次數、下載量與平均回應時間的趨勢圖,細項可以按回應碼、檔案類型、檢索目的與 Googlebot 種類分組查看,也能檢視主機狀態掌握網站對 Google 的可用度。這套報表是 2020 年 11 月改版後的樣貌,當時的公告與檢索統計資料報表說明列出完整欄位。
分組數字各回答一個問題。回應碼分佈看健康度,非 200 的佔比升高通常代表伺服器或網址結構出了狀況;檔案類型看檢索量的組成,圖片與指令碼占比異常高時,值得回頭檢視頁面的資源設計;檢索目的與 Googlebot 種類則透露 Google 怎麼看待這個網站,例如重新整理既有頁面與發現新頁面的比例、Desktop 與 Smartphone 的消長。使用網域屬性、一個資源涵蓋多個主機的站,還能分別檢視各主機的狀態,一次掌握整個網域的檢索健康。
兩種來源剛好互補:日誌回答「Google 實際上對我的伺服器做了什麼」,報表回答「Google 官方怎麼呈現它的檢索行為」。看到異常時,先在報表確認趨勢,再回日誌找具體請求,是最省力的排查順序。把觀察變成固定節奏更有價值:定期看一輪總量與組成變化,改版或換架構前後各留一份快照,Googlebot 的行為平時是穩定的,異常幾乎都有原因,而原因多半在自己網站上的某次變動。把檢索觀察再往外擴一圈就是整站健檢,SEO 健診怎麼做有系統化的清單與流程可以照著跑。
這支 Search Console 官方教學介紹檢索預算與檢索統計報表,可用來對照請求量、回應時間與主機健康狀態。(Google Search Central 官方影片)
網址檢查工具:單一網址的顯微鏡
針對單一網址,Search Console 的網址檢查工具能看見 Google 眼中的它:上次檢索時間、用 Desktop 還是 Smartphone 檢索、robots.txt 是否允許檢索、頁面抓取是否成功、是否允許索引、宣告與選定的標準網址,以及 Google 是從哪些參照頁面發現它的。它有兩種模式:索引資料來自最近索引的版本,即時測試則當場抓取並渲染頁面,還提供渲染後的截圖。兩個使用上的細節:即時測試會默默跟隨重新導向,測試結果正常不代表原始網址就是被索引的那個;工具對檢查與要求索引都有每日用量限制,適合單點排查,不適合大批操作。網址檢查工具說明提醒了一個更重要的細節:被 robots.txt 封鎖的網址,「是否允許索引」欄位會永遠顯示允許,因為 Google 讀不到裡面的 noindex,這正是前一節那個誤解在工具裡的樣子。Search Console 還有更多與檢索相關的報表,完整的工具地圖可以從Google Search Console 是什麼讀起。
常見誤解:關於檢索的十個錯誤認知
檢索這個主題累積了大量以訛傳訛的說法,Google 官方整理的檢索迷思清單逐一澄清過。以下挑出實務上最常碰到的十個:
- crawl-delay 可以限制檢索頻率。Google 直接忽略這個非標準指令;現在的降速手段是回應 5xx 或 429,或走特殊表單。
- 小網站天生被檢索得少。取決於內容的重要性與變動頻率,經常更新重要內容的小站,檢索頻率不輸大站。
- 舊內容天生吃虧。不會。有用的頁面不會因為年紀大而失寵,重點是品質與持續被需要的程度,新舊不是評斷軸。
- 4xx 回應浪費檢索預算。除了 429,4xx 不算浪費,Google 只是拿到一個狀態碼,代價很低。
- 常常微調頁面會被檢索得更快。改幾個字或更新日期不會帶來更高檢索頻率,價值在內容本身。
- 頁面越快,檢索量就會越多。只對了一半。速度讓 Google 在同樣時間內能抓更多頁,但 Google 也會為了重要內容分配時間給慢站;速度對使用者體驗的意義,遠大於對檢索量的意義。
- 距離首頁越近的頁面越重要。也是一半。首頁直接連結的頁面可能被檢索得較頻繁,但檢索頻繁與排名好沒有等號。
- noindex 可以省下檢索預算。不行,Google 得先檢索才看得到 noindex,該次檢索照樣發生;它的用途是退出索引,不是省流量。
- nofollow 能省下檢索量。不完全。nofollow 只表示這個頁面不背書這些連結,被連到的網址若從其他頁面或站外被連到,仍會被檢索。
- 把 Sitemap 壓縮可以增加檢索預算。沒有幫助,壓縮檔仍要下載解壓,省不了多少檢索成本。
這些誤解有個共同來源:把 Googlebot 想成一個需要討好或對抗的角色。比較有用的心智模型是把它當成一個照規則辦事的自動化訪客,你把規則(robots.txt、狀態碼、meta 標籤)講清楚,把該給的東西(可檢索的 HTML、可執行的資源、真實的連結)準備好,它就會照著做。這些準備不是修一次就結束的工程,而是網站能見度的地基,技術 SEO 的真正價值正是在這種日常維持裡浮現。
關於 Googlebot 的常見問題
Googlebot 一天會來幾次?有辦法讓它多來一點嗎?
沒有固定數字,同一網站的兩次造訪平均間隔通常不低於幾秒鐘,實際頻率由 Google 依內容重要性、更新節奏與伺服器健康度決定。想提高被檢索的機會,做的是基本面:讓內容真正值得被檢索、維持穩定的更新、提交帶正確 lastmod 的 Sitemap、從站內重要頁面連向新內容,必要時用網址檢查工具要求建立索引。Google 明確不接受付費換取更頻繁的檢索。
可以只封鎖 Googlebot Desktop、讓 Smartphone 繼續檢索嗎?
不行。兩種 Googlebot 在 robots.txt 共用 Googlebot 這個 token,規則無法分開套用。而行動優先索引之下,多數檢索本來就來自 Smartphone,封鎖整個 Googlebot 等於同時關掉搜尋、新聞、圖片、影片與 Discover 的內容來源,通常不是你想要的結果。
Googlebot 的 IP 都在美國嗎?
主要在美國,但不是絕對。Google 的說明是檢索流量主要來自美國的 IP 位址,若美國來源被阻擋,可能改從其他國家檢索。所以防火牆規則不要只開放美國 IP 段,以官方發布的 IP 範圍清單為準最穩妥。
用網址檢查工具要求建立索引,多久會生效?
官方說法是通常一天左右,視情況可能到一兩週,而且提交不等於保證索引。這個功能有每日配額限制,適合重要頁面的單點加速;大量網址要進索引,靠的還是 Sitemap 與清楚的站內連結。
降低檢索頻率會影響 Google Ads 廣告嗎?
有機會。Google 在降速文件裡提醒,長期限制檢索可能讓廣告活動被取消、暫停或停止放送,因為廣告系統對到達頁面與內容的掌握也依賴檢索。AdsBot 是獨立的機器人、有自己的 robots.txt 規則,但把 Googlebot 擋掉對廣告生態的影響會超出搜尋本身。
noindex 或 nofollow 可以減少 Googlebot 的造訪嗎?
都不能直接減少。noindex 要 Google 檢索後才讀得到,該次請求照樣發生,長期來說頁面退出索引後檢索量會慢慢下降,但那是間接效果;nofollow 只代表這個頁面上的連結不跟隨,被連到的網址若從其他地方被連到,仍會被檢索。要控制檢索量,正規手段是 robots.txt 的 Disallow。
Googlebot 檢索會吃掉我的主機流量或拖慢網站嗎?
會消耗流量,但 Google 主動限制自己:對同一網站的造訪平均間隔數秒以上,單一檔案預設最多抓前 15MB,並用 ETag 等快取機制避免重複下載沒變的內容。一般網站不需要特別處理;真的遇到檢索壓力,先看檢索統計資料報表確認請求量與來源網址,再用前述的短期降速手段處理。
robots.txt 修改之後,多久會對 Googlebot 生效?
Google 通常會把 robots.txt 快取至多 24 小時,重新抓取失敗時可能更久,所以規則變更不是即時生效。安排大範圍封鎖或解封時,把這段緩衝期算進時程;解封後可以用網址檢查工具確認 Google 讀到的是不是新版規則。
Googlebot 一直來抓 CSS 和 JavaScript 檔,正常嗎?
正常,而且是必要的。頁面上參照的每個資源都是分開抓取的,Google 要拿到樣式與指令碼才能完整渲染頁面;這些請求同樣受大小限制規範。把 CSS 或 JS 從 robots.txt 擋掉,省下的流量有限,代價卻是 Google 看到的頁面不完整,是典型的因小失大。
怎麼封鎖 Googlebot?封鎖之後會發生什麼事?
在 robots.txt 用 User-agent: Googlebot 搭配 Disallow 指定路徑,就能擋下相應的檢索流量。被封鎖的頁面不會被檢索,但只要有其他頁面連向它,網址仍可能以無摘要的條目出現在搜尋結果裡。要真正退出索引改用 noindex,要完全拒絕存取則用密碼保護或伺服器端封鎖。

討論與提問