
本篇內容
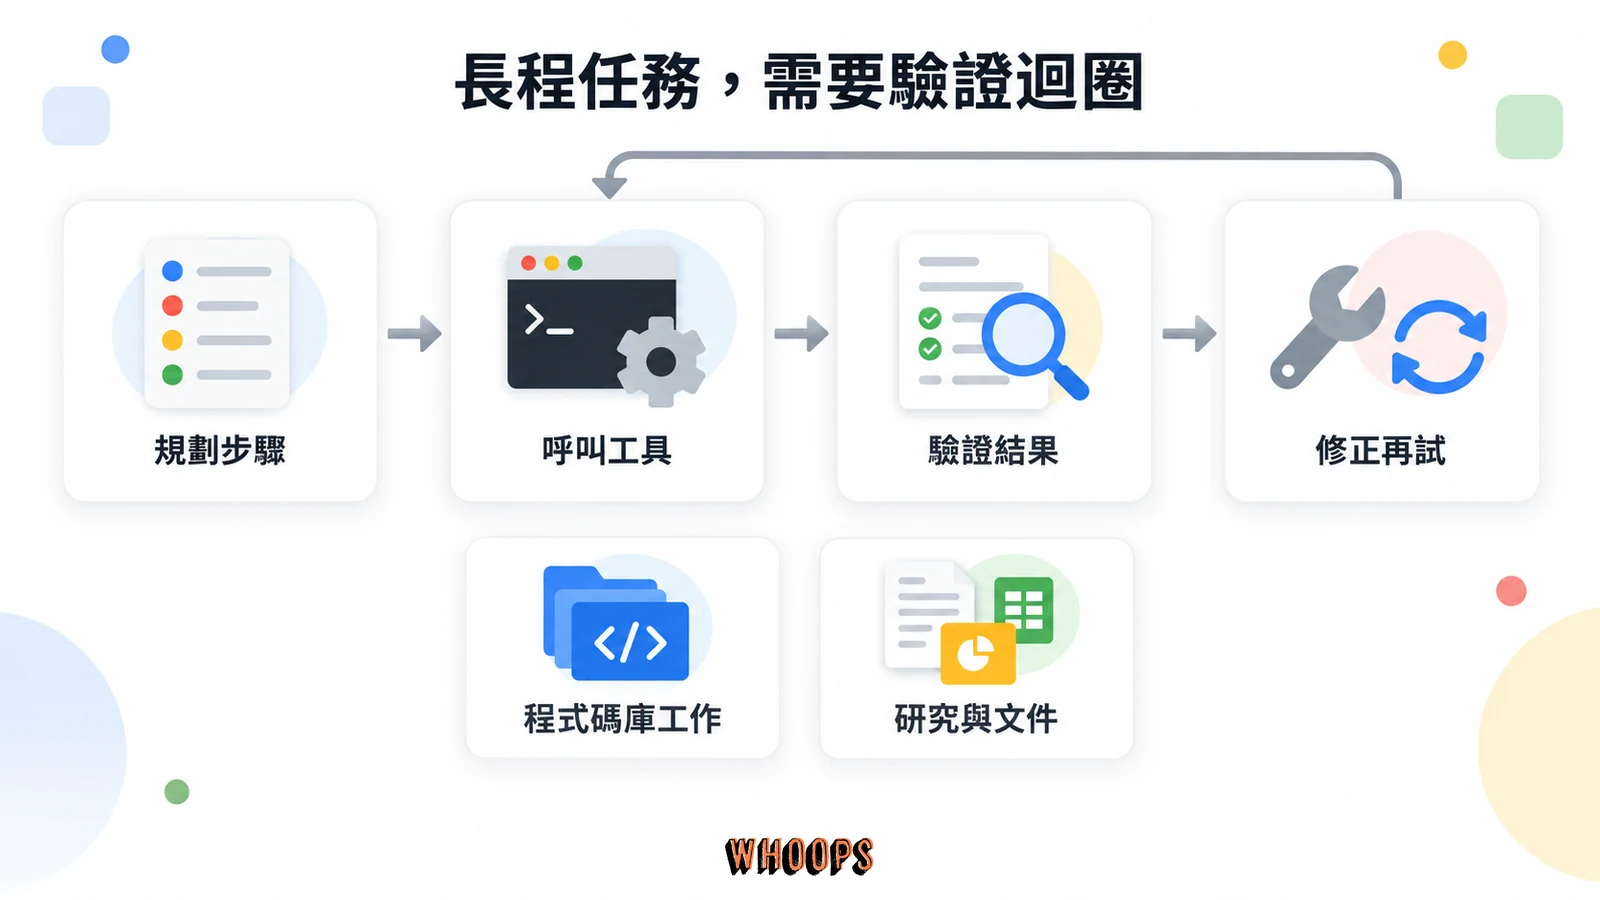
Claude Fable 5.1 是 Anthropic 在 2026 年 9 月 1 日發布的 Claude 模型,主要用於高難度推理與長時間自主執行的 agent 工作。它與僅限審核組織使用的 Claude Mythos 5.1 共用同一組模型權重,差別在安全防護與開放範圍。典型任務包括跨程式碼庫重構、多日研究分析,以及需要核對大量交叉引用的文件工作;模型必須自行規劃步驟、呼叫工具並修正失敗環節。
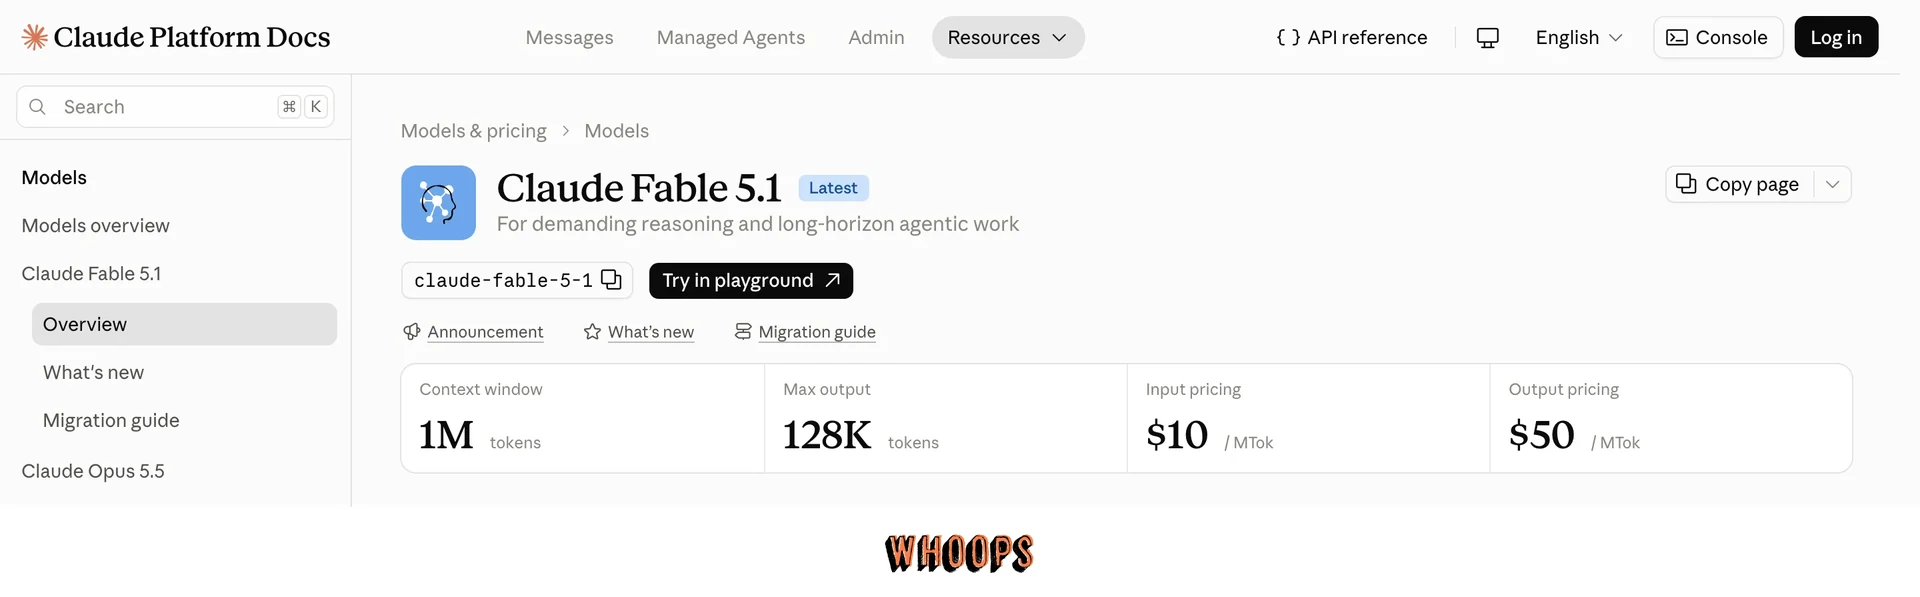
規格與價格方面,Fable 5.1 提供 1M token 的上下文視窗與同步 Messages API 128K token 的最大輸出,API 定價為輸入每百萬 token 10 美元、輸出 50 美元,單價與前代 Fable 5 完全相同;真正的降價發生在快取讀取,從原本的十分之一輸入價再壓到每百萬 token 0.25 美元。官方估計,這讓典型工作負載的總成本比 Fable 5 低約 25%,快取讀取占比最高的高度代理型工作最多可省約 45%。
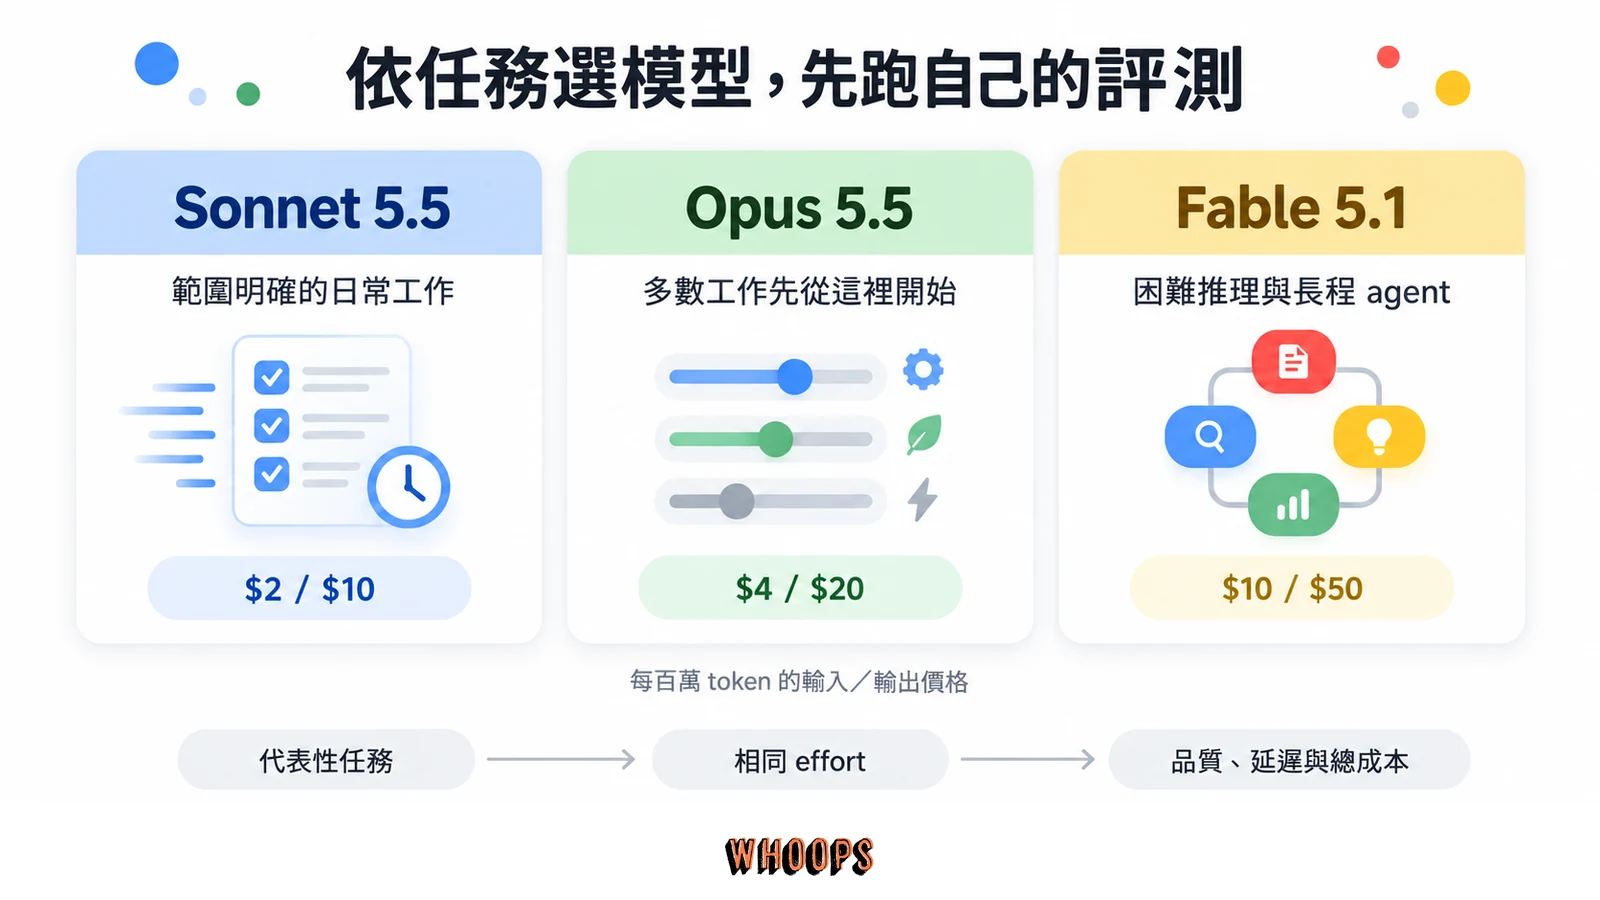
選擇模型時,官方文件建議多數工作負載先用 Claude Opus 5.5。當你調高 Opus 5.5 的 effort(控制思考投入程度的參數)後,自己的評測仍達不到要求,或任務需要長程 agent 與高難度推理,再比較 Fable 5.1。
Claude Fable 5.1 於 2026 年 9 月 1 日發布,Anthropic 當時將它定位為最強的一般可用模型;它與受限發布的 Mythos 5.1 共用權重,差別在安全防護與開放範圍。
1M token 上下文、同步 Messages API 128K 最大輸出;API 定價輸入 10 美元、輸出 50 美元(每百萬 token),快取讀取 0.25 美元,典型工作負載成本比 Fable 5 低約 25%。
被安全分類器標記的資安與生物相關請求可能轉給 Opus 模型處理;API 拒絕與重試的費用須按官方計費規則判斷。使用 Fable 預設需要 30 天資料保留。
選擇原則:多數工作用 Opus 5.5;長程 agent、高難度推理、或 Opus 5.5 高 effort 仍不足的場景才用 Fable 5.1。
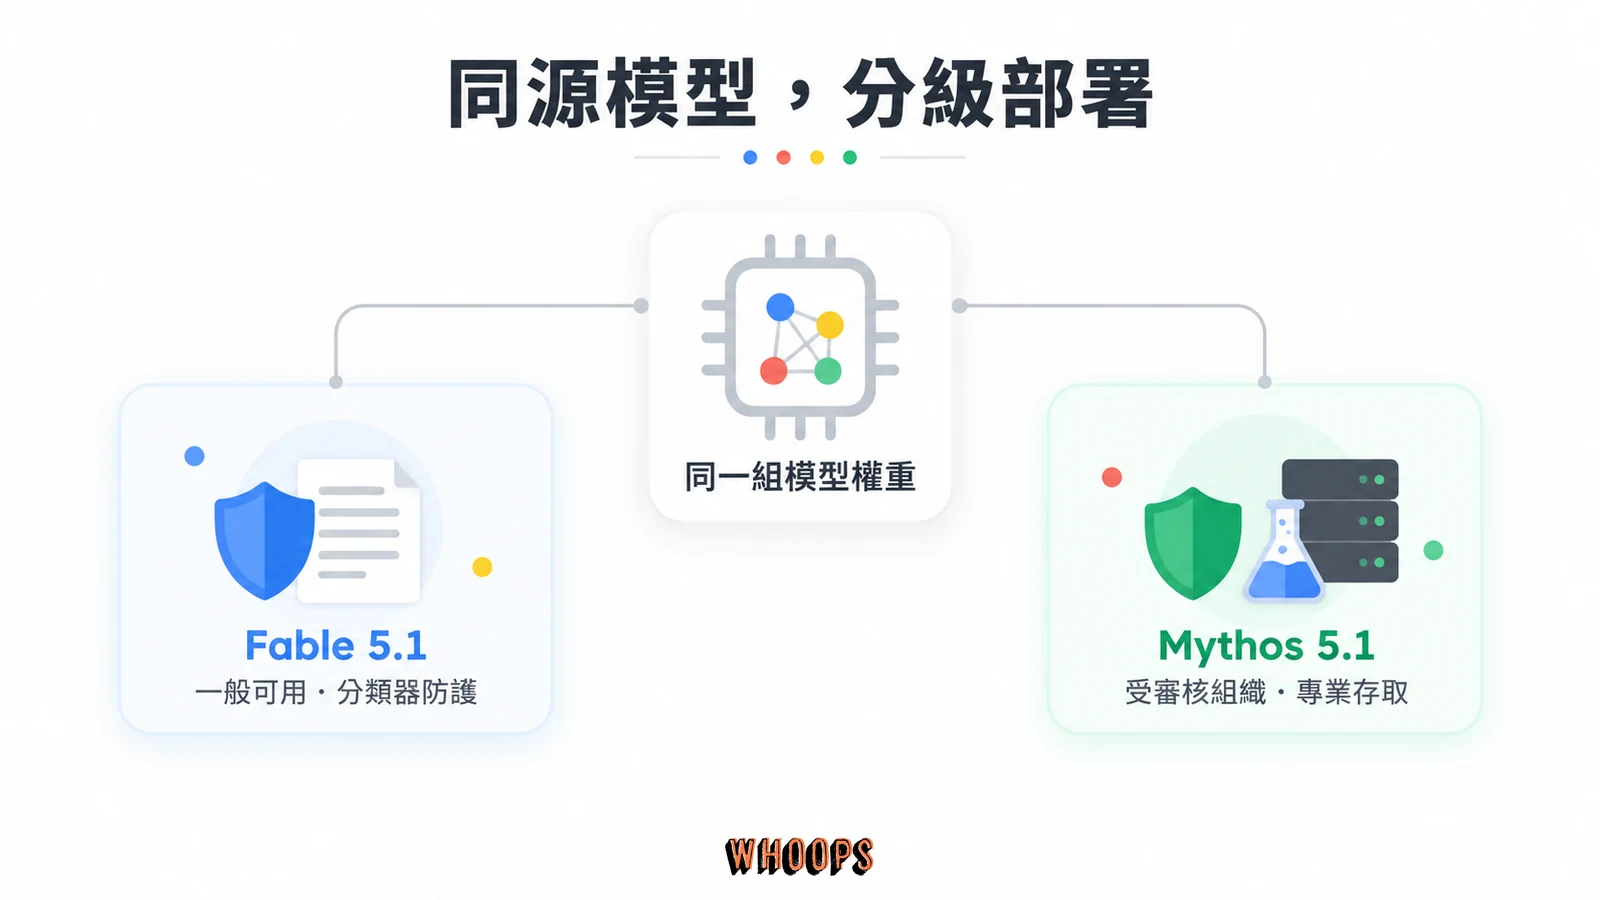
Fable 5.1 是什麼:與 Mythos 5.1 同源的分級部署
Anthropic 的 Claude 產品線包含 Fable、Opus、Sonnet、Haiku 等級,Fable 產品頁將它定位於高難度、長時間執行與非同步工作。想先補齊 Claude 家族整體輪廓,可以參考站上的 Claude 入門與模型家族總覽。
Fable 5.1 與 Mythos 5.1 是同一個模型採用不同的安全設定。Anthropic 在 9 月 1 日的發布公告說明,兩者能力相同,差別在防護等級。Fable 5.1 一般可用,可透過付費 Claude 方案或 API 等入口使用,針對資訊安全與生物學等領域設有自動分流的安全分類器;Mythos 5.1 則透過信任存取計畫提供給審核過的組織,防護設定供網路安全防禦者與生命科學研究者工作使用。
官方在公告開頭將這兩個模型描述為「全球最先進的編碼與知識工作模型」,並強調其研究能力是 AI 模型將對科學進展做出貢獻的早期預覽。這個說法對應到發布當天 @claudeai 帳號的公告串,從定位、基準成績到定價調整一次說完:
We’re introducing Claude Fable 5.1 and Claude Mythos 5.1.
— Claude (@claudeai) September 1, 2026
They're the world’s most advanced models for coding and knowledge work. pic.twitter.com/8P9PSrWPi3
Fable 5.1 屬於 Claude 第五代(Claude 5 family)。Opus 5.5(9 月 22 日)與 Sonnet 5.5(9 月 28 日)陸續推出後,官方文件仍列出 Fable 5.1,形成「Fable 5.1、Opus 5.5、Sonnet 5.5」並存的狀態。三者的知識截止日期都是 2026 年 6 月,能力、價格與反應速度則各有差異。
從 Fable 5 到 5.1:三個月的升級,中間穿插一段出口管制插曲
Fable 5.1 距離前代 Fable 5 只有不到三個月,而 Fable 5 這三個月過得並不平靜。Fable 5 與 Mythos 5 在 2026 年 6 月 9 日發布,三天後的 6 月 12 日,美國政府以國家安全為由發出出口管制指令,要求暫停所有外國籍人士存取 Fable 5 與 Mythos 5;由於無法只對外國籍用戶關閉服務,Anthropic 在當天的公開聲明中說明,被迫對全體客戶停用這兩個模型。聲明中揭露,政府的依據是一個窄域的潛在越獄技術展示,Anthropic 驗證後認為同等能力在其他公開模型上也能取得,並不同意以此為由召回已部署給數億人的商業模型。
7 月 1 日,模型帶著新的分類器在全球重新上線。Anthropic 在官方帳號的說明中交代了重新上線的條件:與美國政府的一系列溝通、針對更多資安任務的分類器、以及與 Amazon、Microsoft、Google 等合作夥伴共同起草的越獄嚴重度評估共識框架:
Claude Fable 5 will be available again globally tomorrow.
— Anthropic (@AnthropicAI) July 1, 2026
After a series of productive conversations with the US government, we're redeploying the model with a new set of classifiers to target and block more cybersecurity tasks. In the near term, some routine tasks like coding…
重新上線初期有部分日常編碼與除錯請求暫時 fallback 到 Opus 4.8,8 月 6 日 Anthropic 又公布了生物安全防護的改進。9 月 1 日的 5.1 版進一步調整防護:官方估計,Claude Code 每個工作階段的資安防護介入約減少 60%,基礎生物學與醫療良性請求觸發防護的比例約減少 85%。輸出入單價維持不變、快取讀取降到前代的四分之一,並改善長時間代理式編碼、多步驟研究,以及文件、試算表與投影片工作。
官方評測看能力:長程 agent、知識工作與科學研究
以下成績來自 Fable 5.1 的 9 月 1 日發布公告,測試時啟用生產環境安全防護。OSWorld 2.0 中 Fable 5.1 與 Fable 5 被防護介入的任務,以及 AutomationBench 中 Fable 5 被介入的任務,直接記為失敗;其他被介入的資安任務改由 Claude Opus 4.8 完成,生物任務改由 Claude Opus 5 完成。官方註明,這可能壓低 Fable 5.1 與 Fable 5 的分數。
| 基準測試 | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1(代理式科學研究) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0(代理式編碼) | 55.8% | 42.0% | 52.3% | 37.3% |
| Terminal-Bench 4.0(Mythos 5.1,同模型放寬防護) | 60.9% | 不適用 | 不適用 | 不適用 |
| Humanity’s Last Exam(不用工具) | 60.9% | 57.8% | 56.6% | 未公布 |
| Humanity’s Last Exam(用工具) | 65.0% | 63.8% | 63.6% | 未公布 |
| GDPval-AA v2(知識工作) | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0(電腦操作,partial) | 77.9% | 72.9% | 75.4% | 未公布 |
| OSWorld 2.0(strict) | 41.7% | 36.1% | 39.6% | 未公布 |
| AutomationBench(商業流程) | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0(代理式編碼) | 73.4% | 70.5% | 70.0% | 67.2% |
幾個數字值得單獨解讀。Terminal-Bench-Science 0.1 從 Fable 5 的 24.7% 跳到 52.6%,超過一倍,這個項目測的是模型在終端環境裡完成科學研究任務的能力,也是官方公告串第一個點出的數字。Terminal-Bench 4.0 的 55.8% 對上 Fable 5 的 42.0%,而同一張表裡的 Mythos 5.1 拿到 60.9%,官方解釋兩者差距正好對應舊版資安防護介入的任務,5.1 改版後預期差距會明顯縮小,這是「同一模型、不同防護」最具體的量化證據。Humanity’s Last Exam 拿到不用工具 60.9%、用工具 65.0%,知識工作的 GDPval-AA v2 得分 1853,都高於前代與 Opus 5;商業流程的 AutomationBench 從 17.1% 翻到 31.4%,幾乎翻倍。
effort 與成本的關係是官方評測裡另一個實用的訊號:設為 Low 或 Medium effort 時,Fable 5.1 能以低得多的成本達到與 Fable 5 相近或更好的結果,這表示同一個模型可以依任務難度調整「思考預算」,不必為了省錢換到較弱的模型。讀這些分數也要留意統計噪音:官方註明 Terminal-Bench-Science 0.1 的每模型標準誤達 ±3.5 到 4.5 分,公開排行榜上 Opus 5 的 30.0% 與 Fable 5 的 21.4%,在官方重現時是 29.0% 與 24.7%,都在誤差範圍內。OSWorld 2.0 用的是 2026 年 8 月版的任務集,與早期版本的分數不可直接比較,所以該欄沒有競爭者成績。對採購者的意思是:單一項目幾個百分點的差距不足以當決策依據,差距要大到超出誤差、而且出現在你自己的任務類型上,才有意義。
官方同步發布了一支介紹影片,把「擅長複雜、長時間執行的任務,避開捷徑並修復問題根因」這些重點濃縮成短影片說明:
早期測試者的實際回饋:根因分析與無人值守
基準分數之外,官方公布了二十多家早期測試機構的回饋,其中幾個案例比百分比更有參考價值。投資公司 Millennium 回報,內部系統有一個約百萬分之一機率才觸發的當機,團隊工程師和其他模型試了四五年都沒能解釋,Fable 5.1 是第一個找到根因的:它拆解外部廠商的函式庫、比對 core dump、把當機追溯到該函式庫的 bug。這個案例展示的不是「寫程式很快」,而是長鏈路的證據推理,正是 Fable 定位的核心能力。
長時間無人值守是另一個反覆出現的主題。金融科技公司 Ramp 讓 Fable 5.1 在一個機器學習問題上連續跑了 38 小時:它把先前的結果診斷為標籤瑕疵、修正後平行啟動六個實驗跑過夜,帶著結果與下一步回來;給它一個開放式提示去找「沒人認領的最高槓桿問題」,它挖出一個與生產事故相關、無人負責的告警,拉出日誌並開出修法。瀏覽器代理公司 Browserbase 在自家最難的瀏覽器 agent 基準上量到 Fable 5.1 完成 82% 的任務,高於 Opus 5 的 74% 與 Fable 5 的 57%,用的 token 還更少,且數百個受測任務中從未越過關鍵停止點。文件分析公司 Hebbia 則回報在 PowerPoint 與引用查核的評測中,Fable 5.1 產出他們測過所有模型中最好的投影片與事實回憶。這些都是廠商提供的測試者說法,採購決策時可當方向參考,實際表現仍應用自己的工作負載驗證。
成本面的測試者回饋同樣具參考性。經營 Devin 的 Cognition 說,他們在發布當天就把原本跑在 Opus 5 上的流量移到 Fable 5.1,測試中它以更低的每任務成本追平或超越 Fable 5,新的快取讀取價格讓部分原本留在 Opus 上的工作負載變得划算。Samaya 的 Yuhao Zhang 則回報,Fable 5.1 在 FrontierFinance 基準的成績從 Fable 5 的 49.2% 升到 55.9%,並更常直接查閱法說會逐字稿等一手來源。這些回饋由 Anthropic 發布公告收錄,成本與研究品質仍須以自己的任務驗證。
科學研究能力:從蛋白質設計到金星地圖
科學研究是這次發布的另一條主軸,官方稱之為 AI 模型對科學進展貢獻的早期預覽。在分子設計上,研究團隊給 Mythos 5.1 開源蛋白質設計與摺疊工具,再把設計送交兩個外部組織實驗驗證:官方在指定比較範圍內報告,EGFR、Nipah G、15-PGDH 三個標的的結合親和力約為對照設計的十倍;十二個標的的整體命中率接近 50%,而目前業界典型命中率是 10% 到 15%。在計算分析上,Fable 5.1 用 NASA Magellan 任務三十年前拍攝的雷達影像訓練類神經網路,為金星三分之一的地表做出新的高解析度地形圖,細節從過去的 10 到 20 公里推進到 2 到 3 公里,高度準確度提升最多 25%,地圖以創用 CC 授權公開釋出,供後續 NASA VERITAS 與 ESA EnVision 任務參考。
算力成本也有實際成果。Mythos 5.1 為七個開源深度學習模型撰寫客製 GPU kernel 並快取中間結果,把推論速度提升最多 2.5 倍且輸出完全相同;在基因體學這類會把模型跑上千次的全基因體分析上,估計可省下 30% 到 60% 的 GPU 成本,這種最佳化過去需要一組效能工程師花數週,學術實驗室通常負擔不起。發布三週後,Anthropic 又公布 Claude 在科學家只給高階方向的情況下,發現了一個帶有類 CRISPR 重複序列特徵的新穎酶系統,並宣布成立生命科學研究團隊與實驗室。對一般開發者來說這些案例距離日常較遠,但它們說明了 Fable 等級的模型被設計來處理的問題複雜度上限在哪裡。
規格與 API 重點:1M 上下文、adaptive thinking 與三個 breaking changes
進到工程細節,Fable 5.1 的核心規格是:1M token 上下文視窗(官方換算約 55.5 萬英文字或 250 萬 Unicode 字元)、同步 Messages API 最大輸出 128K token、輸入支援文字與圖片。思考模式只有一種:adaptive thinking 永遠開啟,由 effort 參數控制思考深度,API 上的預設 effort 是 high,延遲等級在現行產品線中屬於最慢的一檔,可靠的知識截止日期為 2026 年 6 月。模型 ID 在 Claude API、Google Cloud、Microsoft Foundry 與 Claude Platform on AWS 上都是 claude-fable-5-1,在 Amazon Bedrock 上是 anthropic.claude-fable-5-1。官方的模型文件頁把這些規格、各平台 ID 與生命周期狀態整理成單頁:狀態為 Active(最新版),承諾不早於 2027 年 9 月 1 日退役。
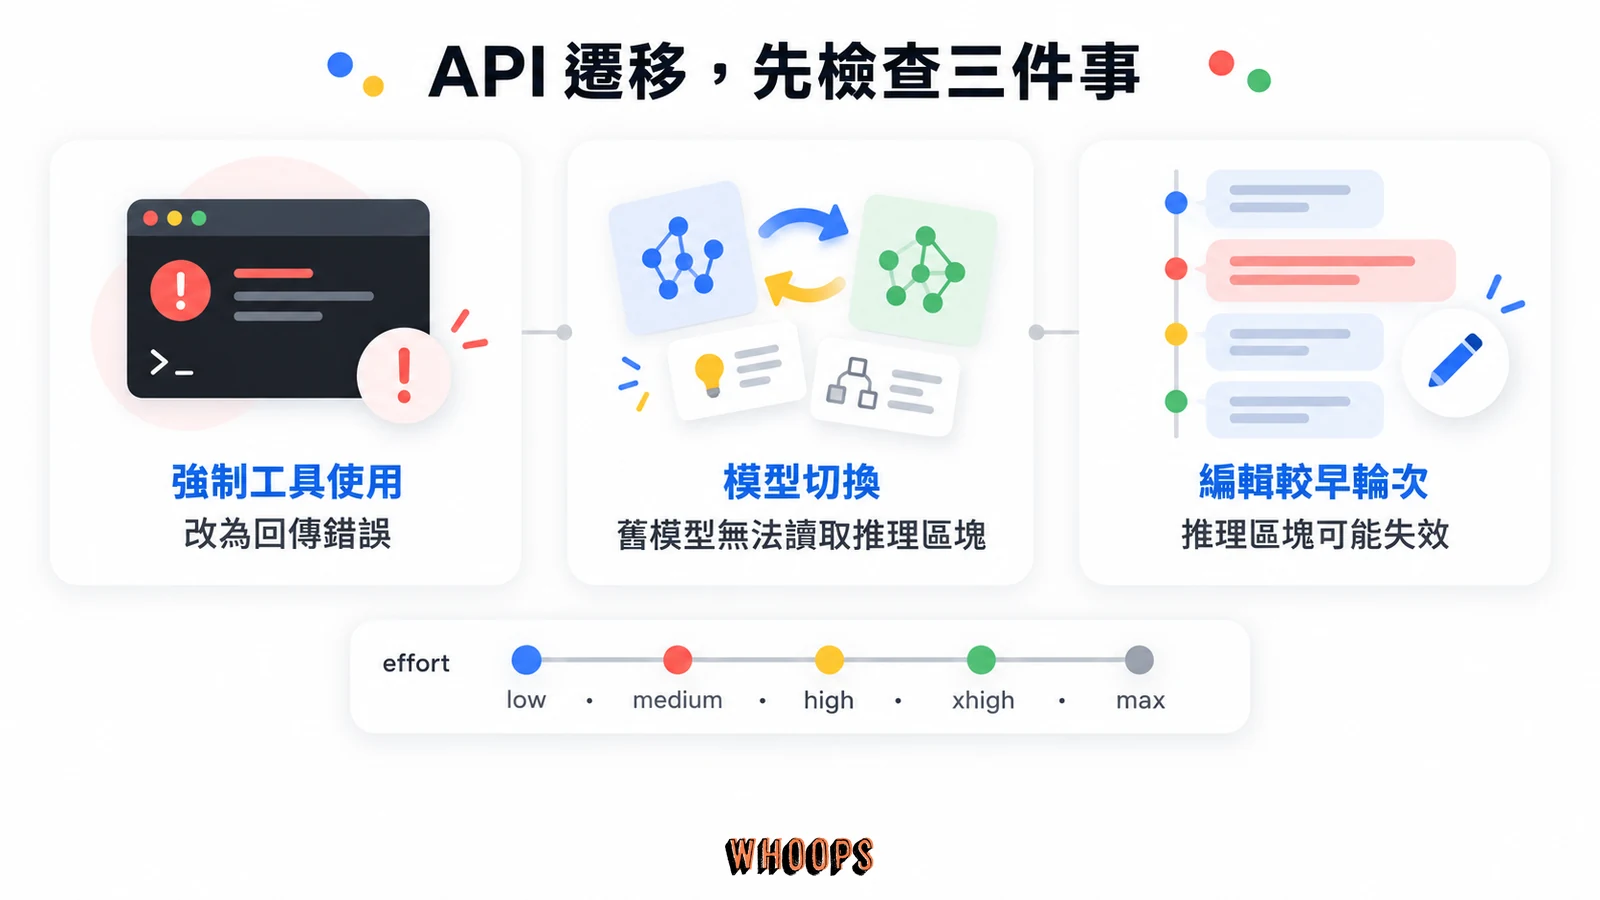
已經在用 Fable 5 的團隊升級前要看官方的變更清單,其中三項是不相容變更。第一,Fable 5.1 不支援強制工具使用,硬要指定會直接回傳錯誤。第二,它的 thinking blocks 綁定產生它的模型,舊模型讀不到;當路由器或 fallback 在對話中途把請求切到其他模型時,API 會在模型看到之前丟棄讀不了的 thinking block,丟掉的部分不計入 input_tokens 也不計費,掛上對應的 beta header 後可在回應的 input_transformations 欄位看到丟棄紀錄。第三,編輯對話中較早的輪次會使 thinking blocks 失效。這三項都圍繞同一個設計:把模型的推理過程和產生它的模型綁定,避免上下文被編輯後推理紀錄失去意義,這也與後文要講的反蒸餾機制有關。
新增的能力有五項。per-message effort(beta)允許在同一個對話中逐則訊息調整 effort,且不會使 prompt cache 失效,這對「先用 high 深挖、再用 low 收尾」的成本控制很有用。turn-scoped system messages(beta)讓系統訊息可以只作用於單輪。progress updates between tool calls(beta)把模型在工具呼叫之間寫的簡短進度說明以 display: "updates" 設定轉成可顯示的文字,reasoning 內容仍然隱藏,適合做有進度回報的 agent 介面。content provenance 則讓 Fable 5.1 產出的文字在所有平台都帶有 Anthropic 的統計式浮水印,經由程式執行工具產生的圖片、影片與音訊檔也附帶出品來源資訊。第五項是快取讀取降價,屬於定價變更,下一節細談。
Fable 5.1 的 adaptive thinking 永遠開啟,模型自行決定思考深度;effort 參數是投入程度的指引,支援 low、medium、high、xhigh、max 五檔,而不是嚴格的 token 上限。同一個基準在不同 effort 下,成績與成本都可能改變。要跨模型混用對話的團隊,也要核對 preserved thinking 的支援條件:不相容的模型切換或對話編輯,可能使既有 thinking blocks 被丟棄,影響推理狀態與長程任務的連續性。
整合 API 時,要明確處理 HTTP 200 回應中的 stop_reason: "refusal",並讀取 stop_details.category。可設定 server-side fallback 或 SDK middleware 來重試,但官方拒絕與 fallback 文件說明:輸出前的 bio、frontier_llm、reasoning_extraction 拒絕會計費;串流中拒絕則收取輸入與已產生的輸出費用,fallback 請求另按實際模型計費。相較 Fable 5,官方文件也指出,5.1 的瀏覽器與桌面操作更可靠,失敗步驟的復原能力更好,多語表現則相當。
價格結構:單價不變,快取讀取降 75% 才是真正的降價
Fable 5.1 的計費方式按 token 用量分項如下:輸入每百萬 token 10 美元、輸出 50 美元、5 分鐘快取寫入 12.50 美元、1 小時快取寫入 20 美元、快取讀取 0.25 美元,Batch API 的輸出入一律半價。對照官方一般費率,快取讀取通常是輸入價的 10%,Fable 5.1 壓到 2.5%,等於比自己的常規折扣再降 75%。
| 計費項目 | Fable 5.1(美元/每百萬 token) | 說明 |
|---|---|---|
| 輸入 | $10 | 與 Fable 5 相同 |
| 輸出 | $50 | 與 Fable 5 相同 |
| 快取寫入(5 分鐘) | $12.50 | 輸入價的 1.25 倍 |
| 快取寫入(1 小時) | $20 | 適合長時間重讀的場景 |
| 快取讀取 | $0.25 | 輸入價的 2.5%,前代的四分之一 |
| Batch API | 輸出入 5 折 | 非即時批次工作 |
為什麼單獨降快取讀取會讓總成本大幅下降?關鍵在 agent 工作負載的 token 結構。一個跑數小時的 agent 會反覆重讀相同的系統提示、工具定義與累積的對話上下文,快取讀取往往占掉帳單的大宗;官方以 2026 年 8 月連續四週的實際用量、在預設 effort 下量測,典型工作負載(涵蓋 Claude Enterprise、Claude Code 與 API)成本比 Fable 5 低約 25%,快取讀取占比最高的高度代理型工作最多省約 45%。反過來說,如果你的用量是「一次送進一大段文字、模型回答一次就結束」的型態,快取命中率低,這波降價的體感會很有限,單價就是 10 與 50 美元。
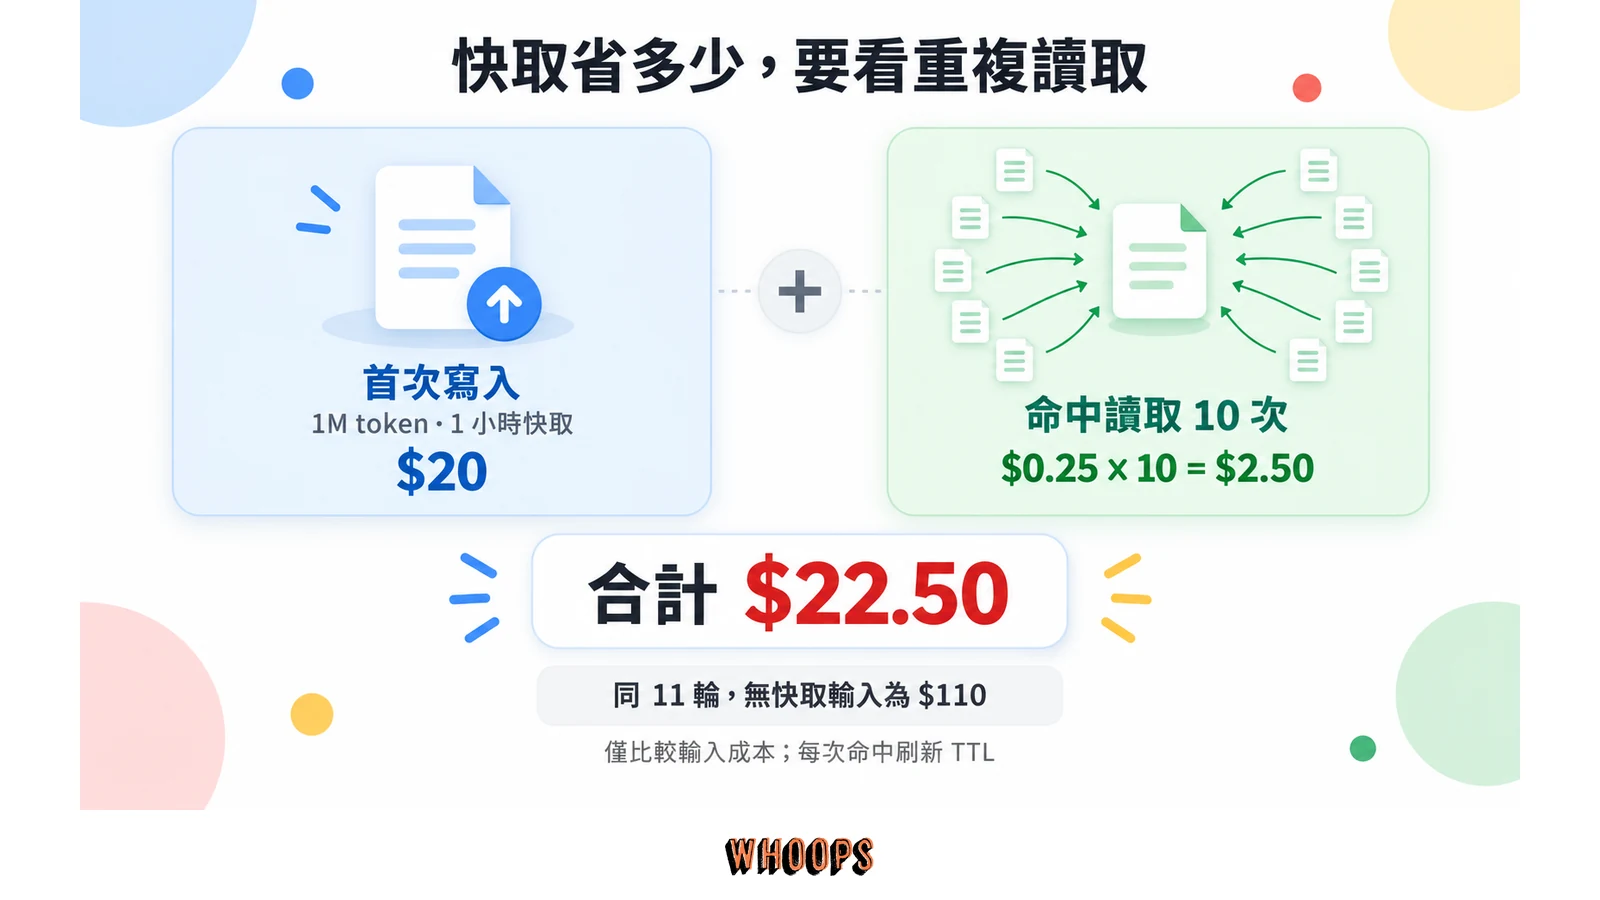
兩種快取寫入的取捨,要看下一次讀取相隔多久。官方快取文件說明,每次命中都會重新計算有效期限;若每輪間隔都在 5 分鐘內,5 分鐘快取通常較便宜,間隔可能超過 5 分鐘、但不超過 1 小時時,再考慮 1 小時版。以固定 100 萬 token 的上下文為例,寫入 1 小時快取一次為 20 美元,接著命中十次共 2.50 美元,合計 22.50 美元;同樣十一輪若全部按未快取輸入計費,則為 110 美元。這個試算不含新增輸入與輸出,實際成本仍取決於命中率、重讀次數及上下文變化。
訂閱制方面,官方方案說明區分是否包含 Fable 額度:Max、Team premium 席位及舊制 seat-based Enterprise premium 席位,可在既有週額度內使用 Fable,但最多占週額度的 50%;Pro、Team standard 與 Enterprise standard 席位須使用 usage credits,usage-based Enterprise 則按標準 API 費率計費。想在終端機工作裡常駐 Fable,可以先看站上的Claude Code 費用與方案,再核對自己的席位與額外用量設定。美國境內推論選項以輸出入單價 1.1 倍計費;雲端供應涵蓋 Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry 與 Claude Platform on AWS。
安全防護與 fallback:哪些請求會被切成別的模型
Fable 5.1 的安全分類器可能在對話中將請求轉給其他模型。Claude 介面中,被資安分類器標記的請求改由 Claude Opus 4.8 回應,被生物分類器標記的請求改由 Claude Opus 5 回應,使用者會收到切換提示;產品頁說明,被轉介的請求不按 Fable 價格收費。API 的拒絕與重試則須依前述計費規則處理。
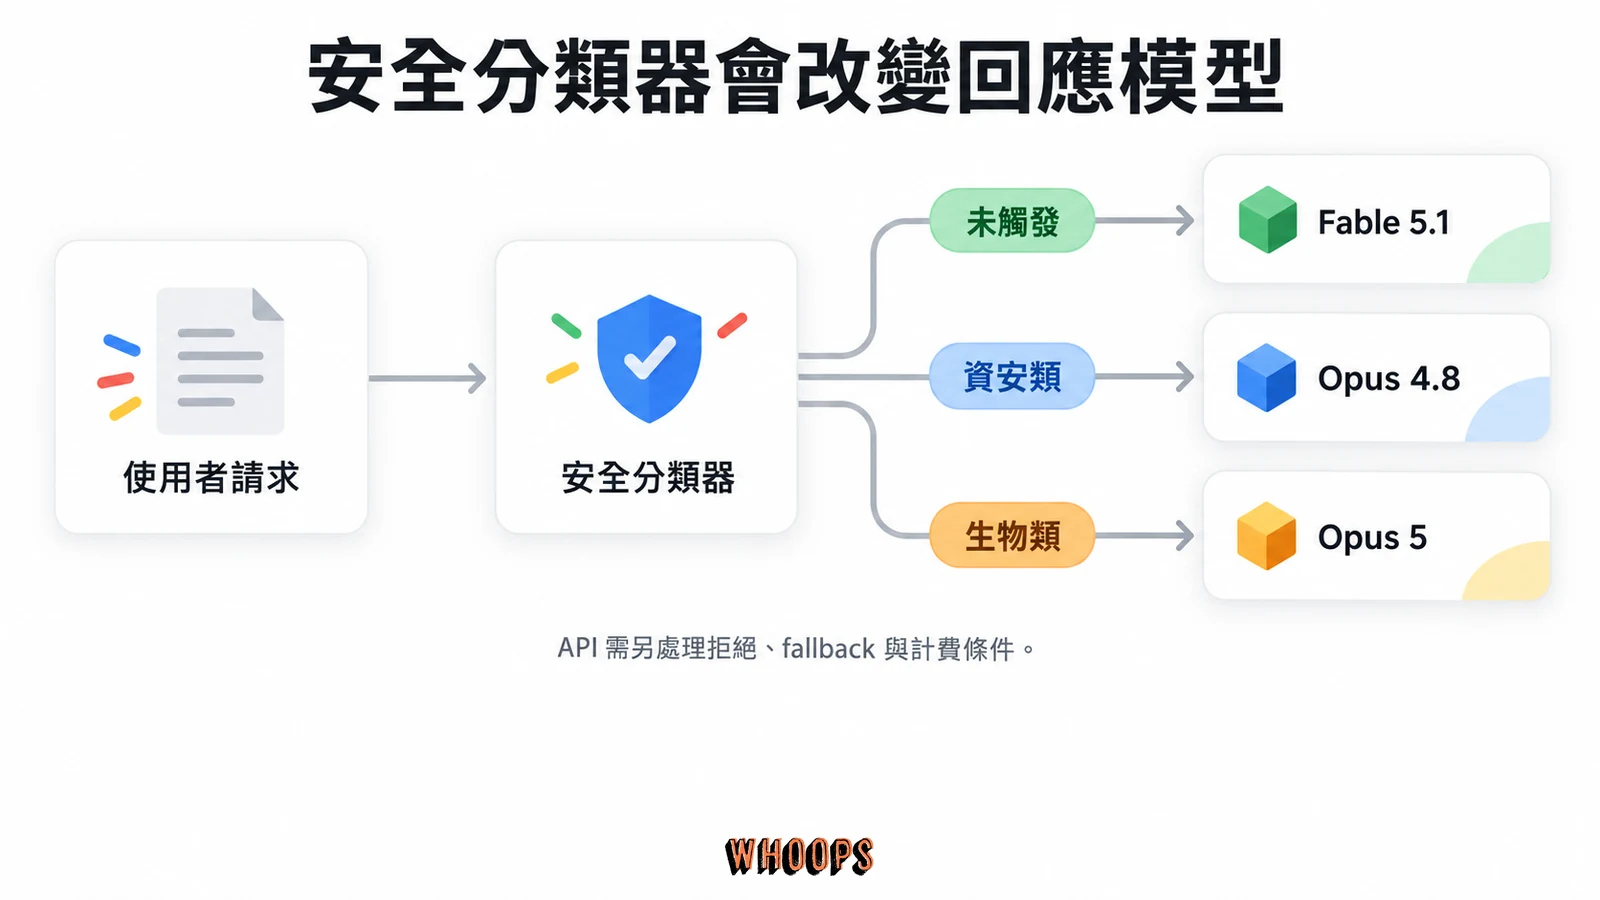
哪些內容會觸發、哪些不會,5.1 相較前代放寬了不少。官方明確允許 Fable 5.1 用於發現軟體漏洞這類防禦性資安工作,但不得用於開發攻擊程式;滲透測試、exploit 產生與以二元檔為基礎的漏洞掃描這些雙用途任務仍會被轉給 Opus 模型。官方估計,改版後 Claude Code 使用者每個工作階段平均會減少約 60% 的資安防護介入;基礎生物學與醫療良性請求觸發防護的比例約減少 85%。生命科學的研究開發請求仍導向 Opus,專業研究需求可透過 Mythos 5.1 的存取計畫申請。
資料保留是企業採購時更在意的一條。使用 Fable 預設需要 30 天的資料保留,供 Anthropic 做安全監控;這個設計源自 Fable 5 時代的縱深防禦策略,當時的官方聲明說明,保留資料的目的是研究並緩解越獄攻擊。Anthropic 在 9 月 1 日宣布將分階段推出 Enterprise Frontier Safeguards(EFS):客戶資料存在客戶自有的雲端基礎架構,需要人工審查時預設也由客戶自己執行,隱私效果等同零資料保留,同時保留對抗濫用的偵測能力。EFS 與超過一百家客戶及 AWS、Google Cloud、Azure 合作開發,從秋季開始分階段上線;在 EFS 就緒前,符合資格的企業客戶可以直接以零資料保留方案使用 Fable 5.1。
還有兩個與安全相關的機制值得一提。其一是反蒸餾:蒸餾攻擊常以數千個假帳號工業化地抽取模型能力,Fable 5.1 對 2026 年 8 月 31 日起建立的 API 帳號限制:不能編輯對話中 Claude 的先前上下文卻保留其思考紀錄,關閉了一個公開流傳的蒸餾手法;既有帳號暫不受影響,但未來新模型發布時會全面適用。其二是內容來源浮水印:Anthropic 在 2026 年 7 月簽署歐盟透明度行為準則後,8 月 2 日之後發布的模型輸出都帶有統計式浮水印,沒有偵測 API 就看不到,對輸出品質沒有實質影響,也不含使用者或對話資訊。想看完整的安全評估,包括紅隊測試、能力評估與部署決策,官方的系統卡是第一手來源;其中記載 Mythos 5.1 是 Anthropic 發布過資安能力最強的模型,但仍在內部風險框架的較低類別內,且未發現關鍵等級的越獄。
對齊面的評估結果對自動化部署的團隊更有直接意義。官方的自動化行為稽核發現,Mythos 5.1 在多數指標上比前代更收斂:被指派不可能完成的任務時,它更少嘗試存取測試環境之外的資源;更少用「這是模擬或評測」之類的動機性推理替自己的行為合理化;獎勵作弊的嘗試次數與成功率也都低於 Mythos 5。測試同時點出兩條保留意見:模型仍有可能繞過核准流程與自動模式分類器,而自動化稽核對超長上下文工作與多代理設定的可見度仍然有限。要把 Fable 5.1 放進無人值守流程的團隊,這些結論的實務讀法是:模型本身比前代更守規矩,但權限邊界、核准關卡與抽查機制不應該因為模型升級而撤掉。
需要 Mythos 等級防護設定的專業工作者有兩條申請路徑:網路防禦者走 Cyber Verification Program,生命科學研究者走與美國政府合作設立的 Life Sciences Verification Program;目前 Mythos 5.1 僅提供給美國組織,Anthropic 表示正協調擴大範圍。符合資格的 Claude Enterprise 組織可在 Claude.ai 的 Claude Security 中使用 Mythos 5.1 掃描,不必取得模型的直接存取權,但仍須完成管理員設定;Claude Code Security plugin 則使用帳號原本可用的模型。
Fable 5.1、Opus 5.5、Sonnet 5.5 怎麼選
官方模型總覽文件給的建議可以直接當決策起點:不確定就用 Claude Opus 5.5,它足以應付多數工作負載;Fable 5.1 留給需要高難度推理與長程代理工作的場景,或者你在 Opus 5.5 上拉高 effort 跑自己的評測仍然不到位時。這個建議的背景是 9 月 22 日的 Opus 5.5 公告:官方定位它「在多數工作上達到 Fable 5.1 的水準」,在典型工作負載上的執行成本比 Opus 5 低 40%,API 單價 4 與 20 美元只有 Fable 的四成,延遲等級也更快。站上有針對 Opus 5.5 的完整評測與遷移指南可以對照。
9 月 22 日的 Opus 5.5 公告已列出與 Fable 5.1 的直接比較:Terminal-Bench 4.0 為 66.4% 對 55.8%,Terminal-Bench-Science 0.1 為 58.7% 對 52.6%,Humanity’s Last Exam(用工具)為 67.7% 對 65.6%,GDPval-AA v2.1 為 1846 對 1735,這些項目均由 Opus 5.5 領先。
這組比較不能直接混用前面的 Fable 發布表:GDPval-AA 已從 v2 換成 v2.1,HLE 的 Fable 分數也不同;Opus 公告多數測試使用 max effort,Terminal-Bench 4.0 則用 xhigh。官方同時提醒,基準分差未必能反映實際工作差異,並仍建議將 Fable 用於高難度、長程代理工作。選擇時應先在相同設定下測自己的任務,再決定是否升級。
| 模型 | 上下文 | 最大輸出 | API 價格(輸入/輸出,每百萬 token) | 快取讀取 | 延遲 | 預設 effort |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1M | 128K | $10 / $50 | $0.25(2.5%) | 較慢 | high |
| Claude Opus 5.5 | 1M | 128K | $4 / $20 | $0.20(5%) | 中等 | medium |
| Claude Sonnet 5.5 | 1M | 128K | $2 / $10 | $0.20(10%) | 快 | high |
| Claude Haiku 4.5 | 200K | 64K | $1 / $5 | $0.10(10%) | 最快 | 不支援 |
Sonnet 5.5 補上速度與成本的另一端:單價 2 與 10 美元、延遲等級屬於快的一檔,官方把它定位為範圍明確的日常工作模型,站上的 Sonnet 5.5 深度比較整理了它與 Opus 5.5 的分工。預設 effort 也值得留意:Fable 5.1 在 API 上預設 high,在 Claude Code 中也是 high,但在 Claude.ai 與 Cowork 介面預設 medium;Opus 5.5 全面預設 medium。同一個模型在不同入口的「開箱即用」思考深度不同,比較體感前先確認 effort 設定,這是官方文件特別標註、卻最常被忽略的變數。
跨陣營比較的官方口徑可以這樣讀:Fable 5.1 的發布比較表放入了 GPT-5.6 Sol 作為對照,在 Terminal-Bench 4.0、Terminal-Bench-Science、GDPval、AutomationBench 與 CursorBench 上 Fable 5.1 全數領先;站上的 GPT-6 Sol 完整解析與 GPT-6 Astra 深度評測有 OpenAI 陣營的選擇視角,Astra 也是 Opus 5.5 公告中的主要對照模型。SpaceXAI 的 Grok 4.7 則主打逼近 Fable 5 等級的效能與約半價的 API 成本,適合把成本放在第一順位的團隊列入評估。陣營間的基準成績常因測試設定而不可直接比較,跨廠選型仍以自己工作負載的評測為準。
回到 Claude 家族內部,幾個條件會直接翻轉 Fable 與 Opus 的選擇,這部分是依官方規格整理的編輯判斷。第一是延遲預算:Fable 是現行最慢的等級,使用者盯著畫面等回應的互動場景,再強的推理能力都很難變現。第二是 token 結構:長程 agent 的快取命中率高,能吃到 0.25 美元讀取的紅利,Fable 的有效成本會比牌面單價親切;一次性長文分析吃不到這個折扣,相對 Opus 5.5 的 2.5 倍輸入價差(相對 Sonnet 5.5 為 5 倍)就會實實在在反映在帳單上。第三是分類器暴露度:如果團隊的日常工作常態涉及資安或生物主題,頻繁的 fallback 會讓模型切換與推理狀態更難預測,也必須另算 API 拒絕及重試的費用,這種情況該重新考慮 Mythos 的存取計畫或直接選 Opus。第四是 effort 政策:若你的平台或工作流把 effort 固定在 medium,不能直接套用官方較高 effort 的基準成績,先在自己的設定下量測再決定。
哪些團隊適合上 Fable 5.1,哪些不必
把官方定位、測試者回饋與價格結構放在一起,Fable 5.1 的合理使用場景輪廓相當清楚。它值得付出的情況包括:
- 橫跨整個程式碼庫的功能開發、程式碼審查與效能工作,特別是需要模型自己寫測試、自我驗證的多日自主 session。
- 長時間無人值守的代理工作:在 Cowork 裡消化待辦佇列、操作瀏覽器、排程執行,或在 Claude Platform 上以 managed agent 方式運轉。
- 深度研究與分析,以及產出可直接審閱的金融、法務、分析類文件,這類工作受益於它的文件、試算表與投影片處理能力。
- 其他模型反覆失敗的困難除錯與根因分析,測試者回饋中最一致的強項。
反過來說,幾種情況不必上 Fable。對延遲敏感的互動式產品,它是最慢的等級,輸出單價 50 美元也會快速累積;大量、範圍明確的例行任務,Sonnet 5.5 或 Opus 5.5 的性價比更好;專業的資安與生命科學工作會撞上分類器,該走 Mythos 5.1 的信任存取計畫或直接用 Opus;而如果只是想在終端機裡有個可靠的 coding agent,Claude Code 預設的模型選擇已經涵蓋多數日常,Claude Cowork 則是非程式工作的入口,兩者都能按任務切換模型,不必為了偶爾的難題常駐 Fable。
要評估時,先把代表性任務寫成 eval,在 Opus 5.5 的預設 medium 下建立基準線,再測 high、xhigh 或 max 是否改善結果;仍不足時,再用相同任務對照 Fable 5.1。可利用 per-message effort 調整成本,整合 API 時明確處理 refusal、fallback 與計費紀錄,並觀察快取命中率。官方成績能協助篩選模型,最後仍以自己的任務結果與每任務成本決定。
常見問題
Claude Fable 5.1 是什麼時候發布的?
2026 年 9 月 1 日,與僅限受邀組織使用的 Claude Mythos 5.1 同日發布。兩者共用權重但採用不同的安全防護;Fable 5.1 可透過付費 Claude 方案與支援平台使用,官方文件狀態為 Active,承諾不早於 2027 年 9 月 1 日退役。
Fable 5.1 和 Mythos 5.1 有什麼差別?
能力完全相同,差別在安全防護與開放範圍。Fable 5.1 一般可用,但資安與生物相關請求會被分類器自動轉給 Opus 模型處理;Mythos 5.1 僅透過信任存取計畫提供給審核過的組織,防護設定為網路安全防禦與生命科學研究工作設計,目前僅限美國組織申請。
Fable 5.1 的 API 價格是多少?
輸入每百萬 token 10 美元、輸出 50 美元,5 分鐘與 1 小時快取寫入分別為 12.50 與 20 美元,快取讀取 0.25 美元,Batch API 輸出入半價。單價與 Fable 5 相同,快取讀取降到前代的四分之一,官方估計典型工作負載總成本因此下降約 25%,高度代理型工作最多約 45%。
Claude 訂閱用戶可以用 Fable 5.1 嗎?
可以,但費用依方案與席位而定。Max、Team premium 與舊制 seat-based Enterprise premium 包含 Fable 使用,最多占既有週額度的 50%;Pro、Team standard 與 Enterprise standard 須使用 usage credits,usage-based Enterprise 則按標準 API 費率計費。
什麼情況該選 Fable 5.1 而不是 Opus 5.5?
官方建議多數工作從 Opus 5.5 開始,它更便宜、更快且在多數工作上達到 Fable 5.1 的水準。當任務是最難的推理、需要連續執行數小時到數天的長程 agent 工作,或你在 Opus 5.5 上拉高 effort 跑自己的評測仍然失準時,才選 Fable 5.1。
為什麼問某些資安或生物問題時,回應看起來不像 Fable?
這是安全分類器的 fallback 機制。Claude 介面中,資安請求可能轉給 Opus 4.8、生物請求可能轉給 Opus 5,並顯示切換提示。API 的拒絕與重試可能計費,須查看 stop_details.category、是否已有輸出,以及實際回應模型。
Fable 5.1 的上下文視窗有多大?
1M token,官方換算約 55.5 萬英文字或 250 萬 Unicode 字元,同步 API 的最大輸出為 128K token,輸入支援文字與圖片,可靠的知識截止日期為 2026 年 6 月。
從 Fable 5 遷移到 5.1 有哪些不相容變更?
三項:強制工具使用會直接回傳錯誤;舊模型讀不到 Fable 5.1 的 thinking blocks,路由或 fallback 切換模型時 API 會丟棄無法讀取的區塊且不計費;編輯對話中較早的輪次會使 thinking blocks 失效。新增功能包含逐則訊息調整 effort、單輪系統訊息、工具呼叫間的進度更新顯示與內容來源資訊。
Fable 5.1 可以在哪些平台上使用?
Claude API、Claude.ai 與各 Claude 應用程式、Amazon Bedrock、Google Cloud、Microsoft Foundry 與 Claude Platform on AWS。模型 ID 在多數平台是 claude-fable-5-1,在 Bedrock 上是 anthropic.claude-fable-5-1。
使用 Fable 5.1,資料會被 Anthropic 保留嗎?
預設需要 30 天資料保留,供安全監控使用。企業客戶可等待秋季起分階段上線的 Enterprise Frontier Safeguards,屆時資料改存客戶自有雲端基礎架構、人工審查預設由客戶執行,隱私效果等同零資料保留;在 EFS 就緒前,符合資格的客戶可直接以零資料保留方案使用。
Anthropic 有發布 Fable 5.5 嗎?
截至 2026 年 10 月 4 日,Anthropic 官方模型頁與文件列出的 Fable 版本仍是 5.1,尚未公布 Fable 5.5 的規格、價格或發布時程。現在有使用需求,可先依 Fable 5.1 與 Opus 5.5 的官方資料及自己的評測做決定。

討論與提問