
本篇內容
Grok 4.7 於 2026 年 9 月 21 日發布,主打程式開發、文件分析,以及需要連續執行多個步驟的工作。官方 API 提供 50 萬 tokens 上下文,接受文字與圖片輸入,輸出文字。一般 token 單價延續 Grok 4.6,但整項任務的花費還得算上推理、工具呼叫與重試。
這次升級適合拿來重跑那些做到一半就卡住的工作。例如,修正牽涉多個檔案的程式錯誤,或讀完一批文件後,交出能逐項核對的分析。短問答與繁體中文寫作的表現,則要另外測,長任務的評測分數回答不了所有問題。
付費前尤其要看清楚計價入口:官方 API 的提示內容一旦達到 20 萬 tokens,整筆請求就改用長上下文費率;Cursor 採用另一個門檻。Grok 4.7 Fast 也另有價格與使用限制。模型名稱相同,帳單未必照同一套規則算。
Grok 4.7 是什麼?
Grok 是 SpaceXAI 的模型系列。對外品牌已經換成 SpaceXAI,發布頁的版權聲明與官方帳號都用這個名字;網域、控制台與文件卻還掛在 x.ai 之下,文件行文偶爾仍見 xAI API 的舊稱。兩個名字目前並存,新聞裡的 xAI 與 SpaceXAI 指的是同一家。更新節奏也快:4.5 在 2026 年 7 月、4.6 在 8 月 12 日、4.7 在 9 月 21 日接棒,差不多一個月一版。整個家族的產品線與使用入口,站內的 Grok 完整教學整理過,把 Grok 拿來做關鍵字研究與技術稽核的 SEO 工作流也有專文,這篇只看 4.7 本身。
官方在發布公告裡的定位是這樣寫的:Grok 4.7 能在困難任務上工作更久、更仔細檢查自己的輸出,並配上迄今校準最好的安全防護。同一頁,副標喊「對同級競品 2 倍速、半價」,內文卻寫「與 Grok 4.6 同價同速」。兩句話不算矛盾,基準不同而已:前者拿競品比,後者拿自家前代比,「2 倍速」更只限加價的 Fast 版。行銷文案先看基準,再決定要不要相信。
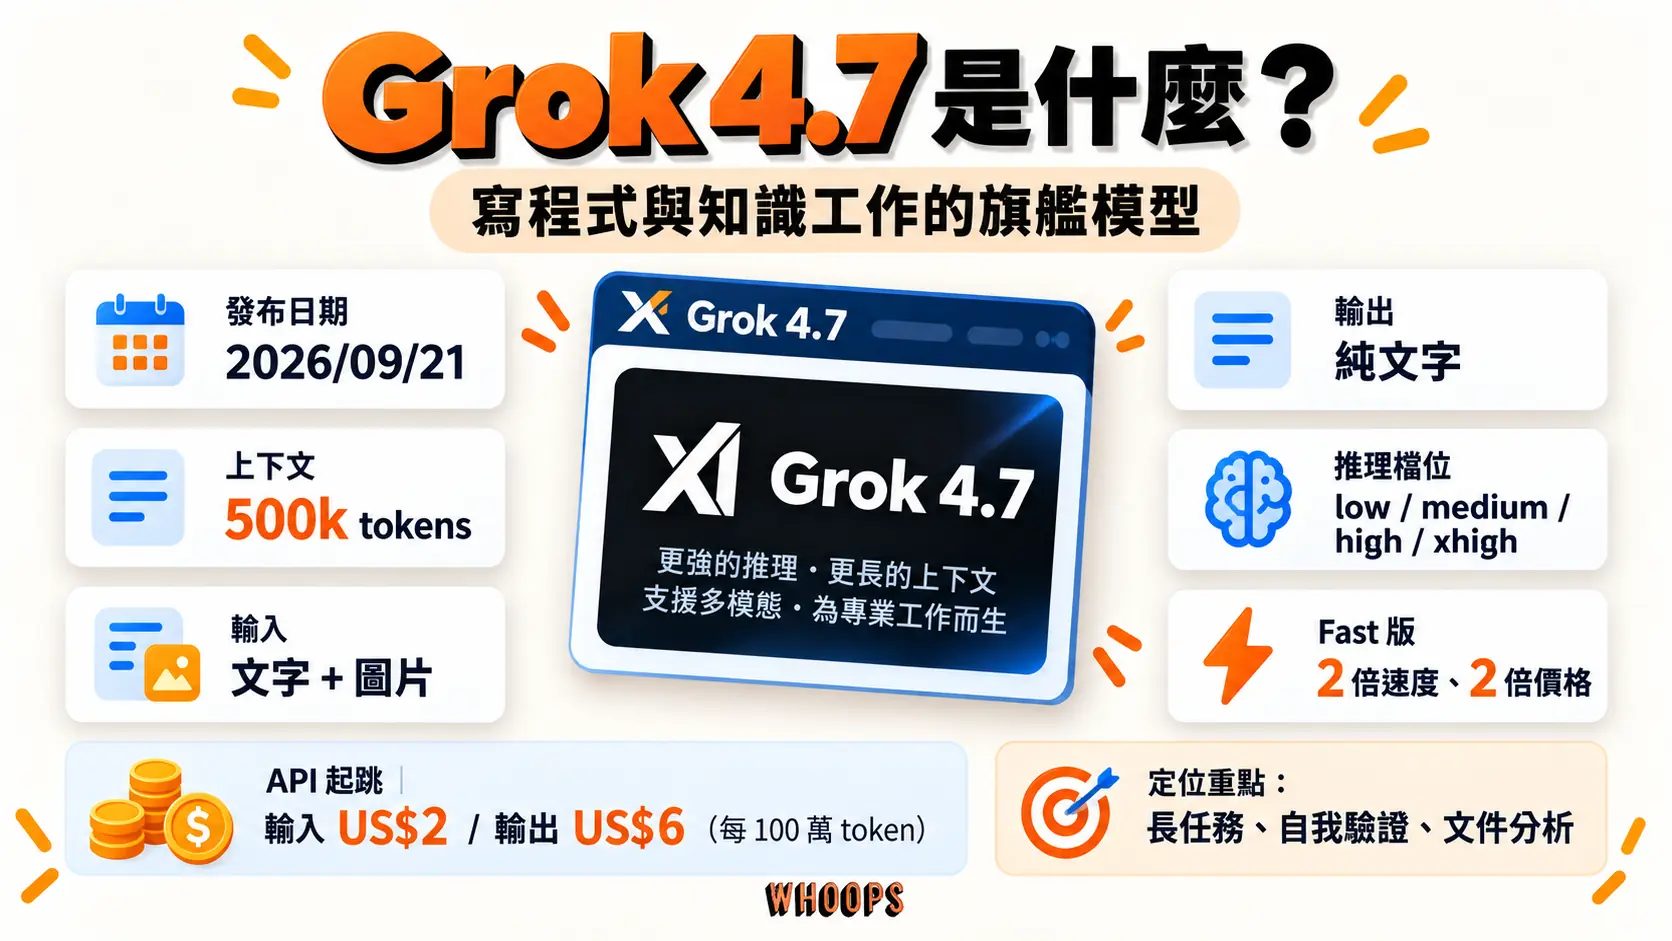
| 項目 | 內容 |
|---|---|
| 發布日期 | 2026 年 9 月 21 日 |
| API model ID | grok-4.7 |
| 上下文視窗 | 500k tokens |
| 輸入/輸出 | 文字+圖片輸入;純文字輸出,無長度上限 |
| 圖片輸入限制 | 每張上限 20MiB(jpg/png),數量不限 |
| 知識截止日 | 2026 年 5 月 |
| 推理強度 | low/medium/high(預設)/xhigh |
| Fast 變體 | 2 倍速度、2 倍價格,僅 Cursor 與 Grok Build 提供 |
| API 價格起跳 | 每 100 萬輸入 2 美元、輸出 6 美元 |
規格出自官方模型文件,有幾個細節得拆開講。圖片輸入收 jpg 與 png,每張上限 20MiB、數量不限,輸出卻只有文字:看圖寫報告、看截圖改程式行,產生圖片不行。輸出沒有長度上限是雙面刃,長報告不會被截斷,但輸出 token 偏偏是計費最貴的一段,模型寫得越長、帳單越厚。這個伏筆先埋著,token 成本那段會收回來。
圖片輸入配上「知識工作」四個字,實際的工作樣貌大概長這樣:整頁錯誤訊息截圖丟給它找原因、報表截圖轉成文字分析、掃描的合約段落整理成重點。一般螢幕截圖與文件掃描都離 20MiB 上限很遠,手機直出的 HEIC 檔得先轉檔。它看得懂圖,吐出來的仍是文字;要產圖,請去找 Grok 家族裡的生成工具,例如 Grok Imagine Image 2.0。
知識截止日停在 2026 年 5 月,比模型自己上線早了四個月。不接任何工具時,4.7 對 6 月以後發生的事一無所知,硬問只會得到猜測或一句「我不知道」。想讓它碰即時資訊,要在 API 呼叫時打開伺服器端的網頁搜尋、X 搜尋或程式執行工具,這些工具按次計費,細節留在價格段。
推理強度是可以轉的旋鈕,這裡多講兩句。low、medium、high、xhigh 差在模型給出答案前願意花多少內部推理:檔位越高,分數越高,速度越慢,費用也越貴,預設值是 high。落差有數字可查:Artificial Analysis 量到 high 檔輸出約每秒 53 個 token,xhigh 剩 39 個;CursorBench 上四個檔位依序是 33.1%、41.6%、43.9%、46.3%,最低到最高差 13 個百分點。同一個 grok-4.7,選檔位幾乎等於在選一套性能與成本的組合。
500k 的上下文視窗換算成中文材料,量級大概如此:token 與中文字的比例依分詞器而定,粗估一個 token 約當 0.5 到 0.75 個中文字,50 萬 tokens 大約是 25 到 37 萬字。一份幾百頁的文件,或一個中小型程式碼庫的主要內容,都塞得進去。計費那邊在 200k 畫了一條線,prompt 一跨過,整筆請求按高費率算,細節同樣在價格段。長材料分段餵、快取顧好,是長文件工作的兩個基本功。
模型本身動了什麼?官方給了六個方向:換上比 4.6 更大的基座模型,參數規模未公布;更長的強化學習,訓練任務偏向要花好幾個小時才做得完的難題;更好的自我驗證與長上下文管理;原生在 Grok Bot 的環境裡訓練,官方稱對話與知識工作因此表現更好;更好的文件與簡報產出;配上全新的安全防護。六項全是廠商自述,沒有獨立驗證,其中「更好的文件產出」在發布後兩天內就撞上使用者的反例,後文會談。
4.6 與 4.7 兩份公告的措辭並排放,重心的變化看得很清楚。4.6 那次講的是長任務代理與互動視覺作品;4.7 換成寫程式與知識工作,訓練任務偏向得花許多小時才能解的問題。白話說,4.6 賣的是把一串工作接起來做完,4.7 賣的是把單一難題做得更深、自我檢查更勤。採購前先問自己:痛點在前者還是後者?答案會決定這次升級你感覺有多大。
變體這邊,官方端出來的就是一個模型、四檔推理強度,加上限通路提供的 Fast 版;Heavy 版不存在,其他名字也沒有。路上看到「Grok 4.7 Heavy」之類的說法,目前都查無官方依據。
六項改善裡,跟日常使用最有關係的是自我驗證。模型多檢查一遍,第一輪品管就由它自己做,一部分錯誤有機會在送出前被攔下;代價是檢查本身也在燒輸出 token,後文的成本爭議跟這裡直接相連。官方宣稱與第三方實測難得地互相印證,講的就是這一件事。
順帶拆一個流傳很廣的說法。部分媒體報導 4.7 的參數規模是 2.1 兆,官方從頭到尾沒公布過任何數字,獨立追蹤者也把 2.1 兆標成未證實。寫規格時記住:「更大的基座」是官方唯一口徑,任何具體數字都以傳聞看待。
官方評測:Grok 4.7 贏在哪、輸在哪?
先看 SpaceXAI 公布的主表。欄位是 Grok 4.7(xhigh)、Grok 4.6(high)、GPT-5.6 Sol(max)、Fable 5.1(max),各欄推理強度並不一致,這件事正是下一節的主角,這裡先讀數字。
| 評測項目 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 輸入價(每 100 萬 token) | 2 美元 | 2 美元 | 4 美元 | 10 美元 |
| 輸出價(每 100 萬 token) | 6 美元 | 6 美元 | 20 美元 | 50 美元 |
| CursorBench 4.0(軟體工程) | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1(軟體工程) | 71.0% | 65.2% | 72.7% | 70.0% |
| AA Briefcase v1.1(多小時辦公任務) | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0(終端機長任務) | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal(法律工作) | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional(臨床推理) | 56.7% | 48.5% | 60.5% | 62.1% |
| EEBench(電子工程) | 64.0% | 53.0% | 39.4% | 56.4% |
Grok 4.7 抱走兩座冠軍:Harvey Legal 的 19.6% 把其他三個模型甩開一截,對手全落在個位數到低兩位數;EEBench 的 64.0% 同樣最高,比 4.6 的 53.0% 高 11 個百分點。兩項的共同點是專業領域的長文件工作,一個法律、一個電子工程,跟官方「知識工作」的定位對得起來。Fable 5.1 拿走 CursorBench、Terminal-Bench、AA Briefcase、HealthBench 四項最高分,DeepSWE 由 GPT-5.6 Sol 的 72.7% 領先。4.7 的 71.0% 只差 1.7 個百分點,而且這格官方加註用的是 high 檔,欄位名義上的 xhigh 其實沒用到。
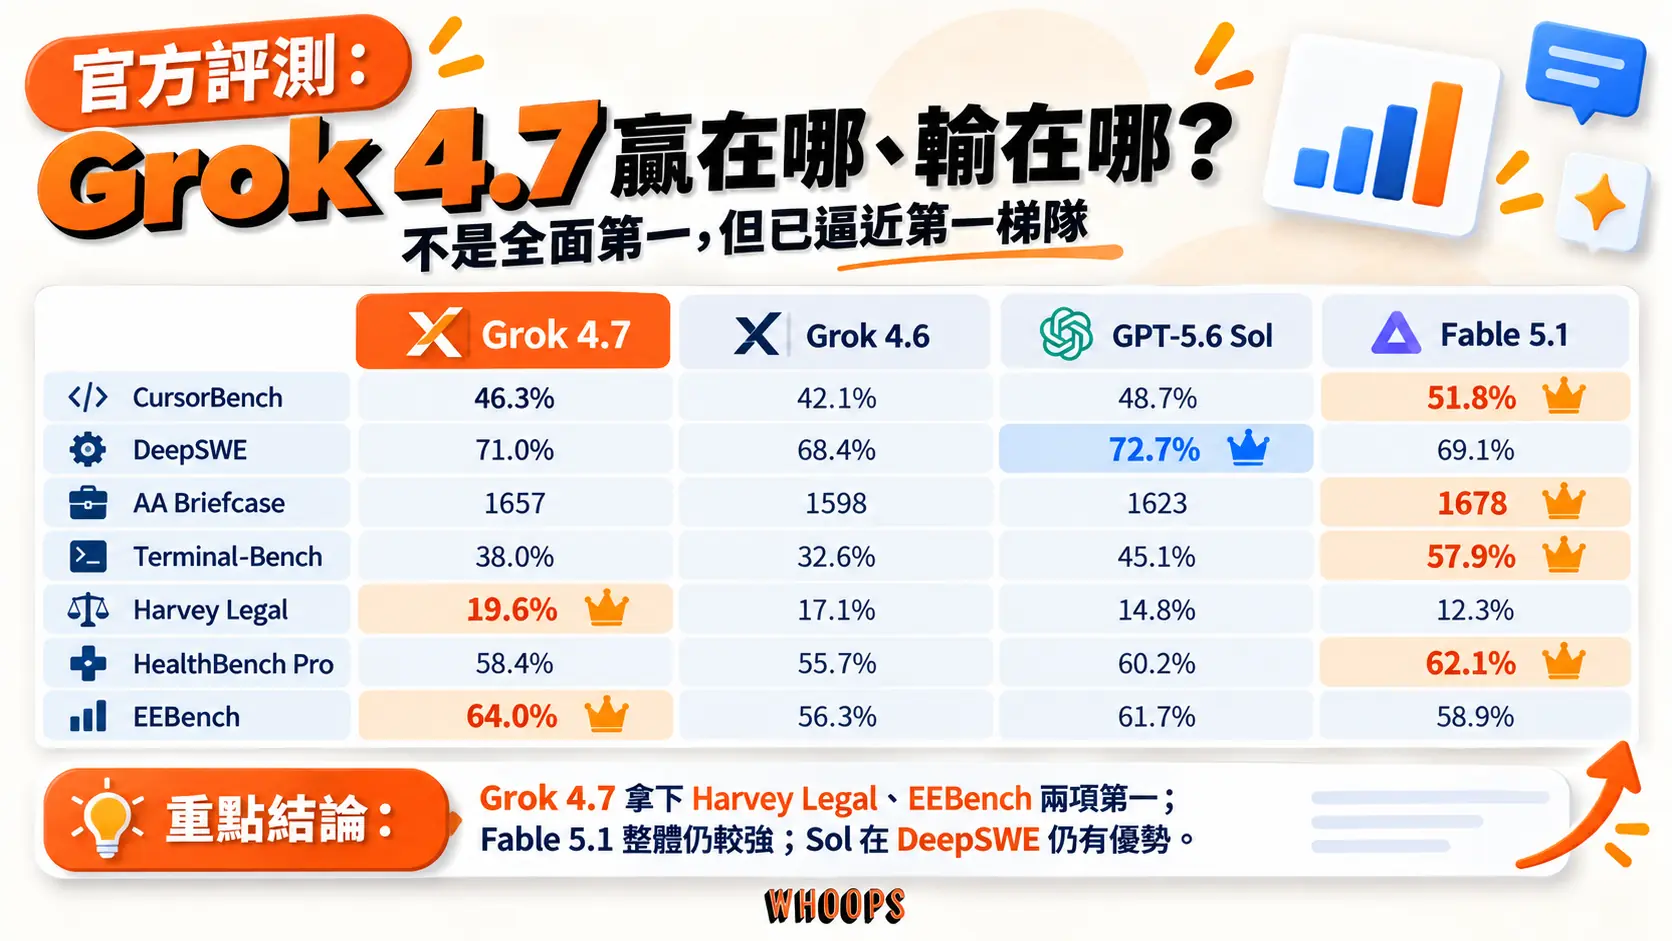
七項評測翻成工作場景會更好用。CursorBench 是 Cursor 開發環境裡的軟體工程任務;DeepSWE 是長時間的軟體工程難題;Terminal-Bench 是命令列裡的多步驟終端工作;AA Briefcase 是文件、簡報這類多小時的辦公產出;Harvey 是法律實務;HealthBench Professional 是臨床推理;EEBench 是電子工程。日常工作越接近其中一項,那個分數就越有參考價值;都不像的話,分數只是間接線索,拿自己的任務直接測最快。
分數的絕對值也要會讀。Harvey 的 19.6% 是全場最高,絕對值卻不到兩成,這類專業代理評測本來就難,四個模型沒有一個摸到兩成。它量的是模型之間的相對差距,可用率要分開看,把 19.6% 直接想成「八成的任務做得完」就錯了,這是公告表最常見的誤讀。AA Briefcase 給的是分數而非百分比,1,657 對上 46.3%,兩種量表別放在同一把尺上。
想把官方表變成測試清單,做法不複雜:挑出離自己工作最近的兩項評測,把它們背後的任務換成手上的真實工作,寫下固定的驗收條件,讓 4.6 與 4.7 各跑幾輪。官方表能告訴你的,只有哪裡可能有差異;差異在自己的材料上成不成立,答案在你手上。
表格裡有一格多停一下:4.7 的 DeepSWE 71.0% 是官方加註的 high 檔成績,欄位名義上卻寫 xhigh。這個加註有兩層意思。一層是 4.7 用 high 檔就貼著 Sol 的 max 檔,省錢空間比 CursorBench 那條梯形顯示的更大;另一層是 high 與 xhigh 的差距依任務而異,長軟體工程任務搞不好正是 xhigh 報酬遞減最明顯的類型。這是從單一格數字做的推讀,自己的任務是不是這樣,還是得實測。
Terminal-Bench 從 20.3% 到 38.0%,全表最大的同版本進步,單獨拿出來講。終端機長任務是代理工作最吃力的場景之一:規劃步驟、執行命令、讀輸出、修正路線,一錯就連環錯。通過率將近翻倍,表示這類工作開始跨過可用門檻;可 38% 也擺在那裡,三段任務裡有兩段會失敗,導入時的期望管理不能省。
表格外,公告頁還擺了一張 GDPval 的 Elo 分數圖:Fable 5.1(max)1735、Grok 4.7(xhigh)1695、Grok 4.6(high)1605、GPT-6 Astra(max)1542。這張圖的比較組合跟主表不同,主表放 GPT-5.6 Sol,圖裡放 Astra,兩份資料不能加總、不能對調。
順著這張圖再讀一層:Astra 在圖裡、不在主表,Sol 在主表、不在圖裡,兩個 OpenAI 對手各露一次臉,任何一張官方圖都沒同時收齊所有競品。這未必是挑對手的手法,要展示哪些比較本來就是發布方的自由;但對讀者的後果很實際:想要完整的橫向對照,得自己補測或看獨立榜,單一廠商的圖永遠缺一角。
GDPval 與 AA Briefcase 擺在一起,訊號一致:兩者都在量長文件的專業產出,4.7 都高於 4.6,也都沒越過 Fable 5.1。知識工作升級了,王座沒拿到,這是官方自己的數字講的,不需要立場。
跟 4.6 公告對照,還有一個安靜的變化:4.6 那次領銜的 AA Intelligence Index 綜合分數行,這次整行不見了,換上 GDPval 圖,官方沒解釋原因。獨立追蹤單位 Artificial Analysis 現行版本的指標裡,4.7 的綜合分是 46,4.6 發布當時是 44,進步幅度 2 分。這個數字後面還會用到。
公告裡替「划算」說法撐腰的,是一張 CursorBench 4.0 的價格-效能散點圖:Grok 4.7 xhigh 拿 46.3%、每任務平均成本 6.01 美元,Claude Opus 5 Max 拿 46.6%、每任務 11.95 美元。分數差 0.3 個百分點,成本差將近一半,官方因此稱 4.7 在價格-效能上站上第一線。數字是真的,「第一線」是官方措辭;而這張圖沒放 GPT-6 Astra,社群已經有人質疑選樣。
官方的兩表一圖合起來讀,敘事的三根柱子各站各的:主表說每一項都勝過前代、法律與電子兩項封王;散點圖說同級分數只要半價;GDPval 圖說知識工作追到第二。合起來同樣沒有說全面第一。我的讀法跟官方口徑一致:特定項目的冠軍,加上整體的性價比。
還有一個提醒:整份表格出自發布方,第三方模型的分數採自報或公開可得的最佳值,要展示哪些評測、用哪個版本,選擇權全在廠商手裡。分數適合拿來決定「哪些任務值得自己測」,當成所有工作都會重現的保證就過頭了。
Grok 4.7 跟 4.6 差多少?三個比較陷阱先避開
4.7 對 4.6 是這次發布最容易被誤讀的一段,Grok 4.6 的完整解析當時的分數不能直接搬過來對。坑有三個,我一個一個拆。
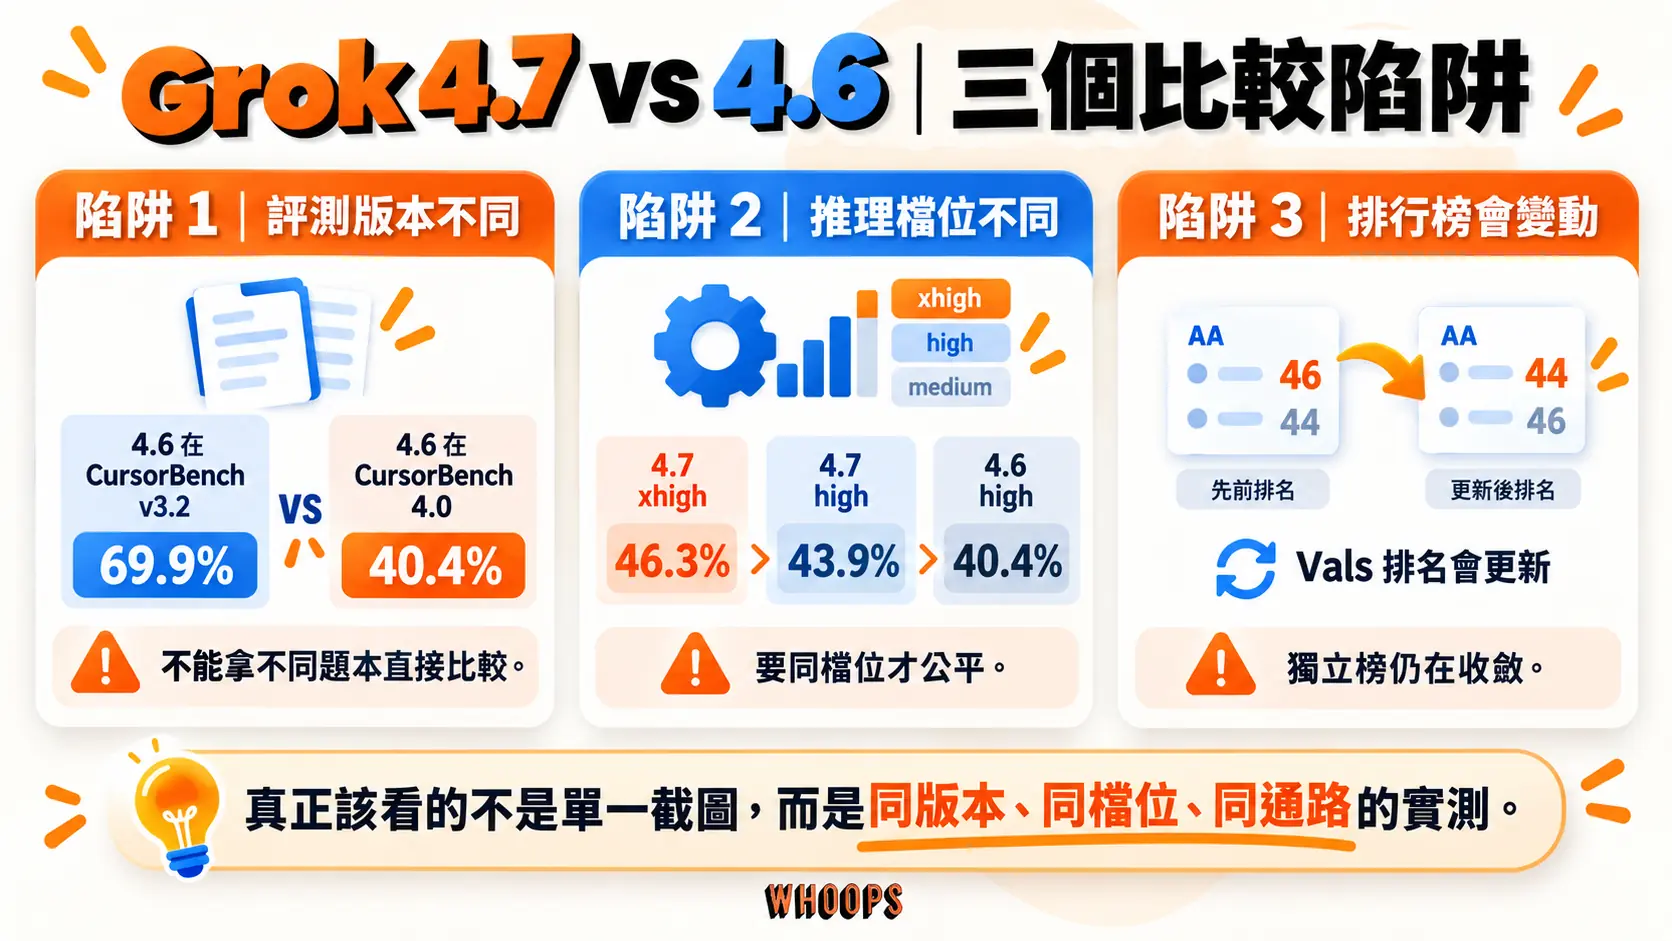
最先絆倒人的是評測版本。4.6 公告用的 CursorBench 是 v3.2,4.6 拿 69.9%;4.7 公告改用 CursorBench 4.0,同一個 4.6 在新題本上只剩 40.4%。拿 69.9% 對 46.3%,會得出「4.7 大退步」的結論,這等於拿兩把不同的尺量身高。比較要限在同一版本內:CursorBench 4.0 從 40.4% 到 46.3%,進步 5.9 個百分點;Terminal-Bench 4.0 從 20.3% 到 38.0%,進步 17.7 個百分點,接近翻倍。換版本也不算 xAI 獨有的招,題目公開久了會滲進訓練資料,分數跟著膨脹,重出一份新題本才量得出真差距;代價是新舊分數不能直接對看,這條規則對所有模型的公告一體適用。
再來是推理強度不對等。官方表拿 4.7 的 xhigh 對 4.6 的 high,社群第一時間就問「為什麼不蘋果對蘋果」。Cursor 員工的解釋:表格比的是各家的最高檔位。獨立站長依 Cursor 的即時評測資料做了同檔修正:high 對 high,4.6 的 40.4% 對 4.7 的 43.9%,進步 3.5 個百分點;xhigh 對 xhigh,41.4% 對 46.3%,進步 4.9 個百分點。同檔之後仍是升級,幅度比官方表的呈現小一號。成本敏感的人再看一個數字:4.7 自己從 high 拉到 xhigh,分數只多 2.4 個百分點,每任務成本卻從 4.69 美元漲到 6.01 美元,貴了約 28%。
官方散點圖的四個檔位,畫出來其實是一條邊際遞減曲線:low 到 medium,分數多 8.5 個百分點,成本多 1.91 美元;medium 到 high,多 2.3 個百分點,多 1.20 美元;high 到 xhigh,多 2.4 個百分點,多 1.32 美元。medium 之後,每多一塊錢買到的分數明顯變薄。日常任務的甜蜜點多半在 medium 或 high;xhigh 的價值在難題,量大的一般工作用不上。
這份獨立整理自己也掛了醒目的但書:Cursor 是 Grok 的開發與經銷夥伴,它的評測有價值,卻稱不上完全獨立,Cursor 先前還揭露過 Grok 4.5 的訓練資料有重疊。0.3 個百分點的差距,放在任何評測裡都不具統計意義。
欄位命名也攪過局:4.7 用 xhigh、4.6 用 high,兩個對手的最高欄都叫 max,五個欄位三套詞彙,各家對「最高檔」的定義又不一定等價。跨表比較的第一步,是把每個欄位的實際設定查清楚,分數擺第二。
第三個坑:排行榜自己會動。Artificial Analysis 的 Intelligence Index 現行版本給 4.7 的 46 分,只比 4.6 的 44 分多 2 分,看起來像小升級。Vals 的模型頁在 9 月 22 日讀取時,4.7 排 59 個模型裡的第 10 名、總分 60.20%,高於 4.6 的 59.17%;同一頁的數字在發布頭兩天就更新過,社交流傳的早期排名跟後來的頁面對不上。獨立榜還在收斂,哪家都別當定論。偏好型的榜更是一片空白:主流的聊天偏好類榜單在 9 月 22 日讀取時還沒有 4.7 的條目,它聊起來順不順、會不會討好使用者,目前查不到任何分數,只能自測。
還有第四個坑:通路。同一個模型走不同通路,測出來的分數不會一樣,AA 用自家 API 帳號測、Cursor 的評測在 Cursor 環境裡跑、Vals 註明用官方 API 的 xhigh 檔。你看到的每個分數,都是模型、通路與設定合出來的結果,模型的純粹屬性談不上。同一週內不同榜單差那麼多,原因在此;自己的任務永遠是最終裁判,原因也在此。
幾個陷阱疊起來,持平的小結是:同價位之下,4.7 對 4.6 的方向是升級,程式與終端機長任務的進步比綜合分數顯著,專業文件工作有官方表兩項冠軍當依據,幅度依任務而定。真正會左右採用決策的,是下一節的 token 帳單。
Token 消耗爭議:單價沒漲,帳單為什麼會變貴
這是 4.7 發布後第三方講最多次的批評。Artificial Analysis 在評測文章裡量到:4.7 用 xhigh 跑分時,每個任務平均輸出 81k tokens,4.6 用 xhigh 只要 38k,超過兩倍。社群把 AA 的整套跑分資料加總換算,4.7 xhigh 燒掉的輸出 token 總量約 2.4 億,換到 46 分;4.6 xhigh 燒約 9,700 萬,換到 44 分。兩倍的 token 換兩分的綜合分,正是「世代級退步」與「可接受的成本」兩派評價吵的分岐點。token 計價不熟的讀者,可以先看站內的 LLM 是什麼裡對 token 的說明。
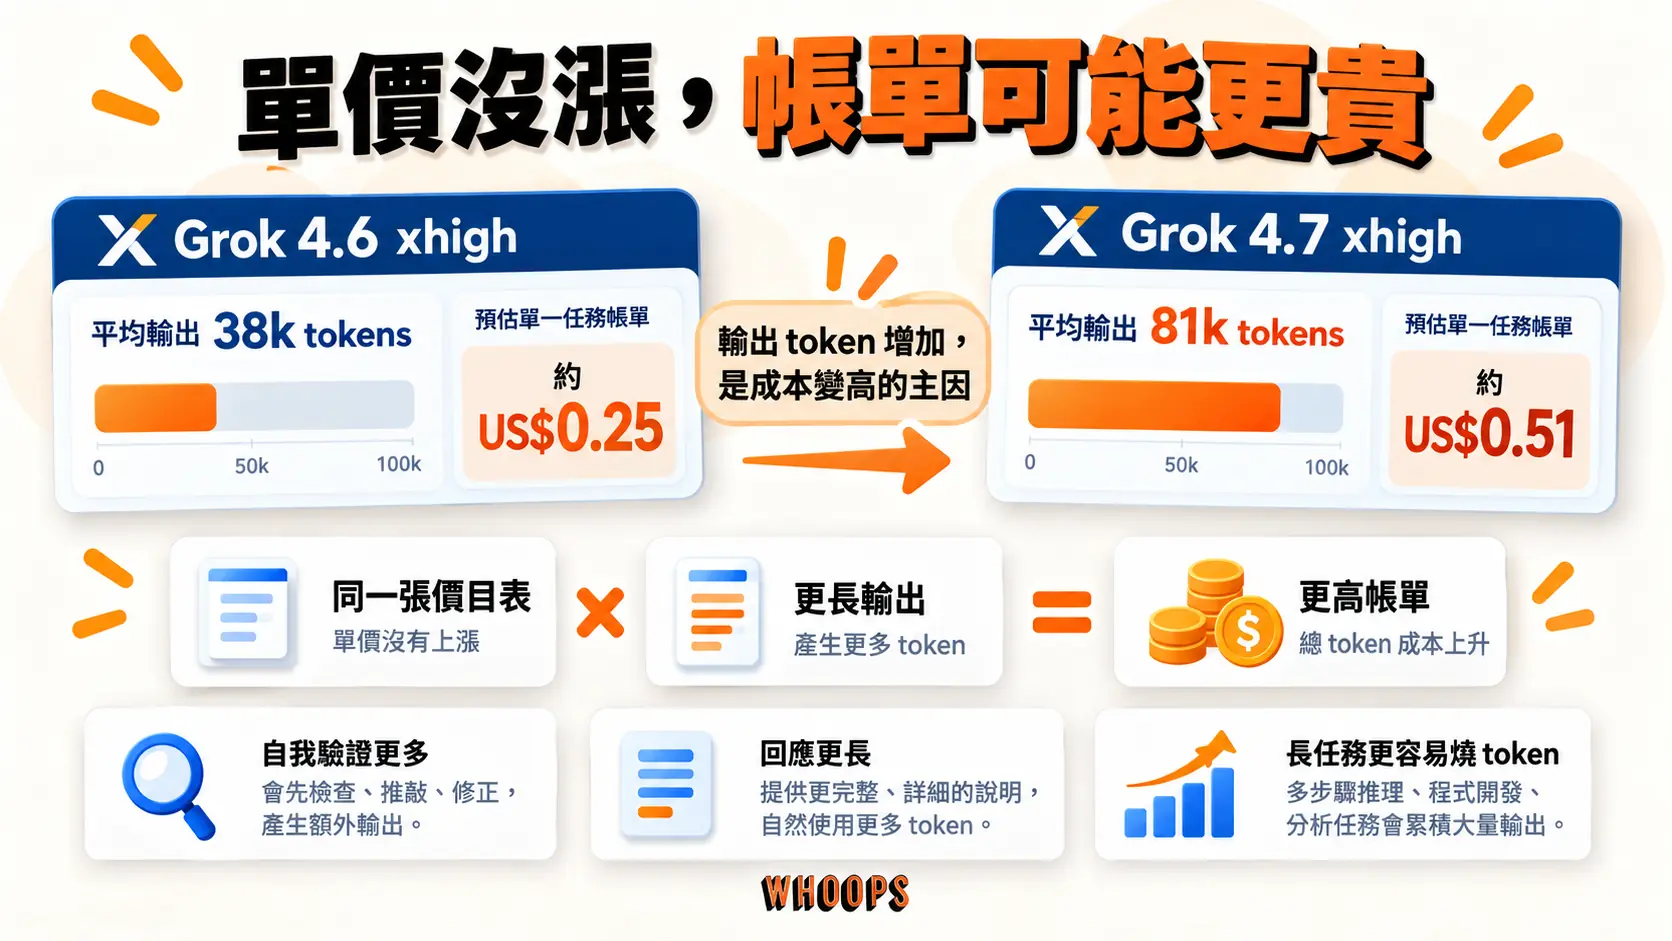
為什麼多燒 token?官方沒給因果解釋,訓練方針裡倒是找得到線索:更長的強化學習、任務偏多小時難題、更多自我驗證,這些方向都把模型推向多想幾步、多檢查一遍、寫得更長。能力和成本,很可能是同一個訓練選擇的兩面。這是依官方描述做的合理推論,機制未經證實,但拿它預期行為很安全:4.7 的輸出天生比 4.6 長,提示裡明確要求精簡、限定輸出範圍,通常是第一個該試的止血帶。
其他口徑指向同一邊。Vals 的評測裡,4.7 每次測試平均花 11.90 美元,在追蹤頁上屬於偏貴的一群;Reddit 與 Hacker News 出現「一次回答燒 6.6 萬輸出 token」的實測貼文,Cursor 論壇也有使用者說「每個任務花的 token 幾乎是 4.6 的兩倍,不再是那種划算的前沿選擇」。個別使用者的說法,方向倒是一致。
套 AA 的數字做個示意估算。假設一個代理任務送進 50k tokens 的前文(快取命中)加上模型輸出:4.7 若輸出 81k,費用是 50,000 乘以 0.50 美元除以 100 萬,加 81,000 乘以 6 美元除以 100 萬,約 0.51 美元;4.6 若輸出 38k,同樣前文約 0.25 美元。同一個任務、同一張價目表,帳單差一倍,原因全在輸出量。示意估算僅供參考,實際金額以平台的計費紀錄為準,但量級感是對的:輸出量是 4.7 時代的第一成本變數。
Cursor 的評測口徑倒是切出另一面。在 Cursor 的長任務評測裡,4.7 xhigh 每任務 6.01 美元,4.6 xhigh 每任務 6.10 美元,成本幾乎相同,分數卻從 41.4% 升到 46.3%。換句話說,在 Cursor 的工作負載上,4.7 是真升級;在 AA 與 Vals 的評測負載上,4.7 明顯更燒 token。兩邊並不矛盾,任務組成不同而已。結論只能是那句老話:你的帳單由你的任務決定。
| 模型與檔位 | CursorBench 4.0 分數 | 每任務平均成本 |
|---|---|---|
| Fable 5.1 Max | 51.8% | 17.28 美元 |
| Claude Opus 5 Max | 46.6% | 11.95 美元 |
| Grok 4.7 xhigh | 46.3% | 6.01 美元 |
| Grok 4.7 high | 43.9% | 4.69 美元 |
| GPT-5.6 Sol Max | 41.7% | 8.23 美元 |
| Grok 4.6 xhigh | 41.4% | 6.10 美元 |
| Gemini 3.8 Flash high | 39.6% | 4.70 美元 |
上表全出自 Cursor 的即時評測,同一把尺,可以互比。Grok 4.7 xhigh 用 6.01 美元拿到 46.3%,已經站進「高分低成本」的那個角落;再往上爬,Fable 5.1 Max 得多花將近三倍錢。預算受限時,4.7 high 以 4.69 美元拿 43.9%,性質上跟 Gemini 3.8 Flash high 的 39.6% @ 4.70 美元打在一起。
快取價是另一處成本細節。4.7 的快取讀取價是每 100 萬 token 0.50 美元,等於輸入價的 25%,業界常見是 10% 上下;對照同一份整理裡 GPT-5.6 Sol 的 0.40 美元與 Fable 5.1 的 0.25 美元,4.7 的快取訂價明顯偏高。三代之間唯一動過的價格就是這一項:4.5 的快取價 0.30 美元,4.6 起漲到 0.50,4.7 照用。長流程代理會反覆重讀前文,快取命中率高時,這個價差會被放大。官方文件建議在請求裡帶 prompt cache key 保證快取命中,長代理流程搭配上下文壓縮,都是把成本壓下來的手段。
省多少可以算。假設一段 100k tokens 的前文在 20 輪對話裡反覆出現:完全沒有快取,20 輪都按輸入價算,20 乘以 0.20 美元、共 4 美元;第一輪全價、其餘 19 輪命中快取,0.20 加 19 乘以 0.05,約 1.15 美元,省下超過七成。長流程代理每一輪都帶著前文,快取命中率幾乎決定這類應用的單位成本,官方文件特別強調 prompt cache key,理由就在這裡。
算總帳時,模型費用只占一欄。同樣的任務,4.7 一輪做完、4.6 要重試兩輪,總成本可能反轉;4.7 的輸出若得人工砍半重寫,省下的 token 錢也會賠進工時。完整的會計式要三項一起記:模型費用、重試次數、人工修正時間,缺一項比較就失真。
打算評估的人,做法可以直接抄:挑一個平常真的要跑的任務,4.6 與 4.7 各跑一輪,記下輸入、輸出、快取命中與總 token 數,加上完成品質與人工修正時間,再算單任務成本。牌價乘以用量才是帳單;單看每 100 萬 token 的單價,4.6 與 4.7 是同一個數字,什麼都看不出來。
Grok 4.7 價格完整拆解
API 計價分兩段,界線畫在 prompt 長度:200k tokens 以下,每 100 萬輸入 2 美元、快取讀取 0.50 美元、輸出 6 美元;達到 200k 以上,三項全部翻倍成 4 美元、1 美元、12 美元。要緊的規則是費率以整筆請求計:prompt 一跨過 200k,整筆都按高費率算,超出多少、落在哪一段,都不影響這個結果。餵長文件的工作,200k 是條要盯緊的線。
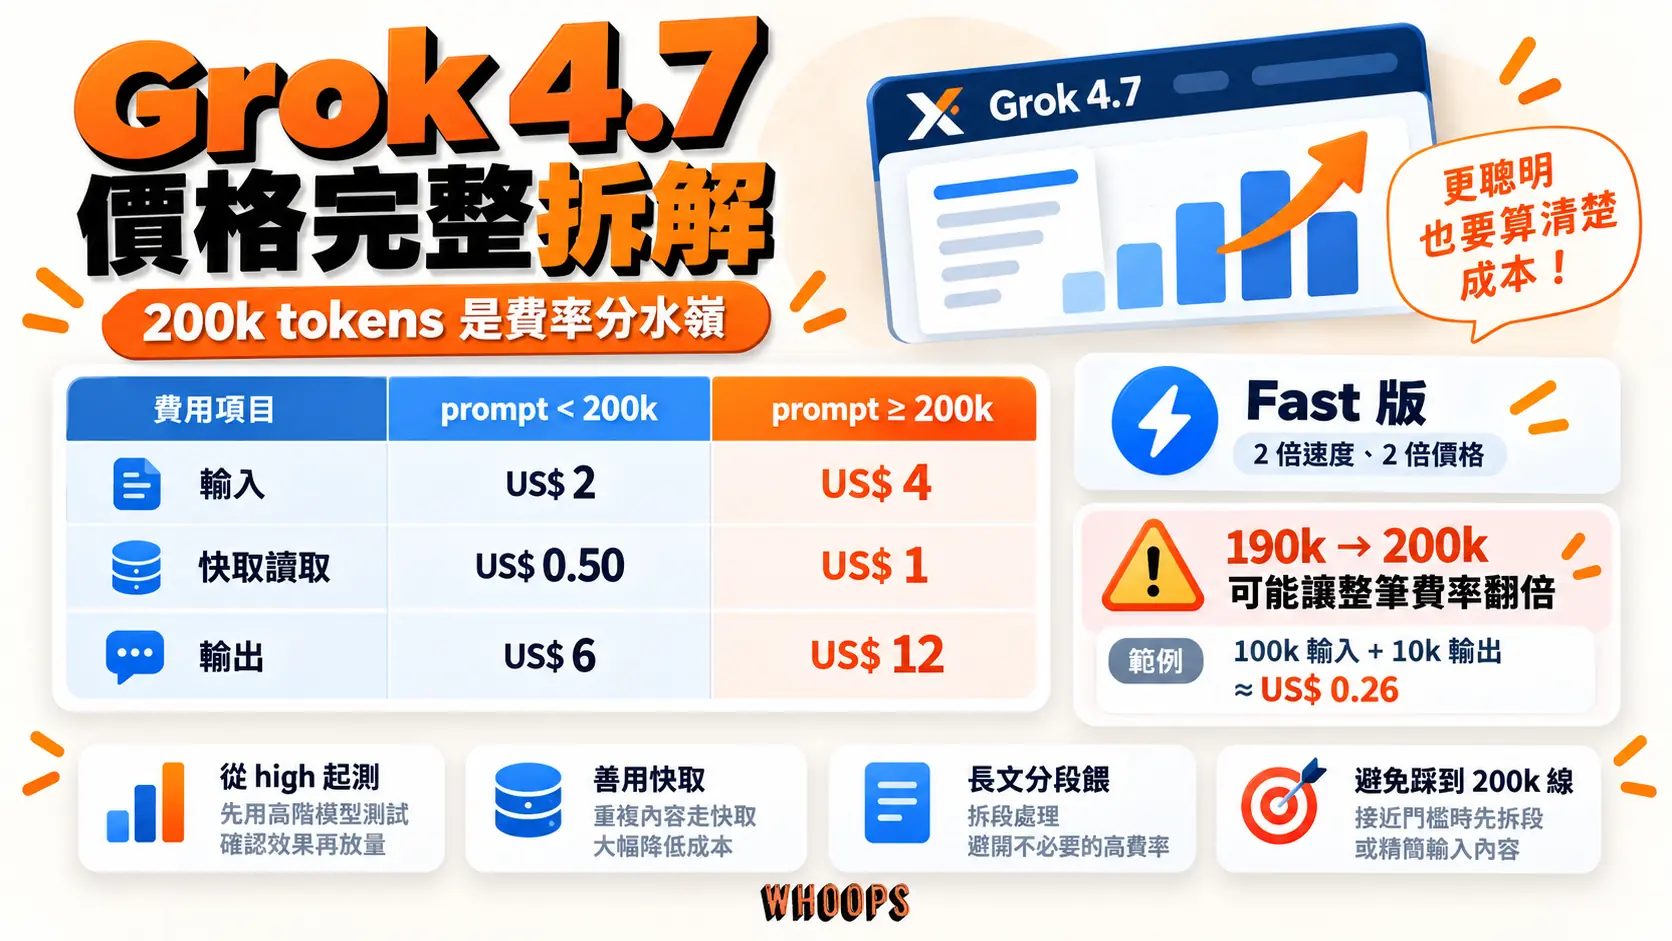
算幾個可重現的例子。送進 100k 輸入、收到 10k 輸出,4.7 在低費率段的成本是 0.20 美元加 0.06 美元,合計 0.26 美元,官方文件拿來示範的就是這組數字。同樣用量換到高費率段,0.40 加 0.12、合計 0.52 美元,剛好兩倍。對手牌價套同一個算式:同樣 100k 加 10k,GPT-5.6 Sol 是 0.40 加 0.20 共 0.60 美元,Fable 5.1 是 1.00 加 0.50 共 1.50 美元。輸出量越大,Grok 的單價優勢越醒目:10k 輸入、80k 輸出的代理任務,4.7 約 0.50 美元,Sol 約 1.64 美元,Fable 5.1 約 5.10 美元。前提只有一個:你的 4.7 沒把輸出量翻倍,這正是前一節的警告。
200k 這條線長得像斷崖,算一次最有感。送進 190k 輸入、10k 輸出,全程低費率,成本約 0.44 美元;輸入多加 10k 湊成 200k,整筆請求跳到高費率,成本變約 0.92 美元。多餵一萬個 token,帳單多一倍。工作會逼近這條線的人,要嘛把材料分批,要嘛把快取顧好,別讓多出來的那一萬個 token 決定整筆費率。
預算控制的槓桿有五根,全立在前面的事實上。檔位從預設的 high 起測,xhigh 那 2.4 個百分點留給真正的難題;長對話帶 prompt cache key,讓快取命中變成常態;超長流程用官方建議的上下文壓縮,別讓 prompt 無限膨脹踩過費率線;長材料分段餵,壓住單筆請求的規模;量大而難度低的工作留在 4.6 或更便宜的模型,4.7 留給它真的做得更好的任務。
| 費率項(每 100 萬 token) | prompt 低於 200k | prompt 達 200k 以上 | Fast 版(低於 200k) |
|---|---|---|---|
| 輸入 | 2 美元 | 4 美元 | 4 美元 |
| 快取讀取 | 0.50 美元 | 1 美元 | 1 美元 |
| 輸出 | 6 美元 | 12 美元 | 12 美元 |
Fast 版是同一個模型,用兩倍費率換兩倍輸出速度,只在 Cursor 與 Grok Build 提供,公開 API 上找不到這個 SKU。Priority Processing 是另一個加價選項,所有 token 類別再乘 2;官方定價頁確認,要用優先處理得在請求裡明確指定服務層級才計費,適合高峰期會卡頓的互動應用,不急的批次工作用不上。批次 API 的 8 折不適用 4.7 與 4.6,只有舊的 4.3 與 4.20 系列有,想靠批次降價,這條路目前不通。
有個數字常讓人混淆:搜尋結果偶爾出現的 2.20 美元輸入價,那是美國區域端點的價格。us.api.x.ai 對所有費率乘 1.1,只有 4.6 與 4.7 掛在這個端點上,屬於資料駐留的選項,標準價並沒有變相調漲。
伺服器工具分開計費,每 1,000 次呼叫:網頁搜尋 5 美元、程式執行 5 美元、檔案搜尋 2.50 美元。X 搜尋在 4.7 發布當天調了價,從每 1,000 則貼文 5 美元,改成每 1,000 則貼文 5 美元、再加每 1,000 個個人檔案 10 美元。會大量抓 X 資料的應用,這個同日生效的調整得重新估算。
第三方通路價擺在一起看。OpenRouter 的模型頁在 9 月 21 日列價輸入 1.60 美元、輸出 4.80 美元、快取 0.40 美元,直營價打 8 折,跟官方文件「批次折扣不適用」的說法擺在一起有些張力;兩邊數字在各自頁面上都是真的,採購前以當天頁面為準,並註明日期。OpenRouter 同頁還有叫 SpaceXAI Priority 的供應商,價位介於兩者之間。
速度與延遲,官方公告半個 tokens per second 的數字都沒給,市面上唯一的公開實測在 Artificial Analysis 的追蹤頁:最低延遲 0.84 秒就吐出第一個答案 token,AA 的混合口徑價是每 100 萬 token 1.4 美元,各檔位的輸出速度差異前面提過。公告副標的「2 倍速」講的是加價的 Fast 版;標準版與 4.6 同速,這是公告內文自己寫的。
速率限制對 4.5、4.6、4.7 一視同仁,分級看 2026 年 1 月 1 日起的累積消費:50 美元解鎖第一級、250 美元第二級、1,000 美元第三級、5,000 美元第四級,每秒請求數從 150 放寬到 500,每分鐘 token 數從 5,000 萬放寬到 1 億。等級只升不降,超限回 HTTP 429,細節在官方速率限制文件。既有 4.6 的用量直接沿用,不必重新養等級。
哪裡可以用 Grok 4.7?
官方的發布貼文寫得明白:4.7 現在就在 Cursor、Grok Build 與 Grok API 上。公告又補一句「第三方編碼環境、模型路由與雲端平台」,這次沒點名任何一家;4.6 發布時可是直接列了 OpenRouter、Vercel、Cloudflare。泛稱裡的每個平台都得逐一查證,以下是把查證結果攤開的現況,時間點 2026 年 9 月 22 日。
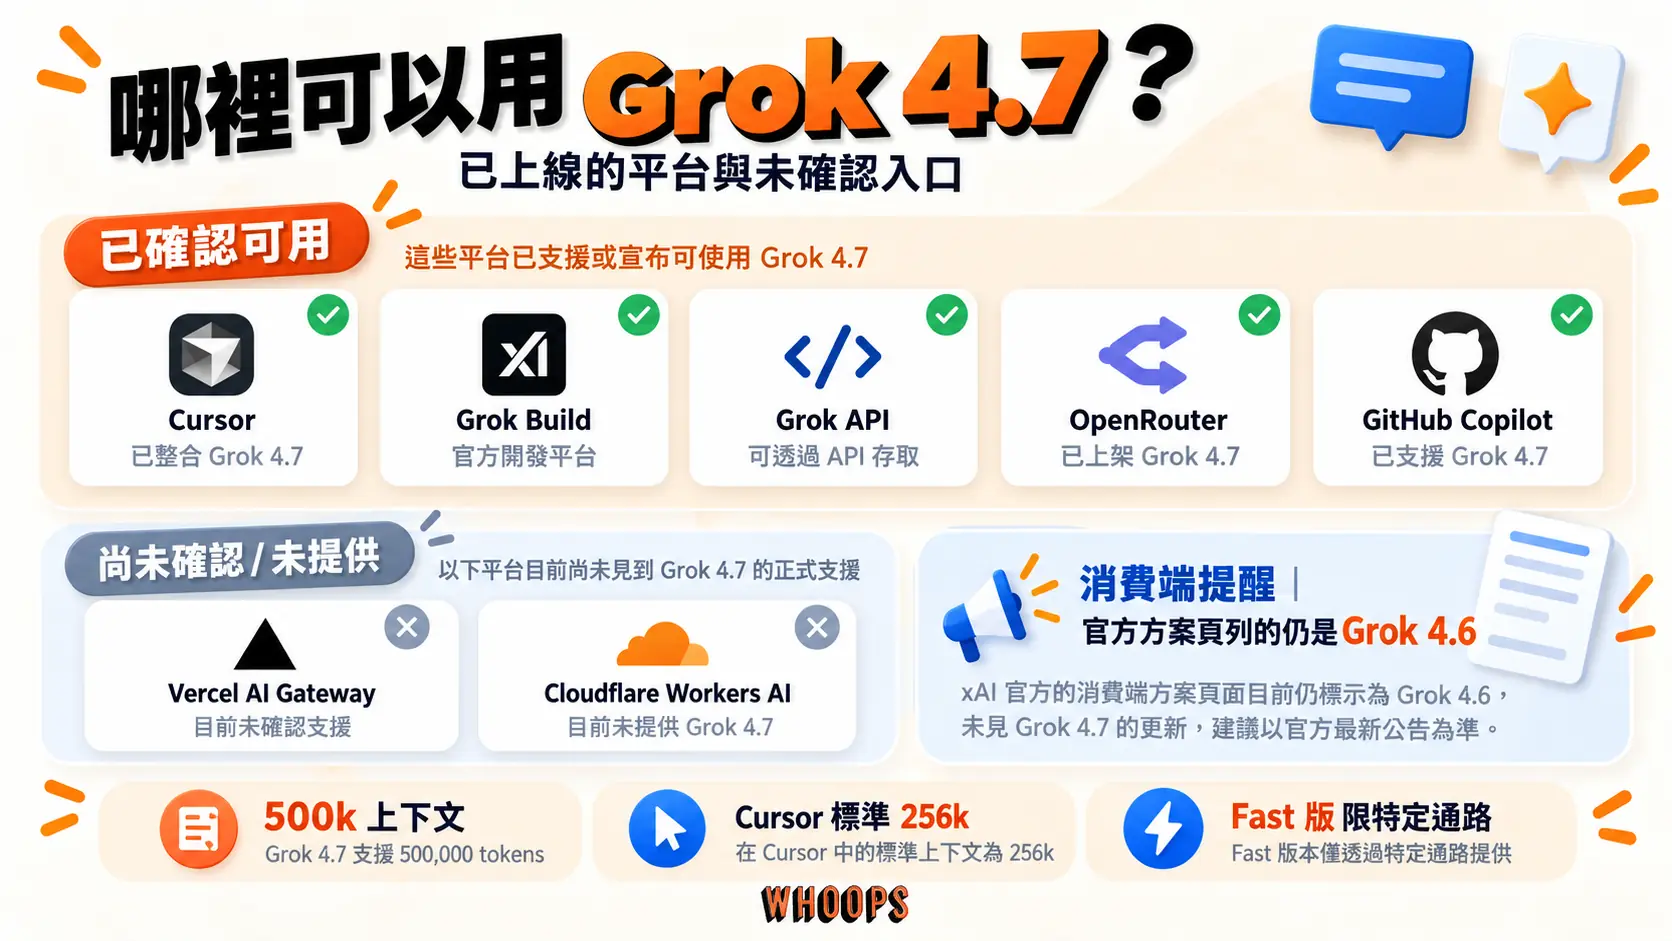
Cursor 是首發平台,4.7 在那裡是與 SpaceXAI 一起打造的第一方模型。依Cursor 的說明文件:標準上下文 256k,超過 256k 的請求走 500k 長上下文、按較高費率計費;所有付費方案都能用,印度的入門方案固定在 medium 檔且不含 Fast;供應範圍是 Cursor 正常提供模型的所有國家,文件直接寫明包含歐盟。這句話有前脈絡:Grok 4.5 在 7 月曾對歐盟全面封鎖,API 控制台半個多月後才解開;4.7 目前沒有任何區域封鎖記錄,Cursor 端則寫死了包含歐盟。
Grok Build 是官方的終端機編碼代理,留了免費的切入點,裝它只要一行指令:
curl -fsSL https://x.ai/cli/install.sh | bash裝完後在專案目錄裡直接派工作,4.7 與 Fast 版都在選單上。這個產品先前鬧過隱私爭議,Grok Build 的完整介紹把事件始末與 privacy 設定整理在專文裡,第一次使用前建議先讀過;第一次跑也建議從測試專案開始,它在終端機裡的權限比聊天視窗大得多。
直連 API 走 console.x.ai。開發者要留意版本別名系統:用基礎名稱呼叫會自動指向最新穩定版,也就是說,4.7 上架當天,原本寫舊別名的程式碼就悄悄換了模型;要釘住版本,得用帶日期的別名或明確指定,讓每次換版都變成你自己的決定,別交給伺服器端的副作用。官方版本紀錄裡沒有 4.6 的退役條目,4.6 仍持續提供;想把行為固定在 4.6 就明確釘版。4.6 沒有退役時間表,急不得,也急不了。
舊版本並未消失,速率限制也是 4.5、4.6、4.7 三代同一套。新模型上線,舊模型沒有跟著下架;4.6 用得好好的流程不必急著遷移,等 4.7 的實測與獨立評測多累積幾週再決定,是完全正當的策略。
GitHub Copilot 同一天宣布跟上,依官方 changelog:Pro、Pro+、Max、Business、Enterprise 方案可用,按用量計費、按供應商牌價;接入面有 VS Code、Visual Studio、Copilot CLI、雲端代理、Copilot app、JetBrains、Xcode 與 Eclipse 八處;推出走漸進式,Business 與 Enterprise 由管理員的模型政策控制。個人方案在模型選單挑用即可,企業環境得等管理員的模型政策放行;升級當天沒看到 4.7,多半只是還沒輪到你的帳號。
OpenRouter 於 9 月 21 日確認上架,500k 上下文,供應商分標準與 Priority 兩條線;頁面標示可用率介於 99.77% 到 100%、輸出約每秒 64 個 token、延遲約 1.07 秒,評測成績註明用 xhigh 檔測得。Vercel 的 AI 閘道至今只確認到 4.6,changelog 翻不到 4.7 條目;Cloudflare Workers AI 同樣沒有。寫整合文件或報價時,這兩家先別假設可用。
同一個模型,四個入口的差異值得在心裡擺一張表。直連 API 拿到完整的 500k 上下文、工具計費與版本別名控制,彈性最大,代價是帳號與用量自己管;Cursor 用方案內的用量計費,標準上下文 256k、要 500k 得走長上下文費率,入門方案釘在 medium 檔;Grok Build 有免費切入點,命令列熟手會喜歡;OpenRouter 一個帳號打通多家模型,通路價與直營價不保證相同。選入口,其實是在選計費單位、上下文上限與資料政策;模型反而是四者裡最確定的一項。
消費端是另一個世界。9 月 22 日實際打開官方訂閱方案頁,模型欄位寫的仍是 Grok 4.6:免費方案 0 元、SuperGrok 每月 30 美元、SuperGrok Plus 每月 100 美元,模型列表明白寫著「Grok 4.6 model」。有媒體報導稱 4.7 已在 Grok app 上線,這跟官方頁面的沉默、方案頁的 4.6 標示擺在一起是矛盾的;官方頁面更新之前,這個說法當傳聞看就好。方案差異與值不值得訂,SuperGrok 方案解析有完整比較。
台灣的可用性,官方從頭到尾隻字未提,也查不到任何區域限制的記錄。合理的推定:API 與開發者平台預設全球供應,帳單用美元計價,台灣沒有被特別對待,也沒有被特別擋。記住這是推定,官方沒給過承諾;4.5 的歐盟封鎖前例擺在那裡,這家公司確實會用區域手段,未來的變動排除不了。以 Cursor 為例,方案頁面與計費都以美元處理,信用卡刷下去就能用,沒有台灣專屬的申請流程;匯率與跨國刷卡手續費,則是年度預算裡該算進去的小項。
怎麼選:四種情況的判斷
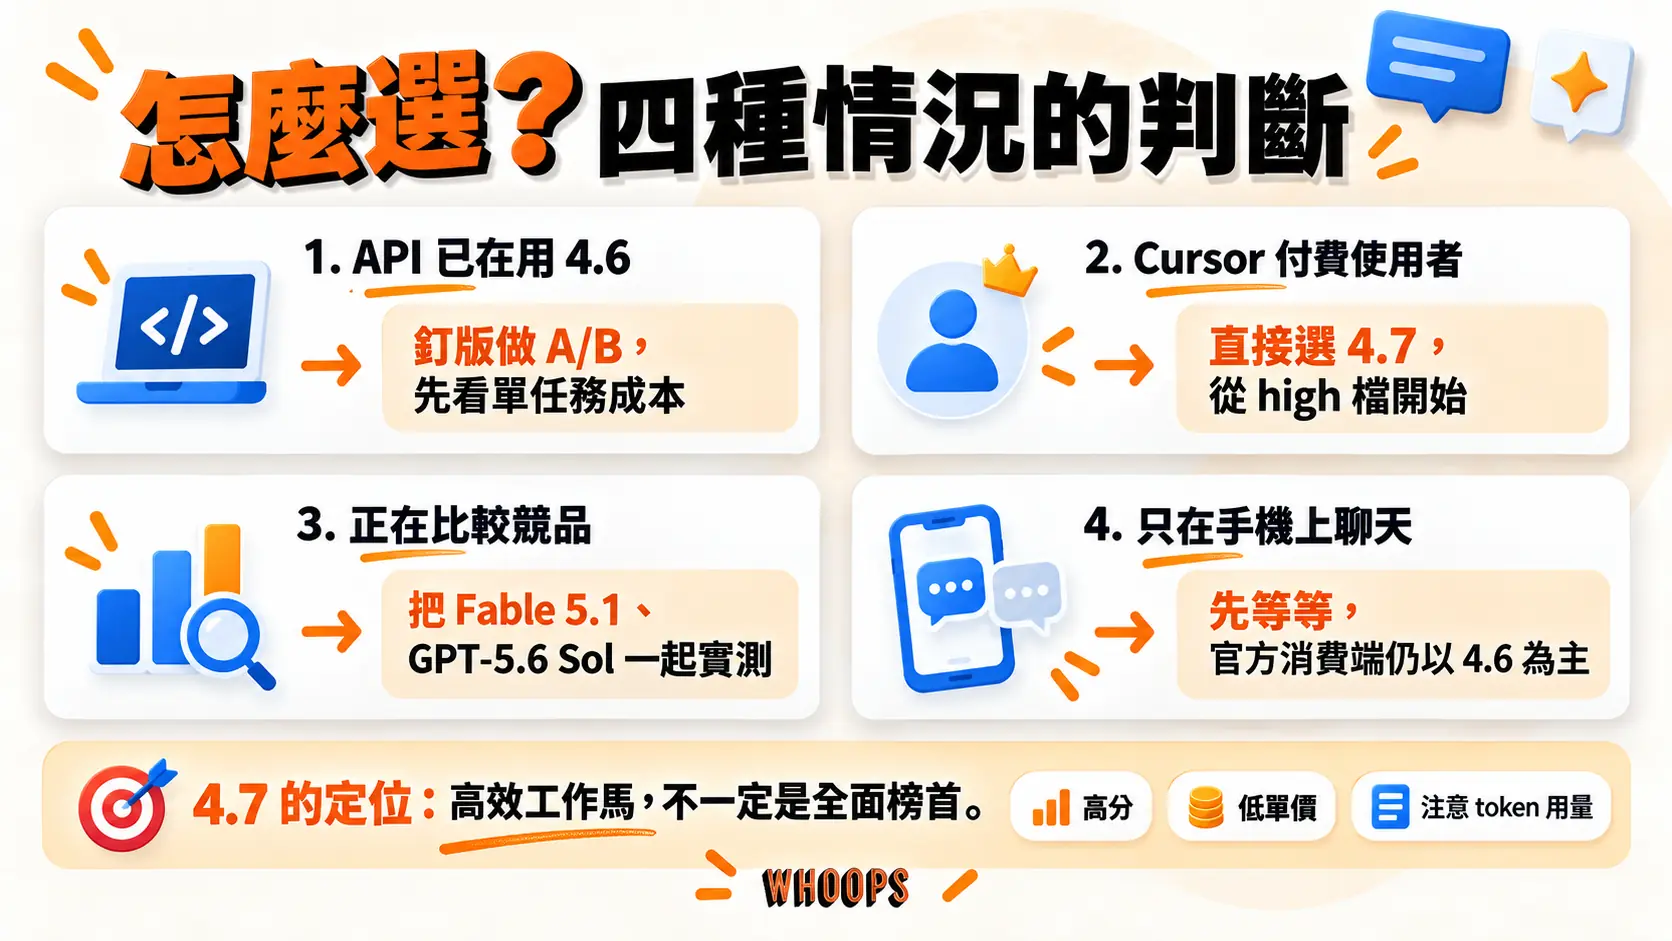
API 已經在用 4.6 的人,這次是低摩擦的升級評估:價格相同、速率限制相同、比較方向向上。挑幾個固定任務做 A/B,釘住版本號避免別名自動切換,同時盯 token 用量。真量出翻倍的輸出量,就把量大又不需要最高分數的流程留在 4.6,混用完全合理。換版可以分三步:正式流程先釘在 4.6,新任務交給 4.7 做影子測試,累積一到兩週紀錄,再決定切換比例。
任務怎麼交代?一段示意寫法:
以下是我們每月固定跑的十項維護任務。逐項完成,每項回報:改了哪些檔案、用什麼方式驗證、結果如何,以及你無法確認的事項。不要更動任務清單以外的檔案。
任務固定、回報格式固定,A/B 才比得公平;動掉其中一項,兩次的結果就不能對著看。
在 Cursor 裡寫程式的人,模型選擇器直接選 Grok 4.7,額外設定一概免了。檔位從預設的 high 起步:分數差 2.4 個百分點、成本貴 28% 的 xhigh,留給真正卡關的難題。急件再考慮 Fast 版;發布當天有使用者反映 Fast 在高峰期反而慢,屬於平台負載問題,過幾天再評估也行。
實戰裡混用比單選常見:研究與探索用低檔跑量,碰上瓶頸才拉 xhigh;同一個任務失敗兩次就換模型,別加倍下注。模型之間切換成本很低,忠誠度在這裡幫不上你。
正在比較競品的人,先看分數結構:要最高分,Fable 5.1 拿走七項裡的四項冠軍,代價是每 100 萬 token 10 美元輸入、50 美元輸出;深度軟體工程看 GPT-5.6,DeepSWE 最高分在它手上;前端與性價比取向,Gemini 3.8 Flash 在非正式的社群榜上口碑不錯。Anthropic 產品線的脈絡,搭配站內的 Claude 完整教學看最快;同週推出的 Claude Opus 5.5 官方稱多數工作達 Fable 5.1 水準、成本降低四成,比較清單值得加一欄。GPT-6 Astra 沒被放進官方散點圖,社群已有質疑;自行比較時把它加進清單,才算公平。
三個對手各給一句話,方便記:Fable 5.1 是分數天花板,貴得有理由;GPT-5.6 Sol 是深度軟體工程的保險,輸出單價是 4.7 的三倍多;Gemini 3.8 Flash 是性價比攪局者,長任務分數輸一截,但便宜耐操。4.7 卡在 Sol 與 Flash 之間:分數貼著第一群,價格貼著第二群,「日常工作馬」的數學就是這麼來的。
Musk 自己發布當天的說法,可以當廠商方少見的誠實定錨:
Grok 4.7 讓 SpaceXAI 在代理寫程式排第三,在 Anthropic 與 OpenAI 之後。把 Grok 明顯更快、成本更低算進來,它是日常工作馬的好選擇。
這段發文的留言區,最高讚的回覆全在質疑「更便宜」三個字,token 用量翻倍的實測正好同一天流出。兩件事擺在一起讀,4.7 的真實定位就清楚了:能力上是第三名的追趕者,成本划不划算,看你的任務長什麼形狀。
只聊天的一般使用者,再等等。手機上的 Grok app 與 grok.com 沒有 4.7 的官方消息,訂閱方案頁列的還是 4.6;對 app 端玩法有興趣的,可以先看 Grok Voice 語音代理的介紹。等官方更新再考慮,現階段沒有為了 4.7 去訂閱或換工具的理由。
| 你的情況 | 優先動作 | 為什麼 |
|---|---|---|
| API 已在用 4.6 | 釘版做 A/B,盯單任務成本 | 同價升級,風險集中在 token 用量 |
| 在 Cursor 付費方案裡 | 直接選 4.7,從 high 檔開始 | 免額外設定,檔位可隨時調 |
| 正在比較競品 | 用自己的任務補測 Astra 與 Fable 5.1 | 官方圖缺一角,單一榜未收斂 |
| 中文工作占比高 | 先做繁中自測再決定 | 官方評測沒有中文專項 |
| 只在手機上聊天 | 等官方方案頁更新 | 消費端列的仍是 4.6 |
中文工作占比高的人,多花一個下午自測,這筆投資省不掉。官方七項評測沒有中文專項,繁中的用詞準確度、語氣一致性、長篇結構,目前連一個分數都看不到;論壇上「變得冗長」的抱怨出自英文任務,方向或許延伸到中文,誰也不敢保證。做法不難:挑三到五個平常真的會交付的中文任務,摘要、改寫、產品文案都行,寫一份固定的評分表,讓兩個模型匿名交叉產出,交給不知道版本的人評分。這一輪換來的結論,比任何排行榜都貼身。
哪種情況都一樣,版本節奏要算進去。4.5 到 4.6 一個月,4.6 到 4.7 一個多月;媒體引述的路線圖裡,4.8 是有意義的一步,4.9 對標 Astra 與 Fable 等級,Grok 5 可能衝擊第一梯隊,全部沒有日期。流程綁死在單一版本上,每次改版都得重測一遍;OpenAI 也在隔天推出 GPT-6 Sol,把代理工作流的 API 牌價較前代砍半,競爭節奏只會更快。留一套可替換的提示與備援模型,比押注哪一版務實。
安全與防護:官方宣稱到哪裡
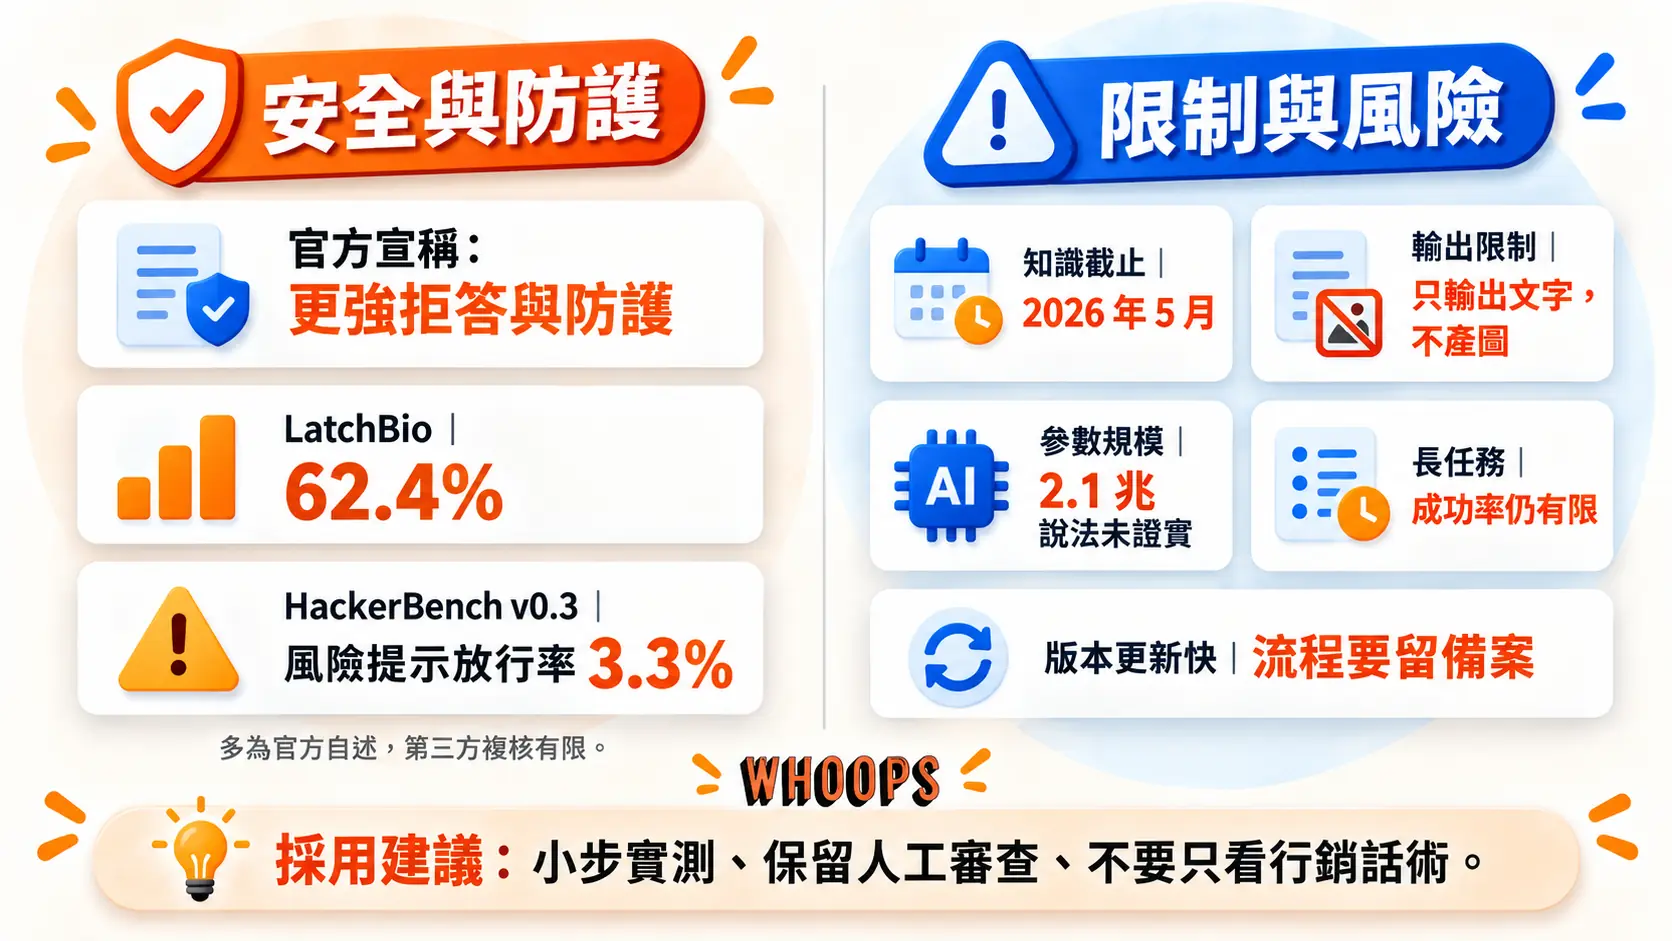
官方說 4.7 換上全新的安全防護架構,是他們測過的模型裡對拒答與越獄抵抗最強的一個,還給了兩個自測數字:LatchBio 生物安全評測 62.4% 拿榜首;自家的 HackerBench v0.3 裡,只有 3.3% 的風險雙用途提示被放行。官方也對特定網安夥伴開了僅限邀請的紅隊測試權限,供防禦研究使用。三件事都停在廠商自述或自家評測,第三方複核不存在;兩個量尺的完整比較集與題目構成,外界看不到全貌。方向可以參考,名次不必照單全收。
獨立端的證據,目前只有 XBOW 的攻防評估,結論摻在一起:部分項目比 4.6 大幅進步,部分略退,部分顯著更好,沒有單一方向的故事。實際的提醒是:安全分數是廠商挑的量表,輸出仍要人工審查,機敏資料照自己的規則處理,別因為「最強防護」四個字就鬆手。
「最強防護」的保護範圍也要畫清楚。官方量的是拒答與越獄抵抗,講的是模型會不會被誘導做出危險回應;你的資料會不會外洩,它沒量,輸出正不正確,它也不保證。機敏文件該看的是平台的資料政策與端點選擇,有資料駐留需求可以考慮美國區域端點;這些決策跟模型安全分數,是兩件事。
限制、傳聞與使用風險
能力的邊界先畫出來。知識停在 2026 年 5 月,不接工具就沒有即時資訊;輸出速度官方沒公布,只有第三方實測;參數規模、訓練資料組成、強化學習配方,全數只有定性描述。媒體上的 2.1 兆參數、用 SpaceX 製造紀錄與衛星遙測訓練這兩種說法,前者未經證實,後者只有單一來源,都別當規格引用。
發布前的傳言正好當反面教材。9 月中曾有報導說 4.7 被擱置、直接改做 4.8,9 月 21 日的實際發布把這個說法證偽;同一批報導也統計過,Musk 從 7 月底以來對時間線至少改口五次。這家公司的時程預告,等產品頁上線再信。
媒體結論的光譜也掃一眼。同樣是發布當週的報導,有人稱它 SpaceXAI 迄今最好的模型、策略是夠好、便宜、到處都買得到;有科技媒體的標題直接寫它多數時候仍會失敗;工程師社群裡,「同價升級很實在」到「上線即死」都有人喊。同一份公告撐不起這麼寬的光譜;分歧本身就在告訴你,證據還沒收斂。採用決策切成可逆的小步,是面對這種不確定性最省錢的姿勢。
使用者的回饋同樣兩極。正面的聲音聚在特定場景:前端網頁開發被形容為現象級、Godot 遊戲場景一發成案、白話英語低諂媚、指令遵循精確。Cursor 論壇上的負面回饋直指輸出品質:有人說它變得冗長又不精確,「4.5 那種簡潔聚焦完全消失了」;也有人改寫 30 頁手冊,拿到滿篇不知所云的比喻,這等於當場打臉官方「更好的文件產出」。個案證言而已,分佈倒值得參考。
代理長任務的成功率也要擺在眼裡。科技媒體 The New Stack 用私人程式碼庫評測後下了個辣標題:它是為長時間工作而生,但多數時候仍會失敗,表現最好的模型也有超過六成任務沒過。評測分數 38% 或 46%,翻成白話就是每兩三次有一次以上得重來或人工接手;把這個比例算進導入成本,才不會高估省下的工時。
長任務的權限風險,不會因為模型變強而縮小。代理能讀檔案、執行命令、連外部服務,一個錯誤判斷傷到的遠超過一段文字;先在可還原的環境裡測,寫入留人工確認,用量與紀錄留到可回查。供應商依賴這件事,同樣一句話:版本一個月一版、通路價格各自浮動,提示與流程留條退路,比押注任何單一模型可靠。
這篇的基準日是 2026 年 9 月 22 日,發布後第三天。四件事會讓結論過期:官方方案頁換上 4.7、獨立排行榜大改版、通路價格調整、4.8 發布。真到了那時候,價格段與平台段要重查,比較段的框架照用。
結論:Grok 4.7 值不值得現在用
開發者值得馬上做一輪 A/B。同價、同速率限制、比較方向向上,CursorBench 與 Terminal-Bench 的同版本進步是真的,法律與電子工程兩項冠軍也給了專業文件工作一個明確的測試理由。可 token 用量翻倍的第三方實測一樣是真的,評估重心要放在單任務成本,牌價先放一邊。
追求極致分數的人,這一代的榜首仍姓 Anthropic 與 OpenAI,官方表自己承認,Musk 的發文再補一刀。4.7 站的位置是高效工作馬:分數夠高、單價明顯較低,代價是可能的用量膨脹,加上還在收斂的獨立評測。
一般使用者再等等。消費端還在 4.6,訂閱頁白紙黑字。等 4.7 出現在官方方案頁,回頭看這篇的價格段算帳,不遲。
三個月後回來看這篇,查四件事就夠:獨立排行榜收斂了沒、官方方案頁換上 4.7 了沒、社群的 token 用量資料聚出共識了沒、4.8 的消息出了沒。四個都翻頁,就把價格段與平台段重算一遍,決策自然更新。
常見問題
Grok 4.7 是什麼?什麼時候發布的?
Grok 4.7 是 SpaceXAI 在 2026 年 9 月 21 日發布的旗艦模型,定位是寫程式與知識工作。上下文視窗 500k,收文字與圖片輸入、只輸出純文字,推理強度有 low、medium、high、xhigh 四檔,另有 2 倍速度、2 倍價格的 Fast 版。發布當天上線 Cursor、Grok Build 與 Grok API。
Grok 4.7 跟 4.6 差多少?值得升級嗎?
同版本評測內,CursorBench 4.0 從 40.4% 升到 46.3%,Terminal-Bench 4.0 從 20.3% 升到 38.0%,方向是升級;Artificial Analysis 的綜合分從 44 到 46,幅度小得多。評測版本與推理檔位要對齊再比,舊分數對新分數會誤判。價格與速率限制完全不變,升級評估的成本都壓在 token 用量上:4.7 的每任務輸出量被量到是 4.6 的兩倍以上。
Grok 4.7 多少錢?
API 依 prompt 長度分兩段:200k 以下每 100 萬輸入 2 美元、快取讀取 0.50 美元、輸出 6 美元;達 200k 以上整筆請求按 4 美元、1 美元、12 美元計。Fast 版費率是標準版 2 倍,只在 Cursor 與 Grok Build 提供。批次折扣不適用 4.7。對手牌價:GPT-5.6 Sol 是 4 與 20 美元,Fable 5.1 是 10 與 50 美元。
哪裡可以用 Grok 4.7?手機上的 Grok app 有嗎?
確認可用的是 Cursor、Grok Build、Grok API 與 OpenRouter,GitHub Copilot 同日宣布漸進推送。Vercel 的閘道與 Cloudflare Workers AI 尚未提供。消費端方面,官方訂閱方案頁列的模型仍是 Grok 4.6,grok.com 與 Grok app 沒有 4.7 的官方消息;有媒體稱 app 已上線,與官方頁面矛盾,建議以官方更新為準。
台灣可以用 Grok 4.7 嗎?
官方沒提過台灣,也沒有任何區域限制記錄,合理推定是 API 與開發者平台預設全球供應、美元計費、無台灣專屬流程。這是推定而非官方承諾;Grok 4.5 曾於 2026 年 7 月封鎖歐盟,區域變動確實可能發生,重要流程要留備案。
Grok 4.7 跟 GPT-5.6 或 Fable 5.1 比哪個強?
依官方表,Fable 5.1 拿走七項評測裡四項最高分,GPT-5.6 Sol 拿 DeepSWE,Grok 4.7 拿 Harvey Legal 與 EEBench 兩項。整體能力的第一梯隊目前是 Anthropic 與 OpenAI,Musk 自己也這樣說。Grok 4.7 的強項在價格:輸出牌價是 GPT-5.6 Sol 的十分之三、Fable 5.1 的約八分之一,前提是 token 用量沒有膨脹。
為什麼有人說 Grok 4.7 反而更貴?
單價與 4.6 相同,但 Artificial Analysis 量到 4.7 xhigh 每任務輸出 81k tokens,是 4.6 xhigh 38k 的兩倍以上,輸出又正是計費最貴的部分,帳單可能不減反增。Cursor 評測口徑下,每任務成本倒是與 4.6 相近。實際影響要用自己的工作負載量測,光看牌價看不出來。
Grok 4.7 知道最新事件嗎?
不知道。知識截止日是 2026 年 5 月,比發布日早四個月,不接工具時對 6 月以後的事件沒有資料。API 可開啟網頁搜尋、X 搜尋與程式執行工具拿即時資訊,按次計費。
Grok 4.7 的參數規模是 2.1 兆嗎?
未證實。官方只說用了比 4.6 更大的新基座模型,從沒公布參數數字;2.1 兆的說法出自媒體報導,獨立追蹤者標記為未確認。任何具體參數數字,目前都只能當傳聞。
Grok 4.7 有免費用法嗎?
Grok Build 有免費的切入點,Cursor 的付費方案內含用量,API 按量計費。消費端的免費方案列的模型是 Grok 4.6;想免費碰到 4.7,目前只有開發者工具這條路。

討論與提問