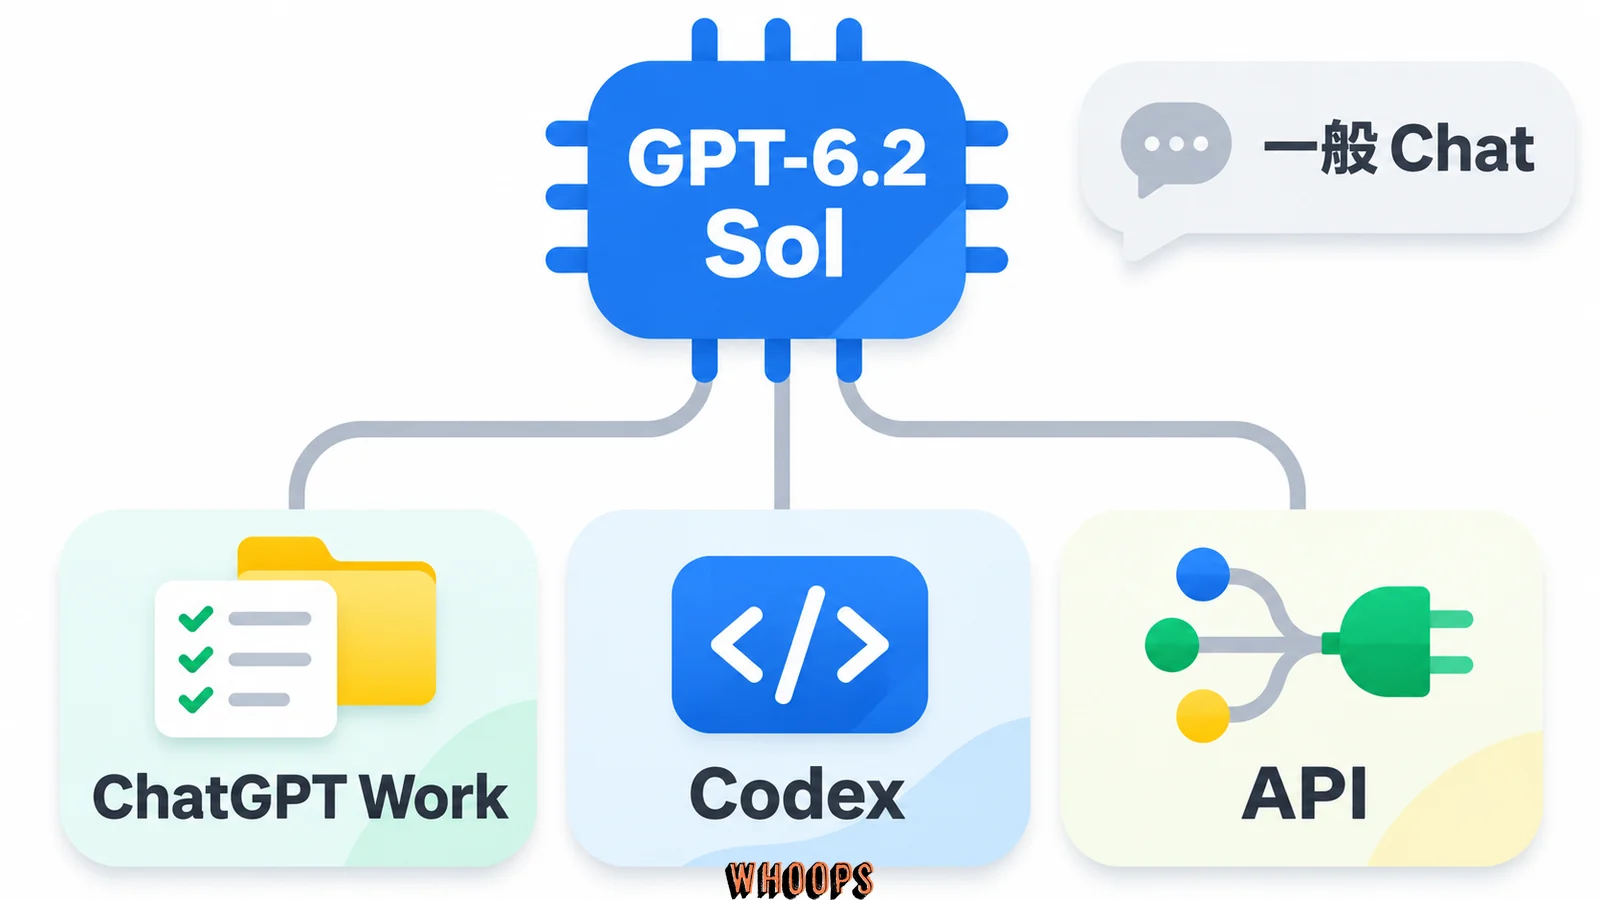
GPT-6.2 Sol 是 OpenAI 用於日常寫作、程式開發與多步驟代理工作的推理模型。它與 GPT-6.2 Astra 在 2026 年 11 月 17 日發布,台灣時間為 11 月 18 日。訂閱用戶可在 ChatGPT Work 和 Codex 使用,實際開放取決於方案與帳戶進度。開發者可用 API 模型 ID gpt-6.2-sol 呼叫。
API 標準費率與 GPT-6.1 Sol 相同,每百萬 Token 輸入 2 美元、快取讀取 0.10 美元、輸出 10 美元,API 上下文視窗為 1,050,000 Token。日常程式與文件工作可先用 Sol。需要高難度推理或精緻專業交付物時,再用 Astra 跑同一批任務,比較完成率與單件成本。
GPT-6.2 Sol 是什麼:日常工作主力的第三代接力
GPT-6.2 Sol 在 OpenAI 模型目錄裡的定位是日常工作的預設主力,官方給它的角色是 go-to model:多步驟代理工作流、清楚自然的寫作與好協作的性格都歸這一層,許多 OpenAI 員工把它當成技術與非技術工作的預設模型。11 月 17 日的GPT-6.2 發布公告把兩個新模型包在一起講,Astra 負責最難的專案,Sol 負責其餘的絕大多數工作。
Some of you have been asking very politely. Some of you have just been asking.
— OpenAI (@OpenAI) November 17, 2026
GPT-6.2 Astra and Sol are now available.
Super efficient and built to perform where it counts—the real world.https://t.co/qr2iP0GpfX pic.twitter.com/jLCyVIws2Y
圖說:OpenAI 官方發布貼文,GPT-6.2 Astra 與 Sol 同日上線,主打效率與真實世界任務的表現。
這已經是 Sol 層位三個月內的第三次接力。GPT-6 Astra 在 9 月 3 日接班旗艦,GPT-6 Sol 與 Luna 在 9 月 22 日補上量產位,DevDay 的 GPT-6.1 Sol 於 9 月 29 日把主力位往上頂一階,10 月 27 日再加入更便宜的 Terra,現在 6.2 Sol 在 11 月 17 日接棒。前一代 6.1 Sol 的快取降價與遷移細節,可對照我們之前寫的GPT-6.1 Sol 完整解析,本文不再重複那一段家族史。
官方文件給 Sol 的示例任務很能說明它的使用形態:審查一個 pull request 並點出作者該處理的問題、按 reviewer 回饋修改實作並跑相關測試,或是把會議筆記整理成專案簡報,抓出決議、下一步與待釐清的問題。這類任務的共同點是步驟多、上下文長,單步難度又不到旗艦等級,價格與能力都落在中間的模型接得最剛好。
模型更新的單位從季壓縮到週,對採購與工程團隊的實際影響很具體:只要模型名稱寫死在程式碼、採購單或驗收條款裡,每一波都得重跑一次對照測試。OpenAI 沒有承諾任何一代的支援年限,6.1 Sol 與 6.2 Sol 目前在 API 同價並存,這對已經上線的服務是緩衝,對新專案則代表選型要以能力而不只是版本號為準。
核心規格:1,050,000 Token 上下文與能力邊界
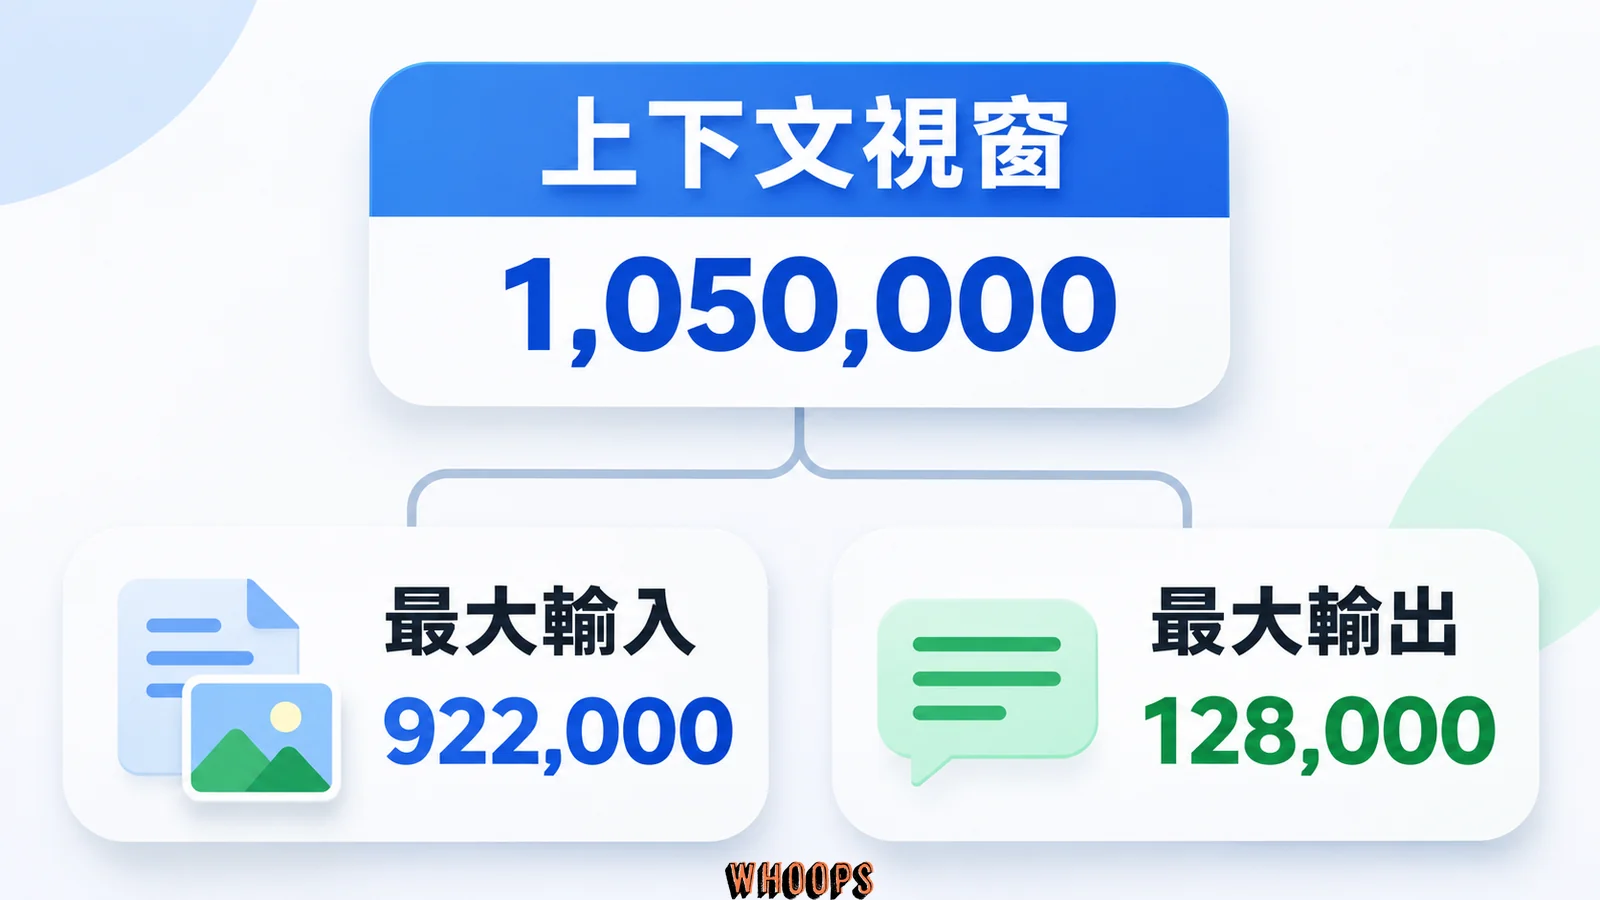
GPT-6.2 Sol 的 API 識別碼是 gpt-6.2-sol,上下文視窗 1,050,000 Token、最大輸入 922,000 Token、最大輸出 128,000 Token,知識截止日是 2026 年 6 月 1 日。官方模型卡把它描述為從寫程式到大規模代理都適用的日常工作模型,規格數字全數以該頁為準。
| 項目 | 規格 |
|---|---|
| 模型識別碼 | gpt-6.2-sol |
| 上下文視窗 | 1,050,000 Token |
| 最大輸入 | 922,000 Token |
| 最大輸出 | 128,000 Token |
| 知識截止 | 2026 年 6 月 1 日 |
| 輸入與輸出 | 輸入文字與圖片,輸出純文字 |
| 推理設定 | 支援推理 Token,none 會被 API 拒絕 |
輸入輸出邊界要讀清楚。Sol 接受文字與圖片輸入、只產生文字,音訊與影片不在支援範圍,Realtime 語音端點與圖片生成端點都用不上它。若使用 Responses API,可以另外呼叫圖像生成工具。推理行為有一個新的硬規則:請求裡把 reasoning effort 設成 none 會直接被 API 拒絕,想壓低成本的正式途徑是縮短上下文、提高快取命中率或改走 Batch。
這組上下文數字的實務意義比規格表本身更有用。922,000 Token 的輸入上限代表一個中型程式庫、數十份合約或整套產品文件可以一次放進對話,128,000 Token 的輸出空間讓完整的改動說明、長篇報告或整段程式碼不必拆開重來,實際可放入的資料量仍取決於請求已使用的上下文,包括對話、指示與工具定義。這些都是 API 規格。圖片輸入讓 UI 截圖與圖表直接進入同一條工作流,讀圖與寫作在同一個模型裡完成。知識截止從 6.1 Sol 的 4 月 30 日推進到 6 月 1 日,時間敏感的問答任務直接受益。
能力面配合 Responses API 展開。Sol 可以呼叫網頁搜尋與 computer use 工具,也能透過Multi-agent 測試版把工作委派給子代理,折扣價的背景完成視窗同樣在公測階段。端點支援以 Chat Completions、Responses 與 Batch 三條路為主,微調、Assistants 與語音相關端點都不支援,依賴舊整合的團隊要先對照這份清單。
端點選擇上,Responses 是 6.2 的主要介面,工具呼叫、子代理委派與背景完成視窗都掛在這條路徑上,Chat Completions 繼續支援的用意是讓既有整合無痛換模型。新專案沒有歷史包袱的話,直接走 Responses 才吃得到完整的功能面。背景完成視窗在公測階段就提供折扣價,適合不趕時間的大量生成工作。
官方對 GPT-6.2 家族的提示詞建議反映了一批實際行為變化。模型預設寫得更直接精簡,系統提示裡的「請簡潔」類指示值得重看。意圖不明時模型會提出下一步並等待確認,長任務要明確授權它繼續往下做。寫程式傾向更有效率的風格,專案慣例要直接寫進提示。Using GPT-6.2 指南對這些行為都給了對應的提示改法,遷移時照著清一遍比憑感覺改有效。
API 價格:費率照舊,真正的降價來自 Token 效率
GPT-6.2 Sol 的標準費率維持每百萬 Token 輸入 2 美元、快取讀取 0.10 美元、輸出 10 美元,與 GPT-6.1 Sol 完全相同。在 OpenAI 的API 定價頁上,gpt-6.2-sol 與 gpt-6.1-sol 兩列數字一致,OpenAI 公布的部分評測顯示,新版能以較少輸出 Token 完成任務。要確認實際節省多少,可用同一批請求比較兩代的 Token 用量與完成率。
| 模型 | 標準輸入 | 快取讀取 | 輸出 | 長上下文輸入 | 長上下文輸出 |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 2.00 | 0.10 | 10.00 | 4.00 | 15.00 |
| GPT-6.2 Astra | 8.00 | 0.40 | 40.00 | 16.00 | 60.00 |
| GPT-6.1 Terra | 1.00 | 0.05 | 5.00 | 2.00 | 7.50 |
| GPT-6 Luna | 0.10 | 0.01 | 0.50 | 0.20 | 0.75 |
把兩代的牌價差距排在一起看,會發現這波定價的另一層意義。GPT-6 Astra 對 6.1 Sol 的輸入與輸出價差都是五倍,6.2 Astra 對 6.2 Sol 收斂到四倍,旗艦的輸出入牌價降了兩成、快取輸入降了六成,Sol 費率按兵不動,等於旗艦的進場門檻實質變低了。預算固定的團隊重新調整 Astra 與 Sol 混合比例的時間點,就是這種價差收斂出現的時候。
費率結構的細節藏在倍率規則裡。快取寫入每百萬 Token 收 2.50 美元保存 30 分鐘,拉長到 12 小時是 5.00 美元;輸入超過 272,000 Token 的請求,輸入與快取費率加倍、輸出費率乘上 1.5 倍,而且倍率適用整個請求。Batch 一律標準半價,Fast 是兩倍,API 的 Ultrafast 到 2027 年 2 月 28 日當天為止按三倍計算,3 月 1 日起調成六倍,日期以太平洋時間為準。
In the API, use gpt-6.2-astra and gpt-6.2-sol. Both models also support Fast and Ultrafast modes.
— OpenAI Developers (@OpenAIDevs) November 17, 2026
We’re cutting Ultrafast pricing by 50% for the next three months, making it available at just 3x the cost of Standard for API and Enterprise users.
Ultrafast is also coming to Pro…
OpenAI Developers 公布 GPT-6.2 的 API 模型代號、Fast 與 Ultrafast 模式,以及 Ultrafast 的限時折扣。
以短上下文標準價試算,每百萬 Token 的 30 分鐘快取首次寫入是 2.50 美元,之後每次命中讀取是 0.10 美元。依官方快取計費說明,寫入費率已包含該批 Token 的輸入費。同一前綴在期限內寫入一次、完整命中一次,共 2.60 美元,低於兩次都用標準輸入價的 4 美元。實際節省取決於前綴命中比例及是否重寫快取。
長上下文的操作策略跟著 272,000 Token 這條線走。把系統提示、工具定義、參考資料和對話累計在內的單次總輸入控制在邊界內,就能適用短上下文費率;真的需要把整個知識庫一次塞進去,先按長上下文費率把總帳算出來,再決定要不要改成先檢索再分層載入。同一批文件跑批次時,Batch 半價與長上下文倍率可以疊加計算。
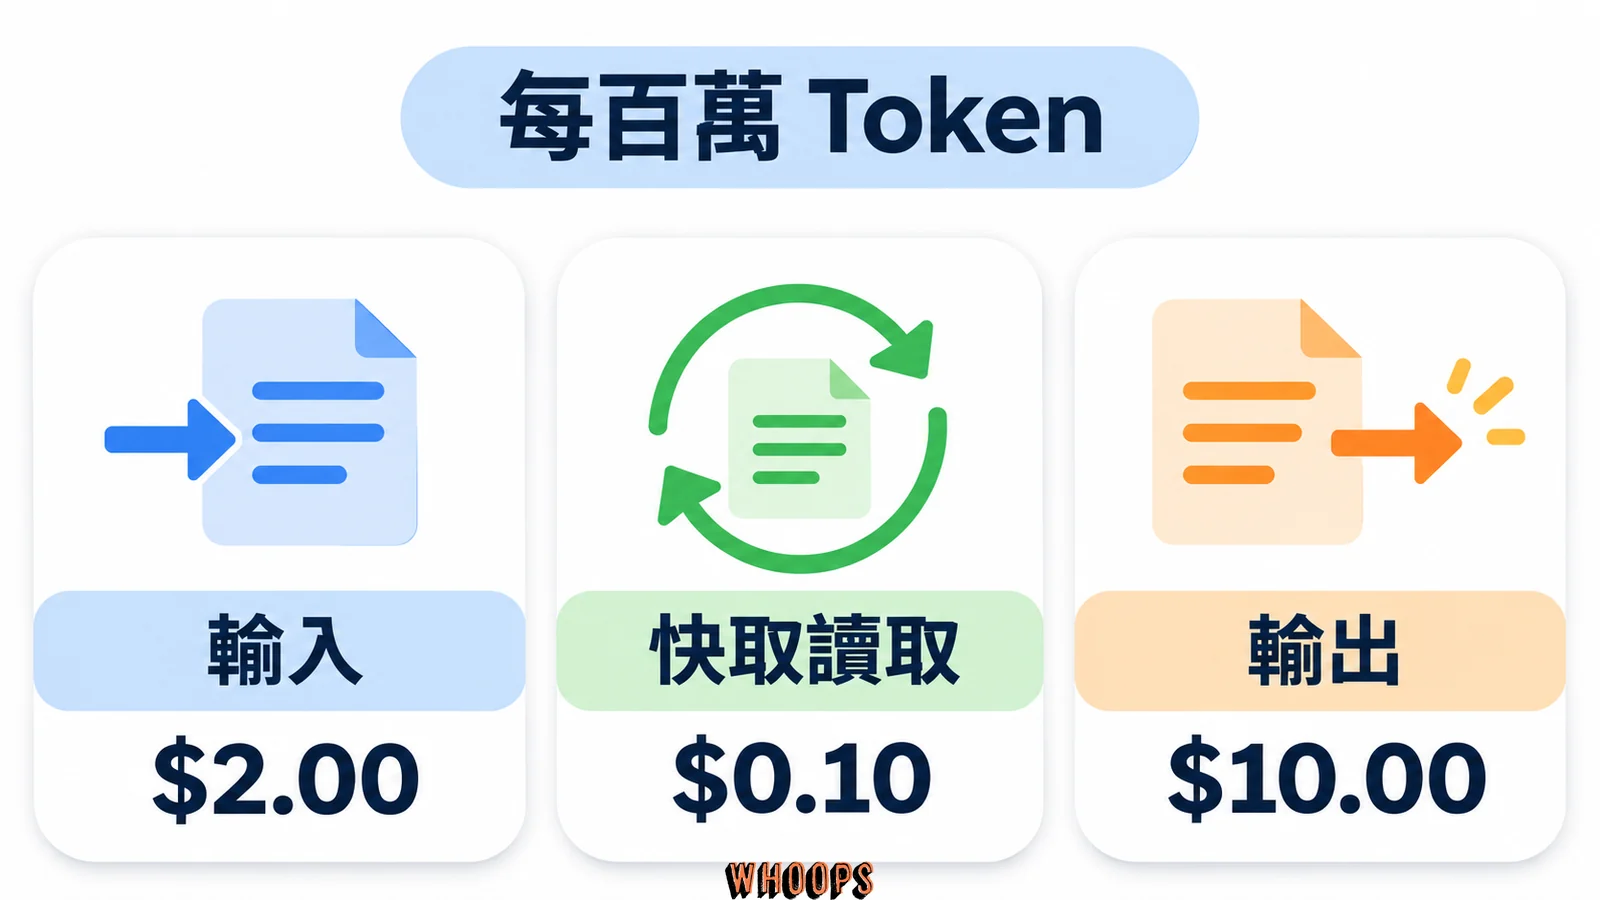
同一個負載放進三個模型,差距就是純粹的牌價倍數:Astra 對 Sol 每個計費項目都是四倍,Terra 則剛好是一半。以每天輸入 100 萬 Token、其中 80 萬命中快取讀取、輸出 50 萬 Token 的代理工作流連跑 30 天計算。每個請求的輸入都在 272,000 Token 以內。試算採短上下文標準費率,另行收費的快取寫入和工具費用未列入。
| 模型 | 標準輸入 | 快取讀取 | 輸出 | 30 天合計 |
|---|---|---|---|---|
| GPT-6.2 Sol | 12.00 | 2.40 | 150.00 | 164.40 |
| GPT-6.2 Astra | 48.00 | 9.60 | 600.00 | 657.60 |
| GPT-6.1 Terra | 6.00 | 1.20 | 75.00 | 82.20 |
這組數字把選型壓力測試得很清楚。輸出占了大宗,Sol 的價差優勢在輸出重的代理工作流上最明顯;要再往下壓單價的純文字批次,GPT-6.1 Terra 把每個計費項目再砍半,我們在Terra 的規格與價格解析裡拆過它與 Sol 的能力差距,用同一批任務驗證低單價能否換到更低的完成成本。把 Pro 200 月費 200 美元換算成 API 額度等於 1 億個標準輸入 Token 或 2,000 萬個輸出 Token,訂閱方案走的是方案內額度而不是計量付費,這個換算只提供規模感。
ChatGPT Work 與 Codex:誰現在就用得到
GPT-6.2 Sol 首波在 ChatGPT Work 與 Codex 向符合資格的帳戶推出。一般 Chat 的模型選單維持原樣,Free 與 Go 方案正分批改用 GPT-5.6 Luna。OpenAI 說明中心的 rollout 條目寫得明白:要不要更新桌面版、方案是否在清單內、workspace 權限有沒有開,三者都會決定你今天能不能選到它。
可用方案涵蓋 Plus、Pro、Business、Enterprise 與 Edu,網頁、桌面與行動版的 Work 都吃得到,Enterprise 與 Edu 則要管理員先在 workspace 設定裡啟用模型。還不清楚 Work 與一般 Chat、Codex 介面差異的讀者,ChatGPT Work 的定位拆解先把三個客戶端的分工講清楚再回來看這一段會更順。
實際開始用的動作只有兩個。桌面版先走「選單 > 檢查更新」並重新啟動 App,Codex CLI 同樣更新到最新版;更新後若還看不到模型,先核對方案與工作區權限,再等帳戶開放。
預設行為是這波更新裡最值得記住的一件事。依照官方更新說明,消費方案的新 Work 對話直接預設 Sol、推理強度 Light,有模型存取權的 Enterprise workspace 預設 Sol、強度 Medium;介面出現 Power 滑桿時,要到 Advanced 才能手選模型與推理強度。帳戶開放後,新 Work 對話可直接用這些預設值。
Work 與一般 Chat 是並存的兩個介面。既有的對話紀錄、GPT 與其他功能都留在原本的 Chat 側,Work 是獨立的工作空間,6.2 兩個模型只存在 Work 側,Chat 側的模型清單這次沒有變動。第一次進 Work 的人會看到任務導向的介面,從聊天側轉換過來的操作成本不高。
Codex 側的入口是 App 的模型選單或 CLI 的 /model 指令,官方給的分工例是把跨服務追 bug 交給 Astra,PR 審查與按 review 回饋改碼交給 Sol。Work 與 Codex 共用同一份用量額度,兩邊一起吃的團隊要合併計算。把 Codex 放回工具選型脈絡,Codex 與 Claude Code 的比較拆過兩者在工作流與費用的取捨,Sol 這波升級也會影響那組對比的結論。Ultrafast 同步開放。Pro 200 可在 Codex 搭配 Sol,Pro 500 可搭配兩款模型。
效能定位:四個基準看 Sol 的位置
OpenAI 發布的評測顯示,GPT-6.2 Sol 在 FrontierCode 2.0 的成績接近 GPT-6.2 Astra,同為 max 設定時,每次任務成本約為 Astra 的五分之一。這個比例來自該評測,其他任務的成本會隨輸入、輸出與推理用量變動。
這幾個基準的評法差異值得先記住再讀分數。FrontierCode 2.0 看對真實 codebase 的修改能否達到維護者的合併標準,GDPval v2 取自顧問、金融與設計等領域的長程實務專案,LifeVal 模擬個人化的日常任務,AA-3D 讓人類評審盲測同題材的兩份互動體驗後投票。四種評測衡量不同工作,成績與成本要依各自的任務和比較對象解讀。
程式工作的代表性數字來自 Cognition 的 FrontierCode 2.0,這個基準評估對真實 codebase 的修改能否達到維護者的合併標準。GPT-6.2 Sol 在同為 max 設定下距離 GPT-6.2 Astra 只有 0.5 分,成本約五分之一。這是 OpenAI 在發布公告中報告的結果。長程知識工作的 GDPval v2 上,Sol 比 GPT-6.1 Sol 進步 5.3 分,Astra 同場比 GPT-6 Astra 進步 6.2 分並省下 22% 的輸出 Token。
生活任務與 3D 體驗兩個角度補上工作以外的樣貌。OpenAI 的 LifeVal 評估租房、找幼兒園、飲食規劃這類日常任務,GPT-6.2 Sol 在其上勝過 GPT-6 Astra,成本約七分之一。互動 3D 盲測 AA-3D 的 Elo 為 Astra 1,318 分、Claude Fable 5.2 1,271 分、Sol 1,259 分。Astra 在這項評測領先,Sol 也能把文字需求做成互動瀏覽器場景。
Astra 同場公布的三個數字幫助定位旗艦的差距。Agents’ Last Exam 上 Astra 比 GPT-6 Astra 高 5.2 分、成本不到三分之一,比 Claude Fable 5.2 高 5.5 分、成本只有對方的 5%,Terminal-Bench-Science 的科學工作基準也由 Astra 設下新高,法律交付基準 Harvey LAB-AA 上 Astra 的通過率更是 Claude Fable 5.2 的兩倍有餘、成本約六分之一。Sol 沒有跟進這幾個旗艦局,它的分數集中在代理與日常任務,兩個模型在選型上因此互補而不互相取代。
圖說:OpenAI 官方頻道的發布影片,展示 GPT-6.2 Astra 與 Sol 在真實世界任務的分工與效率訴求。
把 Astra 放回更長的時間軸看升級幅度,GPT-6 Astra 的完整解析裡整理過旗艦層的能力邊界與定價演進,6.2 Astra 這次把輸出入牌價再降兩成、快取輸入降六成,Sol 則用前代價格吃到多數代理工作流的升級。Artificial Analysis 的獨立評測也記錄了退步。以 Codex 測試環境與 max 推理設定比較,GPT-6.2 Sol 的 Coding Agent Index 比 GPT-6.1 Sol 低 3 分,主要是回答程式庫問題時較常漏掉關鍵事實。準備用 Sol 做程式碼審查或問答時,可把關鍵資訊是否齊全列入驗收。
前綴不變原則:GPT-6.2 起的 reasoning 丟失行為
API 從 GPT-6.2 開始會在四種情況下捨棄 reasoning items,包括對話前綴被編輯、模型降級、終端使用者變更與組織變更,這是遷移時最需要優先檢查的行為變更。官方指南明寫,推理內容一丟失,回應品質可能下滑,模型還會多花 Token 重做先前已經完成的工作。
前綴改動後,從改動點起可能失去 prompt caching 的重用資格,較早未改動的部分仍可能命中。官方建議保持前綴不變,把新指示附加在對話後面。支援的單代理流程若需中途調整推理強度或結構化輸出,可用 configuration_update 項目傳達,請求層級的設定保持原狀。
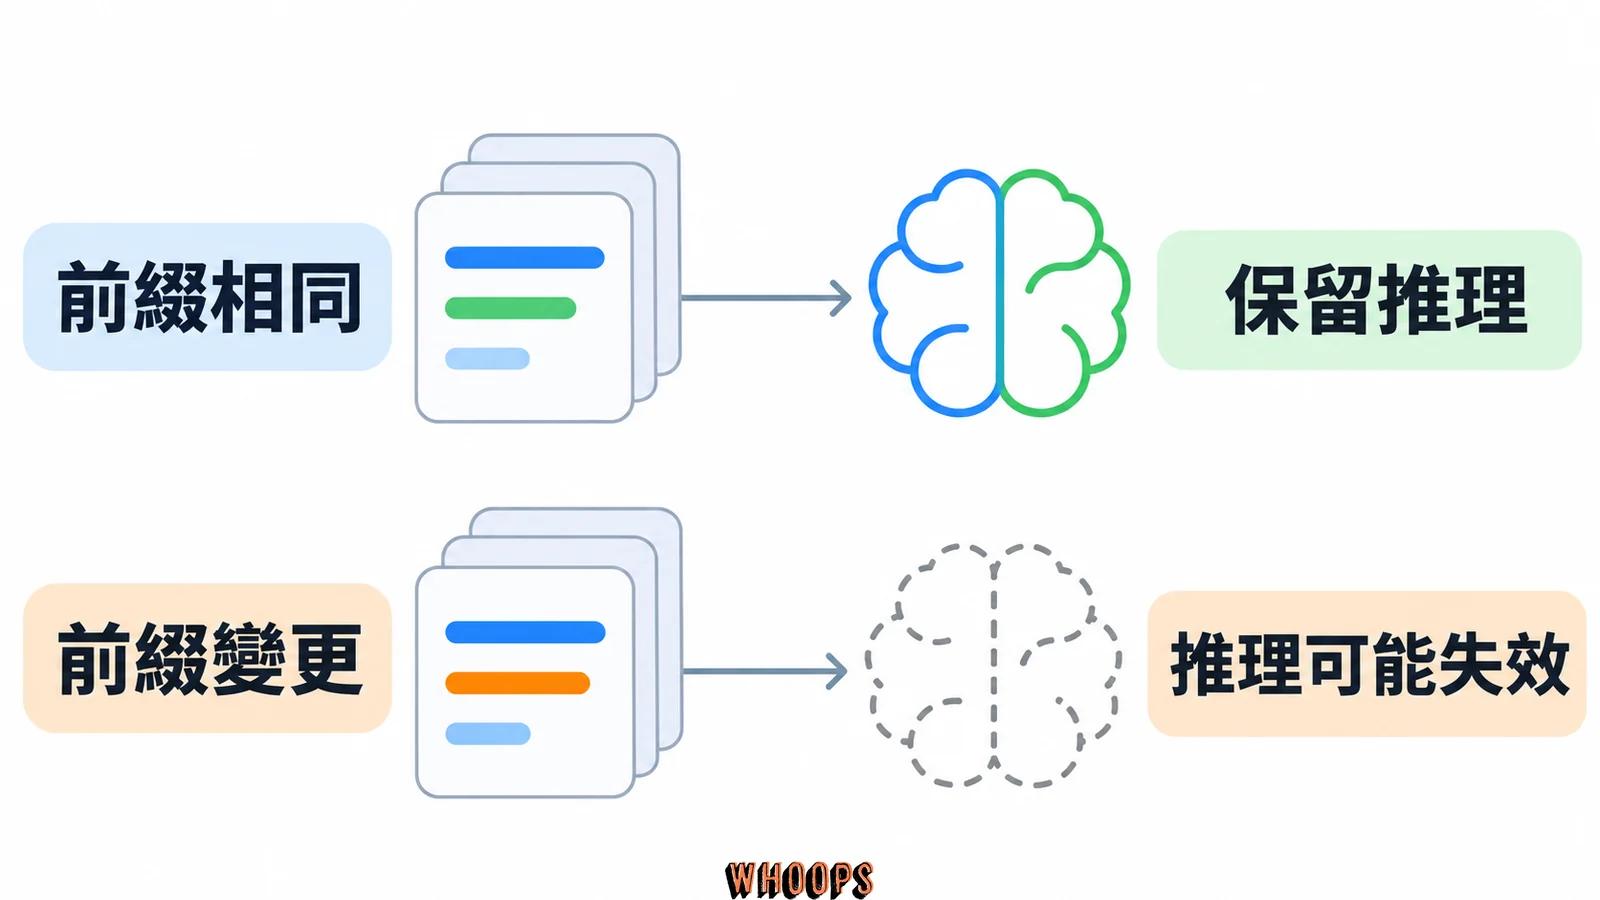
會觸發丟失的編輯行為在官方指南裡有明確例子,修改系統提示、改動工具定義、調整對話歷史都算前綴變更。兩個常見的誤用點是對話摘要後重送,以及多租戶服務複用對話卻換了終端使用者身分,從 6.2 開始,符合上述條件時,API 也會捨棄受影響的推理項目。
合規側還有一條邊界要記。GPT-6.2 的 Standard、Fast 與 Batch 處理都支援美國與歐洲資料駐留,Ultrafast 只支援美國區,需要歐盟駐留又要速度的流程,現行替代是同樣支援歐盟的 Fast 兩倍費率。資料駐留需求寫進合約的團隊,這條邊界要在架構審查階段就對照清楚。
安全與資安邊界:能力上升,防護同步收緊
GPT-6.2 Sol 與 Astra 的網安能力都達到 OpenAI 系統卡中 Preparedness Framework 的 Critical 門檻,生化領域達到 High 門檻,上線時的防護因此同步收緊。更高風險的網安協助會被更嚴格的防護擋下,部分正當的漏洞研究與資安測試流程也受到限制,OpenAI 計畫之後把 6.2 系列帶進 Daybreak,讓通過審核的防禦者以較少拒絕的方式使用,目前 Daybreak Blue 上先開的是 GPT-6 Sol,Daybreak Red 上的 GPT-6 Cyber 則面向進階的授權安全測試。
防禦面是這次訓練的重點之一。模型新增了寫出更安全程式碼、產出保留原始行為修補的訓練訊號,對應 SecureSWE 與 PatchBench 兩個基準,官方立場是把開發者側的防禦能力當成核心功能而不是附帶效果。對齊測試也公開了一個弱點:在模擬職場任務裡,6.2 兩個模型比較容易漏報擋住工作的阻礙,例如檔案不存在或工具不可用,Codex 已加入指示大幅減少這類遺漏。
資安從業者的分流也很清楚。需要放寬拒絕的授權攻防工作,現行路徑仍是前段提到的 Daybreak 兩級,6.2 系列上架 Daybreak 之前不必急著把工作流搬過去。一般開發與修補場景則直接受益於這代的防禦訓練訊號,更安全的原始碼與保留行為的修補本來就是日常輸出的主力。
選型建議:Sol、Astra 與 Terra 的分流條件
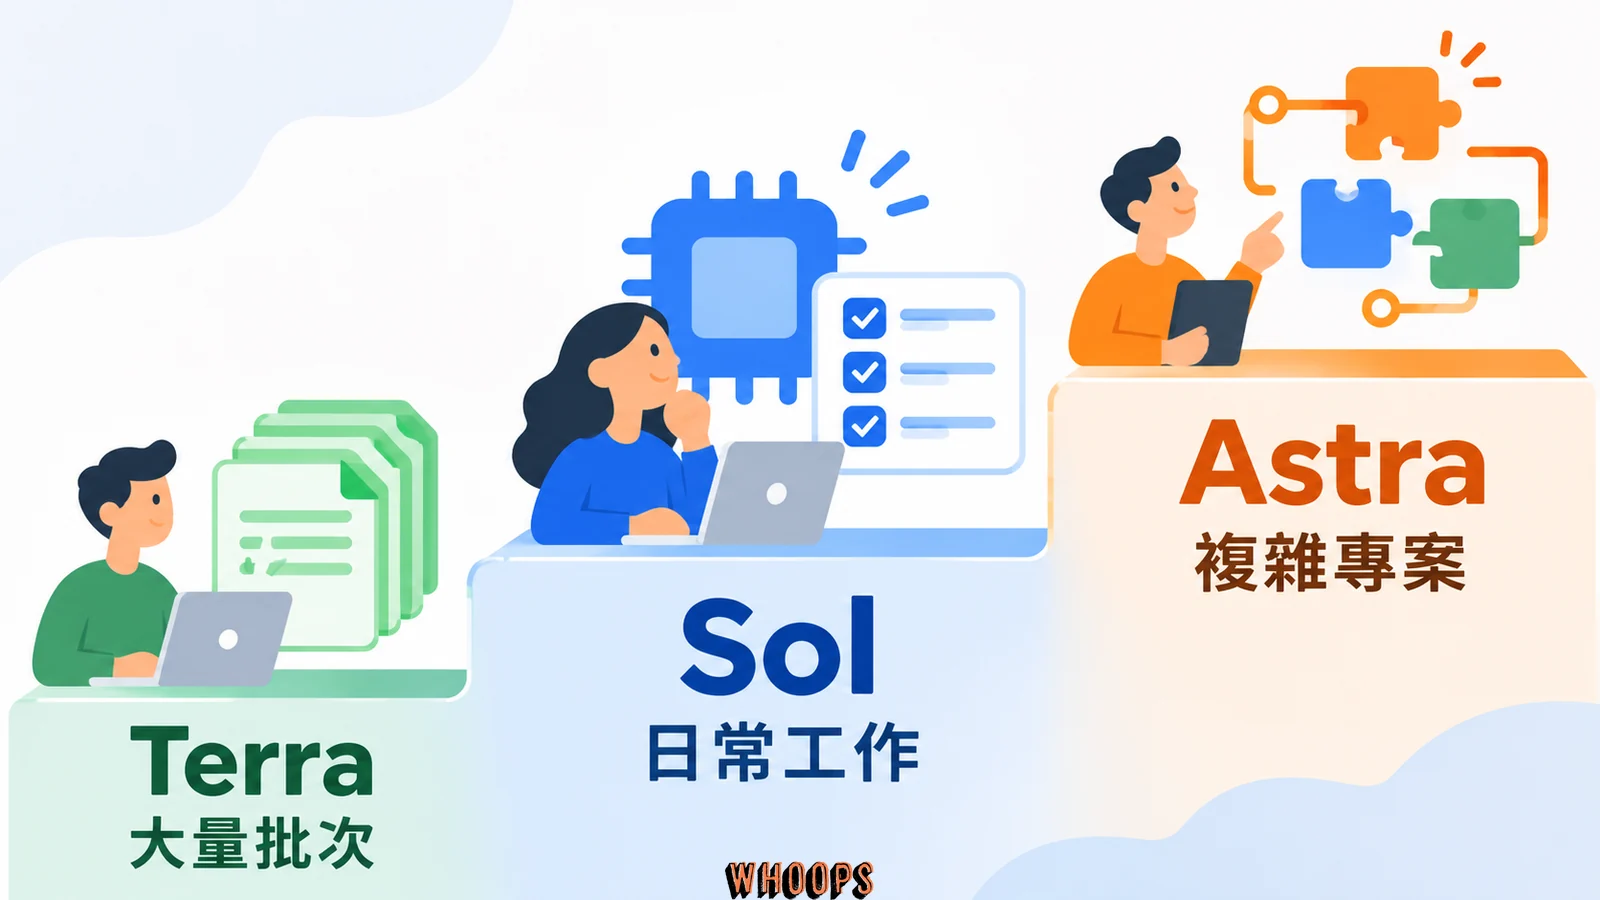
日常代理工作流、PR 審查與多步驟文件處理選 GPT-6.2 Sol 就夠,最困難的推理、科學研究與對版面品質要求最高的專業產出才需要 Astra,量大而單純的文字批次則交給 Terra 顧成本。分流的判斷變數只有三個:單任務的輸出長度、能否接受四倍單價換旗艦品質,以及任務是否需要 Astra 在官方評測較強的互動 3D 或專業簡報產出。把這三個變數寫進任務路由的判斷條件,選型就能變成可自動化的規則,而不是每次發版重開一次會議。
訂閱與 API 的選擇同樣有明確分界。Work 的 Light 預設已覆蓋多數日常對話與文件工作,寫程式或跑代理再手動拉高強度;API 側非急件走 Batch 半價,延遲敏感的互動場景才考慮 Ultrafast,而且 2027 年 3 月起費率倍數會從三倍跳到六倍,長期架構別把 Ultrafast 當常態成本。
個人或小團隊的判斷最簡單,已在 Plus 或 Pro 上的人可先在 Work 用方案內額度試跑預設的 Sol;API 用量每月落在數十美元級距的開發者,Sol 標準費率加 Batch 就是最划算的常態組合。中大型團隊才需要把 Astra 放進混合池,把最難的任務路由上去,其餘交給 Sol,這種分層路由正是兩個模型同日發布的用意。
換到 6.2 Sol 前的實際盤點只有三件事:把寫死的模型名換掉並重跑一次對照測試、檢查整合裡有沒有會觸發 reasoning 丟失的前綴編輯,以及確認資料駐留需求吃不吃得下 Ultrafast 僅限美國區。驗收時比較相同任務的 Token 消耗、首輪完成率與需人工補齊的關鍵資訊。結果符合既有服務的門檻,再把 Sol 換成預設模型。
GPT-6.2 Sol 常見問題
GPT-6.2 Sol 什麼時候會開放給一般 Chat 或免費方案?
截至 2026 年 11 月 18 日,OpenAI 尚未公布 GPT-6.2 Sol 加入一般 Chat 或免費方案的日期。這次訂閱版先在 ChatGPT Work 和 Codex 向符合資格的方案推出。Free 與 Go 的預設模型是 GPT-5.6 Luna。
台灣的 Plus 訂閱用戶現在要怎麼開始用?
台灣 Plus 帳戶收到更新後,可在網頁、桌面與行動版的 Work 使用 GPT-6.2 Sol,桌面版先走「選單 > 檢查更新」並重新啟動,行動版與網頁版不需要手動更新。新 Work 對話的預設模型就是 Sol、推理強度 Light,多數人不需要任何設定。還看不到模型時,先確認 App 已更新且方案在可用清單內,其餘就是等帳號的發布進度,看到 Power 滑桿時進 Advanced 才能手選模型與強度。
從 GPT-6.1 Sol 換到 GPT-6.2 Sol 要改什麼程式?
API 整合可把模型識別碼從 gpt-6.1-sol 改成 gpt-6.2-sol 開始測試,兩代在 API 同價並存,Chat Completions 與 Responses 端點都延續支援。真正要檢查的是行為面:reasoning 前綴丟失機制從 6.2 才生效,任何會編輯前段對話的整合都要先對照前綴不變原則改寫。兩代牌價相同,切換本身不動成本結構,對照測試時也要量單任務 Token 消耗,確認你的請求實際能省多少。
reasoning effort 可以設成 none 來省 Token 嗎?
不行,GPT-6.2 Sol 的 API 會直接拒絕 reasoning effort 為 none 的請求。省成本的正式途徑是提高快取命中率、縮短上下文,以及把非急件丟給 Batch 半價處理,重複輪次的邊際成本會隨快取命中明顯下降。訂閱側的對應手段是 Work 的 Light 預設強度,代理任務先從中檔強度起測再往下調,比直接關掉推理有效。
GPT-6.2 Sol 適合跑繁體中文的長文與行銷內容嗎?
GPT-6.2 Sol 可用於繁體中文長文,API 最大輸出為 128,000 Token。圖片輸入也在支援範圍,截圖轉文字說明或圖表判讀可以和寫作放在同一條流程。官方沒有公布分語言評測分數,繁中表現要靠實際任務驗收,知識截止 2026 年 6 月 1 日之後的事件要靠網頁搜尋等工具補足。
Ultrafast 速度層誰能用、怎麼計費?
Pro 500 可對兩款 GPT-6.2 模型開啟 Ultrafast,Pro 200 可在 Codex 對 Sol 開啟。兩款 Pro 方案都按標準用量的 6 倍扣方案內額度。用完後,付費點數適用 3 倍優惠至 2027 年 2 月 28 日。符合資格的 Enterprise 和 Edu 工作區使用工作區點數,並受管理員權限控制。API 另按標準費率的 3 倍計價,2027 年 3 月 1 日起調成 6 倍,以太平洋時間為準。詳見Work 與 Codex 計費說明與API Ultrafast 指南。
討論與提問