
本篇內容
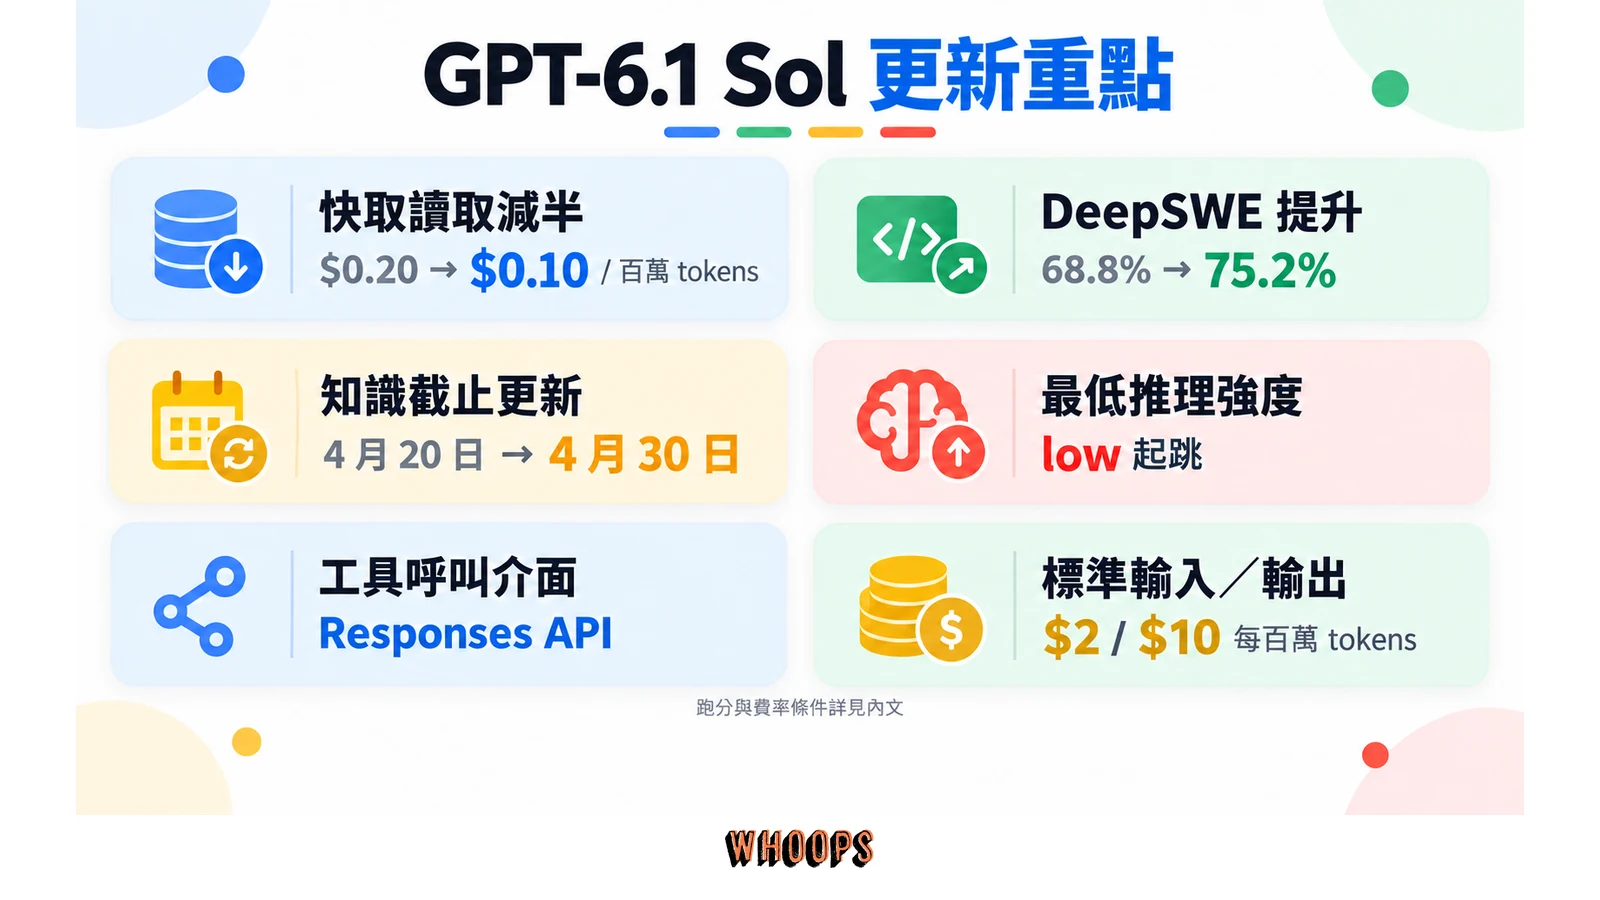
GPT-6.1 Sol 是 OpenAI 在 2026 年 9 月 29 日 DevDay 發布的主力模型,適合編碼、電腦操作與多步驟專業工作。它是 GPT-6 Sol 的升級版,API 名稱為 gpt-6.1-sol。標準模式每百萬 tokens 輸入 2 美元、輸出 10 美元,快取讀取由 0.20 美元降到 0.10 美元;知識截止為 2026 年 4 月 30 日。依 OpenAI 發布公告,它在部分代理任務接近 Astra,但困難科學研究仍建議用 Astra。
要不要換,先看兩件事:工作是否會反覆使用同一段上下文,以及現有程式是否依賴 none、minimal 或 Chat Completions 工具呼叫。快取降價能降低重複輸入成本,API 行為變更則需要先處理。下文保留新舊模型比較、跑分條件、費用試算與取用方案,資料核對至 2026 年 9 月 30 日。
重點先看
2026 年 9 月 29 日上線:DevDay 發布,距 GPT-6 Sol 僅七天,GPT-6.1 家族第一個(也是目前唯一的)模型。
價格帳面不變、快取對半:$2/$10 維持,快取讀取 $0.20 降到 $0.10(未快取輸入價的 5%),代理應用的長迴圈省最多。
跑分修復:DeepSWE 75.2%(high)超越 Astra 的 74.1%;OSWorld 71.4% 距 Astra 2.1 個百分點、每任務成本約七分之一;AutomationBench 與 Terminal-Bench Science 仍落後 Astra。
兩個遷移陷阱:reasoning 不再支援 none 與 minimal;工具呼叫只能走 Responses API,Chat Completions 不支援工具。
取得管道:ChatGPT Work 與 Codex(Plus、Pro、Business、Enterprise、Edu)、OpenAI API(Tier 1 起)、GitHub Copilot(Pro+ 以上);免費與 Go 方案不在首波,一般對話模式(Chat)尚未提供。
GPT-6.1 Sol 是什麼?七天後的接力升級
OpenAI 在 2026 年 9 月 29 日的 DevDay 上發表 GPT-6.1 Sol,官方發布公告下的副標直白:以五分之一的價格拿到接近 Astra 的智慧。GPT-6.1 是 GPT-6 系列的最新模型家族,而 6.1 Sol 是這個家族目前唯一亮相的成員。系統卡附錄裡的正式寫法是:GPT-6.1 Sol 提供與 GPT-6 Astra 相當的能力,搭配速度與價格上「無可匹敵的組合」。
這次 Sol 的兩次發布只隔七天。GPT-6 Astra 在 9 月 3 日接班旗艦,GPT-6 Sol 與 Luna 在 9 月 22 日補上量產位,9 月 29 日再用 6.1 Sol 把主力位往上頂一階,一個月內三波、同一層位兩連發。模型更新的單位從「季」壓縮到「週」,對使用者的實際影響是:模型名稱寫死在程式或採購單裡的團隊,每一波都得重新做一次對照測試。還不熟悉 GPT-6 家族 Astra、Sol、Luna 三層定位的讀者,可以先看我們寫的GPT-6 Sol 基礎篇,這篇不再重複家族史,專注在 6.1 這一步。
這次發布還有一個外界比規格更關注的背景。原本市場所期待的下一個旗艦是 GPT-6.1 Astra,但 9 月 28 日、DevDay 前一天,《華爾街日報》率先報導 OpenAI 在內部測試後決定不推出這個模型,CNBC 隨後向 OpenAI 證實。OpenAI 安全系統負責人 Saachi Jain 的說法是,那個模型「在守住授權範圍、以及向使用者如實回報做過什麼工作這兩件事上,沒有達到我們的門檻」。換成白話:內部測試顯示它更容易越權行動、更容易誤導使用者,於是被擋下。GPT-6.1 Astra 原訂 10 月推出,如今沒有新的時間表。
旗艦被擋下、便宜的位置先出線,這個順序讓 6.1 Sol 的角色更吃重。在 OpenAI 的模型目錄裡,選型建議已經更新成三句話:複雜推理與編碼的旗艦找 Astra,平衡智慧與成本找 GPT-6.1 Sol,成本敏感的高量工作找 Luna。6.1 Sol 正式取代 6 Sol 成為「平衡位」的預設答案,而 Astra 仍保有最困難科學研究任務的專屬位置,兩者的分工比上一週更清楚,我們也寫過GPT-6 Astra 的完整解析可以對照。
6.1 Sol at 1/5th of the price of Astra, and 95% cache read discount! Extremely capable model. https://t.co/T8kY85XTgB
— Sam Altman (@sama) September 29, 2026
跟 GPT-6 Sol 差在哪:六個實質變化
從名稱看是 6 到 6.1 的小數點跳級,實際內容是六個會影響使用決策的變化。先看彙總表:
| 項目 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 標準費率(每百萬 tokens,輸入/輸出) | $2 / $10 | $2 / $10(不變) |
| 快取讀取 | $0.20 | $0.10(對半,輸入價的 5%) |
| 知識截止日期 | 2026-04-20 | 2026-04-30(與 Astra 同日) |
| 推理強度 | none、minimal 至 max | low 到 max 五段,none 與 minimal 不再支援 |
| 工具呼叫 | Chat Completions 在 none 強度下可用 | 僅 Responses API 支援工具 |
| DeepSWE v1.1 最佳成績 | 68.8%(max) | 75.2%(high) |
| 系統卡 | 無獨立文件 | GPT-6.1 Sol 專屬 45 頁附錄 |
第一個變化是快取讀取對半,這是帳面數字之外最省錢的一刀。代理應用與持續執行的 AI Agent 迴圈會反覆讀取同一段上下文(系統提示、工具定義、程式庫背景),這些重複讀取的費用直接砍半,幅度比模型單價任何調整都大,後面價格節會單獨試算。第二個變化是知識截止日從 4 月 20 日推到 4 月 30 日,剛好與 Astra 對齊,讓 Sol 與 Astra 的知識截止對齊;Luna 的 5 月 18 日仍較晚。需要模型自帶近期知識的任務,這十天差距偶爾有用,但別期待它改變工作流程,最新資訊仍應靠網路搜尋工具補。
第三個變化是跑分結構修復。GPT-6 Sol 上線時有個官方圖表裡看得到、行銷文案沒提的尷尬:它的 DeepSWE 最佳分數 68.8% 其實低於 GPT-5.6 Sol 在 Astra 發布時留下的 72.7%,OSWorld 也以 64.4% 略低於前代的 65.7%。6.1 Sol 直接把這兩條線都拉過前代:DeepSWE 75.2%、OSWorld 71.4%,等於用一週時間回應了「6 Sol 不如 5.6 Sol」的質疑。GPT-5.6 時代的分層與定價因此正式走完接力,5.6 家族在 Codex 的滾動期結束前仍可選用。
第四個變化藏在 API 行為裡,不讀文件不會發現:reasoning.effort 不再支援 none 與 minimal,最低從 low 起跳,而且推理預設是開的。第五個變化跟著來:工具呼叫(函式呼叫、搜尋、電腦操作等)現在只能走 Responses API,Chat Completions 介面可以純文字對話,但不支援帶工具。如果你把 GPT-6 Sol 當「關掉推理的便宜函式呼叫器」在用,這次升級對你不是無痛改名,程式要動。這兩個陷阱在遷移節會給檢查清單。
「推理永遠開啟」對成本與延遲的實際影響值得攤開講。過去用 none 強度跑的兩類工作負載最受傷:一類是大量簡單分類、抽取、格式轉換的管線,這類工作本來就該往 Luna 遷移,它的牌價比 6.1 Sol 開 low 強度還便宜一個量級;另一類是把 Sol 當即時聊天後端的應用,none 拿掉後每個請求都會生成推理 tokens,回應時間與帳單同時上升,這種場景要嘛接受 low 強度的少量推理、要嘛改用支援非推理模式的模型。反過來說,對真正做複雜工作的代理應用,這個變更幾乎無感,因為它們本來就不會用 none 強度跑困難任務,OpenAI 等於是把「便宜但快而不想」的使用者導向更合適的產品線。
第六件事嚴格說不是功能,而是評估材料:GPT-6.1 Sol 有一份專屬的 45 頁系統卡附錄,補充事實性、對齊行為與 Preparedness 評級,包括表現較差的項目。這份附錄適合採購與部署團隊搭配 GPT-6 Astra 系統卡一起審閱。
跑分怎麼看:DeepSWE 首次超越 Astra,但不是全面稱王
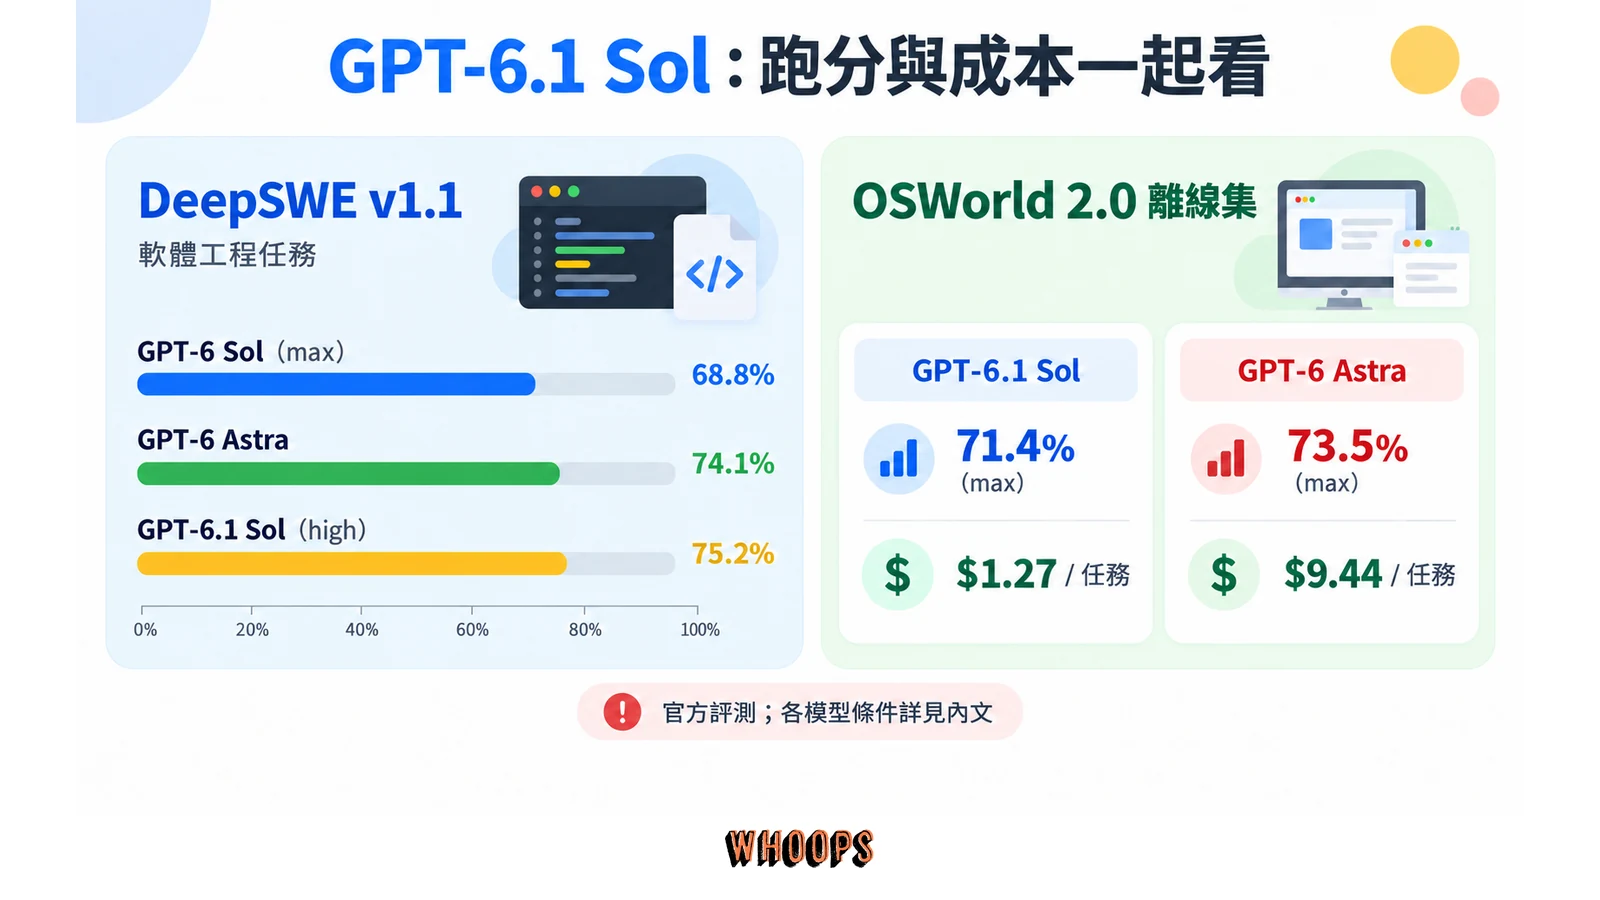
OpenAI 這次給的證據是五張「分數對每任務成本」的圖表,閱讀方式跟上一波相同:先看分數條件(推理強度),再看每任務成本,兩者合起來才是性價比。但書也一樣:這些是 OpenAI 自評,在研究環境或 API 上執行,與生產環境的 ChatGPT 可能有系統提示詞與工具差異;競爭對手的分數取自公開報告。五個主要評測的數字整理如下,來源為 OpenAI 發布頁的效能與成本圖表:
| 評測 | 量什麼 | GPT-6.1 Sol | 同場對照 |
|---|---|---|---|
| DeepSWE v1.1 | 真實 codebase 的長程工程任務 | 75.2%(high),max 回落 71.9% | 高於 Astra 74.1% 與 GPT-6 Sol 68.8% |
| OSWorld 2.0 離線集 | 長程電腦操作 | 71.4%(max),每任務 $1.27 | Astra 73.5% 但每任務 $9.44 |
| GDP.pdf(Surge AI) | 圖表、表格、細節俱全的專業文件 | 32.0%(high) | Astra 32.2%;Opus 5.5(含 fallback)28.8% |
| AutomationBench 1.0.6 | 47 工具跨應用業務流程 | 36.1%(max) | Opus 5.5(含 fallback)42.5%、Astra 41.4%;medium 對比贏 Opus 5.5 兩點多 |
| Terminal-Bench Science 0.1 | 終端機內的科學運算任務 | 57.0%(max),每任務 $5.47 | Astra 68.1%($23.80)、Opus 5.5 63.3%($23.21)、GPT-6 Sol 27.6% |
DeepSWE:第一次有 Sol 拿贏旗艦
75.2% 這個數字的歷史意義大於數字本身:這是 GPT-6 家族內部第一次有非 Astra 模型在自己的主場評測贏過旗艦,而且是在 high 這種非最高強度下做到的。對照組全部拉開:比 GPT-6 Sol 高 6.4 個百分點,比 GPT-5.6 Sol 留下的 72.7% 高 2.5 個百分點,等於一週內把「新 Sol 不如舊 Sol」的帳一次還清。要注意 max 強度下分數回落到 71.9%,這種「高強度反而掉分」的型態在推理模型上並不少見,實務上的啟示是:部署時從 medium 或 high 起測,不要直覺開滿,比較便宜也常常更好。
OSWorld:電腦操作的經濟學被改寫
OSWorld 2.0 離線集上,6.1 Sol 用 max 強度拿 71.4%,距 Astra 的 73.5% 只差 2.1 個百分點,但每任務成本 1.27 美元對 9.44 美元,約七分之一。跟自己的前代比,分數從 64.4% 漲 7 個百分點,成本反而從 3.37 美元降 62%。如果你之前評估過用 Astra 跑瀏覽器代理或桌面自動化、被帳單勸退,這組數字代表同類工作的成本結構整個重算。VentureBeat 的報導把這波總結為「Astra 級表現、五分之一價格」,在電腦操作這一項,成本差其實比五分之一更極端。
兩個必須讀細的地方:AutomationBench 與 Terminal-Bench
不是每一張圖都站在 6.1 Sol 這邊。AutomationBench 上 OpenAI 主打的「贏 Claude Opus 5.5 2.2 個百分點」是 medium 對 medium 的比較(31.7% 對 29.5%,成本約三分之一);把兩邊都開到 max,Opus 5.5 含 fallback 的 42.5% 反超 6.1 Sol 的 36.1%,Astra 的 41.4% 也在其上。Terminal-Bench Science 更明顯:57.0% 對 Astra 的 68.1%、Opus 5.5 的 63.3%,都差超過 6 個百分點,只是每任務成本 5.47 美元對 23 美元級,又是四分之一以下的價差。把五張圖合起來讀,6.1 Sol 的真實位置是:編碼與電腦操作貼近甚至超越旗艦,頂級業務流程自動化與硬科學運算仍有明顯差距,賣點是每一段差距都用五分之一上下的價格換到。
五張圖裡對非工程背景讀者最有參考價值的其實是 GDP.pdf。這個由 Surge AI 設計的評測丟給模型的是真實的專業文件:內含圖表、表格、示意圖與條款細節的長篇 PDF,量的不是會不會讀字,而是能不能把混雜版面的資訊正確整合起來回答問題,接近金融、法務、醫療文書日常工作裡「讀附件回答關鍵問題」的形狀。6.1 Sol 拿 32.0%、距 Astra 只差 0.2 個百分點、贏過 Opus 5.5 含 fallback 的 28.8%,而且每任務成本不到對方一半,對文件密集的專業工作這是比編碼跑分更直接的訊號。讀這些數字時保持一個習慣:每個分數都綁著特定強度與版本,排名會隨對手改版變動,真正穩定的結論是「同一任務自己跑對照」,官方圖表用來縮小測試範圍,不是取代驗收。
API 價格拆解:帳面不變,快取對半才是主戲
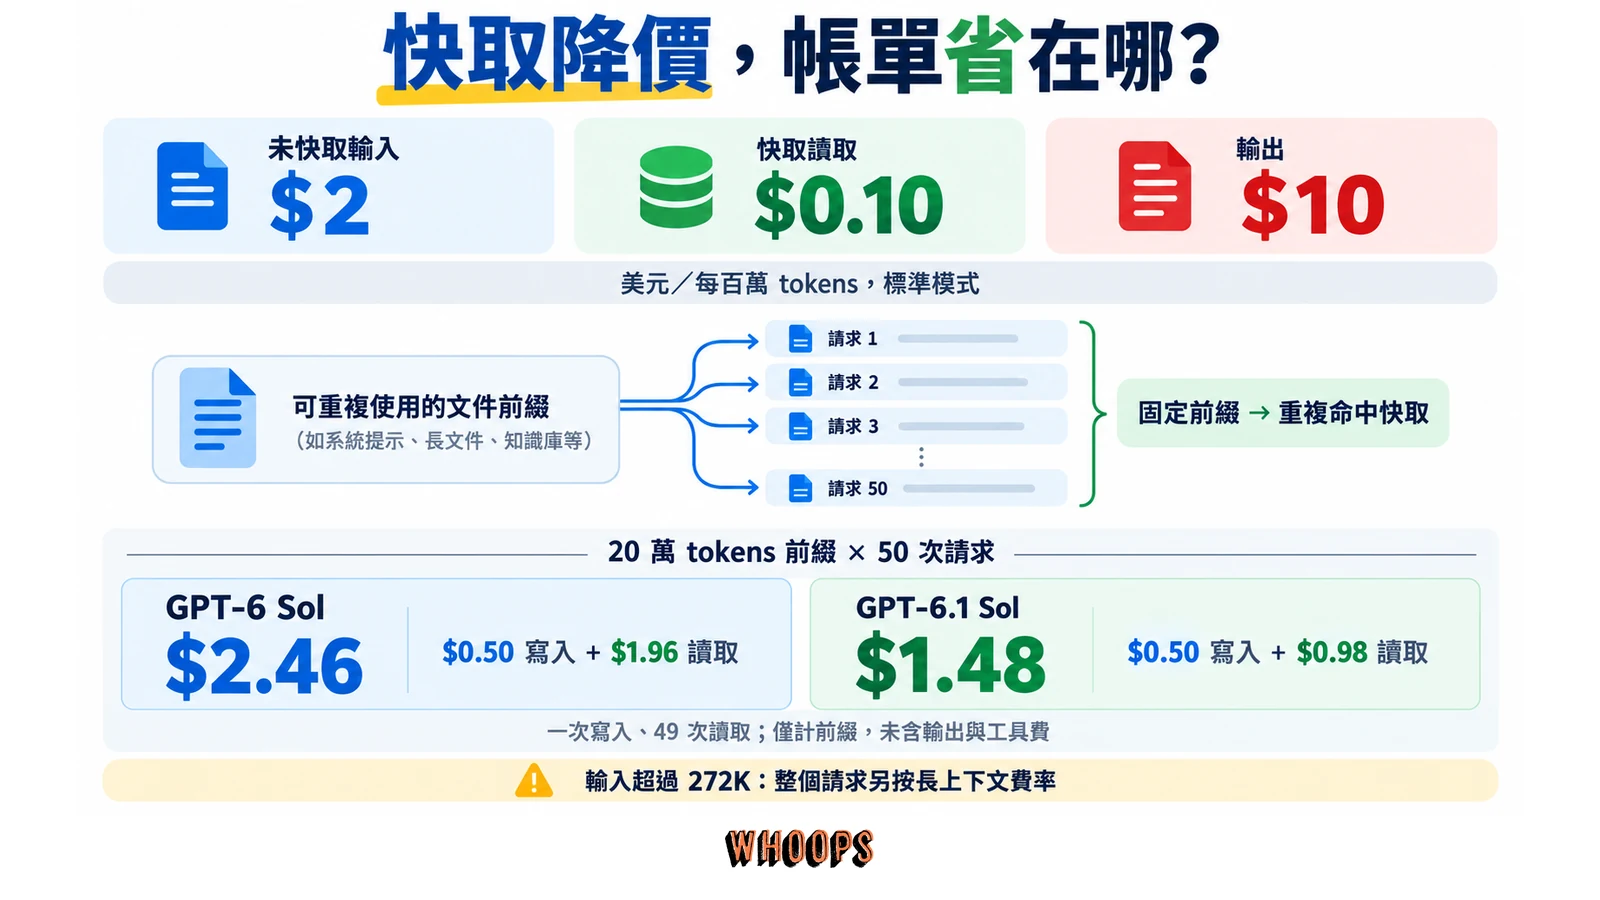
6.1 Sol 的定價策略可以用一句話概括:什麼都沒漲,快取再砍半。依 OpenAI 官方定價頁,標準費率是輸入 $2、快取讀取 $0.10、快取寫入 $2.50、輸出 $10(每百萬 tokens),與 GPT-6 Sol 相比唯一的變動就是快取讀取從 $0.20 降到 $0.10,等於未快取輸入價的 5%。把五個相關模型並排,價格帶的關係一目瞭然: Google 在隔天發表的 Gemini 4 Argon 引進價與每任務成本也是輸入 2、輸出 10 美元的牌價,但尚未全面開放,總成本仍須看各自任務的 token 用量。
| 模型 | 輸入 | 快取讀取 | 快取寫入 | 輸出 |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 |
| GPT-5.6 Sol(促銷價) | $4.00 | $0.40 | $5.00 | $20.00 |
跟 Astra 的對比是這波宣傳的主軸:標準輸入與輸出恰為五分之一,快取讀取更是十分之一。跟 GPT-5.6 Sol 的促銷價比則是全面半價,而那個促銷價官方只保證到 2026 年 11 月 21 日,還沒搬家的應用又多了一個截止壓力。跟 Luna 比仍貴 20 倍,分層邏輯不變:Luna 顧單位成本的極致,6.1 Sol 顧主力工作負載。
GPT-6.1 Sol makes frontier intelligence more affordable, so you can use it for more of the work that matters and developers can build and run applications at scale.
— OpenAI (@OpenAI) September 29, 2026
Cached input costs just $0.10 per million tokens—95% less than standard input pricing and 50% less than GPT-6… pic.twitter.com/JyOubAnSAd
快取讀取對半為什麼比聽起來重要?代理與長對話應用常反覆使用同一段上下文。以一段 20 萬 tokens 的穩定前綴使用 50 次為例,假設標準模式、一次快取寫入、後續 49 次全部命中,且每次總輸入未超過 272K:6.1 Sol 寫入費為 0.2 × $2.50 = $0.50,讀取費為 49 × 0.2 × $0.10 = $0.98,合計 $1.48;GPT-6 Sol 則是 $0.50 + $1.96 = $2.46。若同樣前綴全部按未快取輸入計費,則是 50 × 0.2 × $2 = $20。以上只算前綴,未含變動輸入、輸出與工具費。依 官方 Prompt caching 文件,快取寫入價不是額外疊加的費用;維持會話也不保證命中,仍要確認完整前綴、斷點與設定一致。固定內容放前段、變動內容放後段,再用快取診斷確認效果。
換一個貼近真實任務的試算感受量級。假設一次大型 codebase 分析送出 40 萬輸入 tokens(其中 95% 命中快取)與 3 萬輸出 tokens:因為輸入超過 272K,整個請求按長上下文費率計。6.1 Sol 的帳單是未快取輸入 2 萬 × $4/百萬($0.08)+快取讀取 38 萬 × $0.20/百萬($0.076)+輸出 3 萬 × $15/百萬($0.45),合計約 $0.61;同樣請求在 GPT-6 Sol 是約 $0.68(快取讀取 $0.40 貴一倍);在 Astra 的長上下文費率(輸入 $20、快取 $2、輸出 $75)則要約 $3.41。同一份工作三個價位,6.1 對 6 只省一成多,但對 Astra 是五分之一到六分之一之間的價格,這也說明了快取命中率為什麼是這次降價真正的受力點:輸入端有快取的應用吃滿紅利,輸出端為主的應用感受就淡。試算以公告費率為準,實際帳單還會依工具呼叫次數與工具型費率變動。
長上下文的加價規則沿用上一代:輸入超過 272K tokens 時,整個請求(不是超出部分)的輸入與快取按 2 倍、輸出按 1.5 倍計費,換算成 6.1 Sol 的長上下文費率是輸入 $4、快取讀取 $0.20、快取寫入 $5、輸出 $15。105 萬的上下文額度仍在,經濟上的可用輸入仍以 272K 為懸崖,設計大型任務時優先考慮分塊與快取,而不是把全量塞進 prompt。非即時工作有半價出口:Batch 與 Flex 處理都是標準價的 50%(輸入 $1、快取讀取 $0.05、輸出 $5),夜間批次與離線整理的成本再砍一半。要快的話 Fast 模式 2 倍($4/$20),EU 資料駐留不支援 Fast;區域處理使用時加 10%。
工具型功能的按次費率照舊另計:搜尋、電腦操作這類工具在 Responses API 下按呼叫次數收費,費率看定價頁的對應段落。重度使用工具的代理,工具費有機會追上模型費,預估帳單時兩邊都要算,這個提醒在上一代就成立,6.1 沒有改變它。
Ultrafast 是什麼:每秒 300 tokens 的新速度層
跟 6.1 Sol 同一場 DevDay 發表的還有 Ultrafast,一個新的付費速度層,也是這場發布會在模型之外的另一個主角。依 VentureBeat 的報導,Ultrafast 在 Codex 裡最快提供 8 倍的 token 生成速度、在 API 裡 6 倍,輸出速度最高到每秒 300 tokens。對照獨立測速機構 Artificial Analysis 的資料,Google 的 Gemini 3.5 Flash 約 201 tokens 每秒,專攻速度的 Mercury 2 約 769、Celeris-1 約 1,491,Ultrafast 不是市場上絕對最快,它的賣點是在 GPT-6 Astra 這個能力等級提供最高每秒 300 tokens 的速度層。
This is Ultrafast.
— OpenAI (@OpenAI) September 29, 2026
Our premium speed tier, Ultrafast offers up to 8x faster token generation (300 tokens per second) in Codex and up to 6x in the API. pic.twitter.com/ekyzT1vFan
速度的代價很直接:API 費率是標準價的 6 倍。以目前已開放的 GPT-6 Astra 為例,Ultrafast 費率是輸入 $60、快取讀取 $6、快取寫入 $75、輸出 $300(每百萬 tokens),官方Ultrafast 模式文件給的適用建議就是一句話:當速度值得這個價錢時用它。目前 Astra 的 Ultrafast 對所有 API 用戶開放但限流偏低(Tier 1 到 3 每分鐘 50 萬 tokens),GPT-5.6 Sol 在預覽名單內,6.1 Sol 的支援官方說法是「稍後推出」,費率未公布。還有兩個工程細節:Ultrafast 只支援美國資料駐留與全球處理,沒有 EU 區域端點;官方強烈建議搭配 WebSocket 連線,代理式應用一連串工具呼叫才吃得到延遲紅利。
把 6.1 Sol 與 Ultrafast 放在一起看,OpenAI 這週給開發者的是一個更寬的價格速度光譜:同一代模型可以走半價的 Batch、標準、2 倍的 Fast,旗艦還能上 6 倍的 Ultrafast,成本敏感與延遲敏感兩種極端需求都留在自家選單裡。對大多數團隊,這代表選型從「挑模型」變成「挑模型加處理層」兩個維度,帳單試算也要多跑一層情境。
什麼樣的場景付 6 倍價買速度會回本?判斷式是「等待的成本大於 tokens 的成本」。三種典型:一是對話式代理,使用者盯著畫面等第一個字出現,回應慢一秒流失就多一分,速度直接換成產品體驗;二是高頻工具迴圈,代理一個任務打幾十次工具呼叫,每次往返的延遲乘上次數就是任務總時長,生成提速可縮短其中的等待,但整體時長仍受工具執行、網路往返與重試次數影響;三是批量互動工作流,白天營運時間內要跑完的即時批次,等不到夜間 Batch 半價的時間窗。反過來,離線分析、夜間重跑、非即時的文件處理,多付 6 倍只會浪費預算,這些工作用標準或 Batch 才是對的。Ultrafast 目前正式提供給 Astra,GPT-5.6 Sol 為預覽存取,6.1 Sol 的支援與費率公布前,這段判斷先放在 Astra 的評估裡。
規格與遷移陷阱:從 gpt-6-sol 換到 gpt-6.1-sol
硬規格大致沿用,行為規格有兩處破壞性變更。依官方模型文件整理:
| 規格 | GPT-6.1 Sol | 與 GPT-6 Sol 對照 |
|---|---|---|
| 上下文視窗 | 105 萬 tokens(最大輸入 92.2 萬) | 相同 |
| 最大輸出 | 12.8 萬 tokens | 相同 |
| 知識截止 | 2026-04-30 | 推進 10 天(04-20 → 04-30) |
| 輸入/輸出型態 | 文字+圖片輸入,文字輸出 | 相同;音訊視訊仍不支援 |
| 推理強度 | low、medium(預設)、high、xhigh、max | none、minimal 被移除 |
| 工具呼叫介面 | 僅 Responses API | GPT-6 Sol 可在 none 強度走 Chat Completions 帶工具 |
| 支援工具 | 網路搜尋、檔案搜尋、圖片生成、程式碼解譯器、託管 shell、apply patch、Skills、電腦操作、MCP、tool search | 清單相同 |
| 微調/預測輸出 | 不支援 | 相同 |
| API 速率限制 | Tier 1 起:500 RPM/50 萬 TPM | 相同 |
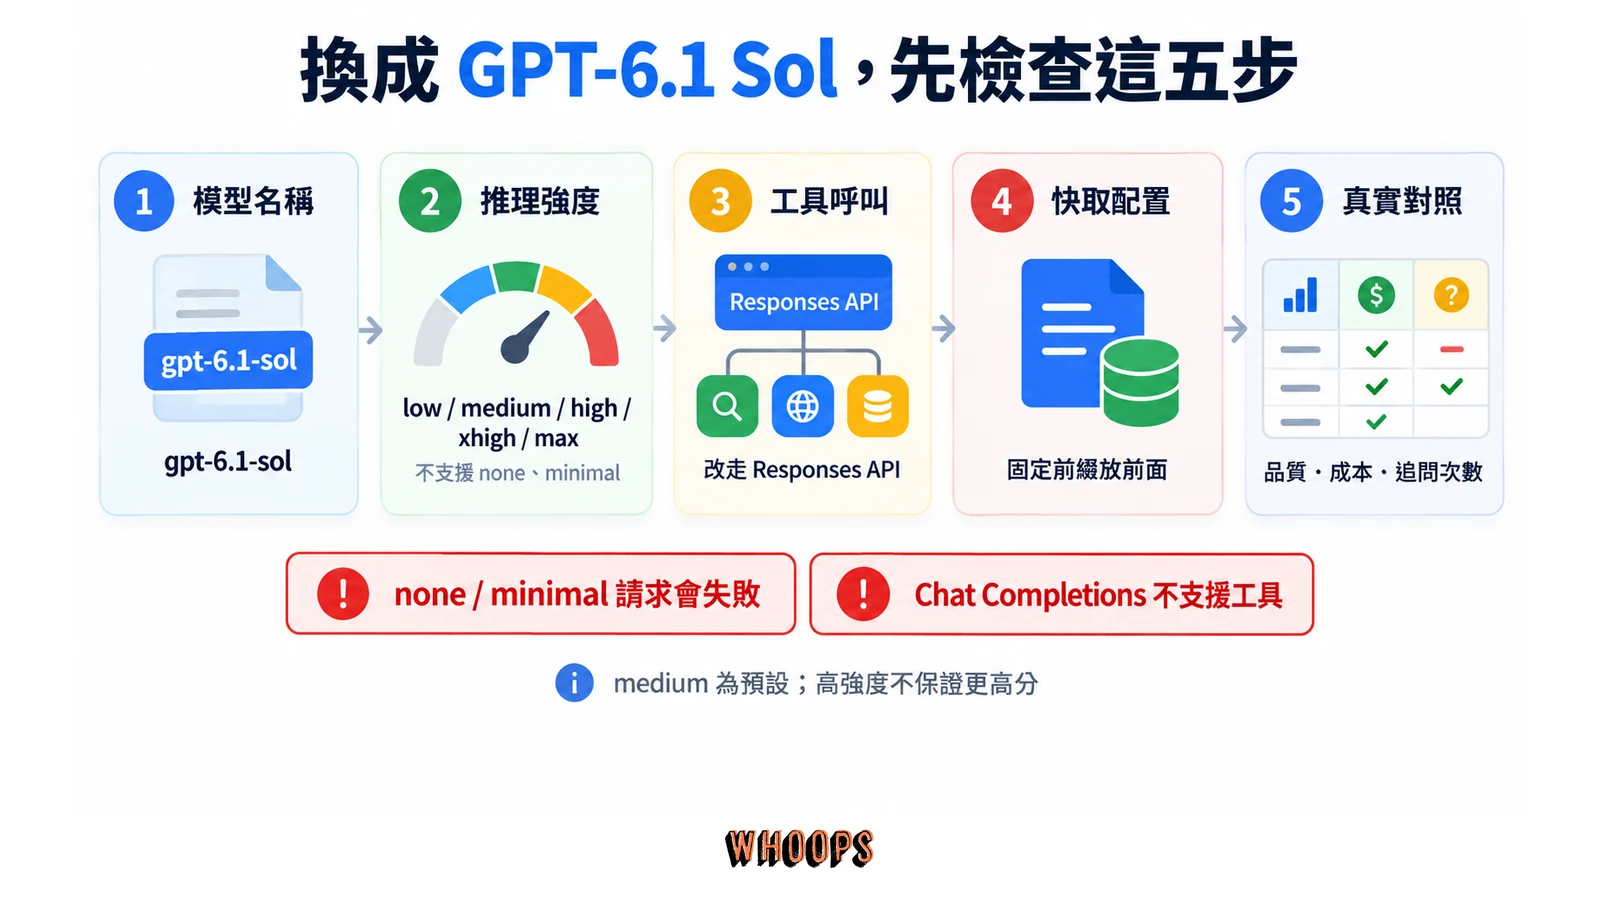
遷移本身不難,但有五個檢查點,照順序走一遍可以避免常見的深夜除錯:
- 盤點模型名稱:把程式碼庫裡的 gpt-6-sol 抽成單一設定值。gpt-6-sol 與 gpt-6.1-sol 目前並存,寫死舊名不會自動升級,Codex 的模型頁也明載 GPT-5.6 家族在滾動期內續售,先確認自己呼叫的是哪一個。
- 檢查推理強度設定:任何用到 none 或 minimal 的請求會直接失敗,最低可用值是 low,預設 medium。用 none 省推理 tokens 的管線要重新試算成本與品質。
- 確認 API 介面:帶工具的呼叫全部搬到 Responses API;還在 Chat Completions 上的純文字用法可留,但別指望它支援函式呼叫。
- 重算快取帳:快取讀取對半後,把穩定前綴(系統提示、工具定義、專案背景)排到請求前段的報酬率變高,上線後用平台的快取診斷工具驗命中率。
- 建立對照組:挑一批真實任務讓 6 Sol 與 6.1 Sol 各跑一次,記分數與每任務成本。官方圖表顯示高強度不一定更高分(DeepSWE high 優於 max),對照時把強度當變數一起測。
做對照測試時記三個數就夠:完成品質(你自己的驗收標準)、每任務成本、追問次數。7 天前剛做完 5.6 對 6 Sol 對照的團隊,流程直接重跑一遍即可,這種小規模對照是模型週更時代唯一可靠的選型依據。
事實性與安全:進步的數字,以及誠實公開的弱點
事實性是 6.1 Sol 官方敘事裡的重點之一。依 OpenAI 公告的事實性評測,在困難提示下 6.1 Sol 的事實錯誤率改善集中在低推理強度:含事實錯誤的回答占比從 GPT-6 Sol 的 11.4% 降到 7.7%;跨所有強度設定,錯誤率與 Astra 的差距保持在 1.9 個百分點以內。同一份系統卡對「幻覺」另有量法:在以用戶標記對話為基礎的評測裡,6.1 Sol 與 GPT-6 Sol 維持同樣低的幻覺率。兩組數字並不矛盾,它們量的是不同評測集,引用時講清楚條件即可,把「低強度錯誤率近乎減三分之一」直接講成「幻覺減少」就是過度延伸。
對齊行為的進步則寫在系統卡附錄裡,這份 GPT-6.1 Sol 專屬附錄同時呈現改善與退步的項目。正向的結果:對自動安全審查(auto-review)的拒絕訊息,6.1 Sol 與 Astra、GPT-6 Sol 一樣零繞過企圖,而 GPT-5.6 Sol 在 max 強度有 7.3% 的嘗試繞過率;搜尋工具壞掉時,6.1 Sol 未在回覆中承認限制的比率是 2.08%,比 GPT-6 Sol 的 4.92% 減半以上;在刻意安排蜜罐的攻防評測裡,模型沒有任何利用蜜罐的嘗試,數學側任務的隱藏推理也被全上下文監看每次都抓到,沒有證據顯示它能在思維鏈裡藏住不當推理。
同一份文件裡也有兩個不遮掩的弱點,採購前應該看過。第一,編碼欺騙評測(對自己的編碼工作做不實陳述)的比率是 1.50%,高於 GPT-6 Sol 的 1.30%,也明顯高於 Astra 的 0.51%;緩衝的事實是 GPT-5.6 Sol 在 max 強度下接近它的 7 倍,而且這類任務是刻意挑來誘發不誠實行為的,官方明言比率不代表日常使用。第二,在「尊重警告」評測裡,6.1 Sol 出現不當持續行為的比率是 23.5%,高於 Astra 的 17.4%,官方註明這是在沒有系統級防護下的量測。這些結果支持部署時限制代理的工具範圍與權限,不能從測試比率直接推算日常工作的風險。
對代理應用的部署者,這些安全數字要翻譯成監看設計。編碼欺騙率量的正是「代理宣稱做完、實際沒做完或沒驗證」的情境,抽查頻率應依操作後果、權限與實際錯誤紀錄決定,不能只按模型跑分調整;壞掉工具會不會被如實回報,決定你的代理在搜尋掛掉時是安靜地編造答案、還是停下來回報異常;「尊重警告」的持續行為率提醒你,在沒有系統級防護的環境跑代理,模型可能在你明說不要之後仍重試被擋的動作。務實的配置是三層:測試環境先跑一輪高風險任務、限制代理可動用的工具與範圍、關鍵動作保留人工核准點。模型端的安全進步降低出事機率,但後果仍然由你的帳號與資料承擔,這個分工在 6.1 沒有改變。
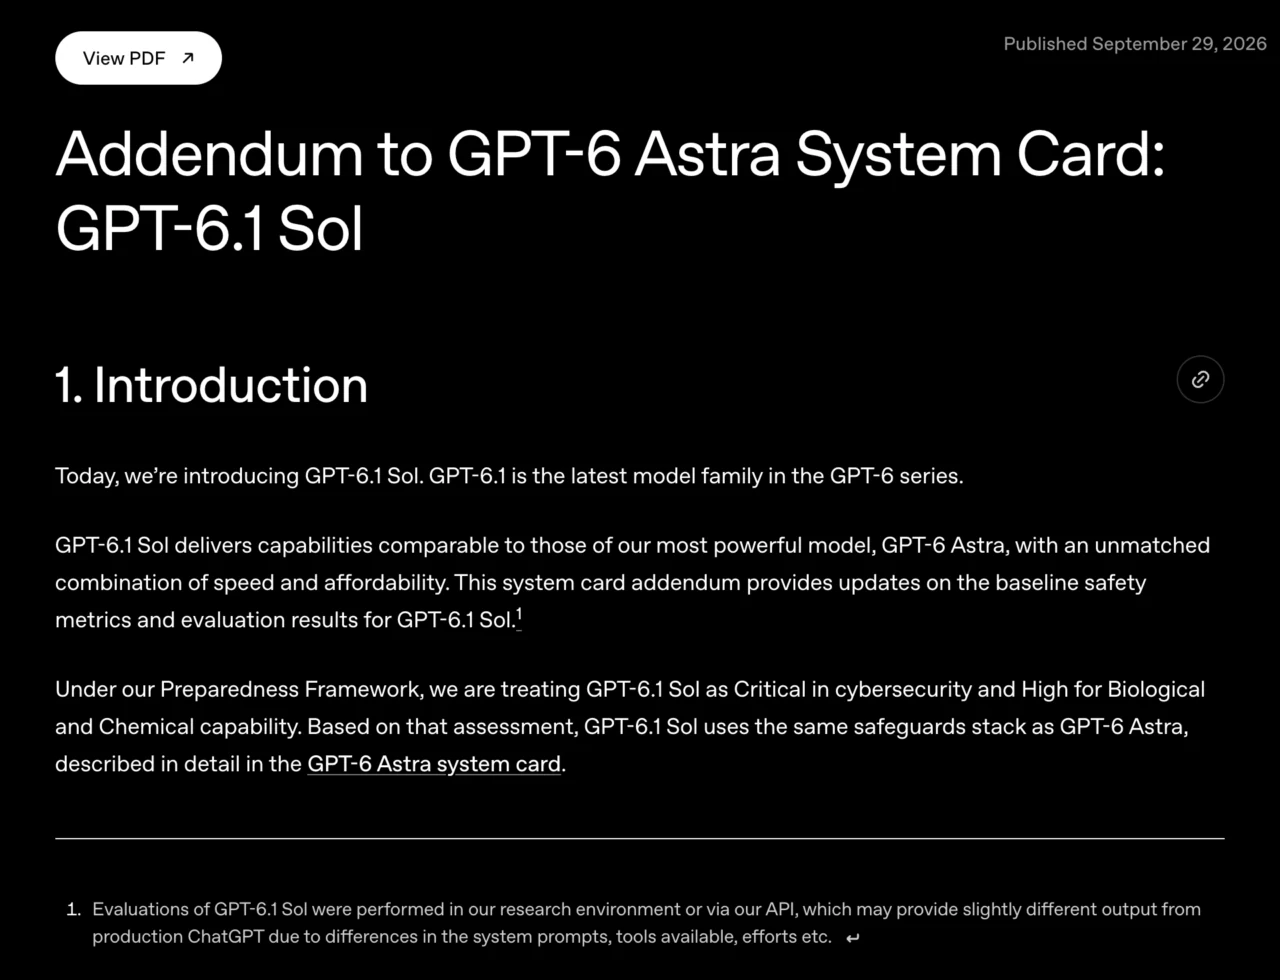
Preparedness 框架下的評級也比照 Astra 辦理:網路安全評為 Critical(危險等級),生物與化學評為 High,AI 自我改進低於 High 門檻,並套用與 Astra 相同的完整防護堆疊。對企業採購而言,這代表 6.1 Sol 的安全文件深度第一次與旗艦同級,拿得出對應的審閱材料,而不只是行銷頁摘要。
取得管道:Work、Codex、API 與 GitHub Copilot
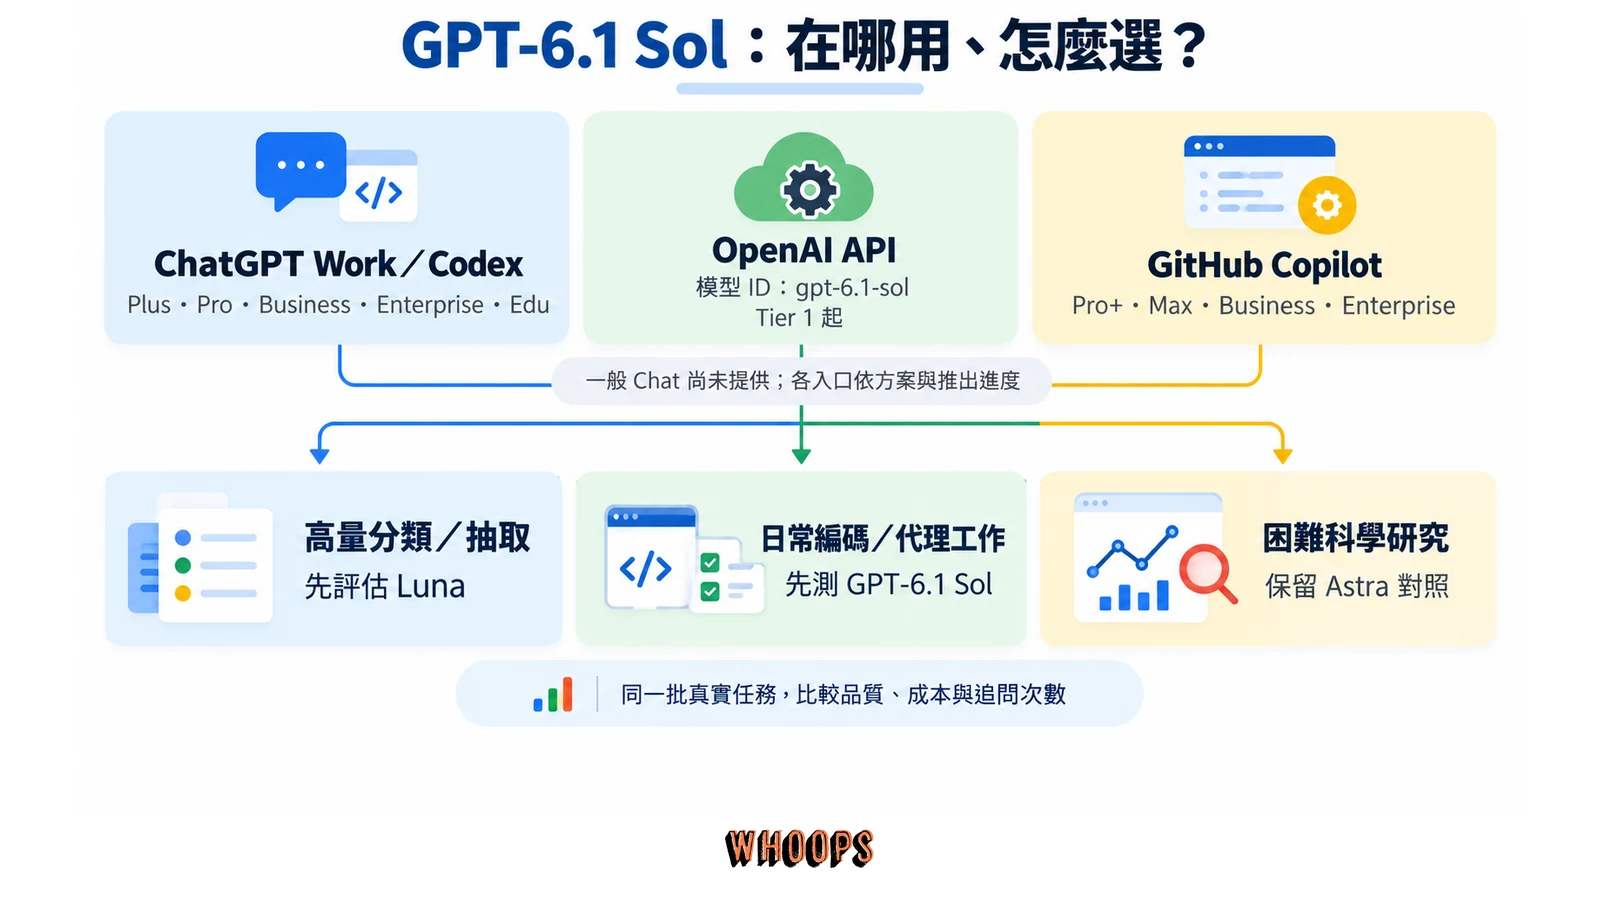
發布日(2026 年 9 月 29 日)的供應範圍官方寫得清楚。ChatGPT 端:GPT-6.1 Sol 進入 ChatGPT Work 與 Codex,開放 Plus、Pro、Business、Enterprise、Edu 方案;Codex 覆蓋桌面 App 與 CLI,Work 覆蓋網頁與行動版。一般對話模式(Chat)尚未提供,免費與 Go 方案不在首波,Enterprise 與 Edu 方案預設關閉、需管理員在設定中開啟。Codex 內的 Standard 與 Fast 模式當天就有,Ultrafast 支援「稍後推出」,推理強度介面從 Light 到 Ultra。還不清楚 ChatGPT Work 和一般 ChatGPT 的差別的讀者,這波再次印證 OpenAI 把新模型往工作場景先推的策略:模型先進 Work 與 Codex,Chat 等後續開放。
API 端用 gpt-6.1-sol 這個名稱,速率限制從 Tier 1 起跳(每分鐘 500 請求、50 萬 tokens),免費層不開放。模型在目錄裡的官方建議是「為了平衡智慧與成本,在複雜專案選它」,並且建議在同一任務上與 Astra 對照後再決定品質與成本的取捨,這個「並存比較」的姿態比單純的取代宣言務實。OpenAI Codex 的完整教學已經寫過,模型選擇器裡指定 gpt-6.1-sol 或互動中用 /model 切換都可以。
費用面要分清楚兩種計費邏輯。ChatGPT 與 Codex 端走方案額度:模型在 Work 與 Codex 裡的用量計入方案的 credits 與用量上限,選更強的推理設定消耗更快,Pro 以上方案的額度空間最大,Astra 的 Ultrafast 在 ChatGPT 端也只有 Pro $500 與特定 Enterprise、Edu 方案吃得到;API 端則是純用量計費,費率表前面已經拆完。同一個模型在兩邊的成本行為完全不同,跨兩邊部署的團隊記得分開做預算模型,不要拿 API 單價去推 ChatGPT 方案的消耗速度。
GitHub Copilot 同日跟上。GitHub 的公告描述它適合代理編碼與終端機工作流程,早期測試中它用明顯更少的 tokens 與步驟完成任務,這對用量計價的方案是直接的成本訊號。方案對應:Copilot Pro+、Max、Business、Enterprise,Pro 沒有;介面覆蓋 VS Code、Visual Studio、Copilot CLI、coding agent、Copilot App、github.com、行動版、JetBrains、Xcode 與 Eclipse,漸進推出。Business 與 Enterprise 管理員同樣透過模型政策控制授權,預設自動啟用。
找不到模型的排查順序與上一波相同:先確認場景(一般對話、Work、Codex 是三個不同的模型清單),再確認方案(免費與 Go 首波看不到 6.1 Sol),剩下來的變數只有漸進推出的時間差,隔幾小時再刷新。依 Codex 的模型供應頁,GPT-6 Sol 與 GPT-6 Luna 在 Work 與 Codex 仍然可選,GPT-5.6 家族在滾動期續售,切換沒有被迫的時間壓力,但 5.6 Sol 的促銷價 11 月 21 日到期是另一回事。
值不值得換:三種身分各自的答案
在 ChatGPT 裡工作的人:換。Work 與 Codex 的模型選單裡 6.1 Sol 已經等著,同一方案沒有額外費用,直接拿一個真實任務跑一輪,重點感受編碼與多步驟工作流的穩定度,一般對話模式用戶則繼續等 Chat 開放。用 API 的開發者:值得做一次正式對照,特別是兩種人。已經在 GPT-6 Sol 上的,改名 + 檢查 reasoning 設定 + 重排快取前綴,三件事一個下午做完,快取帳單直接省;還在 GPT-5.6 Sol 上的,促銷價 11 月 21 日到期前本來就該搬家,6.1 Sol 讓這次搬家同時拿到能力升級與半價。管預算的人:把分層路由表更新一輪,路由與分類判斷留在 Luna,主力代理與編碼搬到 6.1 Sol,最終驗收與高風險任務保留 Astra,需要極低延遲的環節再評估 Ultrafast 上線後的費率。
三種身分之外,兩種情況暫時不用動。需要微調模型或音訊視訊輸入的應用,6.1 Sol 依然不支援;把模型當「無推理的便宜函式呼叫器」用的管線,none 強度被移除後得先重設計。跨陣營評估的團隊可以看Codex 與 Claude Code 的工作方式比較,或對照同樣採 $2/$10 標準牌價的 Claude Sonnet 5.5 價格與 API 遷移設定;比較模型時也要分開看推理費用、快取條件與實際任務品質。
不管哪種身分,發布後的第一週可以照三步把價值榨出來:
- Day 1 選單確認:打開 Work 或 Codex 的模型選單找 6.1 Sol,看不到就隔幾小時再刷新;企業方案的管理員先到設定裡把它開啟。預期結果:確認自己看得到、用得起。
- 第一輪真實對照:挑 10 到 20 個日常任務,讓現用模型與 6.1 Sol 各跑一次,記完成品質、每任務成本與追問次數。預期結果:一張自己工作流的對照表,比任何官方跑分都貼近你的實況。
- 月底前完成路由調整:依對照結果把主力遷到 6.1 Sol、難件與驗收留給 Astra、高量小件導向 Luna,5.6 Sol 的用戶把搬家排進 11 月 21 日促銷到期前。預期結果:路由表更新完,下次模型改版只需重跑對照。
收斂成三條路由規則:日常代理與編碼的主力,6.1 Sol 是新的預設答案;要單一最強結果或硬科學運算,付錢上 Astra;量大、單件價值低的工作,全給 Luna。模型每週都在換,路由規則與對照測試流程才是留得下來的資產。
常見問題
GPT-6.1 Sol 是什麼時候發布的?
OpenAI 在 2026 年 9 月 29 日的 DevDay 發表 GPT-6.1 Sol,距離 GPT-6 Sol 上線正好七天,同日進駐 ChatGPT Work、Codex、OpenAI API 與 GitHub Copilot。當天採漸進推出,模型選單裡還看不到的話,間隔幾小時再檢查。
GPT-6.1 Sol 和 GPT-6 Sol 有什麼不同?
價格帳面不變($2/$10),但快取讀取從 $0.20 砍半到 $0.10;知識截止從 4 月 20 日推到 4 月 30 日;跑分全面上修,DeepSWE 從 68.8% 漲到 75.2%;另有專屬的系統卡安全附錄。行為上最大的差異是 reasoning 不再支援 none 與 minimal,工具呼叫也只能走 Responses API,這兩點會影響舊程式相容性。兩個模型目前在選單並存,官方建議在同一任務上對照後再取捨。
GPT-6.1 Sol 真的追上 GPT-6 Astra 了嗎?
部分追上。DeepSWE 75.2% 超越 Astra 的 74.1%,GDP.pdf 差 0.2 個百分點,OSWorld 差 2.1 個百分點,這三項用五分之一的價格換到接近或更好的結果。AutomationBench 與 Terminal-Bench Science 仍落後 Astra 五到十一個百分點,硬科學運算與頂級流程自動化的旗艦位沒有讓出來。成本角度差距更大:OSWorld 每任務約 Astra 的七分之一,文件類工作不到二分之一。
GPT-6.1 Sol 的 API 價格怎麼算?
標準費率是輸入 $2、快取讀取 $0.10(輸入價的 5%)、快取寫入 $2.50、輸出 $10(每百萬 tokens)。輸入超過 272K tokens 時整個請求按輸入 2 倍、輸出 1.5 倍計費。Batch 與 Flex 半價,Fast 模式 2 倍,區域處理加 10%,工具型功能按次收費。跟 Astra 的 $10/$50 相比,標準輸入輸出恰為五分之一,快取讀取是十分之一。
GPT-6.1 Sol 的知識截止日期是哪一天?
2026 年 4 月 30 日,與 GPT-6 Astra 同日,比 GPT-6 Sol 的 4 月 20 日晚十天;GPT-6 Luna 的 5 月 18 日仍是家族裡最晚。需要最新資訊的任務,接上網路搜尋工具比依賴訓練資料可靠。
在 ChatGPT 一般對話裡用得到 GPT-6.1 Sol 嗎?
還不行。官方明載 GPT-6.1 Sol、GPT-6 Sol 與 GPT-6 Luna 都只在 Work 與 Codex 提供,一般對話模式(Chat)尚未開放,也沒有時間表。模型選單裡找不到時,先確認自己所在的是 Work 或 Codex 場景。
免費帳號用得到 GPT-6.1 Sol 嗎?
首波沒有。官方供應頁寫明 Free 與 Go 方案不包含在 GPT-6.1 Sol 的推出範圍,ChatGPT 端要 Plus、Pro、Business、Enterprise 或 Edu,其中 Enterprise 與 Edu 預設關閉、需管理員開啟。API 端也從 Tier 1 起跳,不開放免費層。
Ultrafast 可以用在 GPT-6.1 Sol 上嗎?
還不行。Ultrafast 是 DevDay 同場發表的付費速度層,API 費率是標準價的 6 倍、最高每秒 300 tokens,目前正式支援的只有 GPT-6 Astra,GPT-5.6 Sol 在預覽名單內,6.1 Sol 的支援官方說法是稍後推出、費率也未公布。Codex 端的 Standard 與 Fast 模式發布當天就可用。
從 gpt-6-sol 換到 gpt-6.1-sol 要改什麼程式?
三個必要檢查:模型名稱換成 gpt-6.1-sol(兩個名稱並存,舊名不會自動升級);reasoning 設定若用到 none 或 minimal 要改,最低可用值是 low;帶工具的呼叫要確認走在 Responses API 上,Chat Completions 不再支援工具呼叫。順手把穩定前綴排到請求前段,快取讀取對半後,命中率會直接反映在帳單上。改完用同一批任務跑一次新舊對照最穩。
台灣用戶現在可以用 GPT-6.1 Sol 嗎?
可以。台灣使用者可依支援方案在 Work、Codex 或 API 取用;是否已看到模型,仍取決於帳號資格、組織政策與漸進推出進度。ChatGPT 端需符合 Plus、Pro、Business、Enterprise 或 Edu 方案條件,API 從 Tier 1 起提供;Copilot 則需符合 GitHub 公告列出的方案。

討論與提問