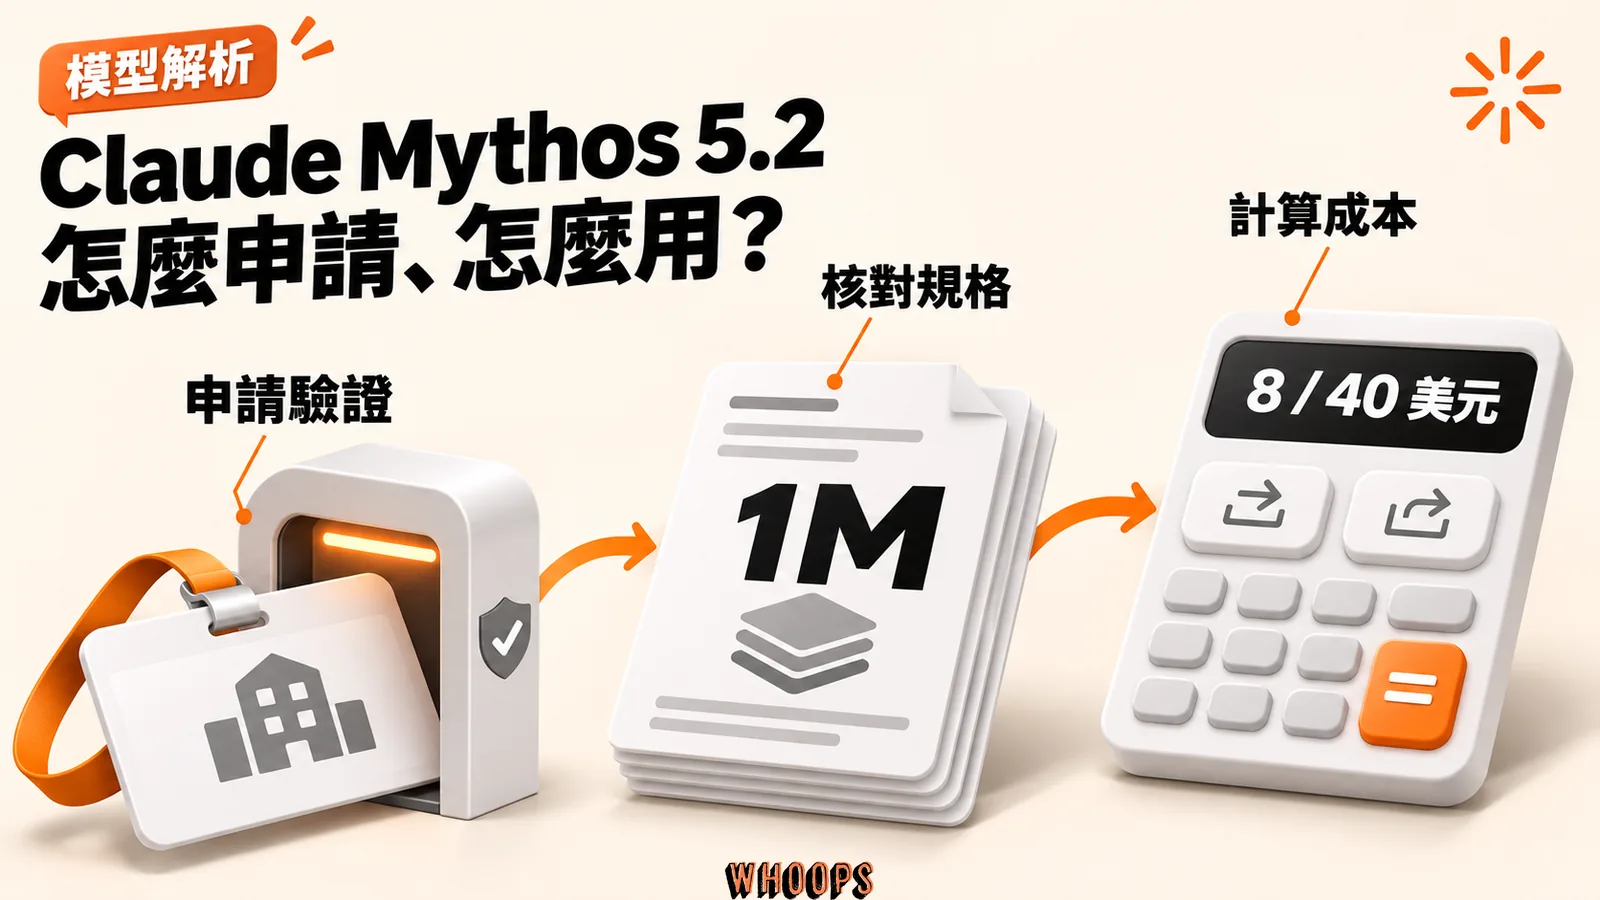
Claude Mythos 5.2 是 Anthropic 於 2026 年 11 月 9 日發布的進階模型,與 Claude Fable 5.2 共用底層模型、規格及價格。差別在存取資格與防護:Mythos 提供給通過驗證計畫的組織及符合資格的個人研究者,依核准等級放寬部分資安與生物防護,使用政策仍然適用。截至 2026 年 11 月 10 日,標準 API 費率為每百萬輸入 token 8 美元、輸出 token 40 美元;日常編碼與知識工作,官方仍建議從 Claude Opus 5.5 開始。
核心答案:Claude Mythos 5.2 是 Anthropic 目前最強的資安與生物研究模型,本體等於 Claude Fable 5.2,差別只在存取資格與防護。Claude Fable 5.2 用安全分類器擋下高風險資安與生物任務,換取對所有人開放。Claude Mythos 5.2 提供給通過驗證的使用者,依驗證資格放寬部分防護,仍受計畫等級與使用政策限制。
規格與通路:1M token 上下文、128K 最大輸出、adaptive thinking 永遠開啟、預設 effort 為 high。取得通路有三條:資安團隊走 Cyber Verification Program,生命科學研究者走 Life Sciences Verification Program,Claude Enterprise 客戶則能用內建、現由 Claude Mythos 5.2 驅動的 Claude Security 掃程式碼庫。標準價 8 與 40 美元,fast mode 16 與 80 美元,Batch API 半價。
底線與限制:官方基準顯示 Claude Mythos 5.2 在資安與生物任務大幅領前代,但這些數字全部是 Anthropic 自評,CyScenarioBench 上各家實驗室用的題目也不相同。Claude Mythos 5.2 預設要求 30 天資料保留供安全監控,ZDR 例外須取得授權,從 Claude Mythos 5.1 遷移有 prefix check 等四個破壞性變更。日常編碼與知識工作,官方建議仍從 Claude Opus 5.5 出發。
用影片看懂 Claude Mythos 5.2:能力、資格與價格
Claude Mythos 5.2 是什麼?與 Claude Fable 5.2 是同一個模型的兩個版本
Claude Mythos 5.2 是 Anthropic 的 Mythos 級模型最新版,官方在Claude Mythos 產品頁給它的定位是「網路安全與生物學研究最強的模型等級」,平台文件則用一句話講完它的本質,Claude Mythos 5.2 就是「給驗證組織使用的 Claude Fable 5.2」。Claude Fable 5.2 與 Claude Mythos 5.2 共用同一個底層模型、同一套規格與同一套價格,兩者只在一個地方分岔:Claude Fable 5.2 內建網路安全與生物防護(safeguards),對所有使用者開放。Claude Mythos 5.2 只提供給通過 Anthropic 驗證計畫的組織,部分防護會依核准資格放寬,並非取消全部安全限制。
為什麼同一個模型要拆成兩個名字出售?Anthropic 在官方 FAQ 給過直接回答:Mythos 級模型在網路安全與生物領域的能力強到若被誤用,可以用來發動網路攻擊或製造危險武器,所以廣泛開放的版本必須是帶防護的 Claude Fable,受限版本才是 Claude Mythos。換句話說,廣泛發行與防護設計有關;合法研究能使用哪些能力,則要看任務及核准等級。理解這條設計線,後面所有規格、價格與申請制度都會變得好讀:官方基準表裡 Claude Fable 5.2 與 Claude Mythos 5.2 的分數差,反映的正是防護介入的任務範圍,而不是兩個不同模型的實力差。
命名方面,Mythos 源自希臘語的「神話」一詞,中文媒體與文件通常不翻譯、直接沿用原文。在 Claude 家族裡,Mythos 是位階最高的模型層:官方公告形容 Claude Fable 5.2 與 Claude Mythos 5.2 在受測的幾乎所有能力上「比 Claude Opus 5.5 高一個台階」,中文維基百科與多數媒體報導也把 Mythos 描述為定位在 Opus 之上的等級。版本號 5.2 與 Fable 世代對齊:2026 年 9 月 1 日的 Claude Mythos 5.1 對應 Claude Fable 5.1,同樣是「同模型、同規格、同價格」的驗證組織版,想看前代雙生結構的完整拆解,可以回頭讀站上的Claude Fable 5.1 與 Mythos 5.1 完整介紹。
Anthropic 在 2026 年 11 月 9 日以一則公告同時發布 Claude Fable 5.2 與 Claude Mythos 5.2,官方 X 帳號的公告貼文把兩個模型描述為「為了處理最艱難技術挑戰而設計」:
Introducing Claude Fable 5.2 and Claude Mythos 5.2, designed to tackle the most daunting technical challenges. They’re capable collaborators on ambitious projects in many fields, and show improvements in areas like coding, reasoning, and vision. https://t.co/jP0AutLxXb
— Claude (@claudeai) November 9, 2026
對台灣使用者,如果你是一般開發者,這次發布對你的實際影響是 Claude Fable 5.2 降價變快。如果你的工作是滲透測試、漏洞研究、惡意軟體分析或生物醫學研究,Claude Fable 5.2 的防護會擋住一部分正當工作,Claude Mythos 5.2 才是為這些工作開的門,而那扇門要申請。下一節先看發布當天實際上線了什麼,再回頭把申請、規格與價格逐一拆開。
2026 年 11 月 9 日發布當天實際上了什麼:速度、降價與 Claude Security 換引擎
發布當天的重點可以濃縮成四件事:Claude Fable 5.2 全面開放、兩個模型輸出變快且降價、新增 fast mode、Claude Security 換上 Claude Mythos 5.2 引擎。Claude Fable 5.2 在 Claude 應用程式、Claude Platform、Amazon Bedrock、Google Cloud 與 Microsoft Foundry 全面可用。Claude Mythos 5.2 同日開放,但只限通過 Cyber Verification Program 或 Life Sciences Verification Program 的組織。官方公告與完整發布文章都把兩個模型定位在「最有野心、最開放式的技術工作」,而不是日常用途。
速度與價格是這次最具體的變化。官方宣稱 Claude Fable 5.2 與 Claude Mythos 5.2 的輸出速度比 Claude Fable 5.1 與 Claude Mythos 5.1 快最多 30%,API 價格從每百萬輸入 10 美元、輸出 50 美元,降到每百萬輸入 8 美元、輸出 40 美元,等於降價 20%。選配的 fast mode 再把輸出速度提高最多 2.5 倍,代價是價格翻倍:每百萬輸入 16 美元、輸出 80 美元。fast mode 在 Claude Code、Claude Platform、Google Cloud(Anthropic managed 與 Google managed)與 Microsoft Foundry(Anthropic hosted)提供,清單裡沒有 Amazon Bedrock。Claude Mythos 5.2 的 fast mode 只給驗證計畫組織。台灣媒體如流動日報的整理也把「快 30%、降價兩成、多數能力超越 Opus 5.5」列為這次發布的三個主標。
Claude Security 換引擎是容易被新聞忽略、對企業其實最直接的一項。Claude Security 是 Claude Enterprise 方案裡的程式碼庫掃描功能,發布後改由包含 Claude Mythos 5.2 在內的最強模型家族驅動,Claude Enterprise 客戶不必加入任何驗證計畫就能使用。近期更新還讓 Claude Security 隨程式碼更新持續監看儲存庫、追蹤發現事項直到修復、從額外背景資料學習,並透過 API 與 MCP 連接既有的資安工具鏈。這代表「用上 Mythos 級資安能力」其實有一條不申請 CVP 的捷徑,後面申請章節會再展開。官方同日釋出 Fable 5.2 的整體介紹影片:
訂閱方案的當週促銷也值得記一筆:包含 Fable 模型的付費方案與席次,依訂閱年資可獲得一至三次 Fable 用量重置,Pro 方案與 Team 方案標準席次的每週用量上限中最多 50% 可用於 Fable 模型。Mythos 模型的訂閱用量規則較嚴:Pro 方案只能靠 usage credits 使用 Mythos,Max 與 Ultra 方案裡 Mythos 與 Fable 共用單一額度(上限為每週用量的一半)。這些促銷與用量條款會調整,使用前請以官方公告為準。
官方也更新了角色定位的建議。Claude Fable 5.2 除了直接執行任務,還能扮演 Advisor,讓 Claude Haiku 5.5、Claude Sonnet 5.5 或 Claude Opus 5.5 在碰到難題時向它請益,也可以反過來當 Orchestrator,把簡單任務委派給更小的模型執行。這個設計與 advisor tool 的同代配對限制要一起讀:Claude Fable 5.2 可以當任何 executor 的顧問,但 Claude Fable 5.2 或 Claude Mythos 5.2 自己當 executor 時,只接受同代的顧問,規劃多模型架構時配對要一次到位。
怎麼拿到 Claude Mythos 5.2:三條通路與 CVP 三級審核實務
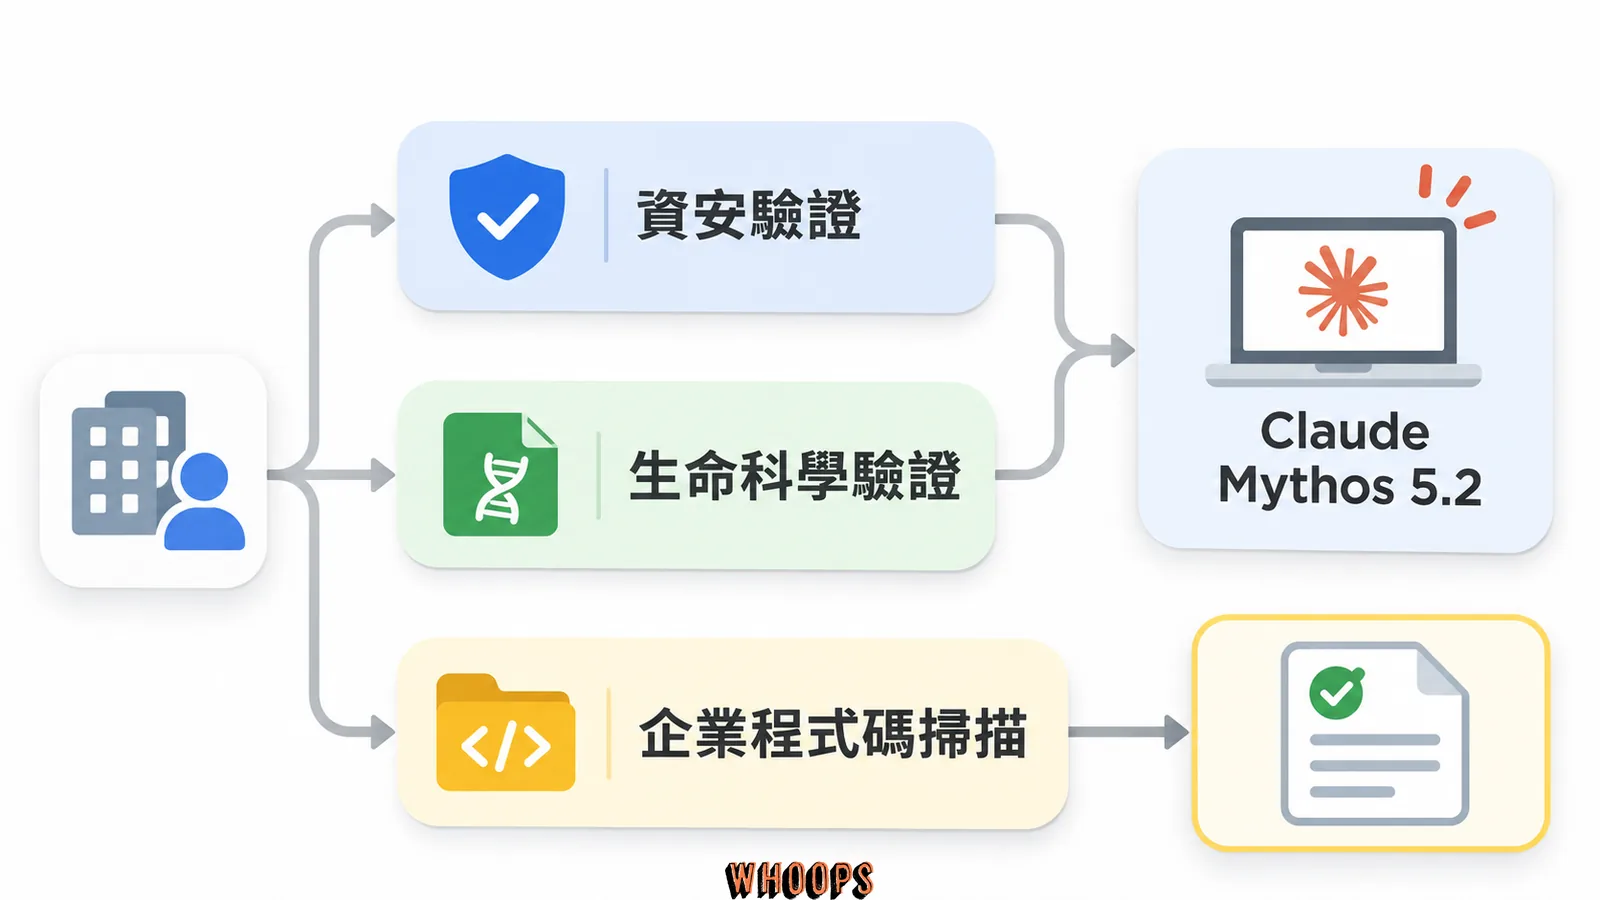
結論先講:拿到 Claude Mythos 5.2 的通路有三條,資安團隊走 Cyber Verification Program(CVP),生命科學研究者走 Life Sciences Verification Program,Claude Enterprise 客戶則可以不改任何資格、直接用內建 Claude Mythos 5.2 的 Claude Security。CVP 在 2026 年 10 月 6 日擴大後採三級制,官方目前的審核目標依等級不同,Defense Access 約兩天、Red Team Access 約兩週,Specialized Access 沒有固定時程,個人研究者也能申請最低的一級。以下逐條拆開申請條件、流程與常見卡關。
通路一:Cyber Verification Program 的三個等級
CVP 是資安人員的主要入口,2026 年 10 月改制後分三級,每一級都能用 Claude Mythos 5.2、Claude Mythos 5.1、Claude Opus 5.5、Claude Sonnet 5.5 與未來模型,等級越高、被安全分類器擋下的工作越少、審核也越嚴。Defense Access(防禦級)門檻最低,企業、非營利組織、大學與政府機關裡負責防守自家系統的資安團隊都能申請,關鍵基礎設施營運者不論規模也算在內,官方舉的例子是區域醫院與市政公用事業。小型資安公司、開源專案維護者與有漏洞通報紀錄的個人研究者也可以申請。個人只能申請 Defense Access 這一級,且必須使用付費方案。Red Team Access(紅隊級)只限組織,申請者是受委託模擬攻擊、替企業找弱點的紅隊與滲透測試公司,開放的是經授權系統上的滲透測試與紅隊演練,部署勒索軟體或破壞實體系統這類行動仍然會被擋,目前目標約兩週,高需求期間可能更久;符合資格者可在審查期間先取得 Defense Access。Specialized Access(特殊級)被擋的工作最少,只給少數經驗證、獲授權測試高影響系統的組織,例如航空作業系統、電網、電信網路與銀行間轉帳基礎設施,三級中只有這一級由 Anthropic 與美國政府合作逐一審查,原 Project Glasswing 成員直接轉入。
各級實際解鎖多少,官方在 10 月的擴大公告用 CyScenarioBench 展示過:同一個 Claude Opus 5.5,十道多階段攻擊規劃題各跑五次,沒有驗證時五十次全部在第一步被拒絕;Defense Access 有四十六次中途被擋、四次完成;Red Team Access 五十次全不被擋、完成三十四次,完成率與完全不設防護的 67.6% 幾乎一致。這是 Anthropic 用自家防護跑的自評,不是第三方驗證,但量級足以說明制度設計:等級越高、攔截越少、審核越嚴,三級制的本質就是把「防護介入程度」做成可以分級授予的資格。
通路二:Life Sciences Verification Program
生命科學研究者的入口是 Life Sciences Verification Program。Claude Fable 5.2 的生物防護會擋下大多數研究生物學任務,從事基因治療、蛋白質設計等正當生物醫學研究的組織,透過這個計畫申請進階能力。官方在發布公告與產品頁都把這條通路與 CVP 並列,申請同樣透過 Anthropic 的驗證入口網站進行。本節撰寫當下,生命科學計畫的審核細節公開資料比 CVP 少,申請前建議直接閱讀官方申請頁的當下條款。
通路三:Claude Security,不申請 CVP 也能用到 Mythos 5.2
如果組織的需求是「掃自己的程式碼庫找漏洞」,其實不必走 CVP。Claude Enterprise 客戶即使不是 CVP 成員,也能使用 Claude Security,這個功能用 Anthropic 最強的模型家族掃描程式碼庫,現在包含 Claude Mythos 5.2。差別在於互動方式:Claude Security 是封裝好的掃描與修補建議流程,使用者不能直接對 Claude Mythos 5.2 下任意指令。CVP 給的是直接呼叫模型的能力。要評估「該申請 CVP 還是用 Claude Security 就夠」,判準是你要不要自己寫 prompt、自己搭資安代理流程。要的話申請 CVP,不要的話 Claude Security 的封裝流程較直接。
申請流程本身有幾個實務細節。申請透過 Anthropic 的 Verification Portal 進行,一個組織填一份申請,Anthropic 會依收到的資料把申請者放進符合條件的最高等級。依最新 CVP 說明,Defense Access 的目標約兩天,Red Team Access 約兩週且目前因申請量大而可能更久,Specialized Access 沒有固定時程。等待超過目標時不必重複送件;申請較高等級而已符合較低等級的組織,可能先取得較低等級存取。需要準備的東西有三樣:組織與申請人的身分資料、資安工作的描述,以及對應等級安全要求的自我聲明。通路按使用平台不同:用 Anthropic 第一方服務(Claude.ai、Claude Code、API)最單純,直接在 Portal 內申請。用 Amazon Bedrock 的組織限定已有 Enterprise Frontier Safeguards 資格的客戶。用 Claude Platform on AWS、Google Cloud 或 Microsoft Foundry 則要先把雲端帳號連結到 Portal 再申請。審核通過後還要一件事:核准不會自動生效,組織管理員要把存取權指派到工作區、角色或連結的雲端帳號,而且雲端平台上的 Mythos 存取會比核准晚約五個工作天。官方列出的未核准原因包括工作性質不在防禦範圍、身分無法驗證、所在地法律與監管環境有風險、主要服務軍方情報或執法客戶,以及申請的等級過高。對台灣組織來說,最穩的第一步是以組織名義申請、聚焦防禦型工作描述、先申請 Defense Access 級。已經在 Project Glasswing 或舊版 CVP 裡的組織不必重新申請,既有存取照舊運作,Anthropic 會把成員轉換到對應的新等級。
通過後的安全要求也要列入導入規劃。Defense Access 級要在 2026 年 12 月 15 日前改用防釣魚的多因素驗證,並停止使用靜態或長期 API 金鑰;在此之前,API 金鑰至少每七天替換一次。Red Team 與 Specialized 兩級的要求更嚴:核可使用者上限分別為 75 名與 25 名。Team 方案須將等級套用到每位使用者;Enterprise 依角色、API 依工作區指派。成員要過身分查核與(法律允許時的)犯罪紀錄查核,只能從公司管理的裝置連入。疑似外洩或濫用要在 72 小時內通報,Anthropic 保留縮減或撤回資格的空間。想把 CVP 資格做成對外服務的組織注意:受管的資安服務(managed service)已開放申請,讓客戶直接使用模型的產品(product)尚未開放受理,只能表達興趣。
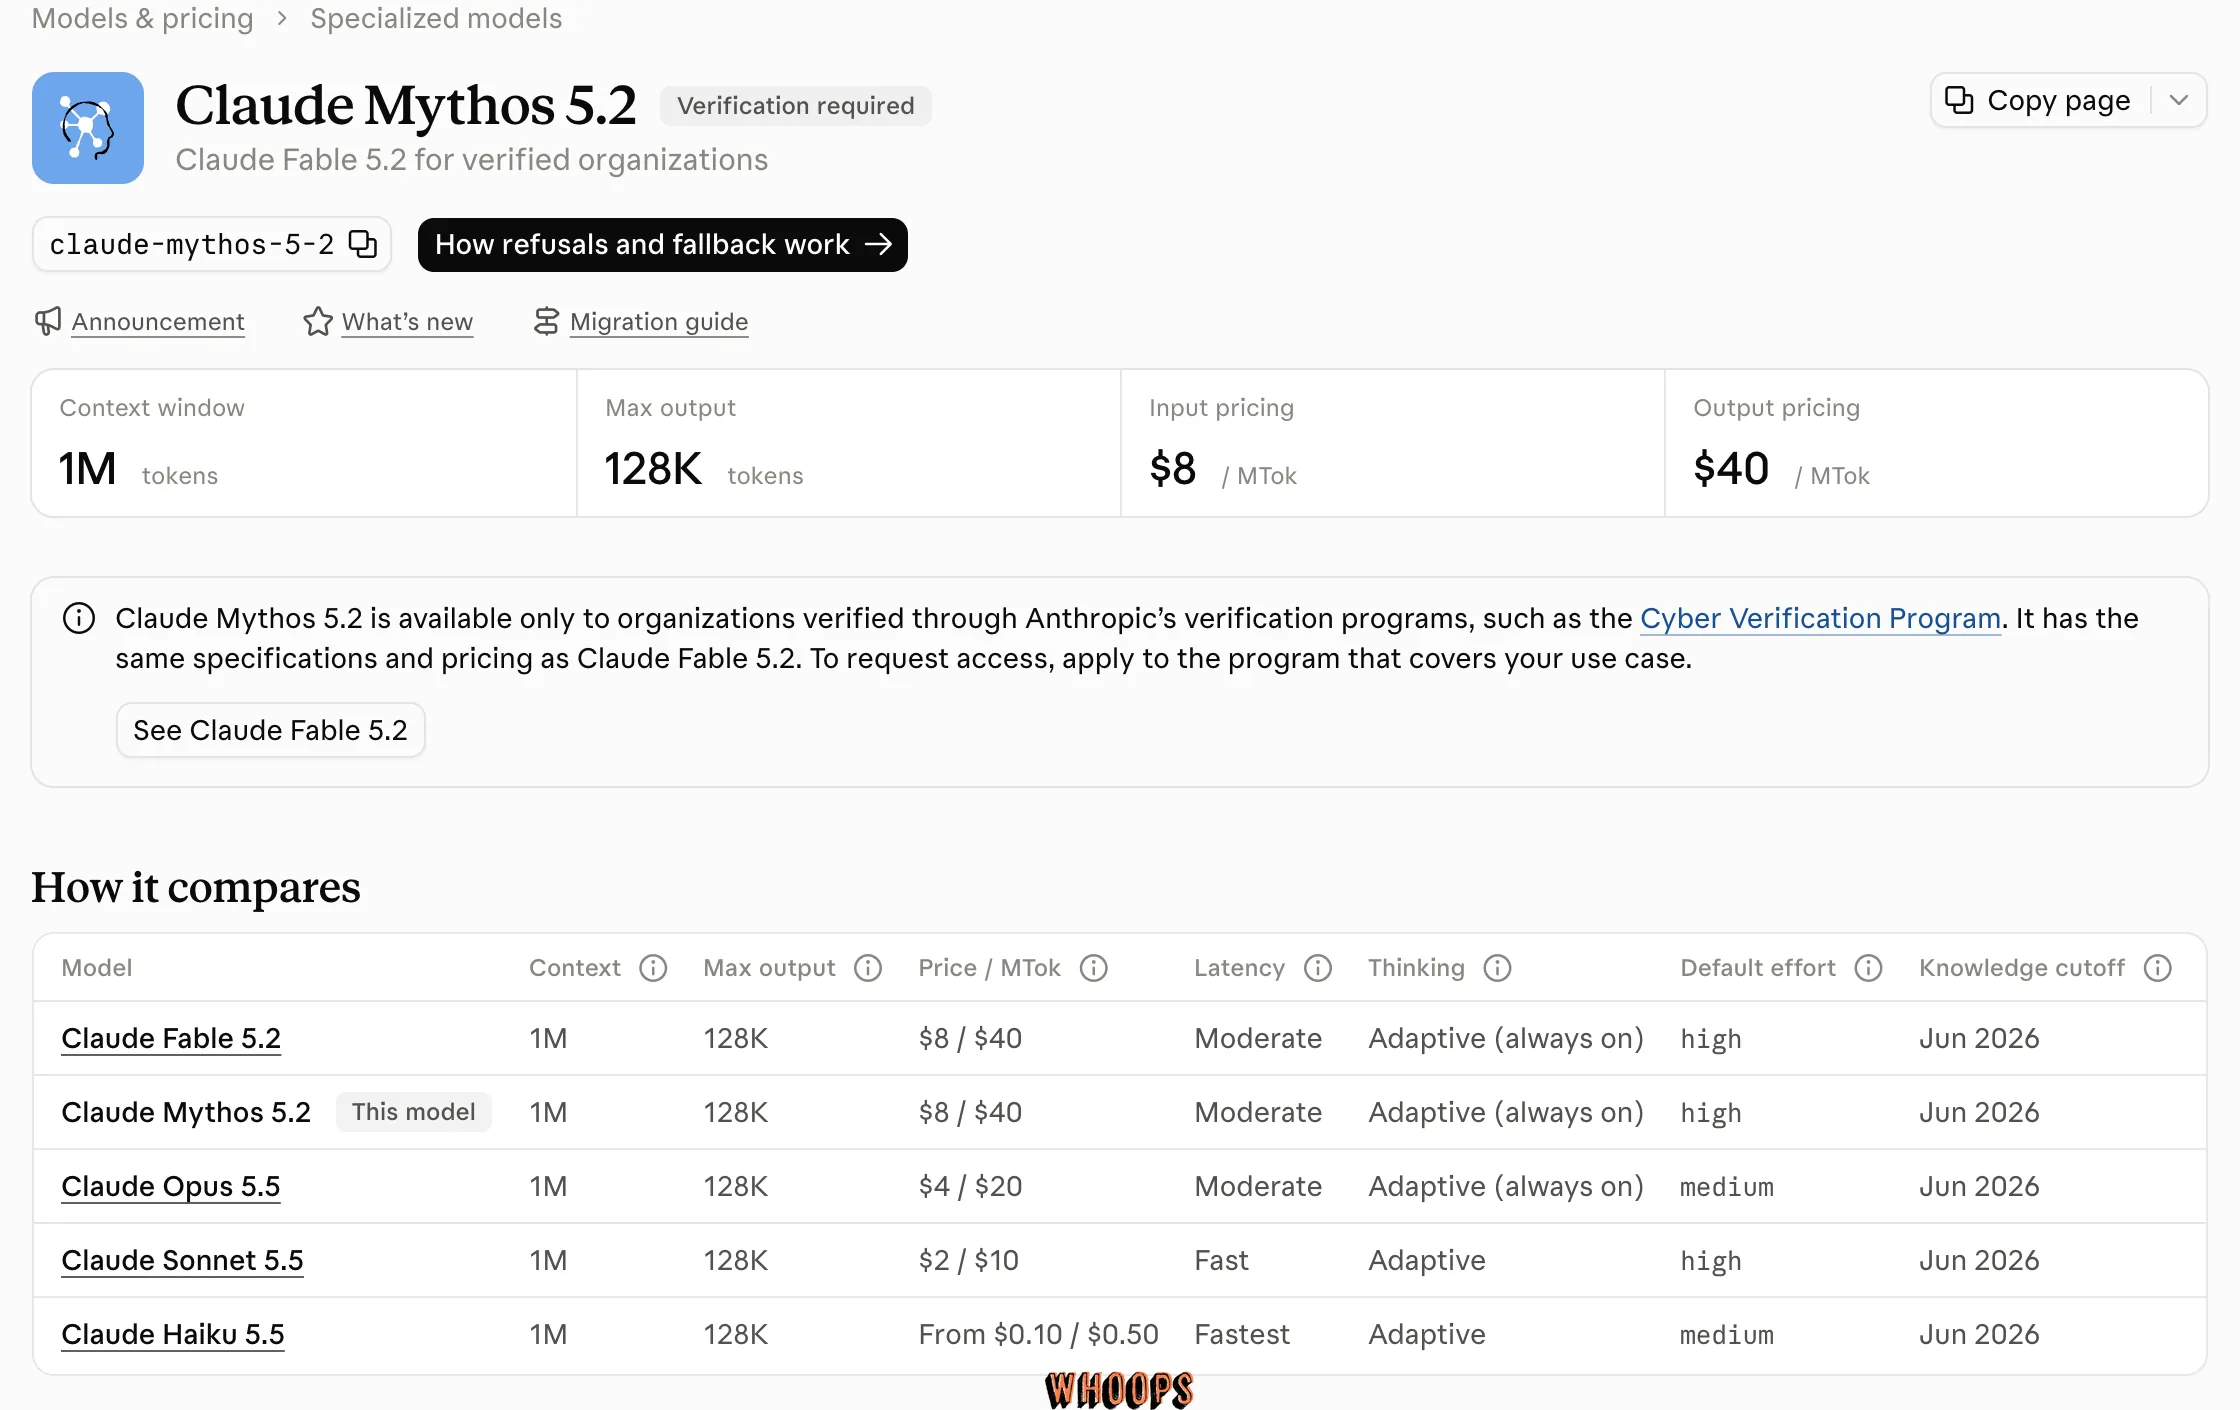
CVP 的前身是 2026 年 4 月啟動的 Project Glasswing(玻璃翼計畫),當時只讓蘋果、微軟、Google 等少數大型夥伴直接操作 Mythos 級模型。6 月 2 日 Glasswing 擴大到約 150 個組織、超過 15 國,10 月 6 日再併入 CVP 改成三級制。Glasswing 擴大公告與CVP 擴大公告都值得申請前讀一遍,CVP 說明中心全文則有各平台逐步操作細節。文件上的「Verification required」標示與價格區,是確認自己通路與費率最快的畫面:
Claude Mythos 5.2 規格與 API 行為:七項相容性檢查
先給規格全貌:Claude Mythos 5.2 有 1M token 上下文、128K 最大輸出、adaptive thinking 永遠開啟、預設 effort 為 high、可靠知識截止 2026 年 6 月、輸入支援文字與圖片而輸出只有文字、比較延遲屬於中等。Model ID 在 Claude API、Google Cloud(Anthropic managed 與 Google managed)與 Microsoft Foundry 都是 claude-mythos-5-2,只有 Amazon Bedrock 是 anthropic.claude-mythos-5-2。生命週期方面,2026 年 11 月 9 日發布,官方承諾不早於 2027 年 11 月 9 日退役。完整規格與價格頁在平台的 Claude Mythos 5.2 文件。
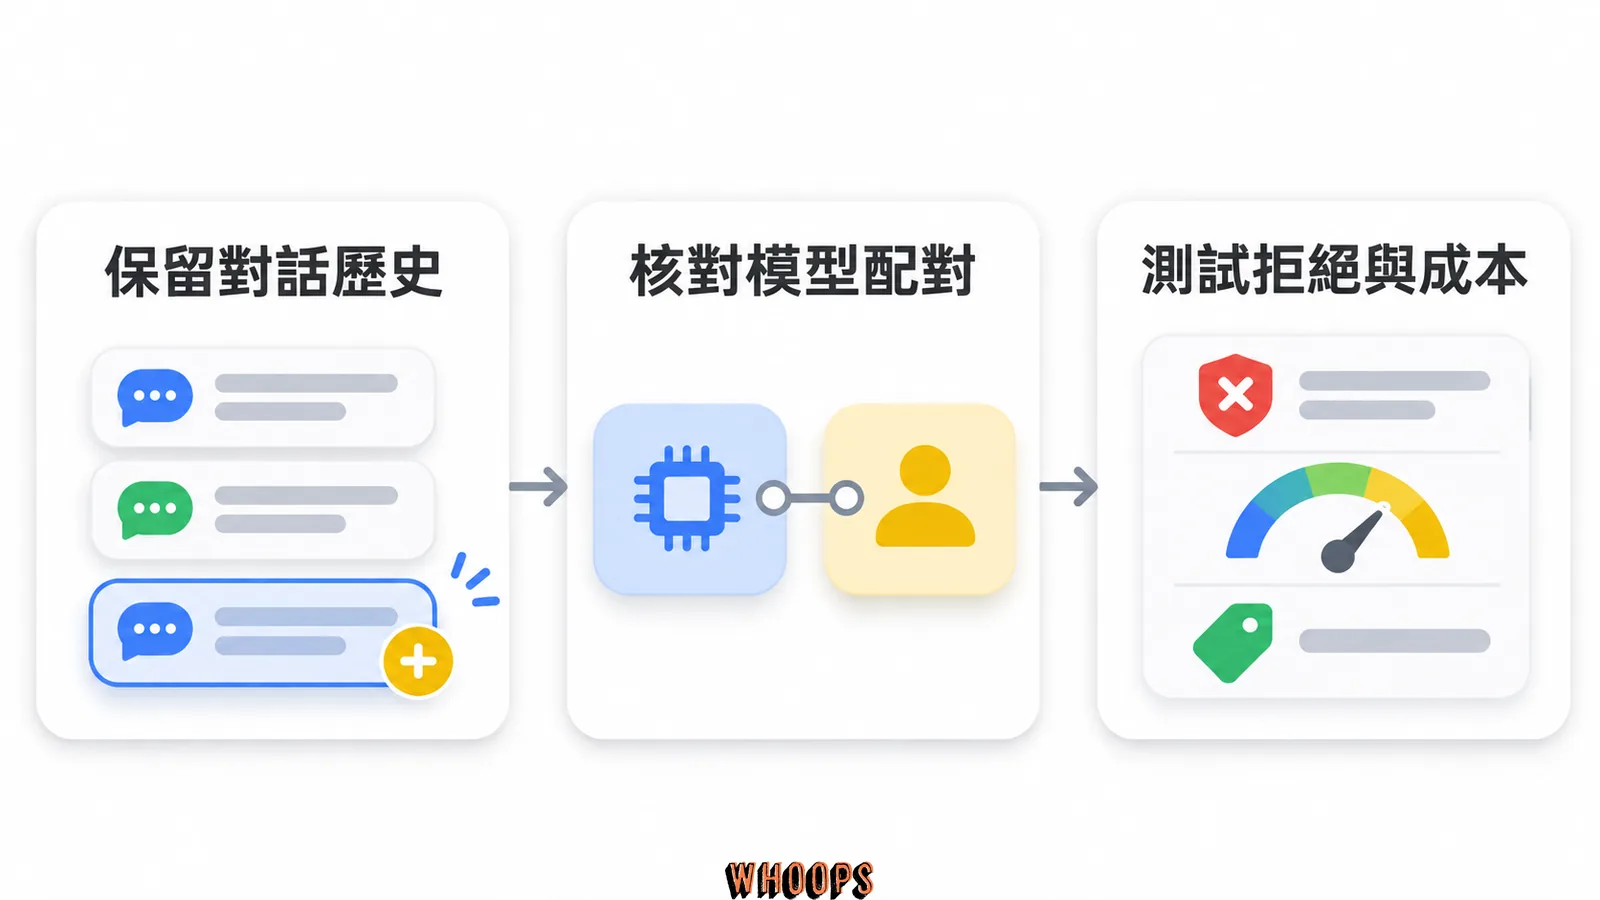
寫程式呼叫 Claude Mythos 5.2 時,有七類寫法會直接回 400 錯誤,這些限制多數沿用自 Claude Fable 5.1,但從 Claude Mythos 5.1 或 Claude Opus 5.5 遷移的程式仍會踩到:
| 寫法 | Claude Mythos 5.2 的行為 | 替代做法 |
|---|---|---|
| thinking: disabled | 400 錯誤,adaptive thinking 無法關閉 | 移除欄位,用較低 effort 控制思考量 |
| thinking 手動 budget_tokens | 400 錯誤,不支援手動 extended thinking | 改用 effort 參數控制深度 |
| 預填 assistant 訊息(prefill) | 400 錯誤 | 把要求寫進 system prompt |
| tool_choice 設 any 或 tool | 400 錯誤,不支援強制工具呼叫 | 保持 auto,在指令中指名工具並用 strict: true |
| 帶 temperature、top_p、top_k | API version 2026-10-21 起,帶任一取樣參數即回 400;更早版本也有限制 | 直接省略這三個參數 |
| CMEK 組織用 structured outputs | strict tool use 與 JSON outputs 都不可用 | 在自家程式裡驗證輸出格式 |
| computer_20251124 電腦操作工具 | 400 錯誤(Amazon Bedrock 除外) | 改宣告 computer_toolset_20260801 |
兩個帳務與流量行為也會影響導入決策。速率限制上,Claude Mythos 5.2 與 Claude Mythos 5.1、Claude Mythos 5 共用同一個合併限額,Claude Fable 5.2 則是獨立限額。換句話說,把流量從 Claude Mythos 5.1 換到 Claude Mythos 5.2 不會帶來新的速率額度,而 Claude Fable 5.2 有自己的池子。服務層級上,Claude Mythos 5.2 與 Claude Fable 5.2 都不支援 Priority Tier,有優先級容量承諾的組織要分開規劃。資料保留上,兩個模型都屬於 Covered Models,預設要求 30 天資料保留供安全監控,零資料保留(ZDR)需要 Anthropic 明確授權,細節留到治理章節展開。
行為面還有兩個補充。安全分類器與拒絕處理:Claude Mythos 5.2 保留防護制度,被分類器拒絕時回應的 stop_reason 是 refusal,實際原因要看 stop_details.category,程式要在讀內容前先處理這個分支。Claude Fable 5.2 的被拒請求可以設定 fallback 到 Claude Opus 4.8 或 Claude Opus 5 重跑,走 CVP 的組織則是攔截門檻隨等級放寬,Red Team 以上在授權範圍內近乎不攔。上下文換算:平台文件對 1M token 的估計約是 55 萬英文字或 250 萬 Unicode 字元,可容納較大量的程式碼與文件,但能否放入整個程式碼庫,仍取決於檔案規模、編碼與其他上下文用量,對資安工作特別有價值,因為漏洞常藏在檔案之間的互動關係裡,能把整個 repo 放進單一上下文,正是 Mythos 級模型改變資安工作方式的地方。
從 Claude Mythos 5.1 遷移到 5.2:四個會讓程式壞掉的地方
從 Claude Mythos 5.1 換到 Claude Mythos 5.2 的移轉,官方文件形容為「大多數情況可直接替換 model ID」,價格同步從 10 與 50 美元降到 8 與 40 美元。但官方遷移指南明列四個破壞性變更,其中第一個在 Amazon Bedrock 上特別容易中招。逐一來看:
遷移陷阱一:prefix check 對每個帳號強制生效
每個 thinking block 只在產生它的 system prompt、tools 與更早訊息之下有效,這條規則叫 prefix check。Claude Mythos 5.2 對每一個帳號強制執行 prefix check,程式如果在兩次請求之間改了 system、tools 或更早的訊息,再舊的 thinking block 一起送回,就會收到 400 錯誤,錯誤訊息寫得很白:「signature 無效,這個 block 綁定在不同對話」。關鍵差異在平台:Claude API 上 Claude Mythos 5.1 本來就對每個帳號強制檢查,但 Amazon Bedrock 上 Claude Mythos 5.1 會接受這種被編輯過的請求,Claude Mythos 5.2 會直接拒絕。如果你的程式自己組 messages 陣列,遷移前先用 thinking-binding-controls-2026-08-01 beta header 搭配 prefix_mismatch_behavior: drop_block 跑一輪,看 input_transformations 裡有沒有 prefix_binding_mismatch,再把對話歷史改成 append-only。把歷史改成只附加還有個紅利:prompt cache 會保持熱的。如果用 Claude Code、claude.ai、Claude Managed Agents 或 Claude Agent SDK 管理對話歷史,這項檢查由工具代勞,不必自己處理。
遷移陷阱二:thinking block 只有單向相容
在 Claude API 與 Google Cloud(Google managed)上,Claude Mythos 5.2 讀得懂 Claude Mythos 5.1 的 thinking block,所以對話可以從 claude-mythos-5-1 無縫搬到 claude-mythos-5-2,先前的推理不會掉。反方向不行:Claude Mythos 5.1 讀不懂 Claude Mythos 5.2 的 thinking block。如果路由器、客戶端重試或分類器 fallback 把對話從 Claude Mythos 5.2 切到 Claude Mythos 5.1,API 會丟掉讀不懂的 block、請求照樣成功,被丟掉的輸入 token 不計費,但模型會在沒有那段推理的狀態下工作,切換後的第一輪成本與延遲可能上升。設計 fallback 路徑時要把這個行為算進去。
遷移陷阱三:advisor tool 只接受同代顧問
用 advisor tool(beta)把 Claude Mythos 5.2 當 executor 時,advisor 必須至少跟 executor 一樣強:Claude Mythos 5.2 只接受 Claude Mythos 5.2 或 Claude Fable 5.2 當 advisor,Claude Mythos 5.1 與 Claude Fable 5.1 當 advisor 都會回 400 錯誤。改 executor 型號時記得同步改 advisor 的 model 欄位,而且這個修改本身就是對 tools 的編輯,要在新對話裡做,舊對話裡改會撞上前面的 prefix check。另一個容易漏的點:Claude Fable 5.2 與 Claude Mythos 5.2 當 advisor 時,建議內容會以加密的 advisor_redacted_result block 回傳,程式若依賴讀取建議文字,要把這段依賴拆掉。
遷移陷阱四:更新電腦操作工具宣告
在 Claude API 與其他適用平台上,舊版 computer_20251124 不支援 Claude Mythos 5.2,改用 computer_toolset_20260801。Amazon Bedrock 的支援方式不同,應依平台文件核對;不要只替換 model ID 就沿用舊工具宣告。
遷移後補測:拒絕處理與 effort 校準
Claude Mythos 5.2 保留安全分類器,程式要在讀回應內容前先處理 stop_reason: “refusal” 並讀 stop_details.category,不能假設回應一定有內容。effort 也要重新校準:官方觀察到「請直接回答、不要深思」這類提示詞在 medium effort 以上擋不住思考,小 max_tokens 可能在 thinking block 之後、正文之前就用完。xhigh 與 max effort 下模型還會開 subagent 自我審查,subagent 可能佔掉 session 成本的一大塊。沿用舊 system prompt 與技能指令的團隊,建議把寫給舊模型的指令整批檢查一輪。如果你是用 CLAUDE.md 管理代理指令的 Claude Code 使用者,這次遷移是回頭檢視指令檔的好時機,相關背景可參考站上的CLAUDE.md 完整介紹。
Claude Mythos 5.2 價格與成本試算:降價 20% 之後的實際帳單
Claude Mythos 5.2 與 Claude Fable 5.2 同價,下表依官方規格與費率文件整理,以美元及百萬 token(MTok)計價:
| 項目 | Claude Mythos 5.2 / Fable 5.2 | 前代 Mythos 5.1 / Fable 5.1 |
|---|---|---|
| 輸入 | 8 美元 / MTok | 10 美元 / MTok |
| 輸出 | 40 美元 / MTok | 50 美元 / MTok |
| 5 分鐘 cache write | 10 美元 / MTok | 12.50 美元 / MTok |
| 1 小時 cache write | 16 美元 / MTok | 20 美元 / MTok |
| cache read | 0.20 美元 / MTok | 0.25 美元 / MTok |
| Batch API | 輸入輸出半價 | 輸入輸出半價 |
| fast mode 輸入 / 輸出 | 16 / 80 美元 / MTok | 前代無此選項 |
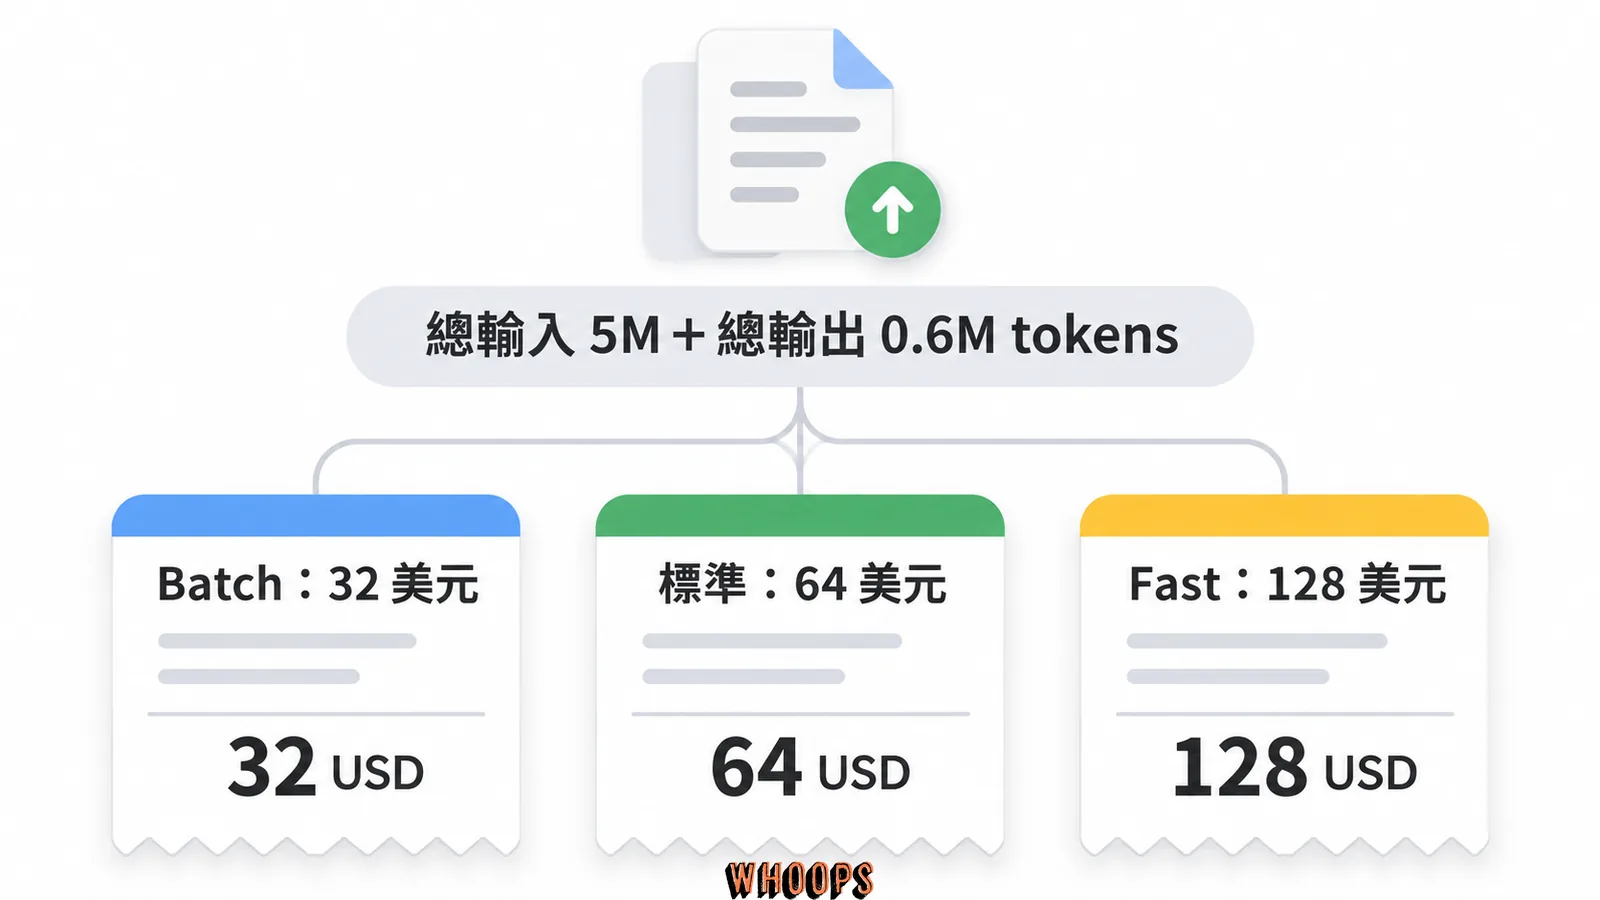
換算新台幣給個量級:以試算假設匯率 1 美元兌 32.5 元換算,每百萬輸入 token 約 260 元、每百萬輸出 token 約 1,300 元,匯率浮動請以帳單當日為準。做一個可重算的成本情境:假設一次全庫資安稽核包含多次 API 請求,累計輸入 500 萬 token(程式碼、設定與歷史)、輸出 60 萬 token(漏洞報告、修補建議與 diff)。這是總用量,並非單次請求;每次仍受 1M 上下文與 128K 最大輸出限制。標準模式的帳單是 5 乘 8 加 0.6 乘 40,等於 64 美元,約 2,080 元新台幣;走 Batch API 半價是 32 美元;fast mode 是 5 乘 16 加 0.6 乘 80,等於 128 美元。這個試算不含重試、cache write 費用與 effort 差異,實際帳單以你的用量為準,公式可以直接代入自己的數字重算。
快取的帳要單獨算。cache read 每百萬 0.20 美元,只有輸入單價的 2.5%,重複掃描同一個程式碼庫、或長對話沿用同一段 system 與工具定義時,快取命中部分的輸入單價較低;未命中部分、寫入及輸出仍須計費。寫入分兩檔:5 分鐘 10 美元、1 小時 16 美元,選法很直觀,同一批上下文會在五分鐘內重複用就選短檔,整個上午的稽核 session 會反覆用就選長檔。把 system 與 tools 在 session 開始時凍結、對話歷史保持只附加,快取命中率自然高,這也是遷移章節要求把歷史改成 append-only 的經濟動機:同一個工程決策,同時買到 prefix check 的合規與快取的省錢。
官方這次特別強調「能力往上、成本往下」的效率組合,幾個數字值得記住:在 FrontierCode 2.0 上,Claude Fable 5.2 用 High effort 拿 45.3%,與 Claude Opus 5.5 用 Max effort 的 45.5% 約持平,每任務成本約一半。Humanity’s Last Exam(HLE)用 Low effort 就追平 Claude Opus 5.5 的最高分,每任務成本不到十分之一。圖表判讀基準 Chartography 用 Medium effort 拿 66.4%,超過 Claude Opus 5.5 用 Max effort 的 64.4%,成本同樣不到十分之一。對已經在 Claude 家族裡的團隊,這代表「先把 effort 調對」比「換更貴的模型」更省錢:日常編碼與知識工作從Claude Opus 5.5 出發,批次與可延遲的工作走 Batch API 半價,互動式長任務才往上開 Fable 或 Mythos,往下有Claude Sonnet 5.5 與Claude Haiku 5.5 可以分流。fast mode 的帳要這樣算:價格是兩倍,換速度最多 2.5 倍,而且加速的是輸出吞吐而不是首 token 延遲,適合瓶頸在「等模型寫完」的互動場景,不適合排隊等首字的場景。
官方基準怎麼讀:逐項數字與三個解讀紀律
先看通用能力的官方數字。除了特別註記,以下都是 Claude Fable 5.2(等同 Claude Mythos 5.2 的底層模型)的成績,對照組是 Claude Fable 5.1、Claude Opus 5.5、GPT-6 Astra 與 Gemini 4 Carbon,分數一律來自 Anthropic 官方基準表:
| 基準(測什麼) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0(代理編碼) | 49.1%(Xhigh) | 32.4%(Xhigh) | 45.5% | 42.8% | 41.1%(Medium) |
| FrontierSWE v2(代理編碼) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench(商務流程) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1(代理科研) | 74.6%(Mythos 5.2:75.3%) | 52.6% | 58.7% | 68.1% | 64.8% |
| WANDR(代理搜尋) | 82.1% | 68.7% | 72.3% | — | — |
| OSWorld 2.1(電腦操作) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim(機器人模擬) | 64.9% | 27.6% | 39.4% | 29.8% | — |
| AA-Briefcase v1.1(知識工作) | 66.1% rubric/1785 Elo | 61.5%/1669 | 61.2%/1800 | 52.0%/1569 | 61.8%/1611 |
| Remote Labor Index(知識工作) | 41.3%(High effort) | 17.9% | 21.3% | 20.8% | — |
| HLE with tools(跨領域推理) | 74.2% | 65.6% | 67.7% | 57.2% | — |
| Chartography(圖表判讀) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
資安與蛋白質設計是 Claude Mythos 5.2 與前代差距最大的地方,官方把這三項獨立列出,並列出 Claude Opus 5.5 關閉防護後的對照結果:
| 基準(測什麼) | Mythos 5.2 | Mythos 5.1 | Opus 5.5(無防護) | GPT-6 Cyber |
|---|---|---|---|---|
| CyScenarioBench(多階段網路攻擊情境) | 76.3% | 61.7% | 67.6% | 61% |
| CVE Rediscovery(找回已知漏洞) | 89.6% | 78.3% | 81.3% | — |
| De novo binder design 24 小時(蛋白質結合體設計) | 85.1% | 79.1% | 82.6% | — |
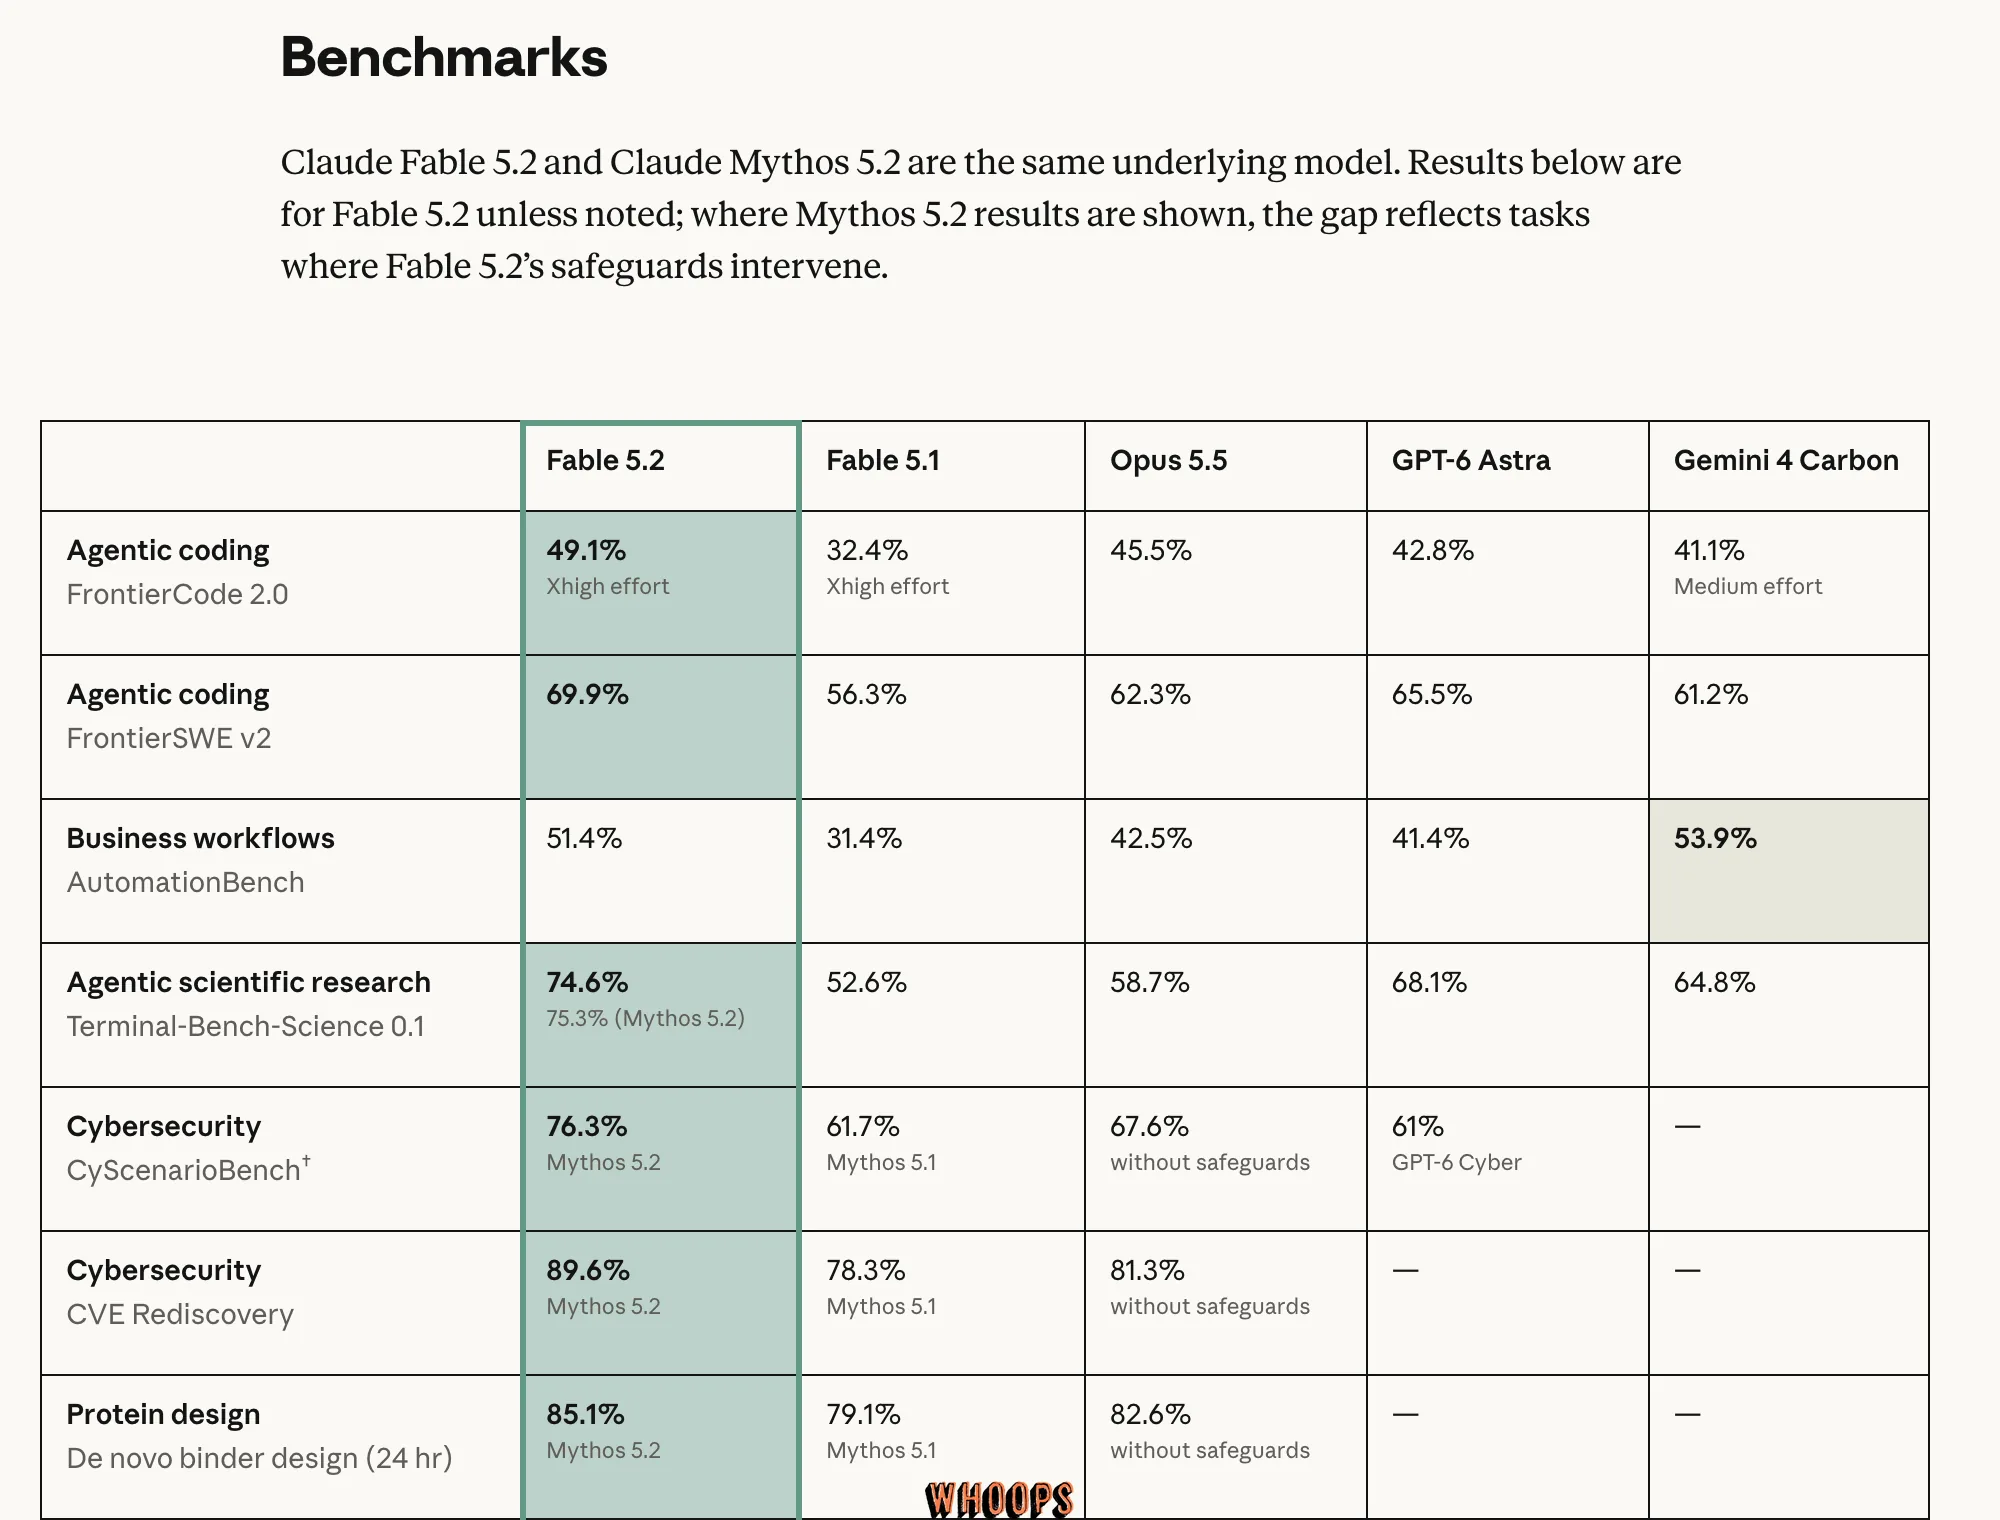
讀這兩張表要帶三個紀律。第一,Claude Fable 5.2 與 Claude Mythos 5.2 是同一個模型,兩者分數的差距反映的是 Claude Fable 5.2 防護介入的任務範圍。例如 CyScenarioBench 測的是規劃並執行多階段模擬網路攻擊,帶防護的版本會被分類器攔下,所以那欄只有 Claude Mythos 5.2 的數字,表中的 67.6% 是 Claude Opus 5.5 關閉防護的分數,不能當成 Mythos 5.2 的消融實驗,也不能用這兩個數字拆解訓練與防護各自的貢獻。第二,跨廠商數字不能直接硬比:CyScenarioBench 上各家實驗室的題目並不相同,RoboDojo Sim 是 Anthropic 用自家 harness 跑的內部測試,GPT-6 Cyber 的 61% 與 Claude Mythos 5.2 的 76.3% 只能當方向參考。第三,這些全部是 Anthropic 自評,方法學細節在官方系統卡,採購決策前值得對照第三方結果再下判斷。
表裡有兩個誠實的亮點反例,反而增加這張表的可信度:AutomationBench 上 Gemini 4 Carbon 的 53.9% 高於 Claude Fable 5.2 的 51.4%,AA-Briefcase 的 Elo 版計分也由 Claude Opus 5.5 的 1800 領先 Claude Fable 5.2 的 1785。也就是說「幾乎所有能力高一個台階」是官方自己的措辭,不是每一格都贏。想深入了解這位在商務流程上仍領先的對手,可以讀站上的Gemini 4 Carbon 完整介紹。
effort 是這一代模型最有效的成本槓桿。五個等級(low、medium、high、xhigh、max)對應思考深度,Claude 應用程式與 Claude Code 的預設是 medium,Claude API 上 Claude Fable 5.2 與 Claude Mythos 5.2 的預設是 high。從預設 medium 的 Claude Opus 5.5 搬過來的請求若不指定 effort,會自動高一級,結果不變差、帳單直接變貴。上面的表除特別註記外,都是各模型最高可用 effort 的成績,採購前應在自己的任務上跑一輪 effort 對成本與品質的掃描:多數日常任務 medium 或 high 就夠,xhigh 以上留給 FrontierCode 這類競賽級難度的工作。
CVE Rediscovery 值得單獨展開,因為它最貼近資安團隊的日常。這個內部評測給模型一份漏洞修復前的專案快照,看模型能不能獨立找回當年的 CVE。2026 年 10 月的評測跑了 1,829 個已發布 CVE,Claude Mythos 5.2 在每個 effort 層級都贏過 Claude Mythos 5.1 與 Claude Opus 5.5,找到的漏洞比 Claude Opus 5.5 多 10.2%、比 Claude Mythos 5.1 多 14.4%。一家資安公司回報,Claude Mythos 5.2 找到的確認漏洞中,每六個就有一個是其他受測前沿模型全部漏掉的。校準度也有具體觀察:一位測試者發現舊模型約每二十個發現就有一個高估嚴重度,Claude Mythos 5.2 沒有高估任何一個。不過官方腳註同時提醒,單一測試者的原始計數不能直接外推,Anthropic 自己的評測裡漏洞識別率與 Claude Opus 5.5 大致相當。「多找多少」會隨任務與工具架構變動,導入時用自己的程式碼庫重跑一輪最準。
資安實戰成績單:Mozilla、Rubrik、Uber 與 Project Glasswing
公告內三則客戶引述給了具體量級。Mozilla 特聘工程師 Brian Grinstead 說,Mozilla 全年與 Anthropic 合作用連續世代的 Claude 模型強化 Firefox,每一輪都留下更少、更隱微的漏洞,而 Claude Mythos 5.2 在各自的掃描活動中把漏洞發現指標「大約翻倍」於 Claude Mythos 5.1。Rubrik 共同創辦人兼技術長 Arvind Nithrakashyap 說,Claude Mythos 5.2 在自家系統裡找出了早期 Mythos 模型沒有發現的潛在問題,輸出更好讀、團隊抽查更快,他們用 Claude Mythos 5.1 打造的 Code Guardian 工具鏈會換到 5.2。Uber 資深工程師 Andrew Mager 的用法更接近台灣企業想抄的作業:一次 10 到 12 小時的資安稽核,Claude Fable 5.2 派出約 170 個 reviewer agents,帶回完整報告、修復用 pull request 與政策建議,而且「做到工作真正完成才停,不是停在看似合理的檢查點」,他在 High effort 下願意用它取代現行工具跑長時間無人值守的稽核。
規模化的數字來自 Project Glasswing 與 CVP 的官方統計:2026 年 4 月到 7 月,計畫夥伴找出至少 129,000 個經驗證的軟體漏洞,Anthropic 自掃開源程式碼 4 月到 10 月再找出 5,500 個,其中超過 33,000 個已被評為重大或高風險等級。官方同時附上但書:這些數字只來自部分 Glasswing 夥伴的調查回報,屬於低估,真實影響官方預期至少是五倍。這些是 Anthropic 與部分夥伴回報的統計,「至少五倍」是官方估計,並非獨立稽核結果。掃描出的修補建議仍須人工驗證;導入時應把修復、追蹤與審查人力一併列入規劃,不能只計算掃描成本。
Claude Security 的演進脈絡讓這條路的定位更清楚。這個功能 2026 年 4 月 30 日以公開測試版登場時用 Claude Opus 4.7 跑掃描,8 月 21 日 Anthropic 把引擎升級到 Claude Mythos 5 並擴大資安夥伴整合,11 月再換上 Claude Mythos 5.2,半年內三次換引擎,每次都對應漏洞挖掘能力的一次跳升。同一段期間,Anthropic 宣布成立 Defender Advantage Fund(0xDAF),提供價值 3,500 萬美元的 Claude 使用額度支援開源資安工作,資助修補開源專案漏洞、自動化掃描修補流程與發展整類攻擊防禦方法的組織,規模是 Glasswing 起步時 400 萬美元開源捐款(250 萬給 Alpha-Omega 與 OpenSSF、150 萬給 Apache 基金會)的近九倍。周邊制度的密度說明一件事:Anthropic 把「模型找到漏洞之後怎麼修」當成一條產品線在經營,採購 Claude Security 的團隊等於搭上這條持續升級的線,而不是買一個靜態工具。
對台灣的資安團隊,這些實績的正確用法是當「能力上界參考」而不是「保證」。Mozilla 與 Rubrik 的翻倍與提速都發生在已有完整工具鏈與人類審查流程的組織裡。官方也強調 Claude Fable 5.2 的防護會擋下大多數資安相關任務,要重現這些工作流程,前提是取得 Claude Mythos 5.2 的驗證資格,或先用 Claude Security 在封裝好的掃描流程裡驗證量級。
生物與科研應用:capsid 預測、黑洞難題、費馬大定理與一千個代理
生物醫學是 Claude Mythos 5.2 的第二個主戰場,代表性成果是 AAV 病毒衣殼(capsid)結構預測。腺相關病毒是小型無害病毒,它的蛋白質外殼可以用來遞送基因療法,而外殼結構會影響療法會不會被患者免疫系統擋下。既有蛋白質折疊模型如 AlphaFold 能預測單一蛋白質,但衣殼由數十個蛋白質組成,超出單體預測的能力範圍。Claude Mythos 5.2 以兩個開源折疊模型為基礎,自己寫程式把模型跑在重疊的蛋白鏈分組上,再利用衣殼的已知對稱性把結果合併,在測試的 34 個天然與工程衣殼中準確建模 28 個(以 Cα RMSD 誤差在 3 Å 內計)。官方影片展示了這個預測流程:
三位計算生物學者的回饋點出實際價值:Dyno Therapeutics 共同創辦人 Sam Sinai 說這個加速可為衣殼折疊管線省下可觀的時間與成本;哥倫比亞大學教授 Mohammed AlQuraishi 指出大型蛋白質組裝仍是蛋白質建模的開放問題,Claude 的做法讓個別科學家在個人工作站上建模過去需要專用運算叢集的系統;開源 ESMFold2 的 Biohub 首席研究科學家 Zeming Lin 則樂見社群把工具延伸到重要應用領域。
理論物理方面,Claude Fable 5.2 解出兩個黑洞理論的開放問題,都倚賴全息對偶(holographic duality)這個「帶重力的宇宙可以由不帶重力的量子理論精確描述」的想法。第一題:物理學家 1983 年證明大型宇宙加熱時黑洞會像水沸騰一樣突然形成,但方法只適用於夠大、廣義相對論成立的宇宙。2003 年有人把小型宇宙的對應計算寫出來,卻太繁瑣而無人完成,Claude Fable 5.2 在大致自主的狀態下算完,證明小型宇宙的相變同樣是突然的。第二題:物理學家用了十五年以上、用來在簡化宇宙中排除量子重力候選理論的技巧,Claude Fable 5.2 找出了這個技巧的精確極限。兩篇論文都以預印本發布。
數學形式化(formalization)的展示更戲劇化:把數學證明翻譯成 Lean 這種電腦可逐步檢查的語言。Anthropic 未公開的研究版 Claude 首次把費馬大定理(Fermat’s Last Theorem)形式化花了 11 天,倚賴特製 harness 與人類研究者指導。Claude Fable 5.2 用 1,000 個代理在 30 小時內完成整套形式化,人類介入極少,只拿到一份中間定理清單作為計分參考,沒有任何數學參考資料,行動 token 只剩三分之一、證明短七倍。對照組 Claude Opus 5.5 用同樣的 1,000 代理設定,18 小時只完成 26%,再給 12 小時也幾乎沒有進展。
工程端的預發布成果同樣具體。一名 Anthropic 工程師用一段 prompt 要 Claude Fable 5.2 設計原型作業系統,模型協調超過 1,000 個子代理、全天候工作八天,做出能在筆記型電腦上開機的作業系統,有自己的核心、磁碟鍵盤網路驅動、永久檔案儲存、視窗、登入畫面與安裝器。硬體方面,模型用一段文字描述設計出三個可動作的電子裝置(語音助理 hub、USB 視訊會議喇叭、手持電子寵物),自己寫規格、從美國經銷商選料、佈線四層電路板、建模外殼、寫裝置軟體,每片板一天內可投產,與硬體公司 Diode 合作製造後三台全部正常運作。在硬體工程基準 BenchCAD 2.1 上,Claude Fable 5.2 用 Max effort 拿 83.5 分,高於 Claude Opus 5.5 的 65.3 與 Claude Fable 5.1 的 44.4。Anthropic 內部則有超過 90% 合併進核心程式碼庫的變更是 Claude 在人類指導下寫的,一個代理團隊把關鍵生產服務從 Python 遷到 Rust,服務啟動快約 26 倍。
機器人是另一個跳躍點。官方影片裡,Claude Fable 5.2 控制的機械手臂完成解魔術方塊、轉開瓶蓋、畫出一台機器人等任務,其中包含它從未受過專門訓練的項目。在模擬雙臂機器人的公開基準 RoboDojo 上,Claude Fable 5.2 用 Max effort 拿 64.9%,是 GPT-6 Astra(29.8%)與 Claude Fable 5.1(27.6%)的兩倍以上,也贏過 Claude Opus 5.5 的 39.4% 與 Gemini 4 Argon 的 34.2%。官方發布頁提供了實際機械手臂展示:
治理與風險:30 天資料保留、EFS、sandbox escape 與防蒸餾
資料保留是最先影響採購的治理條款。部分複雜的模型濫用只在觀察多個請求的模式時才偵測得到,所以 Claude Fable 5.2 與 Claude Mythos 5.2 都被列為 Covered Models,預設要求 30 天資料保留供安全監控。在 Claude API 上,沒開 30 天保留的組織或工作區,請求會直接回 400 錯誤。零資料保留(ZDR)需要 Anthropic 明確授權。過渡安排叫 Enterprise Frontier Safeguards(EFS):把自動安全監控搬到儲存在客戶自家基礎設施的提示與回應上執行,因此與 ZDR 相容,目前已進入私人測試版,首批客戶包括 Bridgewater、Salesforce 與 Stripe。在 EFS 上線前,已有 ZDR 的合格 CVP 客戶可以繼續保留 ZDR 使用 Claude Mythos 5.2。台灣的金融、醫療等對資料出境敏感的組織,申請前應把這條與法務確認清楚。
sandbox escape(模型試圖逃出沙箱)的評測結果是這次安全報告的重點。在兩個沿用舊版設計的評測裡,Claude Mythos 5.2 的逃脫嘗試比 Anthropic 測過的任何模型都少得多。在一個專門設計的對抗實驗裡(超過 1,800 個情境、多數不逃出沙箱就無法解題、沙箱還被故意留了弱點),Claude Mythos 5.2 在 3.1% 的情境裡動用了沙箱外的憑證或檔案,與 Claude Opus 5.5 的 3.3% 相當,低於 Claude Sonnet 5.5 的 5.1%,更遠低於 Claude Mythos 5 的 39% 與 Claude Mythos 5.1 的 21%。在提示裡描述沙箱、並給模型回報弱點的工具後,逃脫又更少。行為稽核(約 1,900 個情境的自動化審計)的整體失準分數是 Claude Mythos 5.2 2.67、Claude Opus 5.5 2.79、Claude Sonnet 5.5 3.10、Claude Mythos 5.1 3.28,分數越低越好。在誤導使用者相關的多數指標上,Claude Mythos 5.2 優於三個對照模型。官方也誠實列出未解問題。這一代模型比近期任何模型更常懷疑自己在被評測,且在一項「誤判自己在模擬環境後採取有害行動」的指標上略遜於 Claude Opus 5.5。發布前另由英國 AI 安全研究機構(UK AI Security Institute)、Frontier Design 與 METR 外部測試。
兩個補充把治理圖拼完整。CVP 本身也要求資料保留,因為濫用模式要跨多個請求觀察才看得出來。Amazon Bedrock 上的 CVP 因此只開放給已有資料保留豁免(即 EFS 資格)的客戶,官方表示正在設法擴大。防蒸餾的對手是產業級的:Anthropic 的威脅情資報告記錄到以數千個假 Claude 帳號、工業化抽取模型輸出的組織化行為,蒸餾讓前沿能力在沒有安全防護的複本裡流動,這是把防蒸餾做成「史上最強」的現實動機,也解釋了為什麼連一般開發者都會感覺到 API 對上下文編輯變嚴格。
兩個刻意限制值得技術決策者知道。第一,AI 研發能力被壓在 Claude Opus 5.5 水準:訓練時 Anthropic 刻意限縮最能直接加速 AI 發展的研究能力,所以加速器 kernel 最佳化與大型語言模型架構改進這兩類工作,Claude Fable 5.2 與 Claude Mythos 5.2 表現約等同 Claude Opus 5.5,代理編碼、硬體開發與傳統 AI 研究不受影響。少數主題(如非標準加速器的 kernel 開發)會透明地 fallback 到Claude Opus 5。第二,防蒸餾是史上最強:針對用工業級假帳號蒸餾模型輸出的行為,官方宣稱新防護把蒸餾者可收割的資料減少 90% 到 99%,且 preserved thinking 機制擴及所有帳號,開發者若沿用舊整合方式,改動先前上下文可能開始收到 400 錯誤,需改用上下文壓縮或編輯機制。
Mythos 家族時間線:從 Mythos Preview 到 5.2
Mythos 是 2026 年才出現的產品線,從 4 月到 11 月經歷了外部審查、出口管制與制度改革,理解這條時間線能解釋今天申請制度的形狀:
| 日期 | 事件 | 對使用者的意義 |
|---|---|---|
| 2026-04-07 | Mythos Preview 登場,不對一般大眾發布 | 僅 Project Glasswing 夥伴可用;美國媒體稱之資安領域的「清算時刻」 |
| 2026-04 下旬 | 國際媒體報導引發各國央行與情報機構緊急回應 | Mythos 從產品新聞升級成國安議題 |
| 2026-06-02 | Project Glasswing 擴大到約 150 個組織、超過 15 國 | 防禦者早期接入計畫成形 |
| 2026-06-09 | Claude Mythos 5 發布 | 首個正式版,僅少數獲選夥伴可用 |
| 2026-06-12 | 美國政府要求限制外國國民存取;Anthropic 暫停 Fable 5 與 Mythos 5 | 因無法即時確認國籍,暫停範圍涵蓋所有使用者 |
| 2026-06-26 | 一批美國組織獲准恢復 Mythos 5 存取 | Mythos 採分批核准恢復 |
| 2026-06-30/07-01 | 6 月 30 日出口管制解除;7 月 1 日 Fable 5 全球恢復 | 解除限制與各模型恢復存取是不同事件 |
| 2026-09-01 | Claude Mythos 5.1 發布 | 首個「Fable 5.1 驗證組織版」,規格與價格完全相同 |
| 2026-10-06 | Cyber Verification Program 擴大為三級制 | 個人研究者首次可申請(Defense 級) |
| 2026-11-09 | Claude Mythos 5.2 發布 | 降價 20%、輸出最多快 30%、Claude Security 換引擎 |
Preview 時代的背景多數來自媒體側記錄。中文維基百科的 Claude Mythos 條目整理了當時的報導:Glasswing 首批夥伴包含亞馬遜、蘋果、微軟、Google、輝達、博通、CrowdStrike、摩根大通與高盛。Mythos Preview 曾找出一個存在 27 年的 OpenBSD 漏洞、一個被自動化測試跑過五百萬次都沒抓到的 FFmpeg 16 年漏洞,以及一個 Linux 權限提升漏洞。商業周刊當年的整理也把「自主零日漏洞偵測」列為 Mythos 的核心能力,但要提醒:那篇是 2026 年 4 月 Mythos Preview 時代的內容,文中「目前對外釋出為 Mythos Preview」與預覽期價格都已過時,引用其背景可以,所有規格與價格請以官方 5.2 文件為準。Preview 的正式發布日期以官方 Glasswing 頁面列出的 2026 年 4 月 7 日為準。
這條時間線對採購決策有兩層實際意義。供應穩定性:依官方恢復服務公告,6 月 12 日的限制曾造成全面暫停,6 月 30 日管制解除後,Fable 5 於 7 月 1 日全球恢復;Mythos 則在 6 月 26 日先為一批美國組織恢復。這次事件顯示單一模型可能出現供應中斷,重要流程要有替代模型與退場方案。制度方向:從 4 月到 11 月,由少數受邀夥伴走向分級申請、個人可申請、價格連兩代下調,申請制度與費率已有多次調整,但未來是否擴大開放、如何定價,仍須以後續公告為準。
三個熱門傳聞查證:GLM 5.2、第三方比較與 Anthropic IPO 時程
傳聞一:「GLM 5.2 打敗 Claude」到底比了什麼
「claude mythos vs glm 5.2」已經出現在 Google 搜尋建議裡,源頭多半是資安公司 Semgrep 在 2026 年 6 月 22 日發表、標題就叫「我們家有 Mythos 了:GLM 5.2 在我們的資安基準打敗 Claude」的基準報告。先把事實攤開:GLM 5.2 是智譜(Zhipu AI,Z.ai)的開放權重模型,以 MIT 授權公開權重,官方模型卡列出 MIT 授權與 1M 上下文。Semgrep 用自家 IDOR(不安全直接物件參照)偵測資料集測試,GLM 5.2 拿 39% F1,每找到一個漏洞的測試成本約 0.17 美元,仍落後 Semgrep 自家管線的 53% 到 61%。報告正文與表格列出的 Claude Code 分數不一致,不宜引用單一數字判定勝負。
引用這個結果前有三個必須講清楚的限制。第一,這是廠商自辦基準:Semgrep 是賣資安掃描產品的公司,IDOR 資料集、提示詞與評分都由 Semgrep 自己設計,官方沒有第三方複驗。第二,對照組不是 Claude Mythos 5.2:報告發表在 2026 年 6 月,受測的 Claude 是 Claude Code 與 Claude Opus 4.8 這一代公開版,Claude Mythos 5.2 五個月後才發布,「打敗 Claude」指的是當時的公開版 Claude,把標題直接推論成「GLM 5.2 贏過 Mythos 5.2」目前沒有證據基礎。第三,開放權重的真實優勢在別的地方:權重可下載、可自架、可微調,對不能把程式碼送上雲端的敏感環境是硬需求,Semgrep 自己也提醒 open-weight 不等於 open source,訓練資料與完整管線並未公開。這份結果可作為特定漏洞偵測流程的參考,不能外推成所有資安任務的能力排名。要就此宣判 Mythos 級的資安王座易主,證據不存在。成本面 Semgrep 也給了數字:GLM 5.2 每找到一個漏洞約 0.17 美元,報告引述的模型定價約是同級前沿模型的六分之一,每漏洞成本不能直接換成總持有成本;自架還須計算硬體、維運與人力,並以自己的任務測量。想看 GLM 系列的背景,可參考站上的GLM 5.3 完整介紹。
傳聞二:第三方比較頁的數字怎麼讀
搜尋「Claude Mythos 5.2」會撞上llm-stats.com 的比較頁,這類頁面的數字要帶著方法學意識讀。該頁寫 Claude Mythos 5.1 以 44.1 對 33.8 領先 GPT-5.2 Codex 的綜合分數,GPT-5.2 Codex 的 blended 價格約便宜 4.2 倍(每百萬輸入 1.75 美元對 10 美元、輸出 14 美元對 50 美元),上下文是 1M 對 400K。但同一頁也自己標明「找不到共同基準資料集」:兩個模型在不同測試套件上受測,綜合分數是把不同來源的索引混在一起算的。價格差距是真實可用的資訊,能力高下則只能當粗略參考。而且頁面資料是 Claude Mythos 5.1(2026 年 9 月)的,還沒反映 5.2 的降價與分數。若要挑 OpenAI 側的編碼模型來對照,站上的GPT-6 Sol與OpenAI Codex兩篇有完整介紹。官方表列 CyScenarioBench 上 GPT-6 Cyber 的 61%,但各家題目不同,不能直接據此判定模型高下。
傳聞三:Anthropic IPO 時程是媒體推測,官方未證實
「趕在 IPO 前發布」是這次台灣財經媒體最愛的角度,但要分清楚哪些是事實、哪些是傳聞。事實是 Claude Fable 5.2 與 Claude Mythos 5.2 於 2026 年 11 月 9 日發布並降價。傳聞是時程與估值:BigGo 財經引述金融時報報導,Anthropic 目標在 11 月 26 日感恩節前完成首次公開募股,市場預期募資 800 億至 1,000 億美元、估值 1.25 兆至 1.75 兆美元,低於華爾街原設定的約 2 兆美元。Yahoo Finance 的報導同樣以「IPO 將近」為框架,並提醒 AI 股震盪可能讓掛牌延後。這些數字全部來自「知情人士」向媒體的透露,Anthropic 官方沒有證實任何 IPO 時程、募資規模或估值,本文一律標為傳聞處理。順帶一提,搜尋建議裡還出現過「claude mythos 5.1a 4.7t a602b mxfp8」這類參數規格字串,官方文件與系統卡從未出現此型號,屬於社群流傳的規格流言,本文不採用。
選用建議:誰該申請 Claude Mythos 5.2、誰用 Fable 5.2 就好
把整篇收斂成一張決策清單,先分「該申請」與「不必申請」兩種情況:
- 該申請 Cyber Verification Program:組織的防禦型資安工作正被分類器擋下,例如事件應變、惡意軟體分析、漏洞驗證與自家程式碼庫的深度稽核。
- 該申請 Cyber Verification Program:紅隊或滲透測試公司,且所有工作都在客戶書面授權範圍內;個人研究者從 Defense 級就能申請。
- 該申請 Life Sciences Verification Program:生物醫學研究需要 Claude Fable 5.2 防護會擋下的進階能力。
- 用 Claude Fable 5.2 就好:一般編碼、長文件分析、圖表判讀、艱難除錯與大規模重構;分類器在資安與生物之外的任務不會介入,規格與價格相同,也有預設 30 天資料保留要求;有 ZDR 需求仍須確認 Anthropic 的授權與 EFS 安排。
- 維持 Claude Opus 5.5:日常編碼與知識工作的官方建議起點,需要更強再往上,輕快任務往下用 Claude Sonnet 5.5 或 Claude Haiku 5.5 分流。
比較 Haiku 5.5 與 Sonnet 5.5 時,要品質選 Claude Sonnet 5.5、要速度與成本選 Claude Haiku 5.5。同樣的邏輯往上套用到 Fable 與 Mythos 的取捨:先問任務會不會踩到防護,再問錢花得值不值。
導入順序上,給三個可執行的下一步。第一,資安需求先確認資格與資料保留:以組織名義在 Verification Portal 送出單一申請,聚焦防禦工作描述,同時讓法務看過 30 天保留條款與 ZDR 過渡安排。第二,技術端在切換 model ID 前跑兩個檢查:用 prefix check 的偵測流程確認程式沒有編輯舊對話,並在自己的任務上重跑一輪 effort 對成本與延遲的掃描。第三,還在評估的團隊可以先開 Claude Enterprise 用 Claude Security 掃一輪自家程式碼庫,用實際產出判斷值不值得走完整申請。互動式開發想吃到 fast mode,可以從Claude Code 的模型選單直接切換。剛接觸 Claude 生態系的讀者,建議先從Claude 完整入門教學建立整體輪廓,再回來對照本篇的進階內容。
Claude Mythos 5.2 常見問題
Claude Mythos 5.2 和 Claude Fable 5.2 有什麼不同?
兩者是同一個底層模型的兩個版本,規格與價格完全相同,差別在防護與存取資格。Claude Fable 5.2 內建網路安全與生物防護、對所有使用者開放;Claude Mythos 5.2 提供給通過 Anthropic 驗證計畫的使用者,依核准資格放寬部分防護,仍受計畫等級與使用政策限制。官方 FAQ 的理由是這些能力若遭誤用可用於網路攻擊與危險武器,所以廣泛開放的版本必須帶防護。
個人開發者可以申請 Claude Mythos 5.2 嗎?
可以,但只能申請 Cyber Verification Program 的 Defense Access 級,而且要使用付費方案。這一級開放給有漏洞通報紀錄的獨立研究者與開源專案維護者,開放的工作以防禦為主,例如事件應變、惡意軟體分析與漏洞驗證,攻擊向的測試仍會被擋。Red Team 與 Specialized 兩級只限組織申請,Pro 方案訂閱者也要注意 Mythos 只能用 usage credits 扣款。
Claude Mythos 5.2 的 API 價格是多少?fast mode 多少?
標準價是每百萬輸入 token 8 美元、每百萬輸出 token 40 美元,比 Claude Mythos 5.1 的 10 與 50 美元降 20%。fast mode 是 16 與 80 美元,輸出速度最多 2.5 倍,只給驗證計畫組織。快取寫入 5 分鐘 10 美元、1 小時 16 美元,快取讀取 0.20 美元,Batch API 輸入輸出半價。以試算假設匯率 1 美元兌 32.5 元換算,標準輸入每百萬 token 約 260 元新台幣;長對話與重複掃描先善用快取,命中快取部分的輸入單價為標準輸入單價的 2.5%,其他輸入與輸出另計。
Cyber Verification Program 申請多久會審完?沒過怎麼辦?
官方目前的目標是 Defense Access 約兩天、Red Team Access 約兩週,後者因申請量大可能更久;Specialized Access 沒有固定時程。一個組織填一份申請,依審核結果分級。雲端平台上的 Mythos 存取會比核准晚約五個工作天,審查與雲端開通是不同階段;核准後仍須完成管理員指派。未核准常見原因包括工作不符合該等級範圍、身分難以驗證與所在地法律環境風險;可補強資格證據,七天後重新申請。Enterprise 客戶也可評估 Claude Security 的封裝掃描流程。
不申請驗證,做資安工作會被擋嗎?
會擋一部分,不是全部。用 Claude Fable 5.2 做安全程式碼審查、威脅建模、修補已知問題、在自家原始碼找漏洞與告警分流都不受影響;滲透測試、漏洞利用產生、二進位分析與多數研究生物學任務會被分類器攔下,攔下時改由 Claude Opus 4.8(資安)或 Claude Opus 5(生物)回應。官方數字是 Fable 5.2 的誤擋比 Fable 5.1 減少約 55%,資安類約 60%、生物類約 40%。
Claude Mythos 5.2 會保留我的資料 30 天嗎?可以談零資料保留嗎?
會,Claude Mythos 5.2 屬於 Covered Models,預設要求 30 天資料保留供安全監控,在 Claude API 上沒開保留的組織請求會直接回 400 錯誤。零資料保留需要 Anthropic 明確授權;在 Enterprise Frontier Safeguards 上線前,已有 ZDR 安排的合格 CVP 客戶可以保留 ZDR。EFS 把安全監控搬到客戶自家基礎設施執行,已在 Bridgewater、Salesforce 與 Stripe 私人測試,是未來 ZDR 相容的正解;CVP 申請本身也要求資料保留,對資料出境敏感的產業要先把這條納入法務評估。
Claude Mythos 5.2 比 GLM 5.2 強嗎?
沒有可直接比較的證據。流傳的「GLM 5.2 打敗 Claude」來自 Semgrep 自辦的 IDOR 偵測基準,受測的 Claude 是 Claude Code 與 Claude Opus 4.8 這一代,不是 Claude Mythos 5.2,而且報告本身是廠商自評。GLM 5.2 的真實優勢是開放權重、可自架、成本低,適合不能上雲的敏感環境。要判斷誰適合你的工作,用自家程式碼庫各跑一輪,比引用任何單一基準都可靠。
從 Claude Mythos 5.1 換到 5.2,程式要改什麼?
四個地方最常壞:prefix check 對每個帳號強制生效,改過 system、tools 或舊訊息再送回 thinking block 會回 400,Amazon Bedrock 上 5.1 能過的請求 5.2 會拒;thinking block 只有單向相容,5.2 讀得懂 5.1 的、反向會被丟掉;advisor tool 的 5.2 executor 只接受 5.2 系的 advisor;舊電腦操作工具 computer_20251124 要換成 computer_toolset_20260801。遷移前重跑 effort 掃描並重算成本與延遲基線,xhigh 以上會開 subagent 自我審查,成本可能明顯上升。
討論與提問