
本篇內容
CLAUDE.md 是 Claude Code 的 Markdown 專案說明檔,用來保存建置與測試指令、程式碼慣例、工作流程及不能碰的範圍。Claude Code 在新對話開始時載入適用的檔案,讓你不用每次重新交代同一套專案規則。專案共用的內容通常放在 repo 根目錄的 CLAUDE.md;跨專案的個人偏好放在 ~/.claude/CLAUDE.md。
第一次設定可以在專案目錄執行 /init 建立起始檔,再補上 Claude 無法從程式碼推導的規則,接著用 /context 確認載入。以下載入方式與版本條件依 2026 年 10 月 5 日的官方文件整理;如果專案已經有 AGENTS.md,先看兩種規則檔的讀取條件,再決定是否新增檔案。
CLAUDE.md 是你寫、模型每次對話自動讀的規則檔;Claude 依你的糾正自己累積的 auto memory 是另一套系統。位置有四層:企業管理層、使用者層
~/.claude/CLAUDE.md、專案層./CLAUDE.md、專案個人層./CLAUDE.local.md。它的內容會成為模型 context,沒有嚴格遵守的保證。需要在工具執行前阻擋的動作,應設定適用的 hooks、權限與 sandbox;文字規則則寫得具體、可驗證,每份檔案以 200 行以內為目標。
維護節奏比寫出完美初稿重要:每次糾正之後讓 Claude 把教訓補進檔案,定期修剪矛盾與過時內容,讓這個檔案跟程式碼一起進版控、一起長。
CLAUDE.md 是什麼?跟 prompt、記憶功能的界線
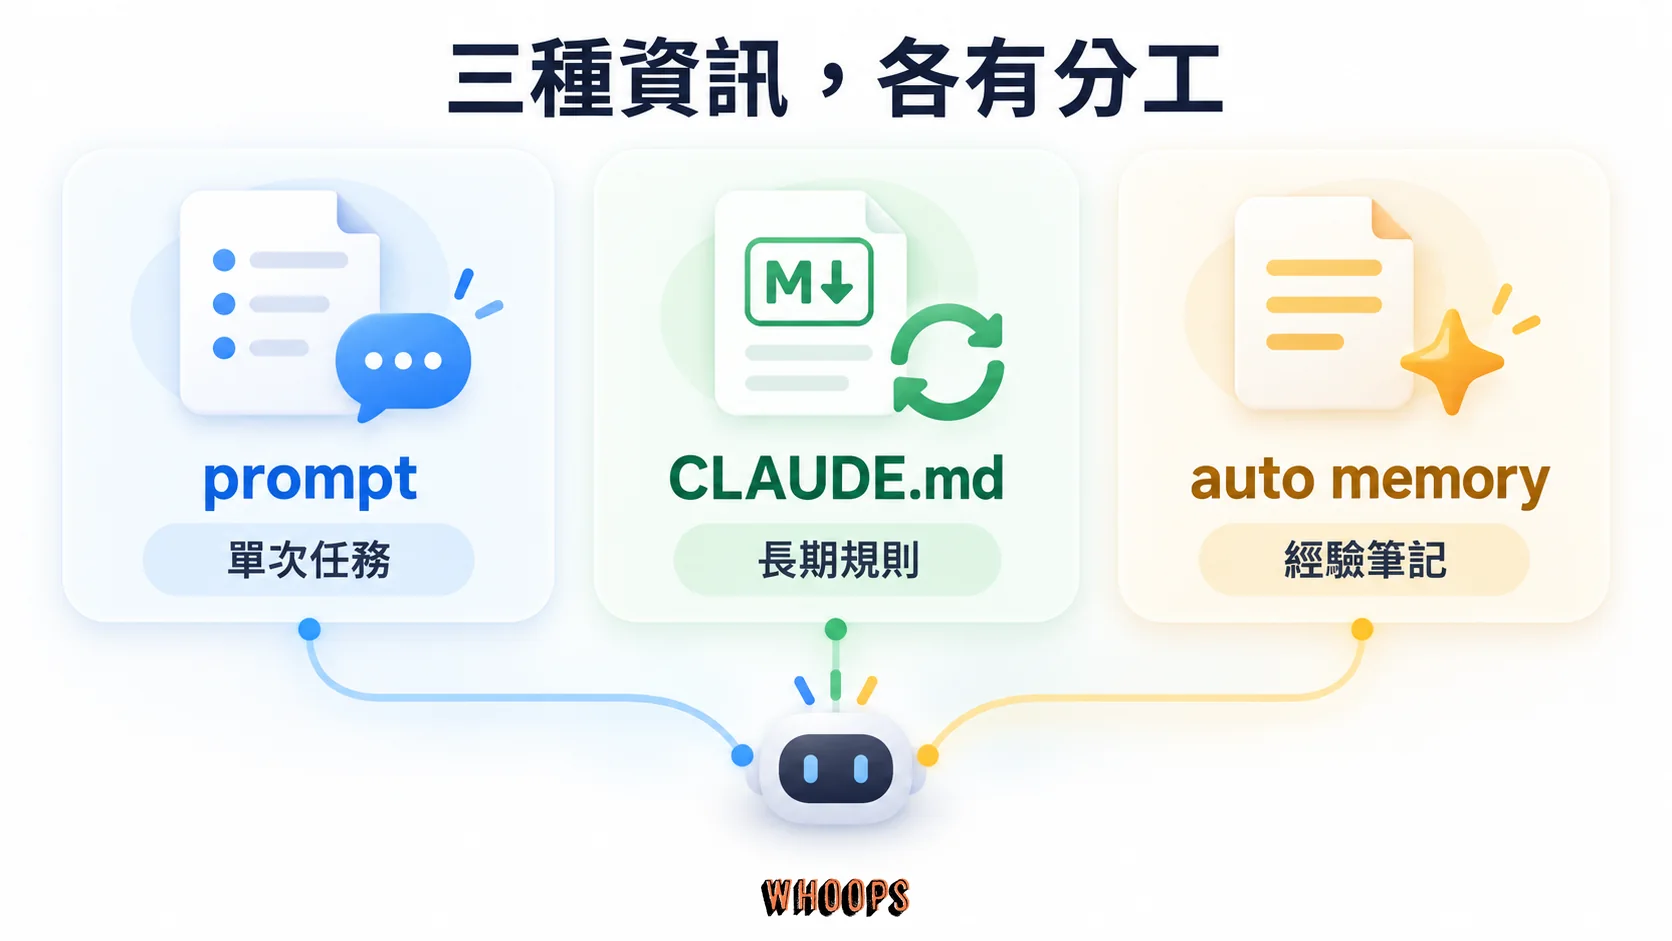
官方把 CLAUDE.md 定義為你用 Markdown 寫給 Claude 的持久指示。官方記憶文件區分兩套機制:CLAUDE.md 保存你指定的規則,auto memory 保存 Claude 依糾正與偏好寫下的筆記。適用的 CLAUDE.md 會載入新對話,auto memory 則載入索引開頭,詳細筆記按需讀取。
它跟 prompt 的分工可以用一句話記住:prompt 說明這一次要做什麼,CLAUDE.md 保存跨任務穩定的規則與禁區。你在 prompt 裡寫「幫這個模組補測試」,在 CLAUDE.md 裡寫「測試跑 vitest,只跑單一檔案,不要跑整個套件」。前者每次任務都要重新講,後者寫一次就對每次對話生效。判斷一段話該放哪邊的標準也一樣:只跟眼前這個任務有關的放 prompt,換個任務仍然成立的才放 CLAUDE.md。
這種檔案對代理工具特別重要,因為 Claude Code 不只回答問題,它會讀你的檔案、執行指令、修改程式碼,行為空間比聊天機器人大得多,context 裡的說明就是它理解工作邊界的主要依據。如果你還不熟悉這類工具的運作方式,可以先看過AI Agent 的運作邏輯,再回來談規則檔會更順。
有一條分界先講清楚,它決定後面所有寫法:CLAUDE.md 不是設定檔。官方文件明講,它的內容是在系統提示之後、以使用者訊息的形式注入 context,Claude 會閱讀並盡量遵循,但沒有嚴格遵守的保證,指令越模糊或互相矛盾,遵循率就越低。如果你要的是「無論模型怎麼想都必須擋下某個動作」,正確的工具是 PreToolUse hook 這種強制層,不是在說明檔裡加重語氣。理解這一點,才不會把 CLAUDE.md 用錯地方,也不會在它勸不住模型的時候誤以為檔案壞了。
CLAUDE.md 位置在哪?四個層級與載入規則
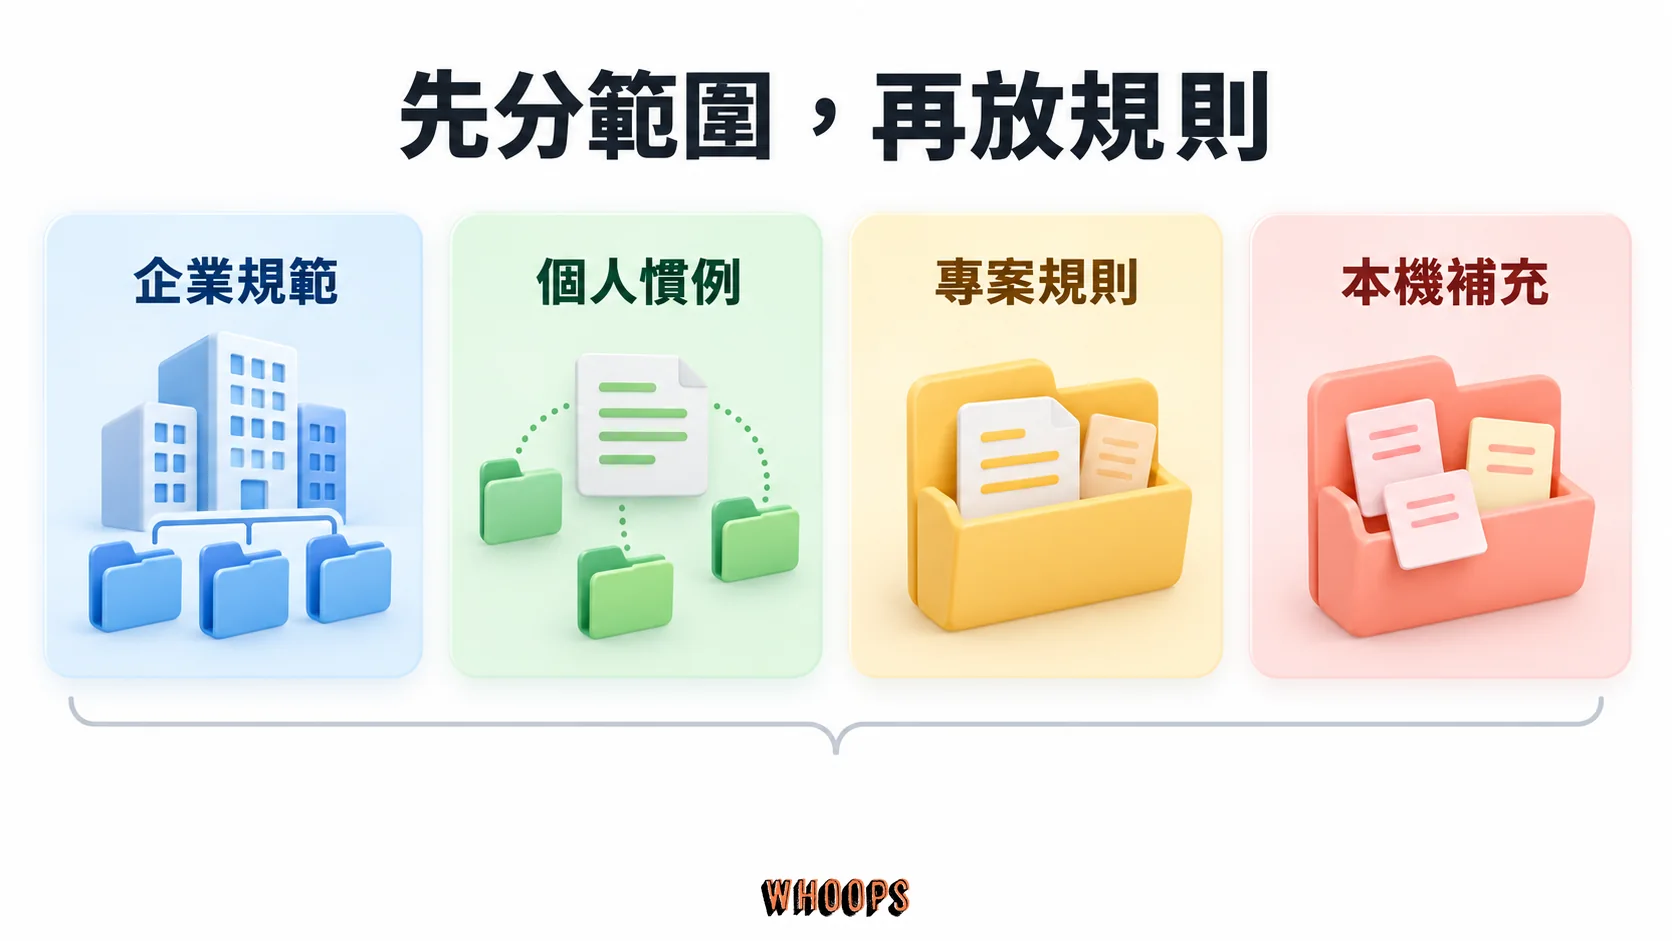
CLAUDE.md 不是丟在任何資料夾都會生效,官方定義了四個層級,從整個組織到只有你自己,各自對應不同的檔案位置與分享範圍。大多數人只會用到中間兩層,但把四層一起看,才知道一條規則該放哪一層。
| 層級 | 檔案位置 | 影響範圍 | 適合放的內容 |
|---|---|---|---|
| 企業管理層 | /Library/Application Support/ClaudeCode/CLAUDE.md(macOS)、/etc/claude-code/CLAUDE.md(Linux 與 WSL)、C:\Program Files\ClaudeCode\CLAUDE.md(Windows) | 這台機器上所有使用者 | 資安政策、合規要求、組織級編碼標準 |
| 使用者層 | ~/.claude/CLAUDE.md | 你自己的所有專案 | 個人慣例、偏好的工具鏈、跨專案的做事風格 |
| 專案層 | ./CLAUDE.md 或 ./.claude/CLAUDE.md | 這個 repo 的所有人 | 建置與測試指令、程式碼慣例、架構決策、地雷清單 |
| 專案個人層 | ./CLAUDE.local.md | 只有你、只在這個專案 | 沙盒網址、本機測試資料路徑,官方建議加進 .gitignore |
載入的範圍比多數人想像的寬:Claude Code 會從你啟動的工作目錄往上,把沿途每一層目錄的 CLAUDE.md 和 CLAUDE.local.md 全部找出來載入。你在 foo/bar/ 啟動,它就載 foo/bar/CLAUDE.md、foo/CLAUDE.md,一路到根目錄為止。所有發現的檔案是串接合併進 context,不是互相覆蓋,越靠近工作目錄的檔案越晚讀;同一層目錄裡,CLAUDE.local.md 會接在 CLAUDE.md 之後,也就是說你個人的補充永遠是那一層的收尾。
子目錄的 CLAUDE.md 則是另一種邏輯:它們不在啟動時載入,而是當 Claude 讀到該子目錄裡的檔案時,才把該目錄的說明檔一起拉進來。這對 monorepo 很有用,不同團隊可以在自己的目錄放自己的規則,只要沒碰到那個區塊就不佔 context。
要確認檔案真的被載入,在 session 裡執行 /context,看 Memory files 清單有沒有它;缺少時先檢查檔名、所在位置與排除設定。清單裡出現你沒預期的檔案也要留意,例如上層目錄殘留的舊規則可能仍參與對話。/init 則會掃描專案,產生包含建置指令、測試方式與專案慣例的起始 CLAUDE.md;檔案已經存在時,它會提出改善建議。生成後,再補上模型無法從程式碼發現的專案知識。
一個實用的小知識:CLAUDE.md 裡的 HTML 註解,載入時會被剝掉,不佔 context;寫在程式碼區塊裡的註解則會保留。所以留給人類維護者看的備註可以用註解形式寫,模型不需要讀到的解釋就不必花它的額度。
四層怎麼選,判斷的問句只有一個:這條規則換了專案還成立嗎?成立就放使用者層,例如「commit 訊息用中文」「測試只跑跟改動相關的」;只跟這個 repo 有關就放專案層,例如建置指令與地雷;跟這個 repo 有關但不該給隊友的就放 CLAUDE.local.md。要留意的反面是:使用者層與專案層不是覆蓋關係而是並存,兩邊寫了相反的指示時,模型一樣可能任意挑一邊,個人偏好與團隊規範要主動保持一致,別讓檔案層級替你製造矛盾。
CLAUDE.md 怎麼寫才會被遵守:把交代變成可驗證的指令
具體與可驗證是第一原則
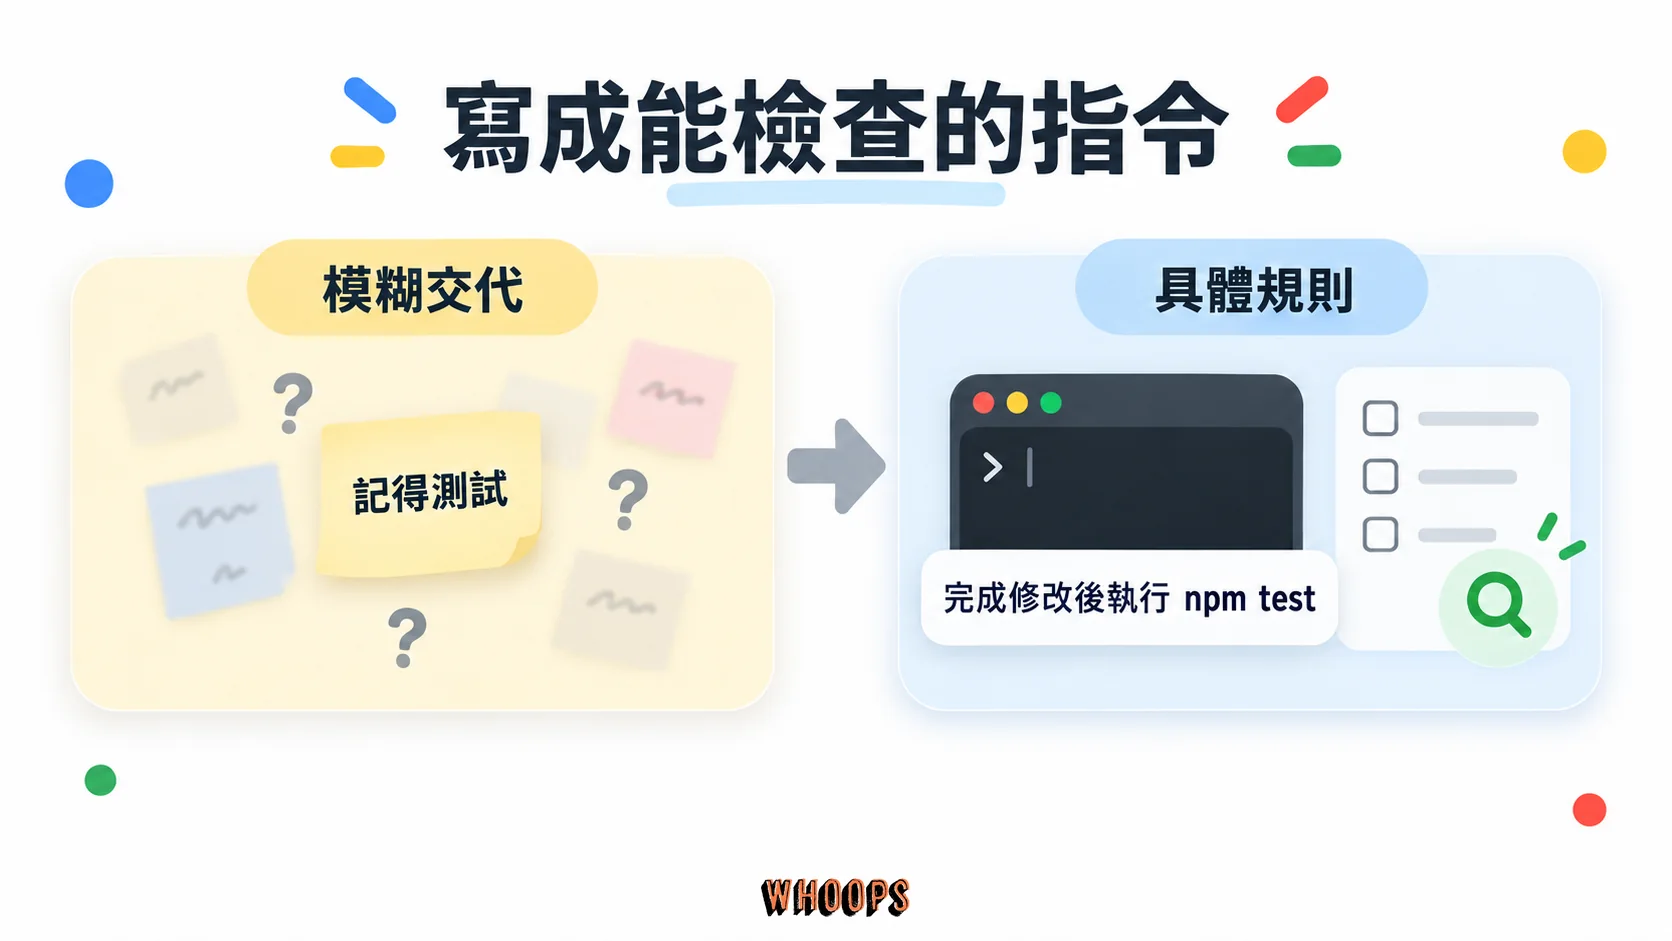
規則要寫到能確認是否做到。官方記憶文件與Claude Code 最佳實踐指南都建議用明確指令取代空泛要求,下面是可以對照的寫法。
| 模糊的寫法 | 具體的寫法 |
|---|---|
| 把程式碼格式整理好 | 縮排一律用 2 格空白 |
| 記得測試 | 完成一系列修改後執行 npm test |
| 檔案放整齊 | API 處理器一律放在 src/api/handlers/ 底下 |
背後的道理不神祕。可驗證的指令給了模型一個明確的錨點:它知道自己做完之後要拿什麼標準檢查自己,你事後也有一致的基準看它有沒有做到。模糊的指令則每次解讀都可能不同,同一個模型在不同 session 的表現就會漂移。這也是為什麼官方文件的建議是「寫得具體到可以驗證」,而不是「寫得客氣」或「寫得詳細」:詳細但不可驗證的長篇解說,遵循效果反而輸給一行能執行、能檢查的指令。
CLAUDE.md 建議多長?200 行目標與 4 MiB 限制
官方建議每份 CLAUDE.md 以 200 行以內為目標,這是精簡建議,不是超過就截斷的行數上限。系統可整份載入不超過 4 MiB 的 CLAUDE.md,超過 4 MiB 才會略過整份檔案;過長時,啟動畫面與 /status 會警告。多份規則與匯入檔的總長度也可能觸發警告。CLAUDE.md 會占用 context,應把空間留給這次任務需要的程式碼、對話與工具輸出;用量限制與計費方式可另看Claude Code 的費用與方案。
修剪時可以問:刪掉這一行,Claude 是否還能從程式碼或既有文件做對?如果可以,就移除或改放按需讀取的文件。保留容易踩錯的細節、決策理由與不同於工具預設的慣例,避免讓真正重要的指示埋在重複說明裡。
如果同一條規則反覆被跳過,可以檢查檔案是否太長,或那條規則是否與其他指示衝突;不能只靠這個症狀判定原因。官方建議把 IMPORTANT 之類的強調留給少數必要指示,避免每行都被標成重點。要系統性修剪,Claude Code v2.1.206 起的 /doctor 可以對進版控的 CLAUDE.md 提出削減建議,優先移除模型從程式碼就能推導的內容。
該寫什麼、不該寫什麼
| 該放進 CLAUDE.md | 不要放進 CLAUDE.md |
|---|---|
| 模型猜不到的 Bash 指令 | 讀程式碼就推得出的資訊 |
| 跟預設不同的程式碼風格規則 | 模型本來就懂的語言標準慣例 |
| 測試方式與偏好的測試執行器 | 詳細的 API 文件(放文件連結) |
| 分支命名與 PR 慣例 | 經常變動的資訊 |
| 專案特有的架構決策 | 長篇解說與教學文字 |
| 開發環境的特殊設定(必要的環境變數) | 逐檔案的路徑描述 |
| 常見地雷與非直覺的行為 | 「寫出乾淨程式碼」這類自明的空話 |
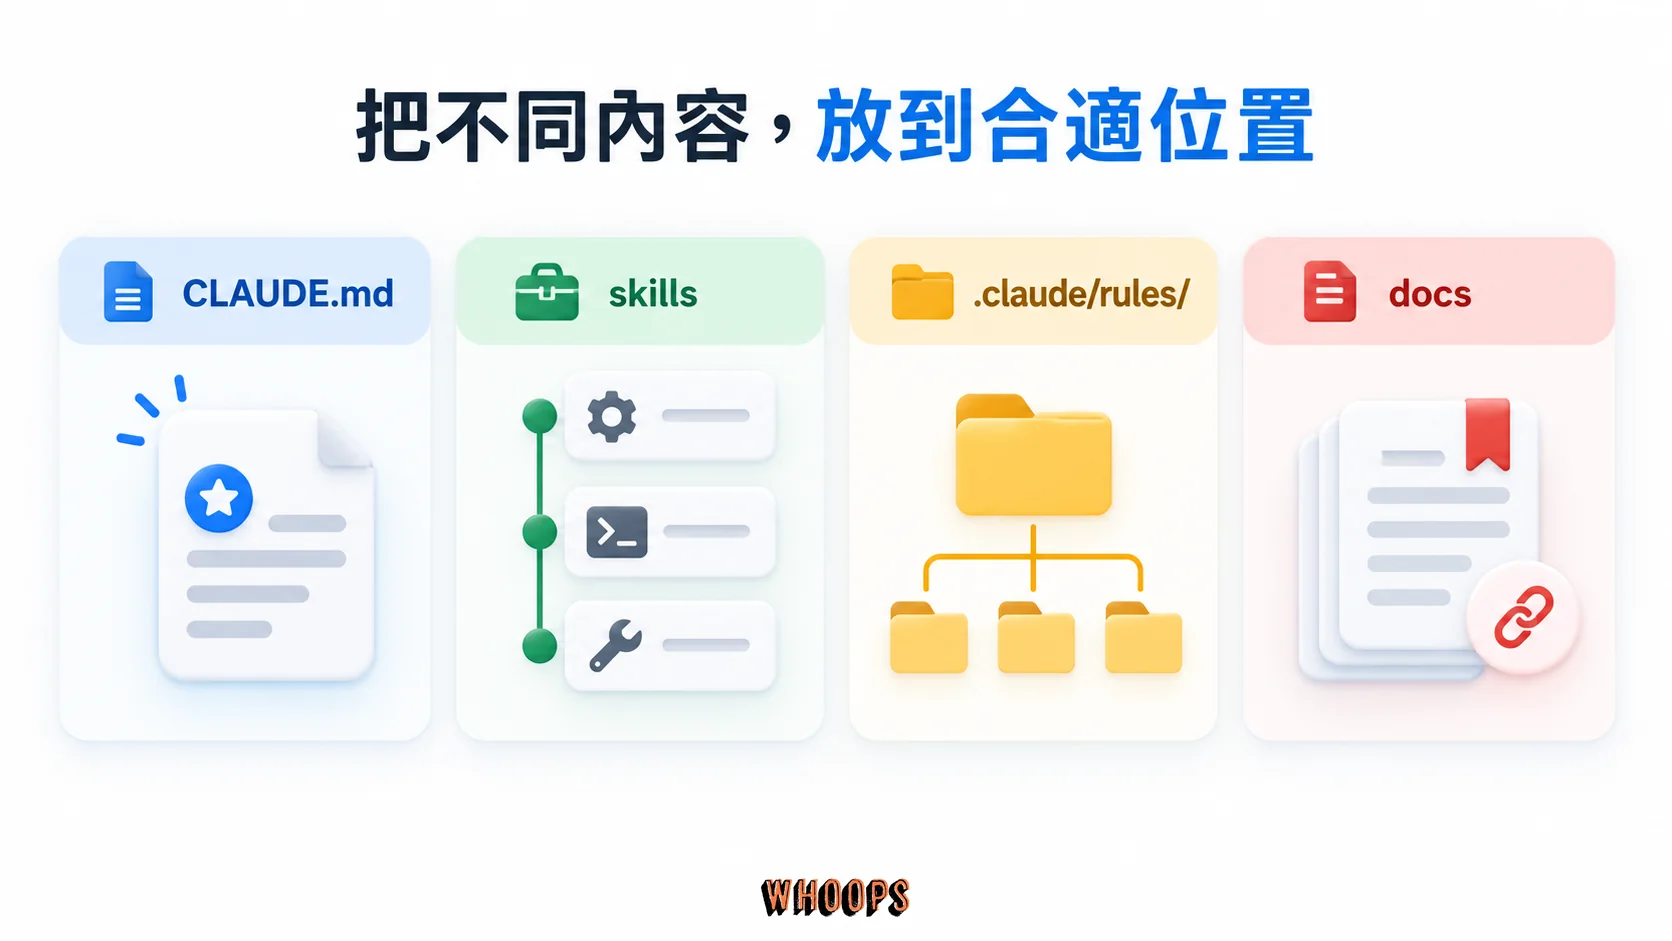
較長的程序適合搬去 skills:日常只載入 skill 名稱與說明,完整內容在啟用時進入 context,詳見skills 說明頁。只對特定檔案類型生效的規則,適合放進 .claude/rules/ 做路徑限定。兩種做法都能讓每次對話必讀的主檔保持精簡,但 skill 啟用後仍然會占用 context。
Anthropic 的 Claude Code 工程師 Thariq 在 2026 年 7 月 24 日分享,團隊針對當時的新模型移除約 80% 的 Claude Code system prompt,並整理撰寫 system prompt、skills 與 CLAUDE.md 的心得。這是他對特定模型與系統提示的經驗,不能直接解讀成所有專案都該刪掉八成規則。
We removed ~80% of the Claude Code system prompt for our newest models, this is what we've learned about writing system prompts, skills and Claude.MDs for them. https://t.co/6DZwSrZjE9
— Thariq (@trq212) July 24, 2026
矛盾、疊代與強制的分界
兩條規則衝突時,Claude 可能擇一遵循,結果也可能不穩定。定期檢查過時命令、已不存在的檔案引用與互相矛盾的要求。Claude Code v2.1.283 起提供 /doctor prompt-audit,會檢查 CLAUDE.md、CLAUDE.local.md、AGENTS.md,以及 rules、skills 等設定,提出問題與修改建議;它不會在你要求套用前直接改檔。這個功能透過內建 /claude-api skill 執行,停用該 skill 或全部 bundled skills 時不可用。
把 CLAUDE.md 當程式碼對待,是官方文件與實務共識的維護姿勢:進 git、讓團隊一起改、出了問題回來 review 它,並用「行為有沒有真的改變」當測試。Claude Code 團隊整理的 power user tips給了一個很好上手的節奏:每次 Claude 犯錯被你糾正,就用一句話叫它把這次的教訓寫進 CLAUDE.md,原文的說法是 Claude 很會為自己寫規則;他們把這個累積稱為複利式的工程,每次修正都讓之後的每一個 session 起點更高。
4/ Our team shares a single CLAUDE.md for the Claude Code repo. We check it into git.
— Boris Cherny (@bcherny) January 2, 2026
需要固定執行的檢查,可以放進對應事件的 hooks,例如檔案編輯後執行 lint;要在工具執行前拒絕動作,則使用 PreToolUse 的 deny 決策。hook 是否涵蓋需求,取決於事件、matcher 與腳本檢查內容。實際設定可看hooks 指南;要設定工具與檔案的權限邊界,站上的權限模式與 settings.json 設定範本有範例。
三個可直接複製的 CLAUDE.md 範例
範例由小到大排列,各自對應不同的階段。第一個給剛裝好 Claude Code 的頭一週,第二個照官方建議的骨架擴充,第三個展示規則型檔案在非典型專案裡的用法。直接複製去改比從空白檔案開始容易,但要記得前一節的原則:每一行都該通過「刪掉會出錯嗎」的檢查,範例裡不屬於你專案的行就刪掉。
範例一:極簡入門版
# 專案說明
- 這是一個用 Next.js 架的內容網站,文章資料放在 content/ 底下
- 套件管理器用 pnpm,不要用 npm

# 常用指令
- 安裝套件:pnpm install
- 本機啟動:pnpm dev
- 跑測試:pnpm test 檔名(只跑單一檔案,不要跑整個測試套件)

# 禁區
- content/legacy/ 是封存資料,不要修改
- commit 之後停下來等我覆核,不要自己 push
這份短範例先交代專案用途、可執行指令與禁區,讓新對話有必要的起點。沒有特殊要求的語言或框架慣例可以先省略,之後再依實際糾正補充。測試指令要換成你專案真正支援的寫法,例如先確認 test script 是否接受檔名參數。
範例二:官方建議要素版
# 專案概述
- 電商後端服務:API 在 src/api,資料層在 src/db
- 錯誤碼統一定義在 src/errors/codes.ts,新增錯誤要先登記

# 常用指令
- 安裝套件:pnpm install
- 啟動開發環境:docker compose up -d 後執行 pnpm dev
- 跑測試:pnpm test(只跑與這次改動相關的測試)
- 提交前必跑:pnpm lint 與 pnpm typecheck

# 程式碼風格
- 使用 ES module 語法,不用 CommonJS 的 require
- 匯入盡量用具名解構:import { foo } from 'bar'
- 註解寫在該行程式碼上方,不用行尾註解

# 工作流程
- 動到 src/billing/ 之前,先用 plan mode 提計畫等我核准
- 一個 commit 只做一件事,格式:feat:、fix:、chore: 開頭加摘要
- 分支從 main 拉出,用 fix/ 或 feat/ 開頭命名

# 測試
- 新增 API 端點必須附測試,放在 tests/api/
- 測試資料用 fixtures/ 的既有檔案,不打真實外部服務

# 環境
- 需要 .env.local(有範本 .env.example),缺少時啟動會直接失敗
- 本機依賴 Redis,先 docker compose up 再跑測試

# 地雷
- src/legacy/parser 是舊系統相容層,行為怪但上線中,重構前先問
- 報表的時區處理有歷史包袱,修改前先看 docs/reporting.md
這份範例沿用概述、指令、風格、流程、測試、環境與地雷等常見要素,電商專案及路徑都是示意。錯誤碼先登記、billing 目錄先提計畫、測試需要 Redis 等規則,要換成你的專案事實;官方沒有要求每份檔案一定要填滿這些欄位。
範例三:內容產線,把發布要求寫成規則
# 這個 repo 是做什麼的
- 台灣繁體中文知識站的文章產線:研究、撰稿、發布都在這裡跑

# 寫作規範
- 全文台灣用詞:資訊、影片、搜尋、網路、軟體、部落格
- 有一份固定禁用詞表(AI 常見的轉場與總結詞),命中即退回重寫
- 語氣停頓用逗號或冒號處理,不使用破折號
- 外部來源織進句子敘述,禁止任何括號歸因的形式
- 每個外部連結全文只用一次,錨點用描述性文字

# 發布防護(每次送出前必跑)
- 文章標題必須是真實中文標題,嚴禁把 URL slug 當標題送出
- 作者欄位必須設為指定帳號,送出後重新取得並驗證
- 內容結尾的 FAQ 結構化資料區塊,編輯後必須確認仍然存在
- 送出前掃描禁用詞與用詞規範,有命中先修再送

# 流程裁決
- 文章要不要發布、何時發布,依站方在這次任務的明確授權執行
- 不對排名、流量、收錄做任何保證性描述
第三個範例展示 CLAUDE.md 在內容產線的用法:寫作規範交代站方的用詞與來源格式,發布防護要求檢查標題、作者與結構化資料,流程裁決界定哪些決定需要站方授權。這份骨架參考本站的專案規則;套用到自己的網站時,應換成實際編輯標準,不必照搬禁用詞與標點限制。
三個範例共同的用法提醒:抄完的第一天它只是範本,第二週開始才是它變成你自己的檔案的時候。實際發生的糾正補進對應段落,用不到的行直接刪,讓檔案慢慢長成你專案的形狀。健康度的訊號也很好觀察:Claude 問你的問題是不是越來越少、來回修改的次數是不是在下降。如果某條規則放了一個月都沒有影響任何一次輸出,可以在下一個修剪週期檢查是否還需要保留。
「記住」會存到哪?CLAUDE.md 與 auto memory 的分工
依官方文件,對話裡要求 Claude「記住這件事」,通常是交給 auto memory 保存;要寫入團隊規則檔,就明確指定「加進 CLAUDE.md」。auto memory 需要在該 session 啟用,這兩種操作也應確認實際檔案是否更新。
| 面向 | CLAUDE.md | auto memory |
|---|---|---|
| 誰寫 | 你 | Claude 依糾正與偏好自己記 |
| 內容 | 規則與指示 | 學到的事實與模式 |
| 存放位置 | 專案或家目錄的檔案,可進版控 | 你機器上 ~/.claude/projects/ 底下的記憶目錄 |
| 生效範圍 | 專案、個人或整個組織,看你放哪層 | 單一 repo,同 repo 的 worktree 共用,不跨機器 |
| 載入方式 | 適用檔案整份載入,子目錄檔按需載入 | MEMORY.md 前 200 行或前 25 KB,先達到哪個就停;細節按需讀取 |
| 適合放 | 編碼標準、工作流程、專案架構 | 你的偏好、糾正過它的模式、程式碼推不出來的專案脈絡 |
Claude 會把對未來對話有用的資訊寫成四類筆記:你的角色與偏好、糾正及確認過的做法、進行中的工作與決策、專案外資訊的位置。預設存放在 ~/.claude/projects/<project>/memory/,同 repo 的 worktree 共用。MEMORY.md 索引在新對話只載入前 200 行或前 25 KB,以先達到的門檻為準;詳細筆記按需讀取。這個截斷規則與 CLAUDE.md 的 200 行建議不同。用 /memory 可以查看、編輯或刪除筆記,也可以開關 auto memory。
要讓一條規則進 CLAUDE.md,請直接說「把這條加進 CLAUDE.md」,或用 /memory 開檔編輯。auto memory 適合保存尚在累積的偏好與糾正;固定且需要團隊共用的規則,再整理進專案 CLAUDE.md。
兩套系統的正確關係是升級,不是二選一。auto memory 是草稿,CLAUDE.md 是你維護的規則:可以在每週或每個衝刺結束時翻一次記憶,看到重複出現的糾正,就把它升級成 CLAUDE.md 裡一條明確規則,讓它對團隊與未來的所有 session 生效。另有一個邊界情境要知道:在桌面版的 Claude Cowork session 裡,使用者層檔案中指向專案目錄外的匯入會被跳過,符號連結過去的使用者層 CLAUDE.md 也不載入,保守程度比一般終端機 session 高。
進階設定:@import、.claude/rules/ 與路徑限定規則
專案規則多到一定程度,單一檔案開始不好維護,官方給了兩個組織工具:@ 匯入語法讓 CLAUDE.md 引用其他檔案,rules 目錄讓規則照主題與路徑切分。兩者的定位不同,前者是組織檔案,後者還能省 context。
用 @ 語法匯入其他檔案
專案概述看 @README.md,可用的指令清單看 @package.json

# 其他指示
- git 工作流 @docs/git-workflow.md
- 個人偏好 @~/.claude/my-preferences.md
語法就是在檔案路徑前加 @,相對路徑以發出匯入的那份檔案為準,不是以工作目錄為準;絕對路徑也可以。被匯入的檔案可以再匯入別的檔案,最多遞迴四層。兩個細節容易踩:路徑裡有空白字元要在每個空白前加反斜線,不然路徑會在第一個空白處截斷;用反引號包住的 @ 路徑會保持字面文字、不觸發匯入,想在說明裡提到某個檔案而不引入它時很好用。
匯入檔會在啟動時展開載入,切檔有助維護,並不減少 context 用量。適合拿來跨專案共用說明、按主題組織文件;只有路徑限定等按需載入機制,才能減少啟動時載入的內容。專案層檔案裡指向工作目錄外的匯入,第一次遇到時會出現核准對話框。
用 .claude/rules/ 切主題、限定路徑
your-project/
├── .claude/
│   ├── CLAUDE.md
│   └── rules/
│       ├── code-style.md
│       ├── testing.md
│       └── security.md
把規則放進 .claude/rules/ 目錄,一個檔案一個主題,這些檔案會被自動發現。沒有設路徑條件的規則檔在啟動時載入,地位跟 .claude/CLAUDE.md 相同;真正的價值在路徑限定:在檔案開頭用 YAML frontmatter 寫 paths 欄位,規則就只在 Claude 讀寫符合條件的檔案時才載入。
---
paths:
  - "src/api/**/*.ts"
---

# API 開發規則
- 所有端點必須做輸入驗證
- 錯誤回應使用統一格式
paths 用 glob 樣式比對,可以列多組、可以用大括號展開副檔名。這套機制讓多語言專案或 monorepo 把規則放到最貼近的位置:API 的規則只在動 API 檔案時出現,前端的規則不干擾後端工作,context 只花在當下相關的規則上。個人層也有對應位置 ~/.claude/rules/,放跨專案的個人規則,載入順序在使用者規則先、專案規則後,兩邊衝突時模型一樣可能任選,維持一致才是正解。碰到大型 monorepo 想跳過別的團隊在上層放的規則,settings 裡的 claudeMdExcludes 可以按路徑排除特定檔案。
用 --add-dir 開放其他目錄時,那些目錄的 CLAUDE.md 預設不會載入。若也需要該處規則,可在啟動時設 CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1,例如 CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD=1 claude --add-dir ../shared-config。這個設定載入的是額外目錄的 CLAUDE.md、local 與 rules 檔,不會連帶啟用該目錄的 AGENTS.md。
已經有 AGENTS.md 的專案怎麼辦?
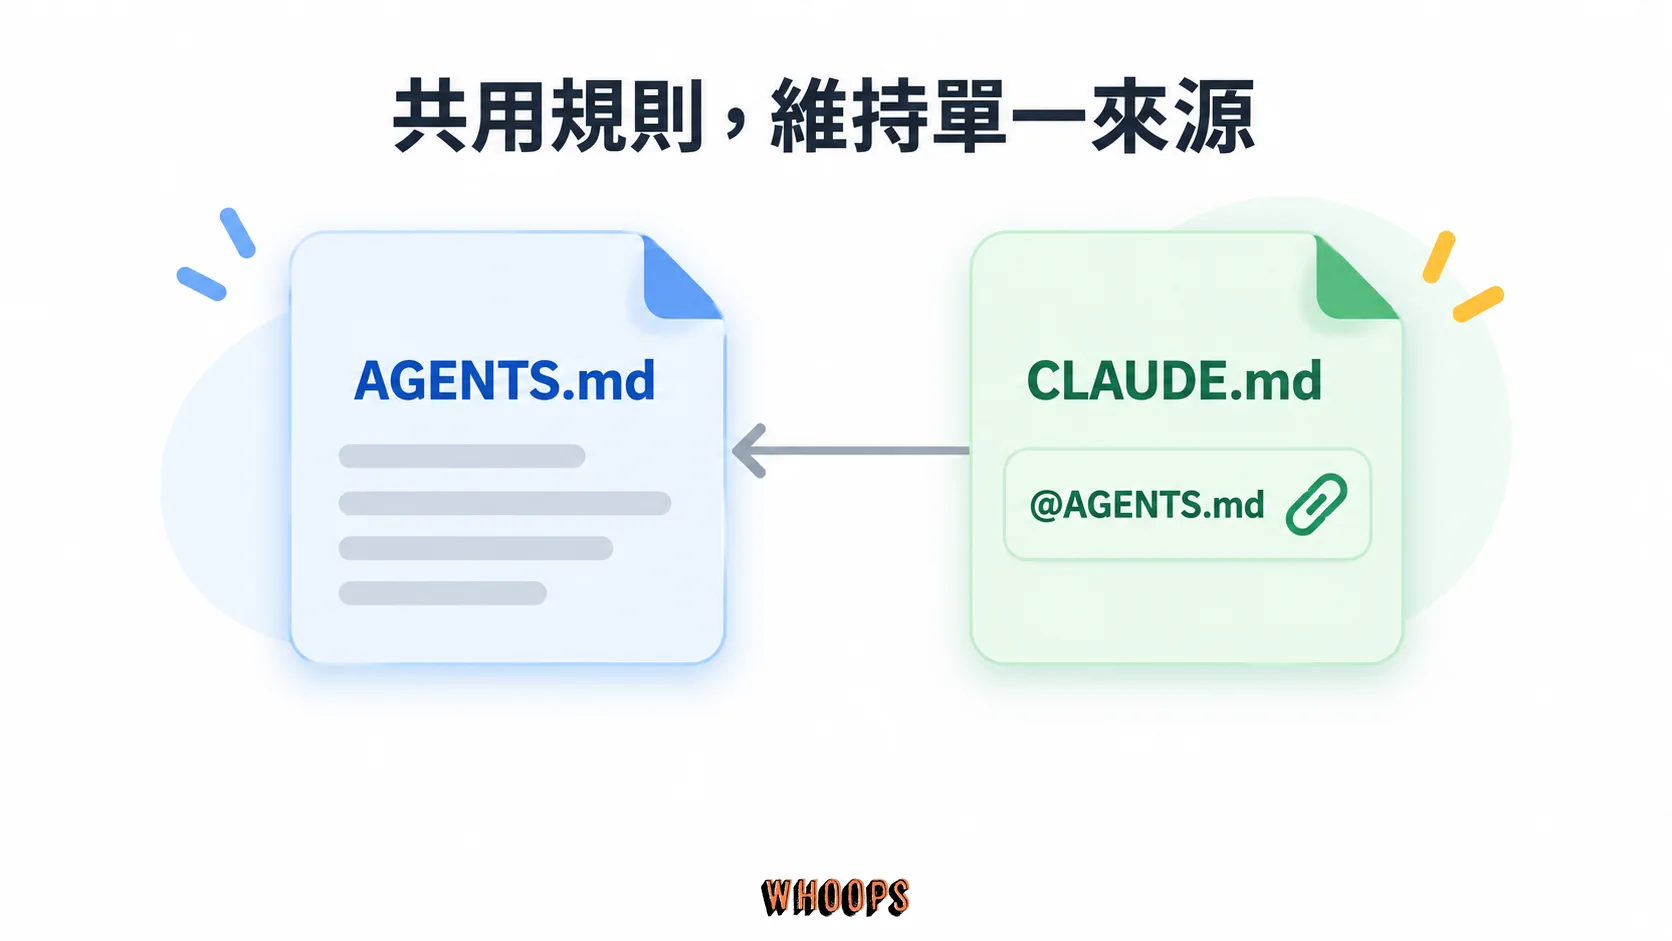
AGENTS.md 是讓 OpenAI Codex 等 coding agent 共用專案說明的開放格式,規格可看 AGENTS.md 開放格式網站。Claude Code v2.1.277 起可直接讀取;預設只有在工作目錄與上層都沒有 CLAUDE.md、.claude/CLAUDE.md 或 CLAUDE.local.md 時,才改讀 AGENTS.md。使用者層 ~/.claude/CLAUDE.md 與企業管理層不會讓這個 fallback 失效。要留意:新增 CLAUDE.local.md 也會使專案原本的 AGENTS.md 停止預設載入。
想共用同一份規則,可以建立只寫 @AGENTS.md 的 CLAUDE.md,把共用內容留在 AGENTS.md,Claude 特有的規則寫在匯入之後。也可以在 /config 的 Project instructions 選 claude-md-and-agents-md,讓兩種檔案一起載入;只讀 CLAUDE.md 的選項是 claude-md。若沒有看到這個設定,檢查版本與內建 agents-md plugin 是否啟用;v2.1.281 之前的部分 Bedrock 或停用 telemetry 情境也不支援直接讀取。工具如何分工可對照Codex 與 Claude Code 的定位差異。
已經在別套工具寫過規則的專案,搬家有現成路徑。跑 /init 時,Claude 會讀 Cursor 的 .cursorrules 與 .cursor/rules/、Copilot 的 copilot-instructions.md,把仍適用的部分併進生成的 CLAUDE.md;新版的 /import 指令更進一步,能把其他 coding agent 的設定整包帶過來,連 MCP 伺服器、指令與 subagent 一起搬。搬完後照老方法用 /context 驗證,確認新檔案真的在載入清單裡,再開始修剪。
從 GitHub 找資源:官方儲存庫與演進紀錄
Anthropic 的 claude-code 公開儲存庫提供 README、插件、issue 與版本更新紀錄。公開儲存庫不代表 Claude Code 本體是開源軟體,該 repo 的 LICENSE 仍列明 Anthropic 保留權利並適用商業條款。遇到問題可在 session 使用 /bug 回報,或到 GitHub 建 issue;送出前檢查報告內容與分享範圍。
更值得定期翻的是CHANGELOG,它是看 CLAUDE.md 相關機制怎麼一路長出來的最快路徑:AGENTS.md 原生支援、prompt-audit 健檢、外部匯入的核准對話框、HTML 註解剝除、超大檔案的處理,都是在一個個版本裡落地的。Claude Code 的更新節奏快,很多「以前可以現在不行」或「以前不行現在可以」的答案就在更新紀錄裡,升級前花三分鐘掃一輪,比出事後回頭猜原因省時間。
在 GitHub 搜尋 CLAUDE.md,可以參考實際專案如何寫規則,但要先看授權與更新日期,並以當下官方文件確認載入方式。企業也可以把行為指引寫入 managed-settings.json 的 claudeMd 欄位,套用到機器上各個 repo 的 session;只有 managed 或 policy 設定會採用,使用者、專案及 local settings 裡的同名欄位不生效。它無法被 claudeMdExcludes 排除,但內容依然是模型指引;工具阻擋等強制控制要使用 managed permissions 或 sandbox。
I'm Boris and I created Claude Code. Lots of people have asked how I use Claude Code, so I wanted to show off my setup a bit.
— Boris Cherny (@bcherny) January 2, 2026
My setup might be surprisingly vanilla! Claude Code works great out of the box, so I personally don't customize it much. There is no one correct way to…
真實案例:一條內容產線的 CLAUDE.md
本站的內容產線把關鍵字研究、撰稿、檢查與 WordPress 發布流程寫進專案規則。CLAUDE.md 保存需要反覆遵守的要求,操作程序與可執行檢查則放在文件及腳本裡;工具的安裝與基本操作可看Claude Code 的完整教學。
檔案裡的規則可以分成三類。發布防護是送出前必須執行的檢查:文章標題必須是真實中文標題、作者欄位必須設成指定帳號並在送出後重新驗證、文尾的 FAQ 結構化資料區塊在每次內容編輯後必須確認還在。這幾條不是事前的想像,標題那條來自一次誤送曾把十六篇文章的標題蓋成網址代稱的事故,結構化資料那條來自內容更新會靜默刪掉文尾區塊的坑。寫作規範與流程裁決構成其餘兩類:前者定義用詞、禁用清單與來源引用方式,後者畫出哪些決定留給人、哪些可以自動執行。
為什麼寫進檔案而不是口頭交代?口頭指示隨 session 消失,換一個對話、換一個協作者、換成三個月後的你自己,同一個坑就要再踩一次。寫進專案 CLAUDE.md 的規則每次對話自動載入,等於把「上一次的教訓」變成「每一次的起點」。效果邊界也要誠實講:規則檔降低的是同類錯誤的復發率,不是歸零的保證,模型仍然可能在長檔案裡漏掉某一條;真正不可接受的破壞,要用 hooks 與權限這種強制層去擋。說明檔負責讓模型知道,強制層負責讓它被迫,兩層各司其職。
CLAUDE.md 的讀者是操作專案的 coding agent;llms.txt 則是提供網站內容與文件導覽的提案格式。兩者的用途與載入機制不同,部署 llms.txt 不等於所有 AI 搜尋服務會讀取,也不保證引用。網站端的配置可看llms.txt 的部署教學;需要把 Claude 放進內容工作流程,可看Claude SEO 的關鍵字研究與內容更新方法。
規則被忽略時,依序檢查這五件事
寫了規則卻沒被遵守,可以依序檢查載入狀態、長度、矛盾、指令的具體程度與強制控制需求。
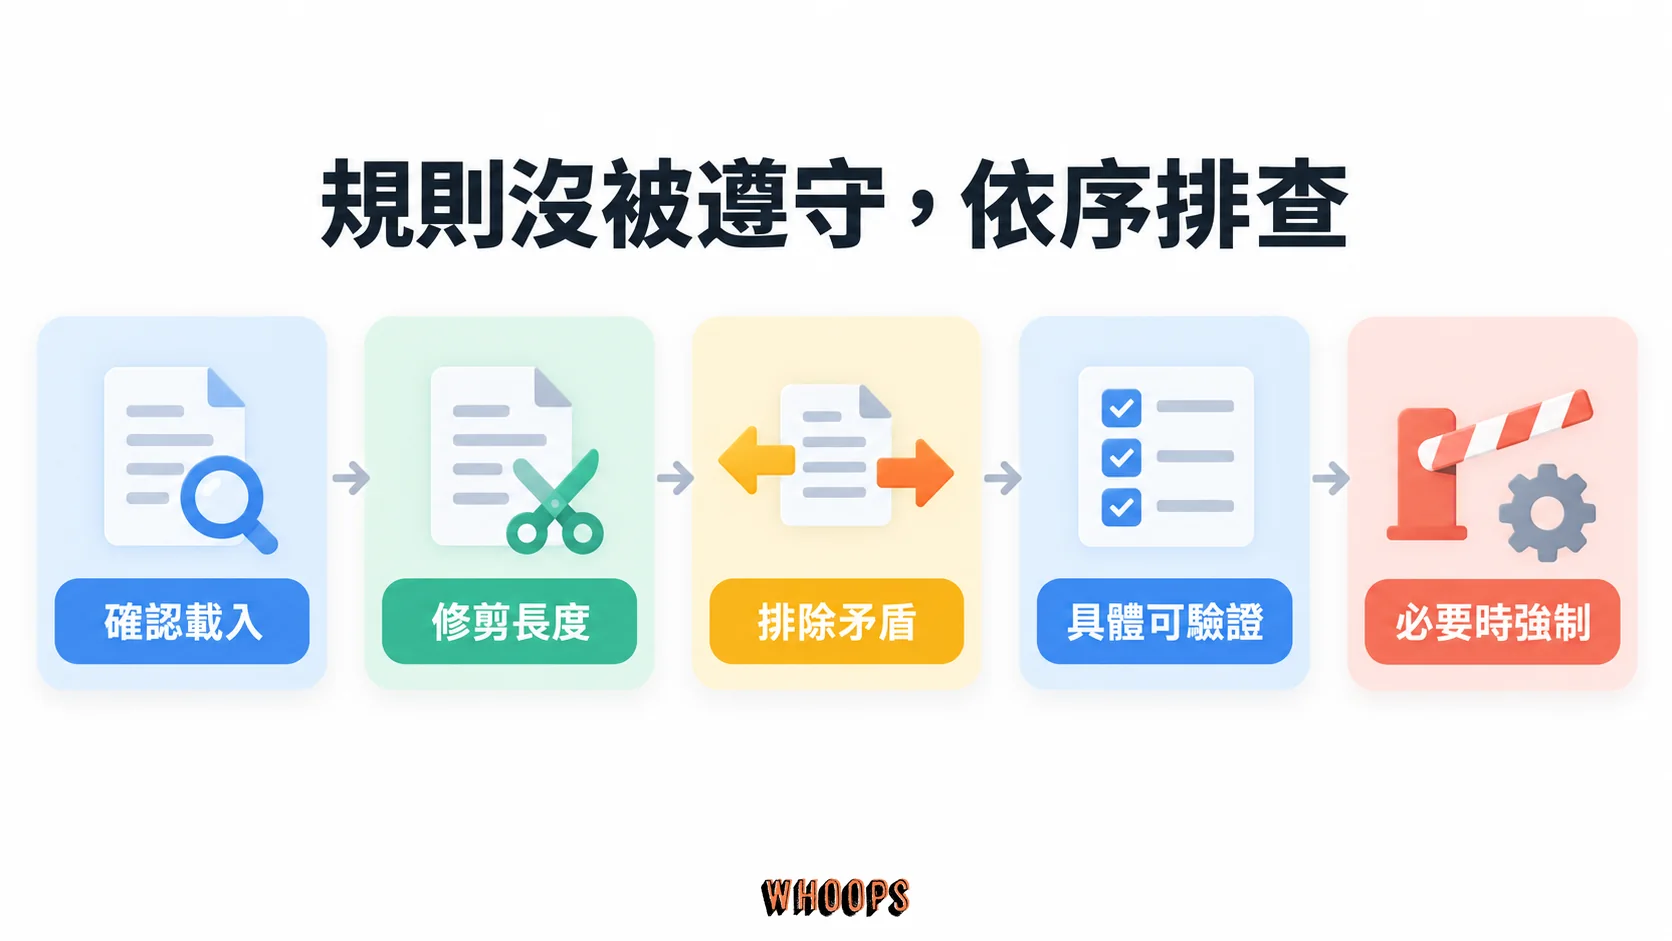
- 確認有載入:跑
/context,看 Memory files 清單裡有沒有你的檔案。位置放錯層、檔名大小寫不對,都會在這一步現形,檔案沒載入,其他調整都是白費。 - 檢查長度:200 行是建議目標,超過時檢查哪些內容不需要每次載入。
/doctor可協助修剪,相關功能需要 v2.1.206 或更新版本。 - 找矛盾:兩條規則說相反的事,模型可能任意挑一條,表現看起來就像隨機忽略。用
/doctor prompt-audit掃一輪,再人工核對巢狀目錄與 rules 檔有沒有跟上現況。 - 提高具體性:把「測試一下」改成「執行哪個指令、通過的標準是什麼」。模糊的指令沒有遵循的錨點,改寫成可驗證的形式往往比加強語氣有效。
- 判斷控制需求:如果某個動作必須被阻擋,或某項檢查每次都要執行,就設定對應的 hooks、權限或 sandbox,並測試規則是否能涵蓋實際操作。
有兩個情境不用緊張:/clear 之後的新對話會重新載入 CLAUDE.md,規則不會因為清空 context 而失效;/compact 之後,專案根目錄的 CLAUDE.md 也會從磁碟重新讀取再注入一次。會被壓縮稀釋掉的,是只在對話裡口頭給過的指示。這正好回到整篇的核心:重要的事寫進檔案,檔案放在對的層級,每一行都值得它佔的位置。
CLAUDE.md 常見問題
CLAUDE.md 是什麼?用途是什麼?
CLAUDE.md 是 Claude Code 讀取的 Markdown 說明檔,保存專案指令、程式碼慣例、測試方式與工作範圍。適用的根目錄與上層檔案在新對話載入,子目錄檔案按需載入。prompt 交代這次任務,CLAUDE.md 保存跨任務規則,auto memory 保存 Claude 累積的筆記。
CLAUDE.md 檔案要放在哪裡?
有四個層級:企業管理層由 IT 部署在系統路徑,影響整台機器;使用者層放在 ~/.claude/CLAUDE.md,對你的所有專案生效;專案層放在 repo 根目錄的 CLAUDE.md 或 .claude/CLAUDE.md,對這個專案的所有人生效;CLAUDE.local.md 是專案裡的個人層,只對你生效,建議加進 .gitignore。大多數人只需要使用者層與專案層兩個。
CLAUDE.md 有規定的格式嗎?
沒有規定格式。副檔名是 .md,但本質上是給模型讀的純文字,官方只要求簡短、可讀,用標題與條列組織。比排版更重要的是把指令寫得具體、可驗證,並避免互相矛盾的內容,因為矛盾的規則可能讓模型任意挑一條遵循。
CLAUDE.md 建議寫多長?
官方建議每個檔案以 200 行以內為目標,超過 4 MiB 的檔案會被整份略過。修剪基準是每一行都問:刪掉這行,Claude 會出錯嗎?不會就刪。模型讀程式碼就推得出的資訊、標準語言慣例、經常變動的內容,都不該放進來。
怎麼讓 Claude Code 自己把規則寫進 CLAUDE.md?
直接說「把這條規則加進 CLAUDE.md」並描述內容,或用 /memory 開檔編輯。說「記住」依官方操作方式會交給 auto memory,但必須在該 session 啟用。完成後查看實際檔案,確認內容存到正確位置。
為什麼寫在 CLAUDE.md 裡的規則 Claude 沒有遵守?
先用 /context 確認檔案有出現在 Memory files 清單,再檢查位置、排除設定、長度、規則矛盾與指令是否具體。CLAUDE.md 沒有嚴格遵循的保證。需要固定執行或阻擋的動作,應設定相應的 hooks、權限或 sandbox,並驗證實際涵蓋的操作。
CLAUDE.local.md 是什麼?跟 CLAUDE.md 差在哪?
CLAUDE.local.md 放在專案根目錄,只對你自己在這個專案生效,官方建議加進 .gitignore,避免個人偏好被推上 repo。載入時,它接在同一層 CLAUDE.md 之後。適合放本機測試資料路徑、個人沙盒網址這類不該跟團隊共享的內容。
CLAUDE.md 可以用中文寫嗎?
可以用中文撰寫規則。用詞保持一致,清楚寫出要執行的動作與檢查標準;指令名稱、檔案路徑和程式語法保留原文。沒有必要只為遵循度把整份說明翻成英文。
CLAUDE.md 和 auto memory 有什麼不同?
CLAUDE.md 是你手寫的規則檔,隨專案存在、可進版控分享給團隊;auto memory 是 Claude 自己記的筆記,存在你機器的 ~/.claude/projects 目錄,記錄你的偏好與它被糾正的模式。一個是定稿的規則,一個是草稿性質的印象,重複出現的糾正應該升級成 CLAUDE.md 裡的正式規則。
專案已經有 AGENTS.md,還需要 CLAUDE.md 嗎?
不一定。Claude Code v2.1.277 起,在工作目錄與上層沒有 CLAUDE.md、.claude/CLAUDE.md 或 CLAUDE.local.md 時,預設直接讀 AGENTS.md。要兩者共存,可在 CLAUDE.md 寫 @AGENTS.md,或在 /config 選 claude-md-and-agents-md。若版本或 session 不支援直接讀取,仍可使用匯入方式。
CLAUDE.md 的內容會被上傳或被別人看到嗎?
本機儲存不等於內容不會傳送。CLAUDE.md 與 auto memory 的已載入內容會進入 context,使用雲端模型時隨請求傳給模型服務。專案檔提交到 repo 後也會被有權存取的人看到;另行分享對話或回饋可能包含檔案內容。API key、密碼與不允許外傳的資訊不要寫進規則或記憶檔。資料保存與訓練用途需依帳號類型、供應商及隱私設定判斷,可查Claude Code 的官方資料使用政策。
/clear 或 /compact 之後,CLAUDE.md 還有效嗎?
/clear 之後,新對話會重新載入適用的 CLAUDE.md。/compact 之後,專案根目錄 CLAUDE.md 會重新讀取並注入;子目錄 CLAUDE.md 與 paths 限定規則會在讀到符合條件的檔案時重新載入。只在對話中交代的指示可能被壓縮,持續適用的要求應寫進規則檔。

討論與提問