
本篇內容
Muse Wonder 是 Meta 於 2026 年 10 月 12 日發表的前沿模型系列,一次推出兩款:可透過 API 呼叫的 Muse Wonder,以及限 Muse Code 訂閱使用的 Muse Wonder Full。Meta 稱這是自家至今能力最強的模型,主打需要長時間執行、中途會遇到阻礙的個人與專業代理任務。
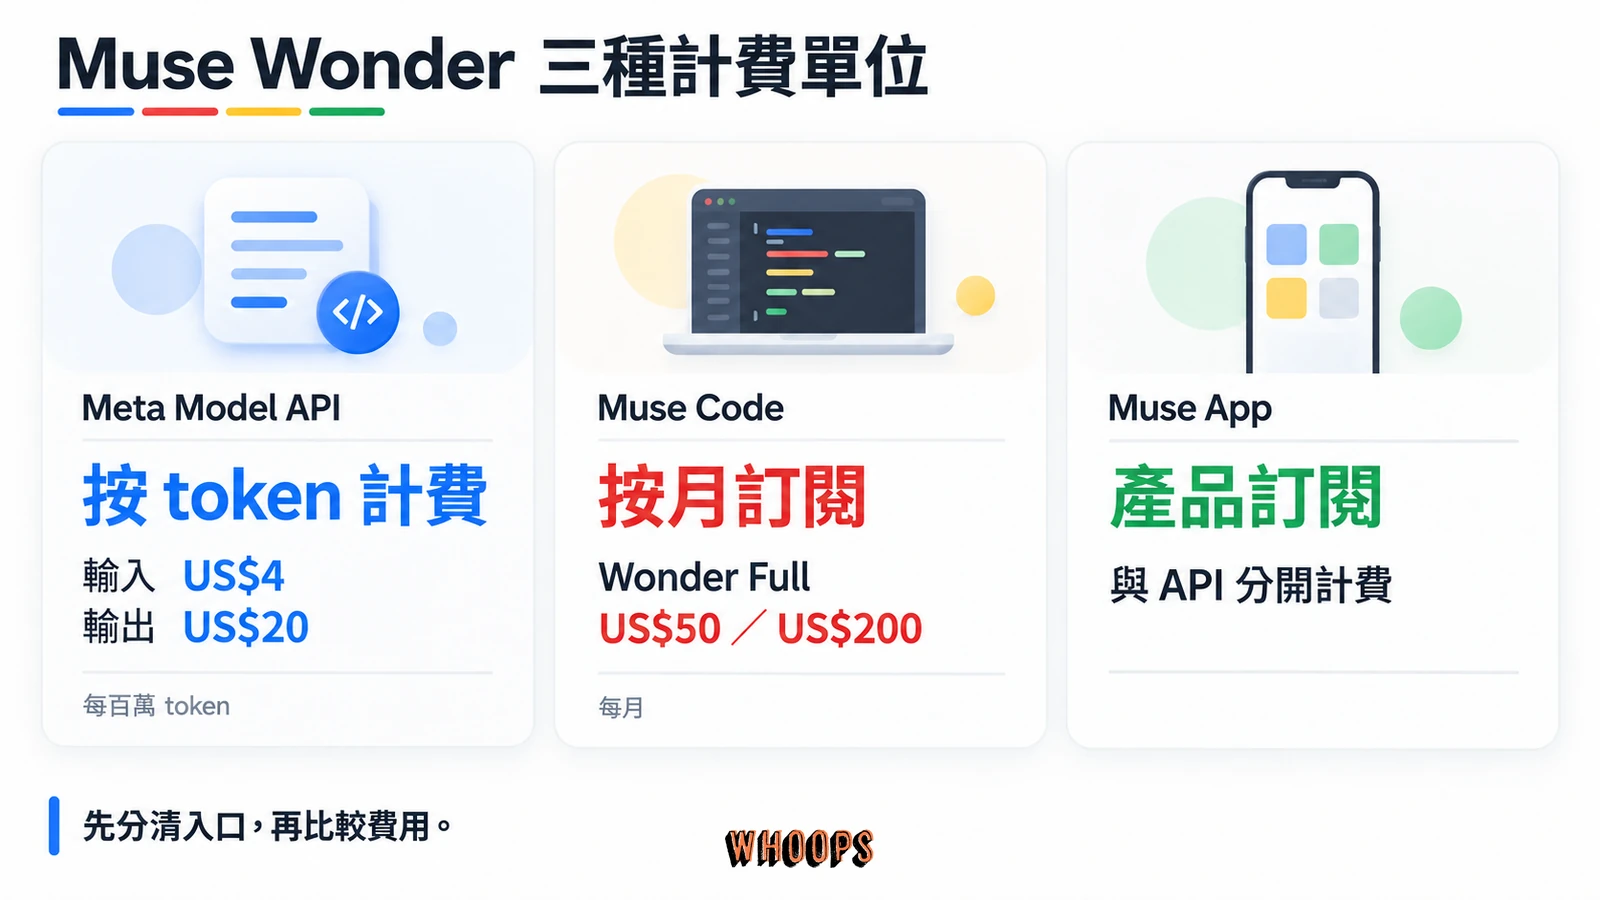
API 版每百萬輸入 token 收 4 美元、快取輸入 0.2 美元、輸出 20 美元。Wonder Full 不單獨提供 API,只能透過 Muse Code 每月 50 美元或 200 美元的方案使用,價格見官方模型與方案頁。截至 2026 年 10 月 15 日,Muse App 的官方市場公告未包含台灣;Wonder 何時整合到 App,官方仍寫即將推出、訂閱者優先。
所以「值不值得等」取決於你的使用方式。開發者可以評估 Wonder 的 API 與 Muse Code,但要先確認帳號、地區及計費資格;一般使用者要分別看 Muse App 的市場開放與 Wonder 的整合進度。想看模型實力,則應把長任務編碼、從零開發與綜合評測分開比較,不能只看一個總分。
兩個名字先分清楚:Wonder 走 API,Wonder Full 只在訂閱裡
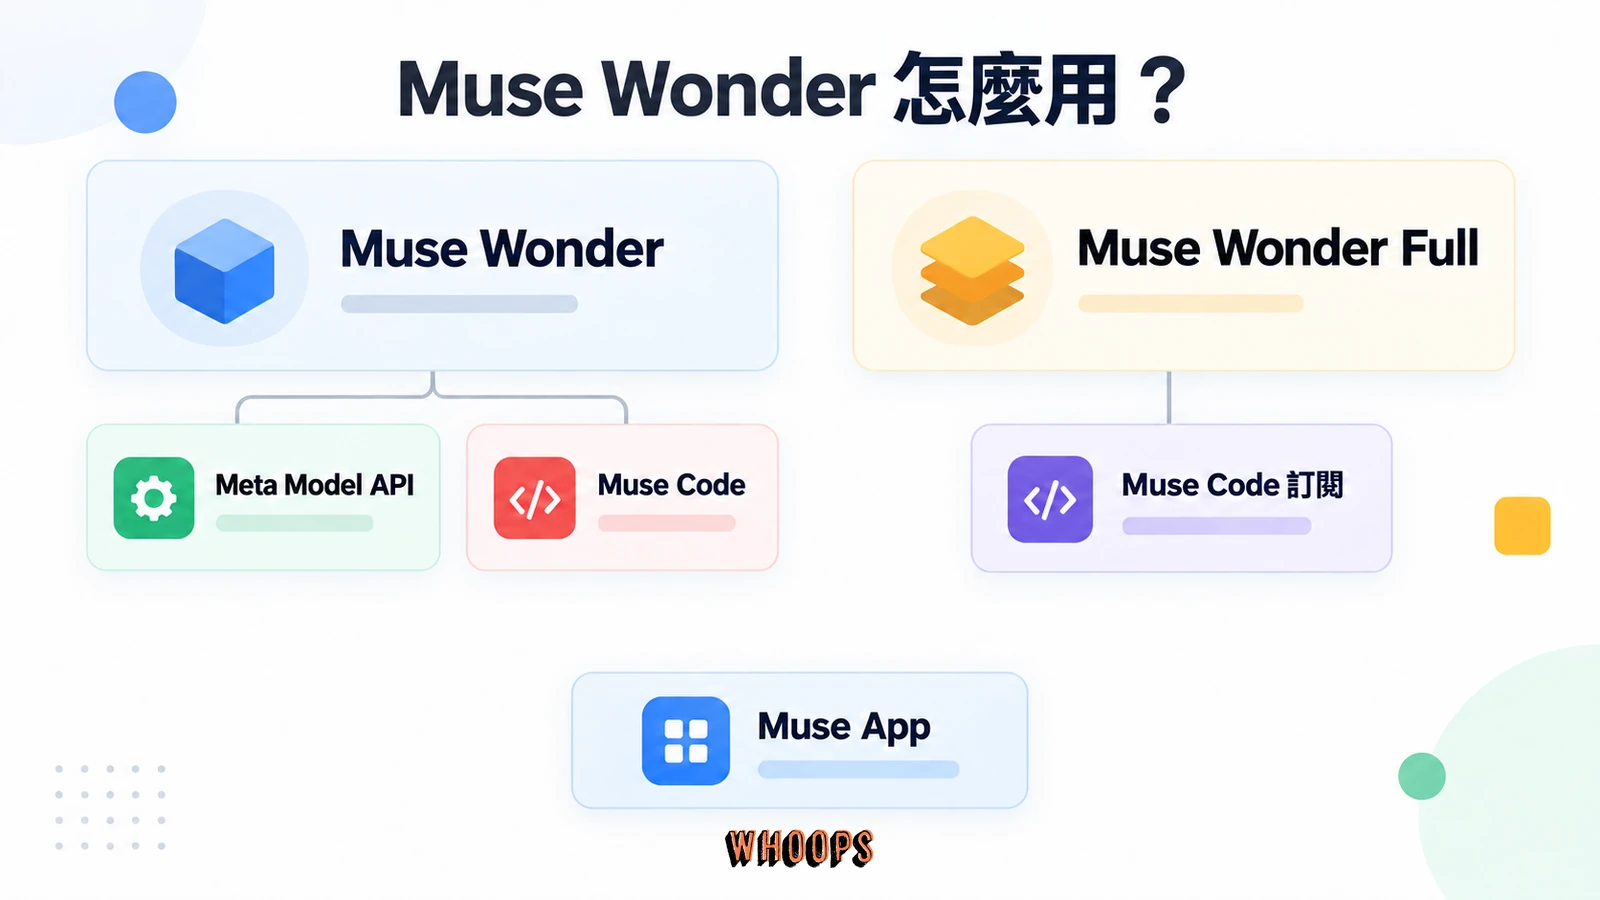
這次發表最容易搞混的地方,是「Muse Wonder」同時指整個系列和其中一款模型。系列有兩個成員:Muse Wonder 是標準版,發表當天就上了 Meta Model API 和 Muse Code,符合服務條件的開發者可付費使用;Muse Wonder Full 是強化版,官方定位在更重的代理任務,只提供給 Muse Code 的 Power Usage 與 Maximum Usage 訂閱用戶,不走 API。也就是說,想直接試 Full,入口是這兩級訂閱。
Meta 新聞室把系列定位在個人與專業代理工作,從處理保險理賠、理解租約到建立應用程式,重點是理解資料後接續操作。與先前的 Muse Spark 相比,Wonder 的官方定位更偏向能力需求較高、執行時間較長的任務。
模型在 Meta 自建的 GW 級資料中心 Prometheus 訓練。Meta 稱這波 AI 全面重建從 14 個月前開始,Wonder 的縮放方法承接自 4 月的 Muse Spark。Meta 新聞室的公告另有一個關鍵訊息:Wonder 之後會進到 9 月上架的個人代理 Muse,而且訂閱用戶優先。
Meta 拿什麼跟對手拼:Active Memory 與 Active Focus
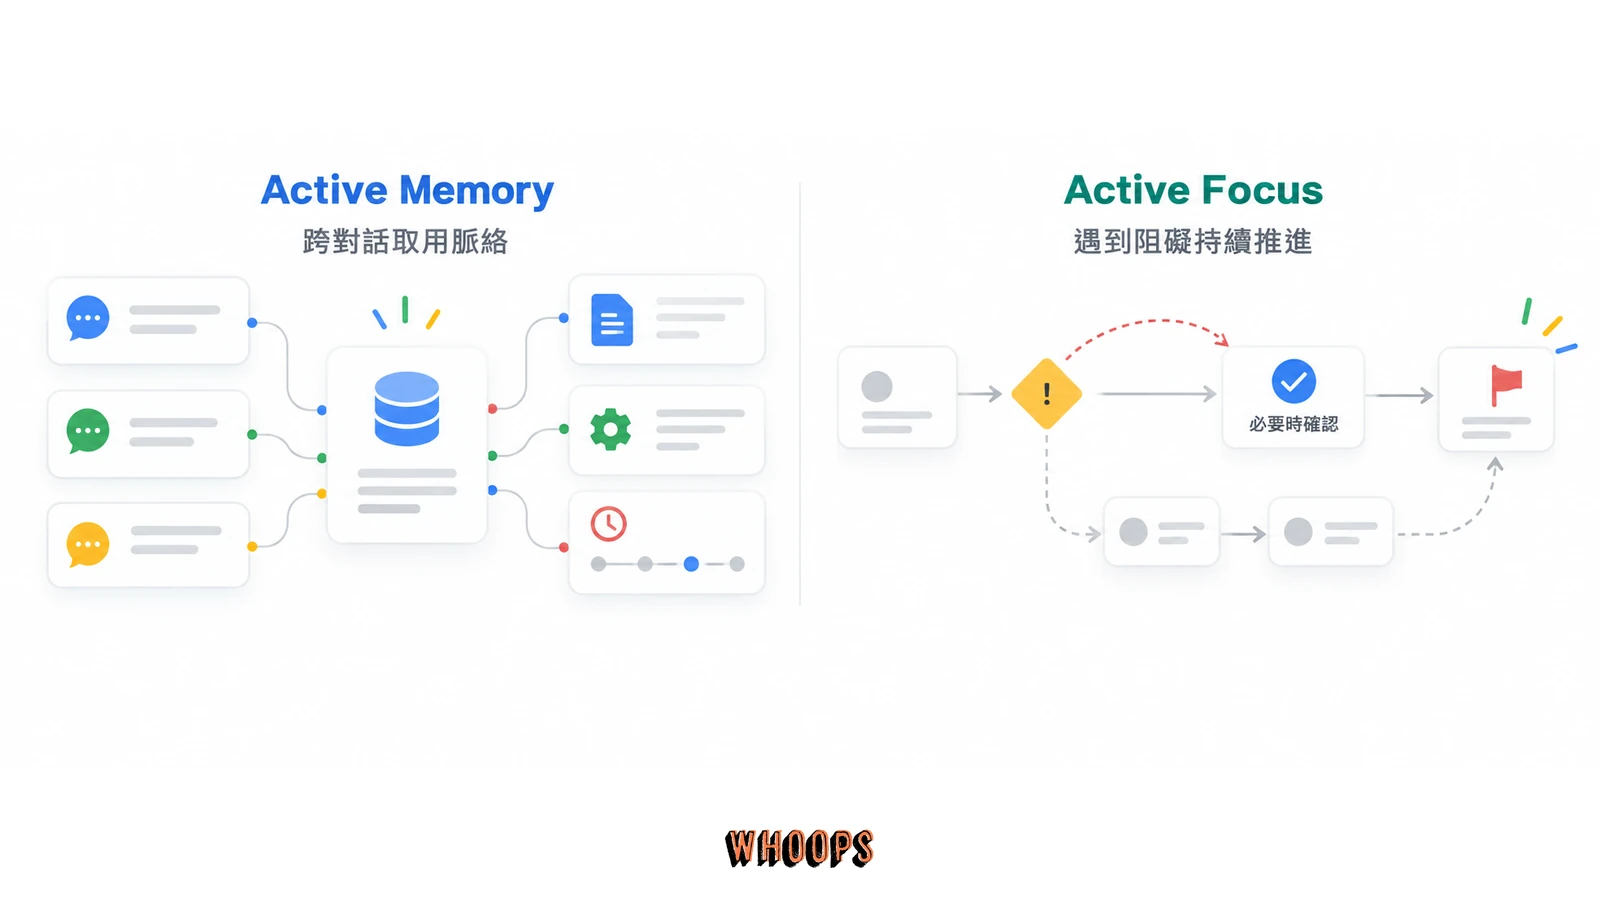
Meta 在官方研究部落格的發表文章裡,把 Wonder 的差異化濃縮在兩個詞上。第一個是 Active Memory(主動記憶):模型把關於你的重要脈絡跨對話帶著走,執行任務時主動取出相關細節。官方另外展示了依客製化圖片輸入建立 3D 廚房遊戲,以及操作瀏覽器與應用程式規劃行程的範例。這些是官方示範,是否適合自己的任務仍要看實際結果。
第二個詞是 Active Focus(主動專注):遇到阻礙時換方法試,而不是停在那裡等使用者救場;可以長時間續作同一個目標;需要澄清時提問,涉及重大行動前會回頭確認。這是官方研究頁對能力的說明。如果你不清楚「代理任務」在講什麼,可以先看AI 代理的基礎概念,重點就是模型不只回答問題,還要操作工具、連續完成多個步驟。
帳面規格兩款相同,都出自官方 model card:上下文長度約 100 萬 token,輸入接受文字、圖片、影片與音訊,輸出只有文字。開發文件列出的視窗長度為 1,048,576 token,能在單次請求容納較長的操作紀錄、文件與對話歷史。token 不能直接等同中文字數,實際容量取決於語言、格式及 token 化結果;找回細節的準確度仍要另外評估。想複習上下文視窗在語言模型裡的角色,可以回頭看大型語言模型的運作原理。
價格全部攤開:三種入口、三種計費邏輯
Wonder 的取得管道分成三層,計費邏輯各不相同,混在一起比容易誤判。第一層是 API:開發者從dev.meta.ai 開發者平台進入 Meta Model API,按用量計費。Muse Wonder 官方價格為每百萬輸入 token 4 美元、快取輸入 0.2 美元、輸出 20 美元;介面相容 OpenAI SDK,可沿用相容的客戶端,再調整端點、API key 與模型名稱。OpenRouter 也提供 Muse Wonder,使用前應分別核對平台費率與資料條件。
快取輸入 0.2 美元會影響代理任務的實際帳單。當重複使用的輸入符合快取條件並命中時,該部分按一般輸入價格的二十分之一計費。代理任務經常反覆帶入同一批文件、程式碼與操作紀錄,因此值得觀察 cached tokens 的比例;未命中的輸入仍按一般費率計算,不能把所有後續輸入都當成快取價。
在 Meta 自家產品裡,Spark 1.3 的 Standard 模式每百萬輸入 token 為 1.25 美元、輸出 4.25 美元,低於 Wonder 的 4 美元與 20 美元。兩者適合的負載也不同:官方模型選擇文件把 Wonder 放在多檔案修改、多小時代理任務及子代理協作;Spark 則偏向大量、延遲敏感或成本敏感的工作。價格要連同任務完成率、輸出量與快取命中一起看。
第二層是 Muse Code,看的是月費而不是逐次 API 帳單。官方訂閱頁有四個方案,Wonder Full 只在 Power Usage 與 Maximum Usage 兩階解鎖,方案結構如下;Muse Code 的操作細節與適合誰,站上的 Muse Code 教學有完整說明。
| Muse Code 方案 | 月費 | 重點 |
|---|---|---|
| Everyday Usage | 5 美元 | 日常用量的入門階 |
| High Usage | 15 美元 | 較高用量的進階階 |
| Power Usage | 50 美元 | 解鎖 Muse Wonder Full |
| Maximum Usage | 200 美元 | 最高用量,含 Muse Wonder Full |
第三層是 Muse App 本身,它是另一個消費者產品,不能把 Muse Code 的月費當成 App 訂閱價。官方 Wonder 公告目前只寫「即將」驅動 Muse 體驗、訂閱者優先,沒有給全面開放日期;打算為 App 訂閱的人,應先確認自己的地區是否開放,以及帳號實際顯示的模型與方案。
官方基準怎麼讀:贏在長任務與記憶,輸在從零開發
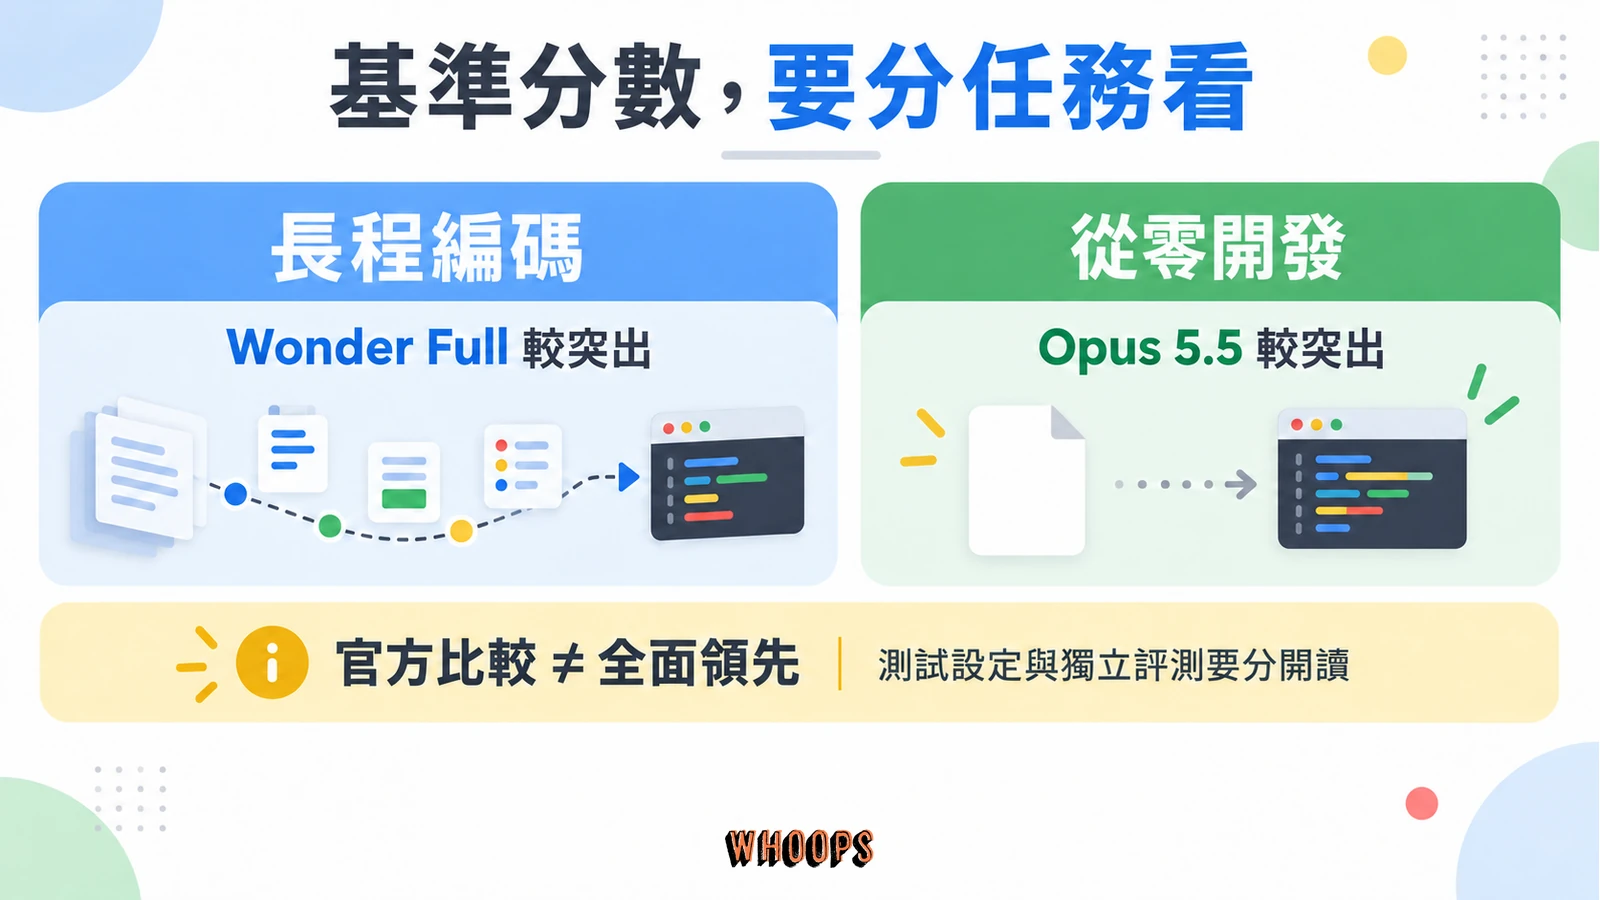
Meta 這次隨發表公布了基準對照表,拿 Wonder 系列跟 Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5 三個對手比,成績由 Meta 彙整發布。在列出的 14 個項目裡,Wonder 系列共拿 7 個最高分,其中 Full 6 個、標準 Wonder 1 個;Opus 5.5 拿 6 個,GPT-6 Astra 拿專業文件項目 1 個。Wonder 系列的優勢集中在長程編碼、記憶與部分專業代理任務。數字全貌如下,標注(內部)的是 Meta 自訂基準。
| 基準項目 | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 | 該列最高 |
|---|---|---|---|---|---|---|
| Personal Superintelligence Index(內部) | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 | Wonder Full |
| Harvey LAB-AA(法律代理) | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 | Wonder Full |
| Vals Finance Agent V2(金融) | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 | Wonder Full |
| HealthBench Pro(專業健康) | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 | Opus 5.5 |
| AutomationBench-AA(商業流程) | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 | Wonder Full |
| GDP.pdf(專業文件) | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 | GPT-6 Astra |
| JobBench(專業工具使用) | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 | Opus 5.5 |
| OSWorld V2.1(電腦操作,部分分) | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 | Opus 5.5 |
| MemoryBench(內部) | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 | Wonder |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 | Opus 5.5 |
| DeepSWE 1.1(長程編碼) | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 | Wonder Full |
| SWE-Marathon(超長專案) | 57.5 | 53.1 | 45.6 | 42.5 | 46.3 | Wonder Full |
| ProgramBench(從零開發完整程式) | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 | Opus 5.5 |
| Artificial Analysis Index v4.3.2 | 56 | 52 | 53 | 53 | 58 | Opus 5.5 |
資料來源:Meta 官方基準對照表及model card,包含 Meta 內部、第三方與模型廠商發布的結果。Meta 自行執行的對手模型測試採 best-effort 設定。SWE-Marathon 的 Wonder Full 使用 xhigh,部分對手透過 Codex 或 Claude Code 執行,並非統一 harness 的比較。Personal Superintelligence Index 與 MemoryBench 為 Meta 內部基準。
這張表有兩個方向值得停下來看。往 Wonder 有利的方向:Full 在 DeepSWE 1.1 比表中的其他廠商模型高約 5 到 12 分,在 SWE-Marathon 比它們高 11 分以上,與 Active Focus 的長任務定位一致;法律代理 Harvey LAB-AA 的 13.1,也高於 Opus 的 4.2。往對手有利的方向:ProgramBench 要求從零重建完整程式,Opus 5.5 的 70.5 高於 Full 的 59.0,差距 11.5 分。長程維護與從無到有完成程式,需要分開評估。
專業領域那幾列的落差也要分開讀。法律代理 Harvey LAB-AA 是 Artificial Analysis 營運的版本,由評審對交付文件逐項驗收,model card 列明此項結果來自 Artificial Analysis。金融代理 Vals Finance 則是另一種情況:Full 的 59.1、Fable 5.1 的 58.9、Opus 5.5 的 58.6,差距都在 0.5 分以內。JobBench 覆蓋 35 種白領職業的 65 項任務,Opus 的 75.4 與 Full 的 75.3 也很接近。這些小分差不能直接當成效果相同,仍應用自己的任務比較完成品質與成本。
讀這張表時,model card 裡的評測口徑要一起看。第一,Personal Superintelligence Index 與 MemoryBench 是 Meta 的內部基準,PSI 是七個評測的組合,不能當成獨立機構的綜合排名。第二,Meta 自行產生的對手分數採 best-effort 設定,提示詞、工具與執行環境未必為閉源模型調到最佳;表內也混合了第三方與廠商自報結果。第三,SWE-Marathon 不只推理等級不同,部分模型還使用不同代理產品,並非同一 harness 的控制比較。因此,表裡的領先幅度不能直接外推到所有工作負載。
第三方綜合評測:Wonder Full 目前排第 4
官方表之外的交叉驗證,可以看Artificial Analysis 的獨立評測頁。截至 2026 年 10 月 15 日,頁面顯示 Wonder Full 在 Intelligence Index v4.3.2 得 56 分、排名第 4。Meta 官方表也收錄了這一列:Opus 5.5 為 58 分,Fable 5.1 與GPT-6 Astra為 53 分,標準 Wonder 為 52 分。榜單會隨新增模型與評測更新,選型時應再看當下頁面。
兩份資料合起來看,Wonder Full 在官方選列的長任務代理項目有優勢,但沒有在綜合智能評測全面領先。若你也在比較Claude Sonnet 5.5,應用相同任務與預算測試,而不是把接近的分數視為效果相同。Opus 5.5 的能力與使用方式可作為另一組比較條件;想看 Google 陣營的選項,也可延伸閱讀Gemini 4 Argon 的模型解析。本篇仍以 Meta 官方選列的三個對手為主,不把單一榜單當成所有用途的結論。
安全與資料使用:模型測試、開放權重與訂閱條件
安全方面,Meta 稱 Wonder 是自家至今對齊度最高的模型,對 CBRN(化學、生物、放射性與核)及網路濫用提供至今最強防護,並依 Meta Superintelligence Scaling Framework 評估。model card 列出的 Agentic Misalignment 測試有害行動率為 0%,這是該組測試的結果,不能解讀為實際部署零風險。官方也提醒部署方評估多步驟推理、語言與使用情境的限制。
model card 裡有兩組數字需要一起讀。風險評估指出,未加緩解措施時,不排除模型在化學與生物領域達到高風險門檻;加入安全訓練與系統級保護後,Meta 將各領域殘餘風險評為中等或更低。網路能力方面,Wonder Full 在 ExploitGym 擷取 92 面 flag,但覆核後只有 21 面使用題目預定漏洞,其餘 71 面來自非預期漏洞。依公開排行的計分方式,可相比的數字是 21。這些結果說明,模型能力與防護效果需要連同測試定義閱讀。
模型供應方式也要分清楚。Wonder 與 Full 目前沒有公開權重,分別透過 API、Muse Code 與訂閱提供。Meta 另有開放權重的產品線:Llama 官方模型庫仍有可下載模型,Muse Glimmer 也保留自架路線。選擇託管模型時,除了能力與費率,還要看送出的內容如何被保留與使用。
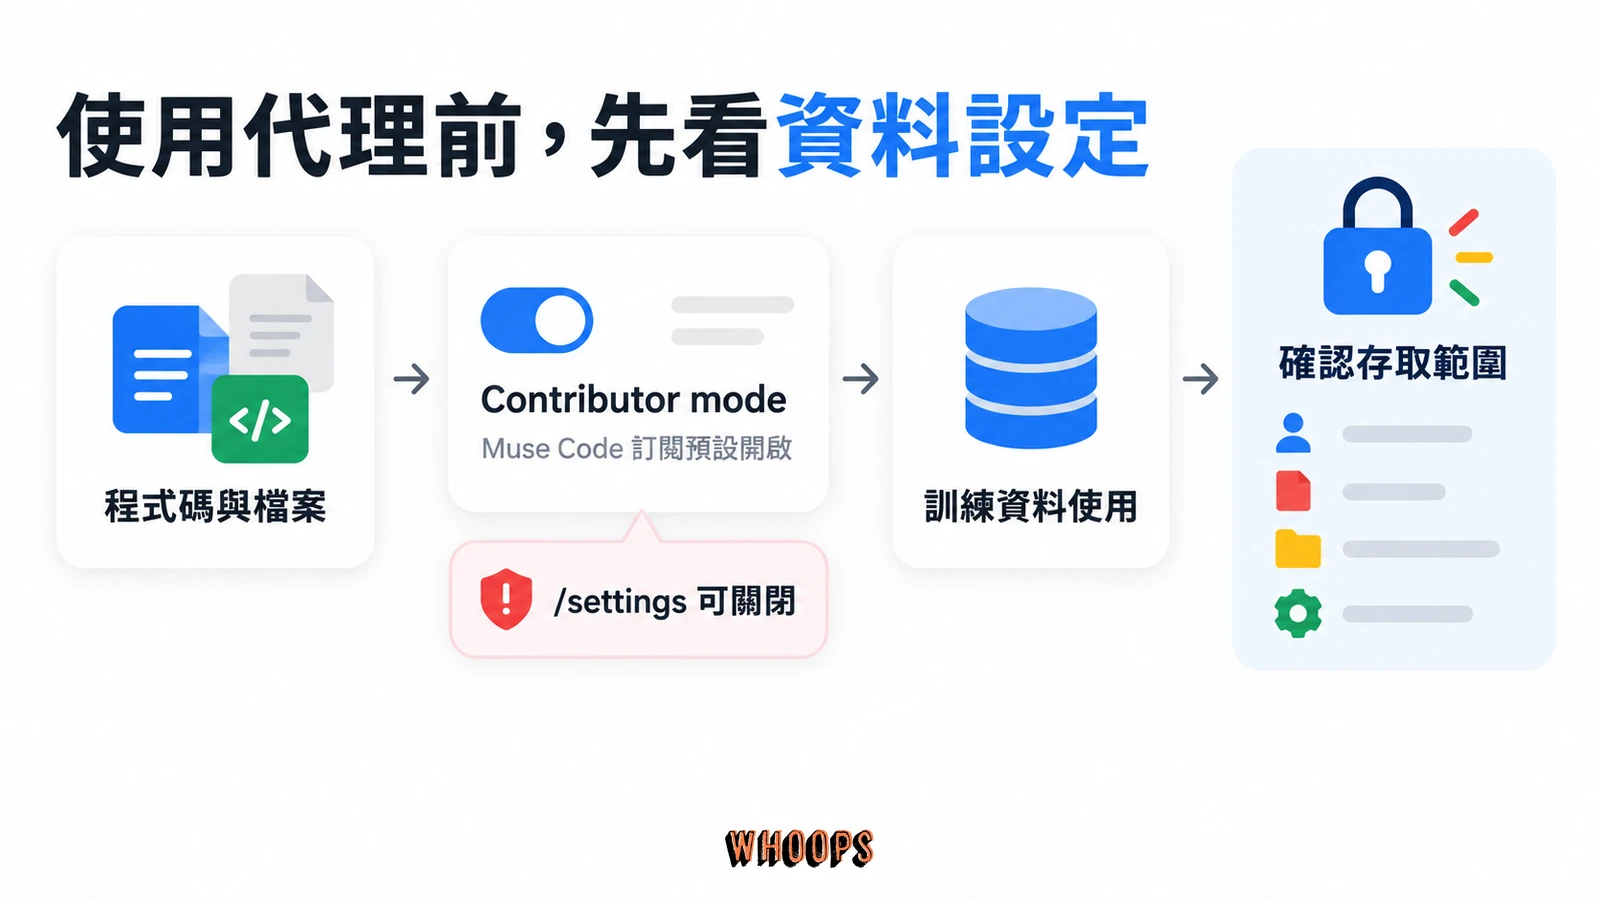
Muse Code 訂閱有一個付費前就該知道的條件:官方說明寫明預設開啟 Contributor mode,送出的 prompts、程式碼、檔案、脈絡及模型回覆可用來訓練未來模型。可以在 /settings 關閉,之後提交的內容改依 Standard 條件處理,不用於模型訓練,但可用額度會改變。涉及機密程式碼或個人資料時,要先核對這個設定。這與 Muse App 的記憶功能是不同條件。
Active Memory 則涉及 Muse App 如何保存與使用你的脈絡。官方設計說明提到,使用者可以查看與編輯 Memory files、檢視活動紀錄及已批准的權限;系統安全說明則介紹 VM、憑證隔離與 Sentinel 授權機制。在把行事曆、通訊軟體或購物帳號接上代理前,先看它取得哪些讀寫權限,以及如何撤回授權,比只看模型分數更切合實際使用。
安全議題對 Wonder 的實際影響是:當模型能長時間操作工具、處理帳號資料時,模型本身的測試分數之外,仍需要系統層的存取控制與重要行動確認。API、自架模型與 Muse App 的資料邊界不同,不能只憑同一個模型名稱推論保障相同。
跟 9 月的 Muse App 是什麼關係:模型層與代理層
很多人把 Muse Wonder 跟 9 月上架的 Muse App 搞成同一個東西,其實它們是上下兩層。Wonder 是模型層,負責理解與決策;Muse App 是代理產品,有介面、帳號授權與自己的雲端 VM,能操作瀏覽器及連接服務。9 月的 Muse 上線時由 Muse Spark 驅動,Wonder 的整合則是這次公告的後續規劃。兩層的完整分工與 Muse App 的功能盤點,Muse 個人代理的完整教學有專文可查。
We’re excited to introduce the Muse Wonder series with Muse Wonder and Muse Wonder Full, our most capable models yet. Both are frontier models, built to deliver state-of-the-art performance for personal and professional agentic tasks.
— AI at Meta (@AIatMeta) October 12, 2026
Muse Wonder is available today via the Meta… pic.twitter.com/Z9Pdf5USyw
官方帳號的貼文與新聞室公告一致:Wonder 已透過 API 與 Muse Code 提供,Full 限 Muse Code 訂閱者,而 Wonder 將優先向 Muse 訂閱者推出。官方使用「即將」的說法,尚未提供全面開放日期,不能據此判定所有付費 App 帳號都已取得 Wonder。
Wonder 進駐後,官方希望改善的是需要延續脈絡、跨多個步驟並克服阻礙的任務,例如規劃行程或長期專案。這與 Active Memory、Active Focus 的方向一致,但實際能否減少中斷或提升完成率,仍取決於 App 整合、工具與任務本身,不能從基準分數直接保證體驗。
把已有官方公告的幾個時間點排開,會更清楚 Wonder 在哪個位置:
- 4 月:Meta 發表 Muse Spark,開始新的模型系列。
- 9 月:Muse 個人代理 App 上線,以 Muse Spark 驅動。
- 10 月:Muse Wonder 與 Wonder Full 發表,增加前沿代理模型選項。
回答版本問題:Wonder 與 Spark 是並存的模型選項。官方文件建議,能力需求較高的長任務選 Wonder;大量、延遲或成本敏感的工作可評估 Spark。Spark 1.3 的 Standard 輸入/輸出費率仍是每百萬 token 1.25/4.25 美元,Wonder 則是 4/20 美元,不能只因名稱更新就一律換掉既有模型。
台灣能用嗎?App、API 與 Muse Code 要分開確認
Muse App 與開發者服務要分開確認。Muse 的官方市場公告未包含台灣,目前也沒有台灣開放時間表。想從 App 使用的人,應等官方列入支援市場,再核對帳號可用的功能;非官方側載或 VPN 教學無法代表官方支援。
Meta Model API 與 Muse Code 則依開發者服務條件提供。官方 Geographic Use Policy沒有把台灣列為 Restricted Territories,但服務仍有地區限制,實際使用要確認所在地、帳號及計費支援。服務條款也要求使用者年滿 18 歲。台灣未列入限制清單,仍不等於所有台灣帳號都能註冊、付款或取得相同模型。
若帳號符合服務資格,API 接入流程與其他 OpenAI 相容服務相近:在 dev.meta.ai 建立帳號、設定計費並取得 API key,把客戶端端點設為 https://api.meta.ai/v1,模型指定 muse-wonder-1.0,細節可看官方 Quickstart。偏好終端工具的人可由官方頁安裝 Muse Code,再登入確認方案。起步時先用少量真實任務比較完成品質、快取命中與帳單,再決定是否擴大使用。
三種讀者分別該做什麼
寫程式的人,可以把 Wonder 當成一個待驗證的新選項。它在官方表的長程編碼項目較強,從零開發完整程式的 ProgramBench 則落後 Opus 5.5;維護大型既有專案與從空白建立系統,應分別測試。API 相容 OpenAI SDK,可以拿現有評估集比較。已經在用終端編碼代理的人,也可對照Claude Code與OpenAI 的 Codex的操作方式與成本,再決定是否加入 Muse Code 訂閱。
一般使用者,先確認 Muse App 是否對自己的地區與帳號開放,再看 Wonder 是否已整合。台灣尚未出現在官方市場公告中,訂閱前要先確認自己能取得哪些功能。在等待期間,若想理解代理如何把對話延伸成任務,可以從ChatGPT 的基本操作開始,再比較各產品提供的工具與權限。
看產業方向的人,可以追蹤 Full 限訂閱的供應方式、Wonder 與 Spark 的負載分工,以及託管模型的資料條件。Full 在 Muse Code 的 50 美元與 200 美元方案都能使用;API 則提供標準版按量計費。這些選擇會影響實際成本與部署彈性,應與能力分數一起評估。
常見問題
Muse Wonder 是什麼?
Muse Wonder 是 Meta 於 2026 年 10 月 12 日發表的前沿模型系列,包含 Muse Wonder 與 Muse Wonder Full,主打個人與專業代理任務。兩款都支援約 100 萬 token 上下文,輸入支援文字、圖片、影片與音訊,輸出為文字。它是模型系列,與有介面、帳號及工具的 Muse App 不同。
Muse Wonder 和 Muse Wonder Full 有什麼差別?
主要差別在能力與取得方式。Muse Wonder 可透過 Meta Model API 按用量付費,也可在 Muse Code 使用;Wonder Full 不提供獨立 API,只包含在 Muse Code 每月 50 美元的 Power Usage 與 200 美元的 Maximum Usage 訂閱。把標準版推理等級設成 max,並不會變成 Full。
Muse Wonder 台灣可以用嗎?
要分產品確認。Muse App 的官方市場公告尚未包含台灣。Meta Model API 的 Geographic Use Policy 未將台灣列為限制地區,但服務仍有地區、帳號與計費條件,應以官方入口顯示的資格為準。
Muse Wonder 價格多少?
Meta Model API 的 Muse Wonder 每百萬輸入 token 為 4 美元、快取輸入 0.2 美元、輸出 20 美元。Muse Code 月費分為 5、15、50、200 美元四級,Wonder Full 僅在 50 與 200 美元方案提供。Muse App 是另一個產品,不能套用 Muse Code 的價格。
Muse Wonder 比 Claude Opus 5.5 強嗎?
要看任務。在 Meta 公布的 14 列對照中,Wonder Full 有 6 列最高、標準 Wonder 有 1 列最高,Opus 5.5 有 6 列最高。Full 的長程編碼分數較高,Opus 在 ProgramBench 從零開發程式項目較高。Artificial Analysis 頁面於 2026 年 10 月 15 日顯示 Full 得 56 分、排名第 4,不能據此稱它全面領先。
Muse Wonder 是開源模型嗎?
目前 Wonder 與 Wonder Full 沒有公開權重,透過託管 API 與 Muse Code 提供。這不代表 Meta 所有模型都停止開放權重;Llama 與 Muse Glimmer 仍有可下載自架的模型。
Wonder 什麼時候會進到 Muse App?
Meta 官方公告仍寫即將推出、Muse 訂閱者優先,沒有提供全面開放日期。這不等於所有付費 App 帳號都已取得 Wonder;還要分別確認產品整合與所在地區的可用性。
Muse Wonder 跟 Muse Spark 差在哪?
兩者並存。官方建議 Wonder 用於能力需求較高的多檔案編碼、多小時代理與子代理協作;Spark 偏向大量、延遲或成本敏感的工作。Spark 1.3 Standard 每百萬輸入/輸出 token 為 1.25/4.25 美元,Wonder 為 4/20 美元。
100 萬 token 上下文是什麼概念?
表示單次請求可容納較長的文件、對話與操作紀錄。token 不是中文字數,實際能放多少內容取決於語言、格式與 token 化結果;找回細節的準確度仍要另外評估。
Muse Code 會用我的內容訓練模型嗎?
官方說明指出,Muse Code 訂閱預設開啟 Contributor mode,送出的 prompts、程式碼、檔案、脈絡與模型回覆可用於訓練未來模型。可以在 /settings 關閉,之後的內容改依 Standard 條件處理,不用於模型訓練,但可用額度會改變。

討論與提問