
本篇內容
DeepSeek 在 2026 年 10 月 17 日把五週前發布的 V4.1-Flash 就地升級為 V4.1-Flash-1017:官方網頁、App 與 API 三端同步切換,API 呼叫名稱維持 deepseek-flash、價格完全不變,新版權重同一天以 MIT 授權放上 Hugging Face。
官方公布的對照分數顯示 11 項基準全數上升,幅度介於 2.0 到 11.1 個百分點,其中 DeepSWE v1.1 從 74.2 提升至 77.0,在官方表格中高於 Claude Opus 5 的 74.0;Terminal-Bench 4.0 從 31.2 大漲到 42.3。同一天 DeepSeek 還開放了 Search & Fetch API,每個端點每千次成功請求 0.75 美元;透過指定 Agent 工具的伺服器端呼叫,暫不收取搜尋與抓取的請求費,台灣時間 11 月 1 日零時起計費。
資料更新:2026 年 10 月 18 日。
| 10 月 17 日同步上線 | 內容 | 對你的影響 |
|---|---|---|
| 模型升級 | V4.1-Flash 就地升級為 V4.1-Flash-1017,網頁、App、API 三端同步 | API 用戶不用改任何程式碼,deepseek-flash 自動換上新模型 |
| 開放權重 | 763B 參數權重以 MIT 授權上架 Hugging Face 與 ModelScope | 可自行部署、可商用;硬體需求須依精度、記憶體與推論設定評估 |
| Search & Fetch API | 自研搜尋引擎開放付費呼叫,每千次 0.75 美元 | 指定工具的伺服器端 Search/Fetch 請求費暫免,台灣時間 11 月 1 日零時起計費;模型 token 另計 |
10 月 17 日這一天,DeepSeek 同時做了三件事
翻開官方更新日誌,10 月 17 日的條目切成兩個小節:先宣布開放自研搜尋引擎的 Search & Fetch API,接著才是「DeepSeek-V4.1-Flash-1017 Update」。條目寫得直接:DeepSeek V4.1 Flash 已升級至 V4.1-Flash-1017,官方網頁端與 App 已同步更新,API 呼叫方式與價格保持不變,仍然使用 deepseek-flash 就能叫到最新模型。這是 9 月 10 日首發之後,同一個架構約五週後的版本更新,命名邏輯沿用 DeepSeek 的日期快照慣例,1017 就是 10 月 17 日,前一個世代叫 V4-Flash-0731。
三件事裡最實惠的是第一件。你在 DeepSeek 網頁或 App 裡對話,背後的模型已經換成 1017;走 API 的開發者什麼都不用改,模型名稱還是 deepseek-flash,帳單費率一毛未動。第二件是開放權重,Hugging Face 與 ModelScope 同步上架完整權重。第三件 Search & Fetch API 則是把 DeepSeek 自家搜尋引擎變成可計費的介面,後面會單獨拆開講,因為它跟做內容、做搜尋的讀者關係最近。
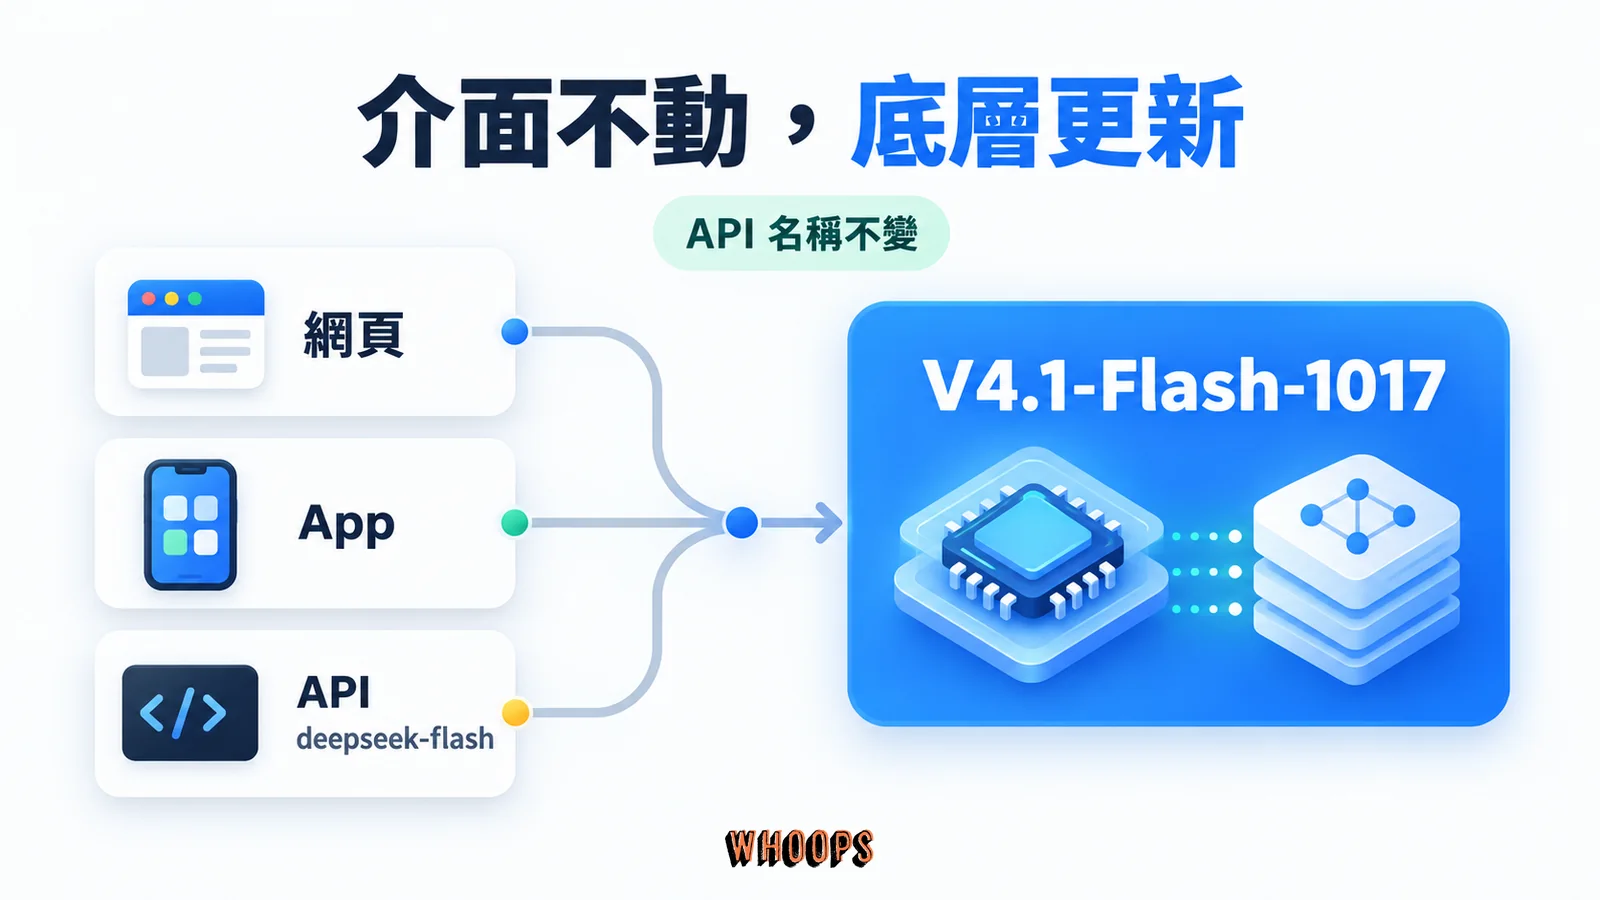
這種「介面不動、底層換新」的發布方式,DeepSeek 九月已經採用過。官方更新日誌目前保留 V4-Pro 獨立提供服務、計費方式不變的說明;定價頁的版本字串仍為 V4-Pro-0813,與 1017 並列。1017 的定位則由模型卡說得很清楚:它是 V4.1-Flash 的 minor update,以新權重更新既有模型,並非另一套新架構。
1017 的權重放在 10 月 17 日當天全新建立的 Hugging Face 儲庫。對照 9 月版連技術報告 PDF 都附在儲庫裡,1017 的模型卡保留定位說明、基準表與推論指引,技術報告直接沿用前版。
1017 改版到底改了什麼:官方說法與訓練方法
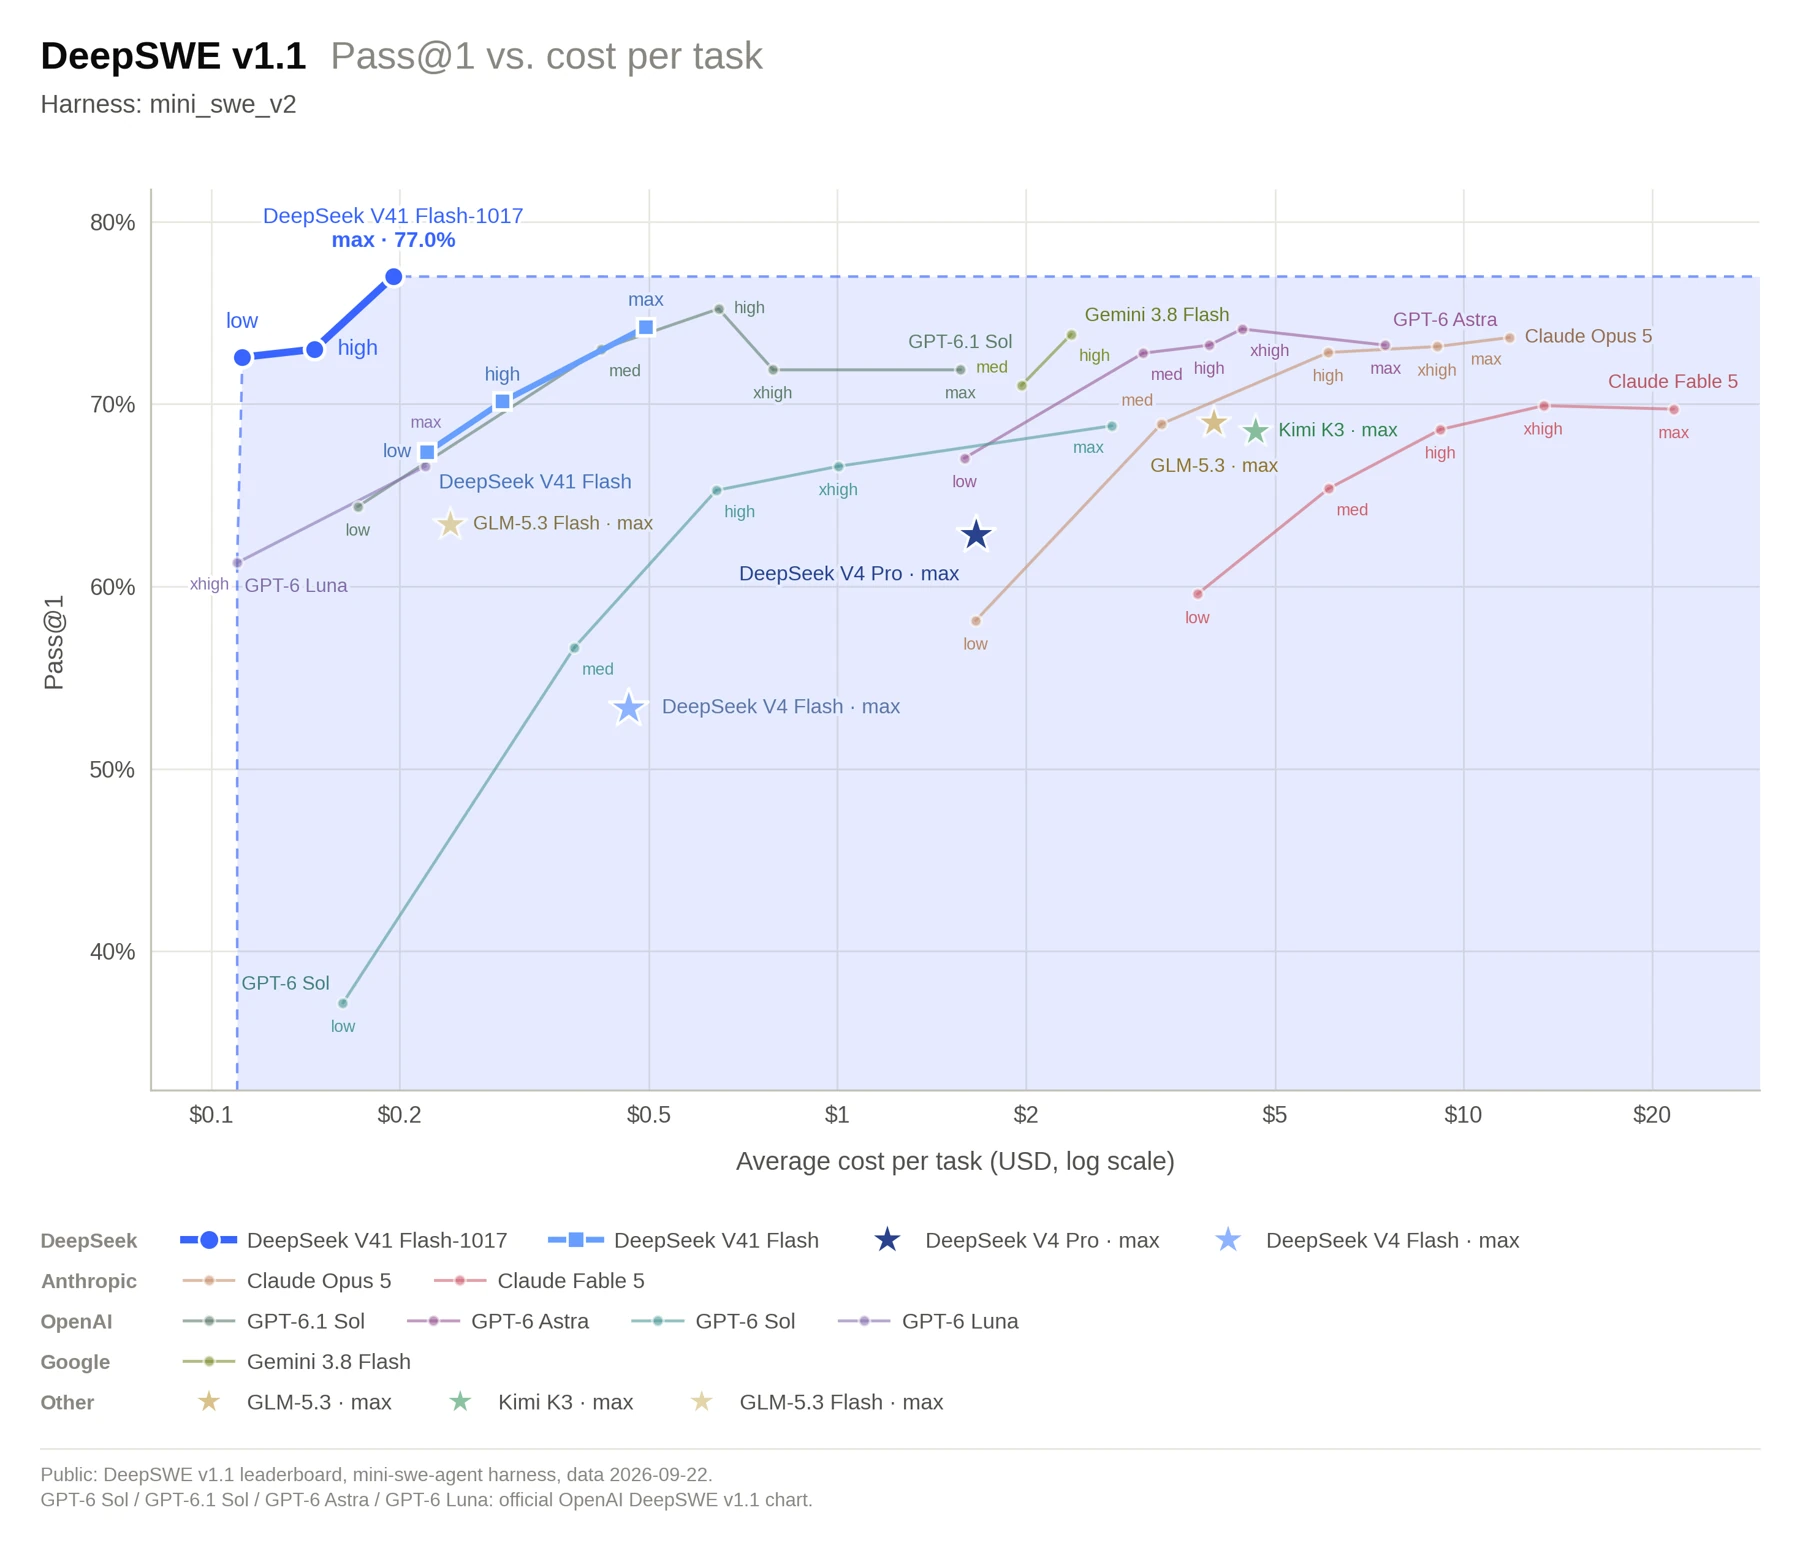
這份標題為 Wish-Driven Programming Made Real 的公告給了三個關鍵字:更強的基準表現、更快的任務完成速度、更短的輸出。官方把這組改進稱為效能與成本的帕雷托改進(Pareto improvement),意思是分數變高的同時,因為輸出變短、任務執行時間縮短,完成同一件工作的花費反而下降。官方 DeepSWE 成本圖以 Mini-SWE-V2 框架對照 Pass@1 與每任務成本:在 DeepSWE v1.1 上,1017 拿到 77.0 分的同時,max 模式平均每個任務成本約 0.20 美元,前一版 max 模式是 74.2 分、每個任務約 0.50 美元,對照組的 GPT-6 Astra、Gemini 3.8 Flash 與 Claude Opus 5 落在 2 美元到逾 10 美元。
🚀 DeepSeek-V4.1-Flash-1017 is here! Stronger benchmark performance, faster task completion, and shorter outputs than the previous version—a Pareto improvement in performance and cost. Now live on our website, app, and API. 🛠️ Optimized for @DeepSeekHarness, Tencent CodeBuddy, WorkBuddy, and more. Upgrade to DeepSeek Harness v0.2.1-rc.1 or later for the best experience with the new model. 1/4
— DeepSeek (@deepseek_ai) October 17, 2026
公告裡最有記憶點的詞是「許願式編程」。官方說 1017 用自我回饋的強化學習(reinforcement learning with self-feedback)訓練,強化從零開始把整個專案做完的能力,並附上四個展示:紫禁城 3D 建模、網頁版賽車遊戲、用 Godot 引擎復刻《傳送門 2》、以及一個把史前到現代的人類演化做成 3D 動態場景的「Valley of Ages」,官方以這些案例展示從需求到完整專案的能力。許願式編程是官方簡中標題的直譯,官方的說法是提示詞與素材參考極為有限時,也要能直接端出可執行的完整專案;同日把文稿整理成報導的中國大陸 IT 之家就以這四個字當標題。官方同時點名這版針對 DeepSeek Harness、騰訊 CodeBuddy、WorkBuddy 等框架特別調校,建議把 DeepSeek Harness 升到 0.2.1-rc.1 以上。
模型卡把這次更新稱為 minor update。對部署者而言,關鍵是同一架構與提示格式仍可沿用,權重則換成 1017;不必從版本號或社群解碼的系統指紋,推測官方沒有公布的訓練細節。
🎮 Build complete projects from scratch DeepSeek-V4.1-Flash-1017 uses reinforcement learning with self-feedback to improve end-to-end project development—from game creation to 3D modeling. See it in action 👇 2/4
— DeepSeek (@deepseek_ai) October 17, 2026
官方跑分怎麼讀:11 項全上升,贏在 Agent,還沒贏在綜合推理
官方在Hugging Face 的模型卡公布完整對照表,1017 對前代是 11 項全勝,漲幅最大的是 Terminal-Bench 4.0 的 11.1 個百分點。對手欄位裡最有指標意義的兩組數字:DeepSWE v1.1 的 77.0 高於 Opus 5 的 74.0,Agents’ Last Exam 的 35.4 與 Apex Bench v1.1 的 72.1 都是全表最高;但 HLE(無工具)42.6 仍明顯落後 Opus 5 的 56.3,NL2Repo-Bench 68.2 也輸給 Opus 5 的 75.3。這份官方表格顯示,1017 在部分程式與自動化基準已高於對照模型,但仍非所有任務領先;HLE 與 NL2Repo 的分數也不能直接推論長文件理解能力。
| 基準(官方數字) | 9 月版 | 1017 | Opus 5 | GPT-5.6 Sol | GLM-5.3 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | 74.0 | 73.0 | 66.9 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | 51.8 | 39.9 | 37.9 |
| ProgramBench | 20.3 | 29.1 | 37.0 | 23.0 | 19.0 |
| Apex Bench v1.1 | 64.6 | 72.1 | 65.8 | 54.3 | 56.6 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | 50.3 | 45.8 | 48.8 |
| Agents’ Last Exam | 31.8 | 35.4 | 28.6 | 26.7 | 28.5 |
| HLE(無工具) | 36.8 | 42.6 | 56.3 | 44.5 | 42.0 |
| NL2Repo-Bench | 65.4 | 68.2 | 75.3 | 56.8 | 58.0 |
讀這張表時要保留量測條件:Terminal-Bench 4.0 使用 Claude Code 框架,DeepSWE v1.1 使用 Mini-SWE-V2;HLE 括號內數字是純文字子集,ZeroBench-main 採 Pass@5。這些是 DeepSeek 公布的比較結果,各基準的框架、版本與評分方式不同。Artificial Analysis 的連結頁面仍標示 9 月版,沒有單獨標註 1017 快照,不宜直接當作新版的獨立驗證。第三方自有測試方面,Bug Hunt Bench 作者 Paweł Huryn 的首輪貼文列出兩個儲存庫、105 個埋藏的 bug,1017 得 34 分、前代 21.7 分;這是該測試的結果,不能與官方基準直接相加。
把分數差換回實務感也很直接。DeepSWE v1.1 量的是真實儲存庫任務的解決率,74.2 到 77.0 等於同一批題目每百題多解掉將近三題,這是官方報表中的差距;Terminal-Bench 4.0 的 31.2 到 42.3 增加了 11.1 個百分點,但它同時提醒了框架效應的存在,這題官方是用 Claude Code 框架測的,換個框架分數就會變動。讀表的底線:官方表呈現的是這次公布項目的新舊分數皆上升,不能直接換算成你專案的生產力,最終仍要用自己業務裡的固定任務驗收。
「輸出更短」這個官方主打,恰好對上第三方量測長期記錄的一個痛點。Artificial Analysis 目前標示為 9 月版的頁面顯示,這個模型是它們測過數一數二囉嗦的模型:整輪評測共生成了 2.5 億 token,將近同類中位數 1.3 億的兩倍。對把模型接進工作流的團隊來說,囉嗦直接等於帳單與等待時間;1017 若真能在分數上升的同時壓短輸出,等於同時修正成本與體驗兩個面。要判斷 1017 省下多少,仍須在固定任務與相同設定下比較總 token 用量、重試次數與完成時間。
So I tested DeepSeek V4.1 Flash 1017 on real work. 2 repos. 105 hidden bugs. Find and fix what you can.
— Paweł Huryn (@PawelHuryn) October 17, 2026
The first results:
Muse Wonder Full 1.0 (max): 42
Opus 5.5 (max): 41.7
Gemini 4 Argon (high): 40.7
DeepSeek V4.1 Flash 1017 (max): 34
Grok 4.7 (xhigh): 29
Qwen3.8-Max (max): 25.7
DeepSeek V4.1 Flash (max): 21.7
GLM-5.3 (max): 19
A great improvement. Strange that the model wasn’t labeled V4.2. 763B params.
The weights are already on Hugging Face.
I expect the score to change by ~1.7 points after repeating the test 3 times. More data and results at different effort levels dropping in this thread very soon 🧵
YouTube 頻道 AI WITH Rithesh 公布了針對 1017 的自有實測。他在影片說明中寫到,用自己 251 題的測試套件在發布當天跑了兩輪,第一輪 84.2%,拉高 token 預算重跑後拿到 91.5%,影片標題列出的費用為 1.80 美元,說明欄也列出弱項:視覺題 57%,五個網頁 demo 沒做完。
Reddit 上的第一手反應更雜色。有人用同一句提示詞對 9 月版、10 月 12 日的中繼版與 GPT-6 Astra 四模型同題競寫小遊戲,結論是1017 是一次大幅跳升。這類單點體感提供了官方基準以外的觀察,但樣本都還太小,當參考不當定論。
從系統指紋到官方四連發:一天內的完整時間線
1017 的發布方式是這則新聞的第二個故事:先漏,再官宣。台灣時間 10 月 17 日上午 9 點 59 分,自動追蹤模型版本的帳號 AI Tracker Bot 在 DeepSeek 自家 API 的模型清單裡抓到 deepseek-v4.1-flash-1017 這個 ID 閃現幾分鐘後消失,中國大陸快科技把這場秒刪記了下來。接著 Hugging Face 上一個全新儲庫在上午 10 點 40 分建立,權重於 11 點 35 分上傳。同一天,長期盯著 DeepSeek 生產指紋的社群帳號 teortaxesTex 發現 deepseek-flash 回應裡的 system_fingerprint 換了一組新值。Hugging Face 的儲庫時間戳能確認檔案發布順序;社群觀察到的指紋變化,則只是後端變更線索,不能單獨證明模型版本。
system_fingerprint for deepseek-flash just changed. aeb56401ca74e127821c4f9126dcb669 to e72d3c7f663d3e1383b00b3884cb4501
— Teortaxes▶️(DeepSeek 推特🐋铁粉 2023 – ∞) (@teortaxesTex) October 17, 2026
I think DeepSeek V4.1-Flash-1017 is here. it does feel smarter. Probably terser.
下午 1 點 46 分,Hugging Face 儲庫打下名為 Release DeepSeek-V4.1-Flash-1017 的提交。下午 4 點 35 分,官方 @deepseek_ai 發布四則公告串;官網更新日誌與定價頁也已列出新版本。OpenRouter 同日提供 1017 模型入口。社群先前的指紋與模型清單觀察,至此有了正式公告可以對照。
| 台灣時間 10 月 17 日 | 事件 | 性質 |
|---|---|---|
| 上午 09:59 | AI Tracker Bot 抓到 API 模型清單閃現 deepseek-v4.1-flash-1017,隨即消失 | 社群觀察 |
| 上午 10:40 | Hugging Face 新儲庫 DeepSeek-V4.1-Flash-1017 建立 | 官方(時戳可查) |
| 上午 11:24 | system_fingerprint 換新值被社群發現 | 社群觀察 |
| 下午 01:46 | Hugging Face 打下 Release DeepSeek-V4.1-Flash-1017 提交 | 官方(時戳可查) |
| 下午 04:35 | 官方 X 發布四則公告串;更新日誌與定價頁已列出新版 | 官方公告 |
| 同日 | OpenRouter 已提供 1017 快照入口 | 第三方平台 |
9 月 10 日 V4.1-Flash 首發時,台灣 iThome 在隔天報導其效能超越前代 V4-Pro。閱讀該篇背景資料時,要分清楚 9 月首發與這次 10 月 17 日的權重更新,避免把不同快照的價格、跑分或服務狀態混用。
架構不變、只換權重:V4.1 家族的底牌
要判斷 1017 值不值得關注,得先知道它站在什麼地基上。9 月 10 日的首發說明把 V4.1-Flash 定位為新架構家族中最小的模型:552B 參數的混合專家(MoE)骨幹,配上因果編碼器與解碼器(Causal Encoder-Decoder)的非對稱設計,每個 token 在輸入端只動用 8B 參數、輸出端動用 16B,把運算花在該花的地方。上下文上限 100 萬 token,原生支援影像輸入,另有一個 196B 參數的 Engram 條件記憶模組,Hugging Face 側欄合計顯示 763B。官方模型卡將 Engram 描述為以 token lookup 稀疏存取的條件記憶模組;這與每個 token 都啟用所有參數不同。技術細節都寫在《Pushing the Limits of KV Cache Compression》技術報告裡,最狠的一招是把常駐 HBM 的全域 KV 快取壓到每 token 890 bytes,約是前代的四分之一,持久層更壓到約八分之一,這是 Agent 長任務成本的關鍵。9 月的首發模型卡與 1017 的差別,官方只用一句 minor update 帶過。
所謂 minor,vLLM 的部署指南講得最具體:1017 與 9 月版共用同一份架構、config、tokenizer 與提示編碼,只有權重不同,vLLM 已把 1017 設為預設檢查點。對照 7 月 V4-Flash-0731 那次官方明說「僅重新後訓練」,這是 DeepSeek 標準的小版本節奏:架構大改留給下一代,中間用資料與後訓練把分數往上推。想知道這套 MoE 與長上下文設計在整個模型版圖裡的位置,可以回頭看站上對大型語言模型原理與極限的整理,以及同樣走開放權重路線的GLM-5.3 解析。自行部署前要分清權重檔案大小、常駐記憶體、KV 快取與 offload 設定;量化檔案的容量不等於完整推論需求。vLLM 指南也註明,頁面中的硬體驗證數據來自 9 月檢查點,1017 尚未分別重跑。
YouTube 創作者 Bart Slodyczka 的更新解析整理了 1017 的功能、費用與遊戲、3D 案例,可作為官方文件之外的補充觀看。
費用與怎麼用:deepseek-flash 不用改一行程式碼
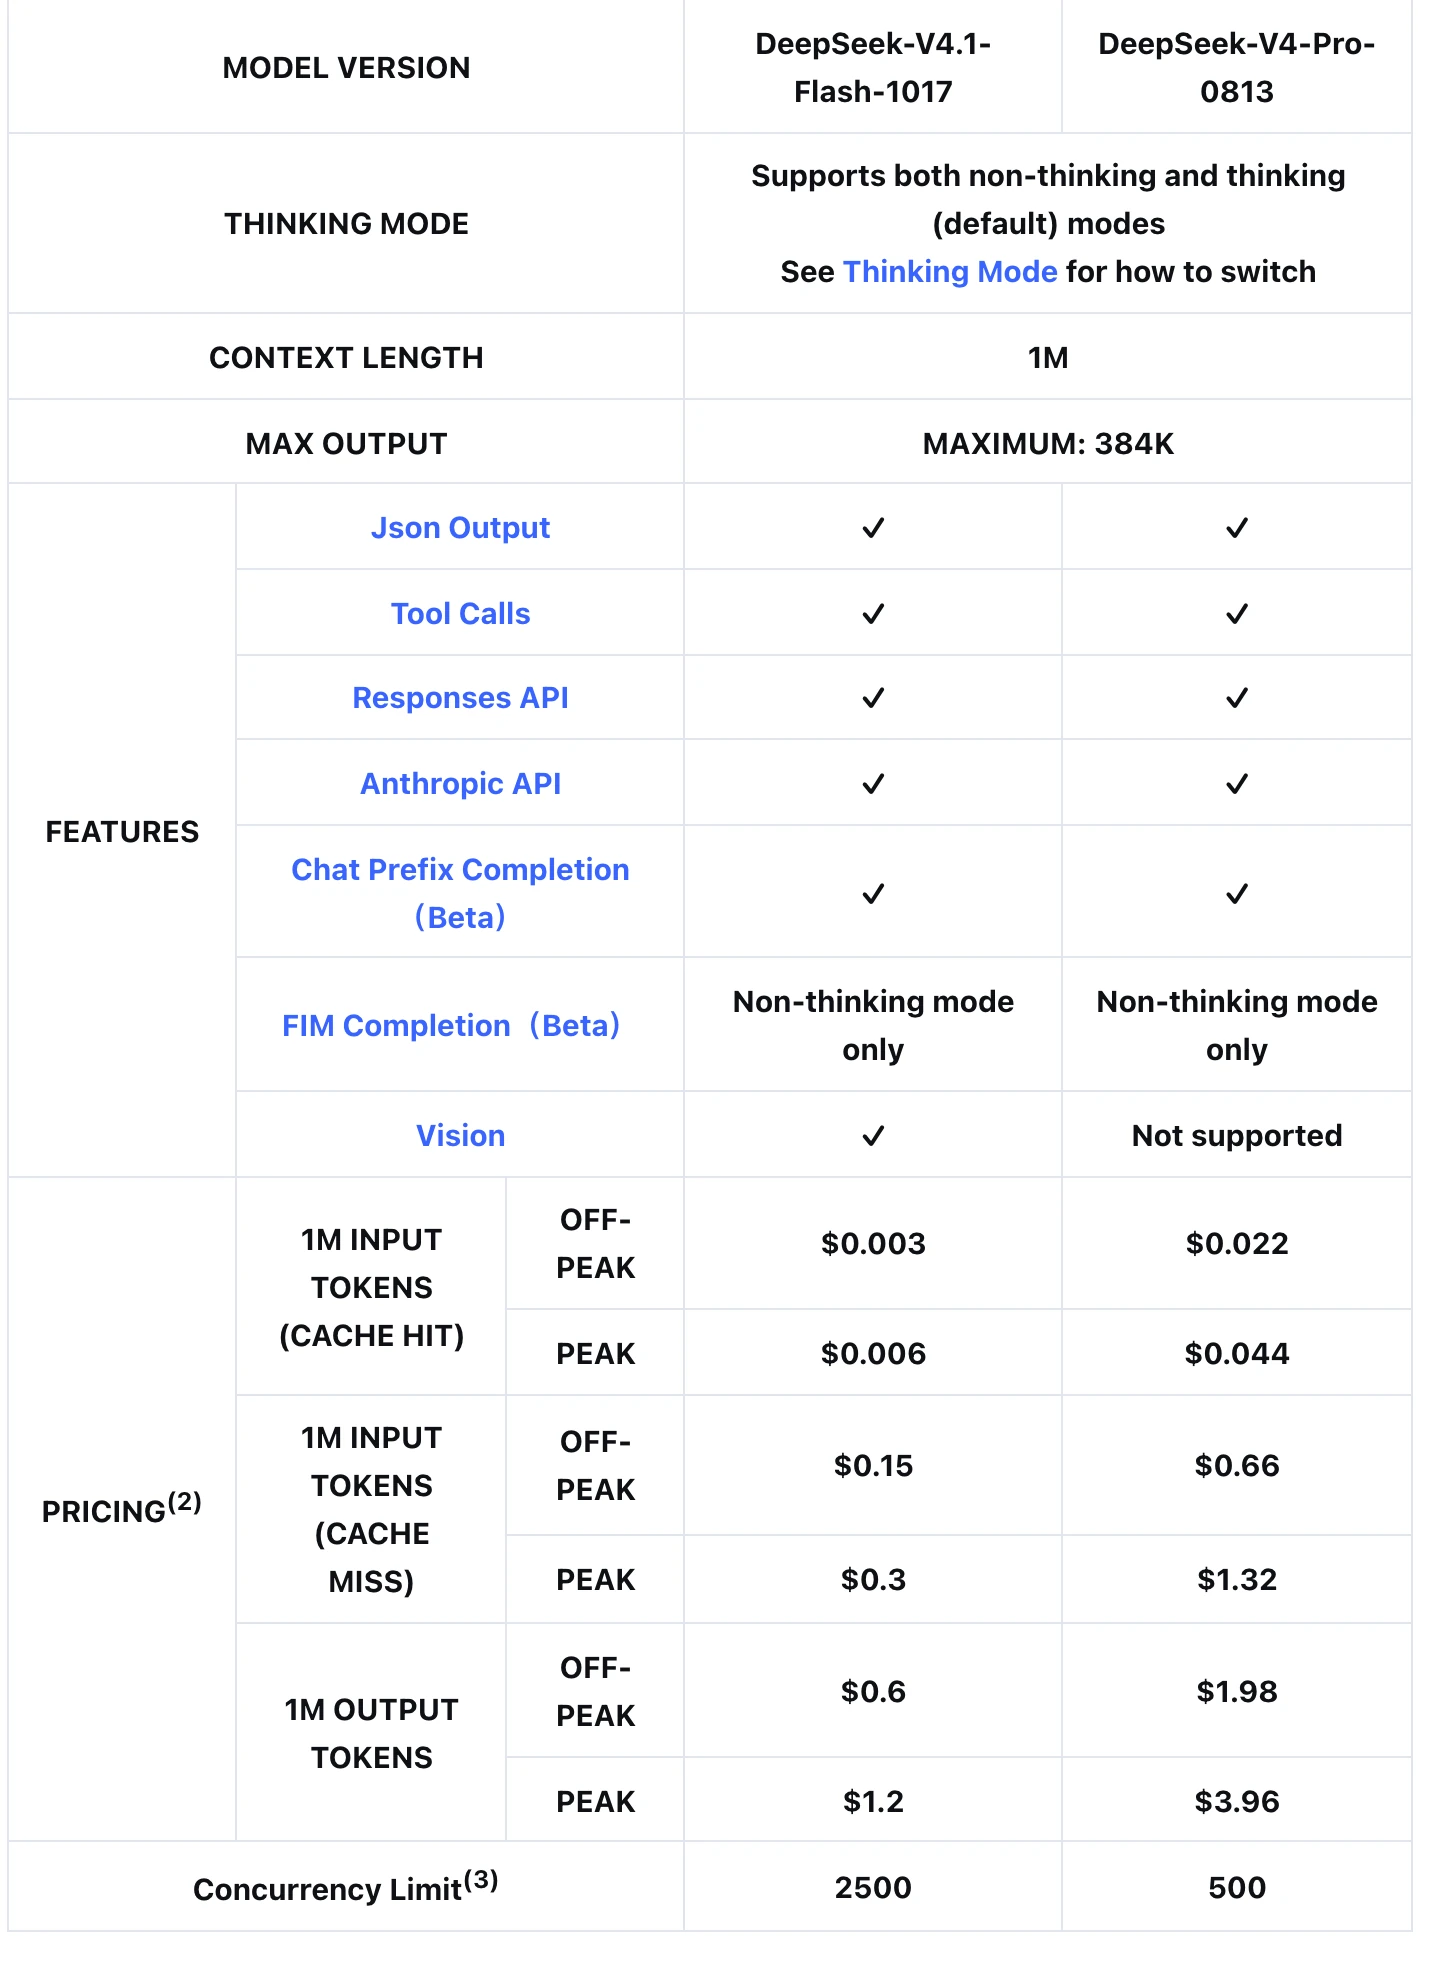
既有 deepseek-flash 使用者不必更改模型呼叫名稱。deepseek-flash 這個模型名稱現在直接由 V4.1-Flash-1017 服務,舊名 deepseek-v4-flash 與 deepseek-v4-flash-vision-exp 仍被接受,但背後模型已退役、改由 1017 接手並按 Flash 費率計費。Models & Pricing 頁的 MODEL VERSION 欄已換上 DeepSeek-V4.1-Flash-1017 字樣,價格表跟 9 月完全相同:離峰時段輸入每百萬 token 0.15 美元(快取命中 0.003 美元)、輸出 0.60 美元;尖峰時段為週一至週五台灣時間上午 9 到 12 點、下午 2 到 6 點,中國法定節假日除外,價格為離峰的兩倍。上下文 100 萬 token、單次輸出上限 384K、併發限制 2500。
| deepseek-flash(每百萬 token,美元) | 離峰 | 尖峰 |
|---|---|---|
| 輸入(快取命中) | 0.003 | 0.006 |
| 輸入(快取未命中) | 0.15 | 0.30 |
| 輸出 | 0.60 | 1.20 |
用一個可以重算的情境把費率表變成立體的。假設一個程式碼代理任務吃進 20 萬 token 的文件與程式碼、吐出 8 千 token 的修改建議,排在離峰跑:輸入端 0.2 乘以 0.15 美元是 0.03 美元,輸出端 0.008 乘以 0.60 美元不到 0.005 美元,合計一個任務約 0.035 美元。同一個任務若輸入全部命中快取,輸入端只剩 0.0006 美元,整單掉到 0.005 美元附近,省下約八成五;挪到平日尖峰時段跑,價格直接翻倍,排程本身就是一個零成本的財務決策。在這個情境中,輸入是否命中快取影響最大。快取命中仍按每百萬 token 0.003 美元計費,不能將架構的 KV 壓縮率直接當成每次 API 呼叫都會命中快取的保證。
同一套算式也能檢驗「輸出更短」實際省多少。若新版把單一任務輸出從 1.2 萬 token 壓到 8 千,每個任務省下的輸出費用約 0.0024 美元,單看很小,乘上月需求量才是真錢,一百萬個任務就是兩千四百美元。反過來想也成立:若輸出變短導致得多跑一次修正,重試會把整批輸入再送一遍,省下的輸出費用可能被未命中的輸入吃回去。建議的驗收方式是固定同一批任務,記錄新舊兩版的輸入量、輸出量、重試次數與成功率,用同一張費率表回算總成本,再決定要不要把主力工作流切過去;只比單價或只比輸出長度,都會誤判。
不想綁 DeepSeek 官方帳號的人有替代路線。OpenRouter 的 1017 頁面同日已提供這個快照;實際費率與可用供應商應以平台當下顯示為準。拿同樣走輕量快速路線的Gemini 3.8 Flash,或之前也打過價格戰的Grok 4.7 對照,可以把 1017 的費率與各模型在自己任務上的成功率一併比較。想在 Claude 生態裡用同級模型的人,也可以參考Claude Opus 5.5 與GPT-5.6 的定位分析再決定工作流怎麼分配。
Search & Fetch API 費用:每千次 0.75 美元,哪些呼叫暫時免費?
跟 1017 綁在同一天上線的 Search & Fetch API,是 DeepSeek 把自研搜尋引擎直接變成產品:兩個端點 /v1/tools/search 與 /v1/tools/fetch 分別負責搜尋與網頁抓取,索引號稱數千億頁、支援多語系,官方在更新日誌裡特別強調會過濾 SEO 垃圾、GEO 操縱與低品質 AI 生成內容,宣稱要「向使用者與 LLM 呈現權威可信的資訊」。計價方式是每個端點每千次成功呼叫 0.75 美元(人民幣計價為每千次 5 元),失敗、沒結果、逾時不收錢;Search 與 Fetch 各自有每帳號每秒 5 次的獨立上限,Fetch 另有每網域限流,回應裡每筆結果附上 0 到 3 級的重排序分數與 0 到 4 級的權威層級(-1 代表未知),供 Agent 選擇來源時參考。這項暫不計請求費的優惠,只明確適用於 DeepSeek API 使用者透過 DeepSeek Harness、Claude Code、Codex 內建伺服器端工具發出的 Search/Fetch 呼叫;台灣時間 2026 年 11 月 1 日零時起開始計費。模型 token 費用仍依原費率計算。細節都在官方指南裡。
Search & Fetch APIs are now open to everyone!
— DeepSeek (@deepseek_ai) October 17, 2026
評估時可以做一輪小實驗,替自己的內容建立基線。挑十篇核心文章,用 search 端點查它們目標的關鍵字,記下每篇有沒有被收回、排在第幾位、權威層級落在第幾級;再挑兩三篇用 fetch 端點抓,看回傳的正文與你自己以為的可抓範圍差多少。這份紀錄就是你站上內容在 DeepSeek 檢索層的可見度基線,之後無論是內容改版或搜尋結果異動,重跑一次就有得比。查不到時,先記錄查詢詞、日期與返回結果,再檢查網站可抓取性;單一查詢沒有出現某頁,不能直接判定該頁未收錄。直接呼叫這兩個獨立端點時,應依每次成功請求的費率估算費用。
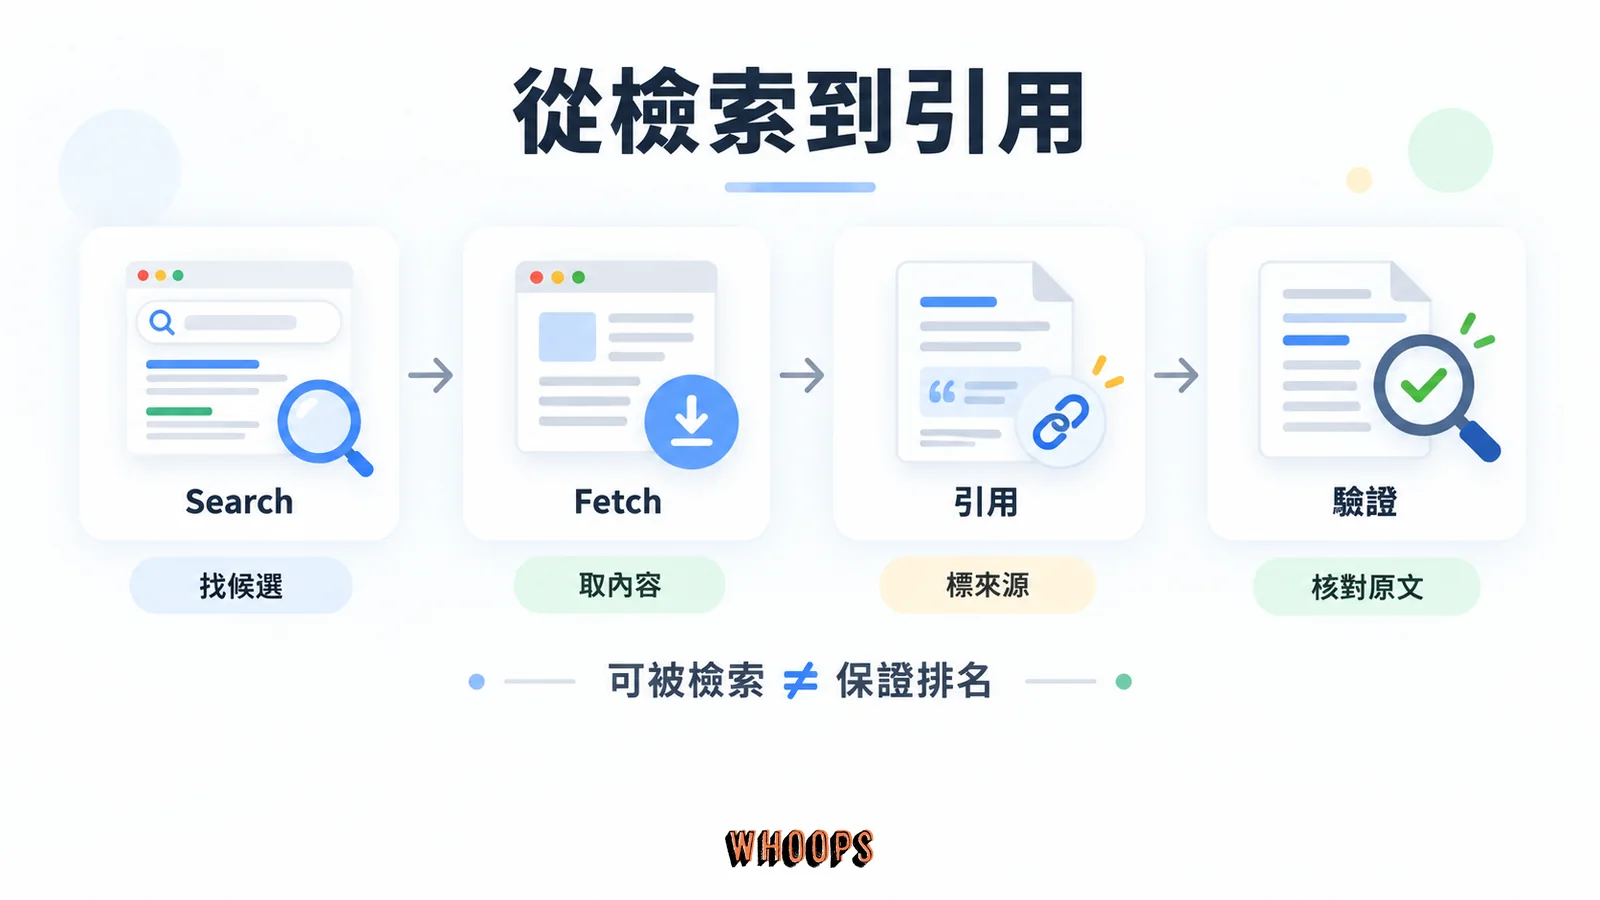
這件事對內容與搜尋工作者的意義,重點不在省下每千次 0.75 美元,而在於另一個大型搜尋引擎明確表態:它的檢索層會主動排除為了操縱排名而生的內容。DeepSeek 沒公布判定細節,過濾成效也待驗證,但這個立場跟 Google 近一年對 AI 垃圾內容的整治方向一致。想跟進這條線的讀者,可以先看站上對AISO 與 AI 搜尋最佳化的完整整理。
現在該做什麼:三種讀者、三個檢查點
API 開發者可以先記錄變更:發一個普通請求,打開回應裡的 system_fingerprint 欄位,跟 10 月 16 日之前存的舊值比對,把指紋變動當作後端更新線索,再對照官方版本說明與固定任務結果;接著用自己業務裡的固定任務跑一次新舊對比,記下輸出長度與重試次數,用總 token 用量與成功率回算成本。網頁與 App 使用者什麼都不用做,已經是 1017,這是體驗新版的其中一個入口。想自行部署則須依完整權重、量化、KV 快取與 offload 方案評估硬體需求,不能只看每 token 啟用參數量。
有兩點會影響實際採用。首先,官方公布的基準與開發者自有測試,題目、框架與評分方式不同;r/LocalLLaMA 的討論與Hacker News 的討論也包含正反兩面的個別經驗。其次,輸出變短只有在任務仍然完成、重試沒有增加時,才會轉化為較低總成本。正式採用前,應用自己的程式庫、文件與驗收條件跑一輪。
接下來可以追蹤明確標註 1017 快照的獨立評測,以及各供應商在自己工作流中的成功率與總費用。內容團隊若要採用 Search/Fetch,先把核心內容的檢索結果存成基線,再觀察內容改版前後的變化,最後決定是否納入正式流程,並將每千次成功請求 0.75 美元計入預算。若目前使用的是 Harness、Claude Code 或 Codex 的免費伺服器端工具呼叫,則應在台灣時間 11 月 1 日零時計費前,確認後續使用量與支出。
DeepSeek V4.1-Flash-1017 常見問題
V4.1-Flash-1017 跟 9 月的 V4.1-Flash 有什麼不同?
官方定位是同一架構的 minor update:config、tokenizer 與提示編碼全部沿用,只有權重更新,vLLM 已把 1017 設為預設檢查點。官方對照的 11 項基準全數上升 2.0 到 11.1 個百分點,Terminal-Bench 4.0 漲最多,DeepSWE v1.1 的 77.0 在官方表中高於 Claude Opus 5 的 74.0。官方表示,新版輸出更短、任務完成更快,單位價格不變。能否在你的任務上同時提高成功率與降低成本,仍需固定任務驗收。
我的 API 程式需要改嗎?費用會變貴嗎?
都不用。模型名稱仍是 deepseek-flash,呼叫方式與費率完全相同,離峰輸入每百萬 token 0.15 美元、輸出 0.60 美元,快取命中輸入只要 0.003 美元。官方表示新版輸出更短,但實際總費用仍取決於輸入、輸出與重試次數。要留意的是尖峰時段:週一至週五台灣時間上午 9 到 12 點、下午 2 到 6 點,中國法定節假日除外,價格為離峰的兩倍,把批次與長任務排進離峰,同樣 token 用量的模型費用可少一半。
這次是偷跑上架,還是正式發布?
這次已有正式發布公告。台灣時間 10 月 17 日上午,社群先觀察到模型清單與系統指紋變動;Hugging Face 在下午 1 點 46 分已有發布提交,下午 4 點 35 分 DeepSeek 再透過官方 X 公告。社群線索與正式發布應分開看,現在可直接以官方文件確認版本。
想自己下載權重來跑,需要什麼等級的設備?
完整權重約 763B 參數、48 個 safetensors 分片,Hugging Face 與 ModelScope 都能下載,MIT 授權可商用。實際部署需求取決於權重精度、GPU 與系統記憶體、上下文長度和 offload 設定,不能用一個容量數字概括。想低門檻體驗,可先走官方網頁、App、API 或提供該快照的第三方平台;下載時則認明官方 deepseek-ai 帳號,並分清官方權重與社群量化版本。
Search & Fetch API 的免費期到什麼時候?
暫不計請求費的範圍是:DeepSeek API 使用者透過 DeepSeek Harness、Claude Code、Codex 內建伺服器端工具發出的 Search/Fetch 呼叫,台灣時間 2026 年 11 月 1 日零時(UTC 10 月 31 日 16:00)起開始計費。獨立 Search 與 Fetch API 則各為每千次成功請求 0.75 美元,人民幣計價為 5 元;失敗、空結果、逾時不計費。兩個端點各有每帳號 5 QPS 上限,Fetch 另受每網域限流。模型 token 費用與搜尋、抓取的請求費應分開計算。
跟 Claude Opus 5 或 GPT-5.6 Sol 比該怎麼選?
看工作類型。官方表中 1017 在 DeepSWE、Automation-Bench、Agents’ Last Exam 這類寫程式與自動化任務超越兩者,官方成本圖亦顯示較低的每任務費用;但 HLE 綜合推理 42.6 對 Opus 5 的 56.3、NL2Repo 68.2 對 75.3,落差明確。可以先用相同程式庫與驗收條件比較成功率、完成時間與總費用,再決定哪些工作交給 1017。官方表中的 HLE 與 NL2Repo 分數,不等於所有長文件或分析任務的表現。
舊的 deepseek-v4-flash 名稱現在呼叫會怎樣?
還能呼叫,但背後已經不是舊模型。官方定價頁註明 deepseek-v4-flash 與 deepseek-v4-flash-vision-exp 兩個舊名仍被接受,對應模型已退役,請求改由 V4.1-Flash-1017 服務並按 Flash 費率計費。舊名稱仍可接受,但模型行為可能改變;若需要 9 月快照,應找明確提供該快照的供應商,或下載舊權重自行部署,並確認實際路由。升級後第一次跑重要流程前,先用小流量驗一輪。
用網頁版或 App 的免費玩家需要做什麼嗎?
官方網頁與 App 已同步更新,不需手動更換模型版本,新對話直接用新版模型,這是體驗新版的其中一個入口。想先感受差異,把同一個問題在網頁版問一輪,再用自己的工作流跑一輪,是最快的煙霧測試;要嚴謹比較新舊版,仍得回到固定任務與計費帳號的對照,免費介面看不出成本與穩定度的差別。

討論與提問