
本篇內容
Jev 是 TypeSafe AI 在 2026 年 9 月 15 日發布的 AI 模型,也是官方稱為 System One Model 的新模型類別中第一個公開版本;TypeSafe 由列名 InstructGPT 論文作者群的 Diogo Almeida 創辦。Jev 不生成自由文字:輸入一段狀態與事先定義的問題,輸出結構化決策及機率,其中 Choice 與 Score 另附 confidence 欄位,概括機率分布的集中程度。
TypeSafe 宣稱:在這類任務上,Jev 的智慧水準與現有 LLM 相當,速度快兩個數量級;輸入每百萬 token 0.042 美元、輸出不收費;「結構上不可能幻覺」是數學保證,不是實測統計。這些數字全部是 TypeSafe 的單方說法。
首頁常見的 193.6 倍加速與 444.6 倍降價出自官方 workflow evals,官方自己承認屬於現實增益的偏高端;第三方早期回報包括 TechCrunch 報導的開發者個案,加速 5 到 18 倍、成本差 10 到 20 倍。
現況:early access 開放中,waitlist 陸續放量;單次查詢的選項基數上限 255;查不到公開 benchmark 成績,官方刻意不公布。判斷框架只有一條:你的工作裡有沒有「需要 AI 又快又便宜地做小判斷」的位置。
2026 年 9 月中旬,一個陌生的模型名稱開始在技術圈流傳:Jev。名字陌生,背後的人不陌生。TypeSafe AI 創辦人 Diogo Almeida 過去在 OpenAI 做讓語言模型學會遵循指令、與人對話的研究,這段背景是他在官方公告裡的自述,而且可以對回公開紀錄:他列名 2022 年發表、後來被稱為 InstructGPT 論文的作者群。兩年前他離開 OpenAI 創辦 TypeSafe,這場發布是兩年低調開發後的第一次亮相,TechCrunch 在 9 月 18 日的報導裡形容它是來自 ChatGPT 發明者的一種新型模型。
After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI?
— Diogo Almeida (@CompleteSkeptic) September 15, 2026
I’ve spent the last 2 years in stealth building a new way to train models (RLCD), and a new type of frontier AI model that we are releasing today: Jev
• 20-200x faster
• 40-400x… pic.twitter.com/JSybNG2BKJ
Jev 特別的地方不在於它比 GPT 或 Claude 更強,而在於它不參加同一場比賽。它不生成文字,也不跟人對話。你給它一段描述現況的狀態,它回傳符合事先定義結構的決策與機率,整個往返以毫秒計。TypeSafe 給這個新類別取名 System One Model,概念借自心理學上快直覺與慢深思的區分,Jev 是第一個公開版本。
想先看 Jev 怎麼運作,可以從下方約 5 分鐘的解說開始。影片以客訴退款分流為例,說明它與 LLM 的分工,以及 Choice、Score、Noul 三種題型如何把資料轉成程式可用的決策。
理解 Jev,要一起看輸出介面、速度與價格的測試條件,以及真實工作流能否用上它。以下從官方文件與早期案例說明它跟 LLM 的差異、適用任務及取得方式,並拆開型別安全的保證與仍需自行驗證的判斷品質。
Jev 是什麼:先把定義講清楚
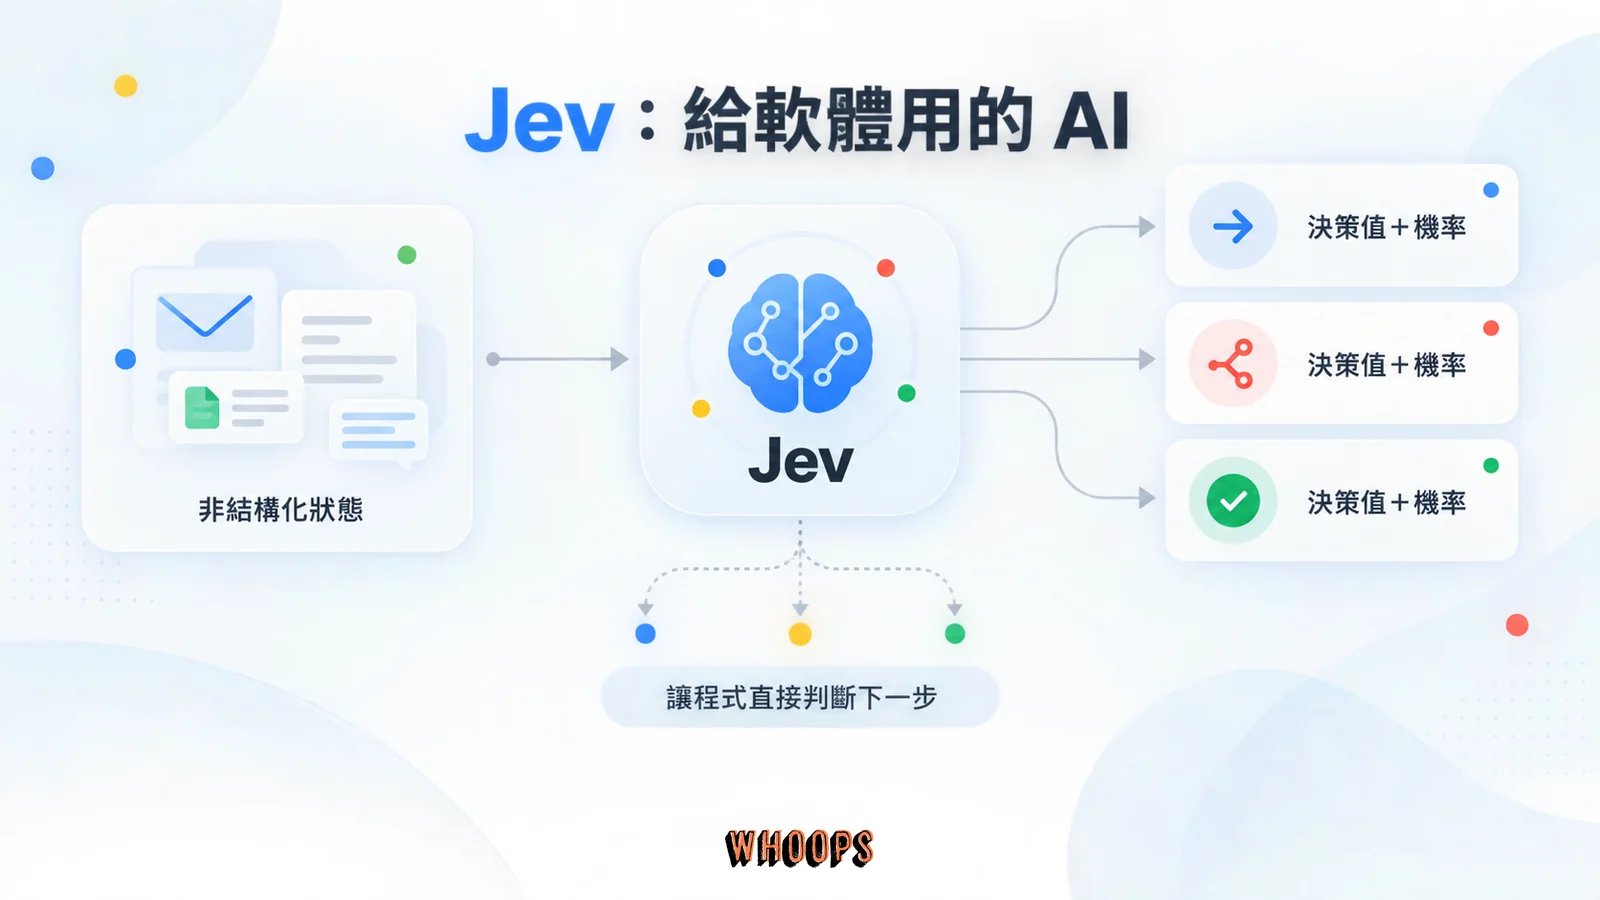
用一句話定義:Jev 是一個以結構化決策為輸出介面的 AI 模型。輸入任意非結構化狀態,例如一段客訴文字、一筆交易紀錄、一份 agent 的執行軌跡,輸出符合事先定義型別的決策值,每個值附帶機率。TypeSafe 在 2026 年 9 月 15 日的發布公告裡給了一個對工程師很好懂的比喻:把 Jev 想成一次前沿智慧的函式呼叫,非結構化狀態進,帶型別的機率決策出。函式呼叫是軟體裡最基本的信任單位,輸入輸出型別講清楚就能放心組合;TypeSafe 想把 AI 放進的正是這個位置。
System One Model 是 TypeSafe 自創的類別名稱,概念取自心理學家 Daniel Kahneman 對兩種思考系統的區分:System 1 快而直覺,System 2 慢而深思。這幾年的 LLM 發展明顯押在慢的那邊,推理模型願意花更多時間思考再回答;System One Model 押在快的那邊,專門處理軟體裡必須在幾百毫秒內做完的判斷。名字裡的典故,以及 TypeSafe 對未來的押注,後面有專節拆解。
它跟 LLM、SLM 的關係,官方 FAQ 裡有一句直接的回答:Jev「既不小、也不是 LLM」。這是在區分產品的任務與輸出介面,不能因此推論它完全不使用語言模型的技術。TechCrunch 報導稱 Jev 採用 transformer 架構;官方則把新的模型架構、並行取樣器與 RLCD 分開介紹。具體網路怎麼接、用了哪個基礎模型,目前不能從這些描述還原。
至於背後的公司,TypeSafe 的團隊頁由 Diogo Almeida 任 CEO,TechCrunch 的報導列出的共同創辦人是 Almeida、Erik Gafni 與 Sasha Sheng。Almeida 在 OpenAI 的經歷可以對回那篇 2022 年的論文;TypeSafe 對外的說法是「共同發明了 RLHF 與 InstructGPT」,這是官方自述,其中能獨立核對的部分是論文作者名單。產品現況:Jev 自 9 月 15 日起開放 early access,排 waitlist 陸續取得資格。
為什麼有人說 Jev 是「給軟體用的 AI」
因為 Jev 的輸出不是給人讀的文字,而是程式可以直接消費的決策與機率:程式碼掌握流程,模型只負責語意判斷。公告開場的第一句話,是 Almeida 自述過去四年的驅動問題:模型在聊天上早就超人類,那麼自動化在哪裡?他接受 TechCrunch 訪問時講得更具體:我們把閃電裝進瓶子裡,它卻派不上用場;問題出在人類語言被當成最佳化目標,而電腦說的是另一種語言。這句話幾乎就是 Jev 存在的全部理由。
這套「為什麼」的論證,Almeida 本人在 AI Engineer 頻道的演講裡親自講過一遍,將近二十分鐘,時間點在正式發布之前:
把這個落差放進工程裡看:模型若以自由文字回答,程式得從字串取出結果、檢查欄位,再決定要不要執行。只靠 prompt 要求 JSON,仍可能遇到格式漂移;即使採用嚴格結構化輸出,欄位裡的判斷也可能錯。Jev 把任務集中在事先定義的決策及機率,省去自由文字生成與解讀的路徑。比較時必須分開看格式、語意品質與延遲,不能把這三件事混成一項保證。
TypeSafe 把目標任務的形狀歸納成五個動詞:classify 分類、route 路由、score 評分、extract 擷取、branch 分支。五個動詞在實務上各自長這樣。分類是把一筆東西放進事先定義的類別,來信是退款、諮詢還是投訴。路由是決定下一站,這張工單派給哪個團隊、這個請求打進哪條管線。評分是給連續的量,這則留言的違規程度、這筆交易的風險、這份履歷跟職缺的相配度。擷取是從非結構化裡抽出結構,合約裡的到期日、信件裡的訂單號碼。分支是流程層的判斷,這一步走自動還是走人工、要不要提前結束。翻成工作流的語言,這就是程式裡每一個「如果怎樣、就走哪條路」的判斷點;這些判斷過去只有兩種做法:寫規則,精確但脆弱;塞 LLM,有判斷力但慢、貴,而且用完還要幫它收尾。
再把帳算粗一點,數字是假設量級,用意是感受規模差。一個產品裡如果有二十個決策點,每個每天跑一萬次,一天就是二十萬次判斷。用 LLM 做,每次即使只要一秒與一美分等級的費用,延遲與帳單會逼你把大多數判斷改回規則;用宣稱中的 System One 形態,每次數百毫秒、單次成本不到百分之一美分,把判斷留在模型這邊變得可行。自動化吃掉的從來不是單次呼叫的強大,而是單次呼叫夠便宜、夠快、夠可靠:便宜到可以浪費,快到可以即時,可靠到不用人盯。這是數量級的問題,不是百分比的問題。
所以「給軟體用的 AI」不是行銷話術,是介面位置的描述。人與模型的協作,聊天、寫作、寫程式的 copilot,仍然是 LLM 的主場,官方比較表也把這些劃給 LLM;Jev 爭取的是軟體內部那一層,程式碼掌握流程,模型只負責語意判斷。想回顧這套主流範式的原理與限制,站內的大型語言模型專文有完整整理;coding agent 這類人機協作的實際用法,站內的 Claude Code 教學走過一遍完整流程。
Jev 跟 LLM 差在哪:三個結構性差異
官方比較表列了八個面向,歸結起來是三個結構性差異:輸出介面、取樣方式、訓練目標。這三件事互相咬合,後面所有價格與速度的宣稱,都是從這裡長出來的。
輸出介面:字串換成型別安全的決策
一般生成式 LLM 透過 token 序列交付答案;Jev 則先由開發者定義問題與候選答案,再回傳決策值及機率。從功能上,可以把它理解成 P(答案|state、問題、選項定義)。這是介面的行為抽象,並非官方公布的神經網路公式。依官方 System One 文件,Jev 目前處理文字、JSON 物件與文字陣列,不直接接收圖片、音訊或影片。
API 回應仍可用 JSON 傳輸,SDK 也仍會解碼回應;差異在於模型不必先生成一段 JSON 文字,再由應用程式從中還原決策。型別與答案範圍受到限制,也不表示整次網路請求保證成功,整合時仍需處理逾時、服務錯誤及業務規則。
概念上有個恰好的對照。做 SEO 的人熟悉的結構化資料就是同一套思路:先把欄位定死,內容只能照欄位填,機器才能穩定讀取。Jev 同時回傳機率,程式可以據此設定分流條件;能信任到什麼程度,仍要靠實際資料驗證。
取樣方式:逐一 token 生成換成並行輸出
自回歸語言模型會根據輸入及已生成的內容,依序產生下一個 token;若還要生成推理過程或每個選項的機率,輸出工作量就會增加。TypeSafe 公開的差異是並行取樣:Jev 在一次查詢中回傳各題的機率結果。這說明它省下了哪些生成工作,但不足以證明底層只做一次神經網路前向運算。官方列出的 70 至 500 毫秒延遲,也仍取決於輸入、問題規模與服務條件。
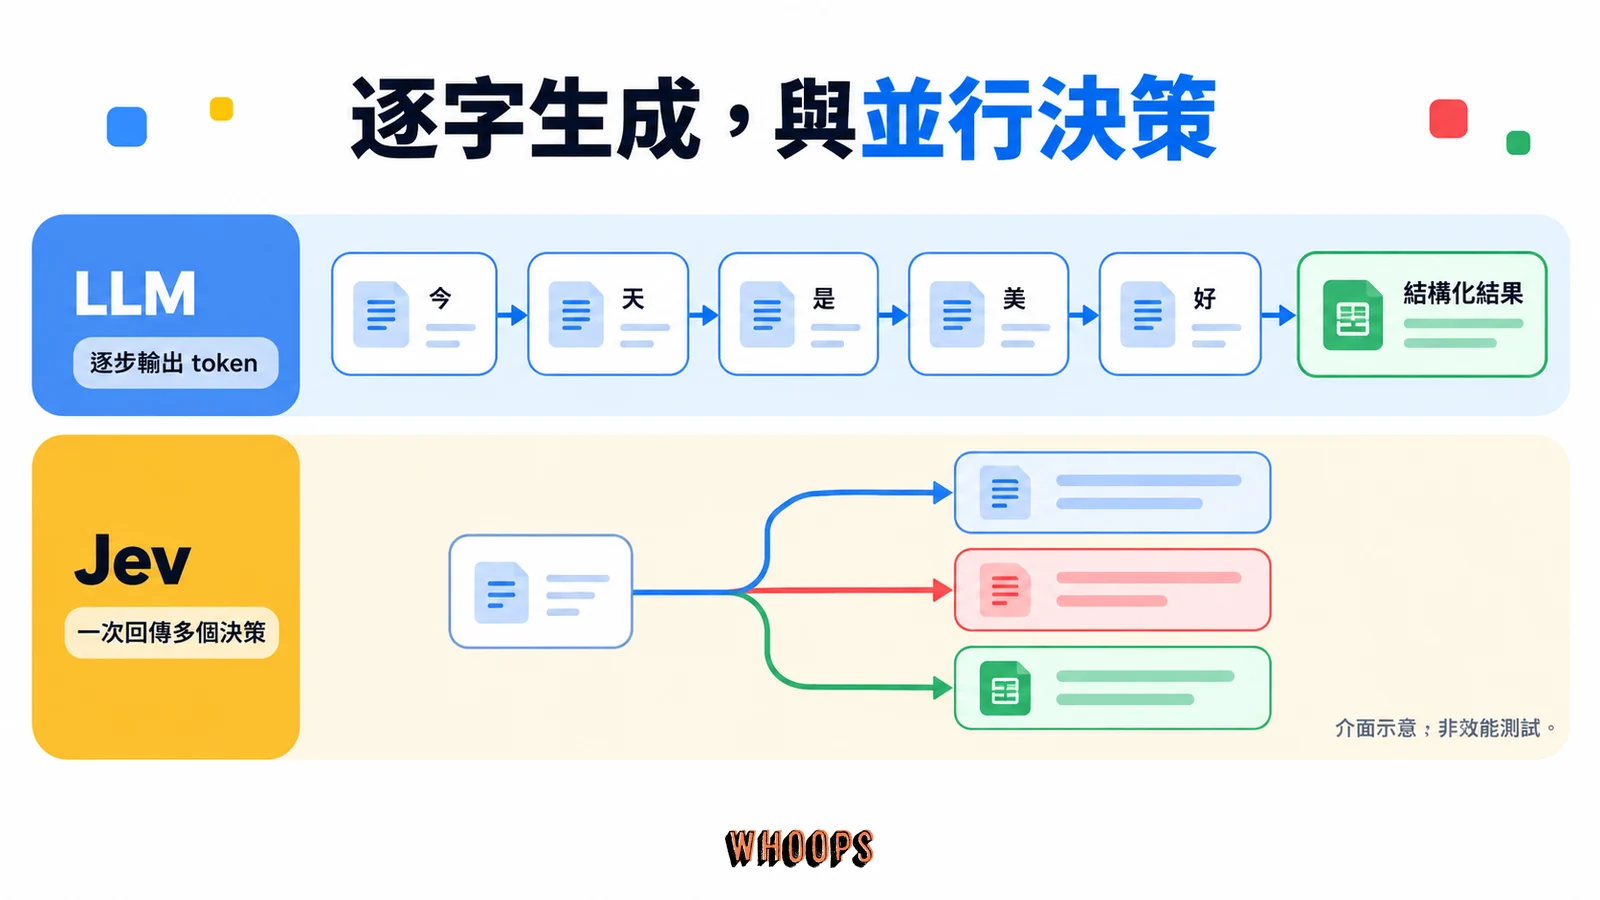
這個機制也解釋了計費結構。輸出不是逐 token 生成,而是對事先定義的選項結構給機率,運算成本集中在輸入端的理解,TypeSafe 因此把輸出定價為零,用「便宜到不值得計量」形容。要說明的是,這一段成本結構的解釋是從官方的機制描述推導出來的;官方沒有公開完整的成本模型,實際上有沒有補貼,他們自己也說無法證明、需要時間驗證。
訓練目標:從 RLHF、RLVR 到 RLCD
三個縮寫代表三種「告訴模型什麼叫做好」的方式。RLHF,人類回饋強化學習,最佳化的是人類評審偏好的文字,ChatGPT 的成功證明它對聊天產品有效,但評審喜歡的文字不等於軟體能直接使用的決策。RLVR,可驗證獎勵強化學習,適合數學證明、程式最佳化這類能寫程式判定對錯的任務;官方 FAQ 的說法是,多數真實世界的判斷任務不是那個形狀。RLCD,校準決策強化學習,是 TypeSafe 為 System One 介面設計的訓練法,直接對結構化決策最佳化,並要求機率具備認識論上的誠實,講白話就是:不確定的時候,要用機率老實說出來。
TypeSafe 的 AI primer 把 RLCD 與 RLHF、RLVR 並列為後訓練方向。這能幫助理解設計目標:不只選對答案,也希望分配給答案的機率能對上實際結果。它沒有公開足以重現訓練的完整配方,因此不能只憑 RLCD 這個名稱,推定獎勵函式、損失公式或校準效果。
官方在另一篇談任務選擇的長文裡把賭注講得很清楚:最佳化對的任務,比資料、算力或演算法更重要。這是對自家路線的辯護,也是對整個產業的批評;文中對 RLHF 與 RLVR 的描述取自官方的簡化口徑,各實驗室的實際做法比這個複雜。對讀者來說,記住因果鏈就夠:訓練目標決定模型擅長什麼。LLM 被訓練成出色的對話者,Jev 被訓練成出色的判斷者,至少 TypeSafe 的宣稱是這樣,驗證方法後面會給。 這條因果鏈有現成樣本:GLM-5.3 靠後訓練衝高戰力,是開放權重陣營的活案例。
能理解文字,為什麼不一定要生成文字?
語言理解與文字生成可以分開設計。早在 BERT 論文,預訓練的語言表徵就能搭配輸出層處理分類等任務。就功能而言,把 Jev 理解成能以自然語言指定問題的分類與評分模型,有助於掌握它的用途;但這個類比不能用來斷言 Jev 就是 BERT,或只是某個模型加上一層 softmax。
目前公開資料足以說明 Jev 的介面、取樣方向與訓練目標,仍不足以還原基礎模型、參數量及完整網路拓撲。RLCD 是訓練方法名稱,不是取代 Transformer 的架構名稱。判斷這項技術時,可先驗證外部行為,再把未公開的內部設計留作未知。
一個查詢長什麼樣:從定義問題到拿到決策
理解一個 Jev 查詢,先看 state 與 questions:前者是要判讀的資料,後者定義要問什麼、答案可以長什麼樣。依官方 Primitives 文件,目前有三種基本題型。
Choice、Score、Noul 各自回傳什麼?
| 題型 | 回傳方式 | 客訴分流的用途 |
|---|---|---|
| Choice | 各選項的 probabilities、機率最高的 choice,以及 confidence | 在退款、諮詢、投訴等候選類別中選一個 |
| Score | 各等級的 probabilities、加權位置 score、等級說明 legend,以及 confidence | 依事先描述的等級評估問題嚴重程度 |
| Noul | 敘述成立的機率 noul,沒有獨立的 confidence 欄位 | 判斷來信是否明確要求退款,再由程式設門檻 |
Score 的等級位置從 0 開始。假設三個等級的機率是 0.1、0.3、0.6,加權分數就是 0 × 0.1 + 1 × 0.3 + 2 × 0.6 = 1.5。這是計算示例,並非實測。依官方 Score 說明,1.5 表示在所定義量尺上的位置,不能當成精確金額、天數或物理量;不同機率分布也可能得到同一分數,要連同分布一起讀。
把三種題型放進客訴工作流
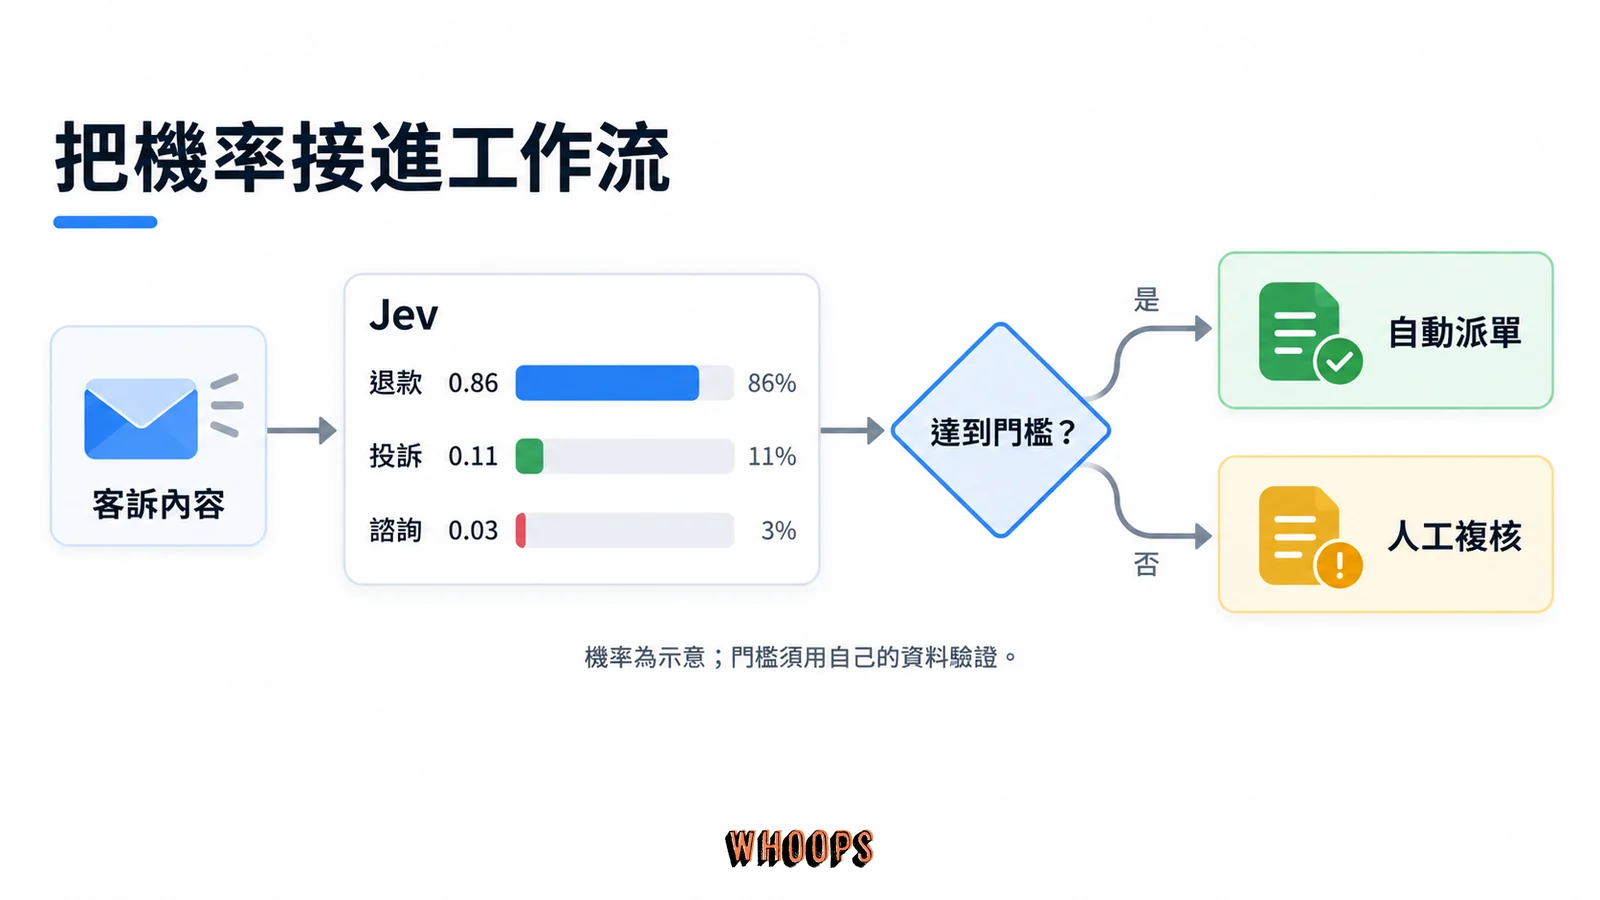
拿客訴分流演練一次,以下欄位與數字都是假設。先用 Choice 定義主要訴求,例如退款、諮詢、投訴;再用 Score 描述「不影響使用」「有替代做法」「完全無法使用」三個嚴重程度;是否明確要求退款則交給 Noul。選項若無法涵蓋所有來信,還要加上「其他」或「資訊不足」的出口,避免模型被迫在不合適的選項裡挑一個。
接著把來信、相關交易與處理政策放進 state。假設 Choice 回傳退款 0.86、投訴 0.11、諮詢 0.03,最高機率的 choice 就是退款。程式可以檢查退款機率是否超過自動派單門檻,再合併其他判斷與確定的業務規則。這裡的 0.86 是某個選項的 probability,不能直接當成 API 的 confidence;退款是否真正執行,也仍由程式決定。
用 LLM 做同一件事,必須區分 JSON mode 與嚴格結構化輸出。前者主要確保 JSON 語法,後者可透過 constrained decoding(受限解碼),限制每一步可產生的 token,使完成的輸出符合支援的 JSON Schema。OpenAI 對 Structured Outputs 的技術說明就公開了這個方法,也提醒內容仍可能出錯,拒答或生成被截斷仍要另行處理。
因此,合法格式並非 Jev 獨有。更有意義的對照是:同一份狀態、同一組問題,以及是否都要回傳完整機率分布,兩邊的正確率、校準、延遲與費用各是多少。LLM 可以生成機率數字,但這些數字是否校準必須驗證;Jev 則把校準決策列為明確的訓練目標,實際效果同樣要驗。
平行回答很多題,與串起一條推理鏈的差別
當多個問題共用同一份資料,可以合成一次請求。例如判斷文章主題、讀者程度與商業意圖,不必為每一題重送全文。官方的批次問題範例說明,這能減少重複輸入費用與往返;若分開的請求原本就同時執行,延遲差距會縮小。因此,批次化的節省與並行取樣的節省要分開看。
同批問題各自讀取相同的 state,答案不會成為其他題目的隱藏上下文。若第二題需要第一題的結果,才能選擇要查的資料或候選答案,就由程式接收第一輪結果、更新 state,再發第二輪請求。這是官方文件列出的依賴處理方式:可並行的判斷一起做,有先後關係的步驟仍要分層。
選項很多的時候還有第二層設計。單次查詢的基數上限是 255,遇到數千個連結、上萬筆候選這種場景,官方的做法是兩段式:先對候選獨立評分,再從最高分的前幾名做明確選擇。「在大集合裡挑一個」被拆成「先粗排再精選」,每一段的速度與成本都可以自己控制。這個模式後面在 Wikiracing demo 會再出現一次。
熱門案例:7 秒查機票,Jev 負責選動作
把「狀態進、決策出」放進瀏覽器,差異就更具體了。Browser Use 共同創辦人 Gregor Zunic 展示的 Jev Ultrafast,每一步先把網頁的 DOM 狀態與可操作選項交給 Jev,再執行選中的動作;需要輸入文字時,由小型 LLM 補上。作者回報,影片中的查機票任務花約 7 秒、模型成本約 0.0039 美元,影片為原速。 讓 AI 在瀏覽器裡逐步操作的思路,也出現在會自己操作電腦的 Grok Bot這類產品上,同樣以連續動作取代單次問答。
Gregor Zunic:Browser Use+Jev 查機票實機影片
這則案例在本次查核時約有 264 萬次瀏覽。它把兩種模型的分工說得很清楚:Jev 選下一個動作,LLM 處理必要的自由文字。這是作者的一次任務示範,成功率、網站差異與重試成本仍要另行測試,不能把「選到合法按鈕」當成「完成了正確任務」。
官方比較表:既有 LLM 對上 System One 加 Jev
下表整理自 TypeSafe 公布的比較表,立場是官方的,數字也是官方引述的口徑,兩側都不是獨立測試結果;表後挑出真正會改變採用決策的三個差異。
| 面向 | 既有 LLM(官方引述口徑) | System One+Jev(官方宣稱) |
|---|---|---|
| 最佳化方法 | RLHF 人類回饋強化學習;RLVR 可驗證獎勵強化學習 | RLCD 校準決策強化學習 |
| 最佳化目標 | 人類評審偏好的文字;可程式驗證的獎勵 | System One 任務上的校準決策,附帶認識論誠實的機率 |
| 輸出 | 字串,軟體使用前需解析與驗證 | 型別安全的結構值,結構事先定義,附機率與信心分數 |
| 取樣方式 | 序列式,逐一 token 生成 | 並行,單次查詢產出所有輸出,硬體感知 |
| 成本 | 輸入每百萬 token 0.20 至 10 美元,輸出約為輸入 5 倍貴 | 輸入每百萬 token 0.042 美元,輸出不收費 |
| 端到端速度 | 3 秒至 329 秒 | 70 至 500 毫秒,宣稱同級智慧下快 40 至 200 倍 |
| 信心表現 | 官方稱傾向過度自信且不一致 | 宣稱每個輸出附校準機率,相似輸入得相似答案 |
| 適用場景 | 人機協作:chatbot、copilot、coding agent;可驗證問題;demo 原型 | 軟體內嵌判斷:分類、路由、評分、擷取、分支;大量資料處理;即時應用;驗證與護欄 |
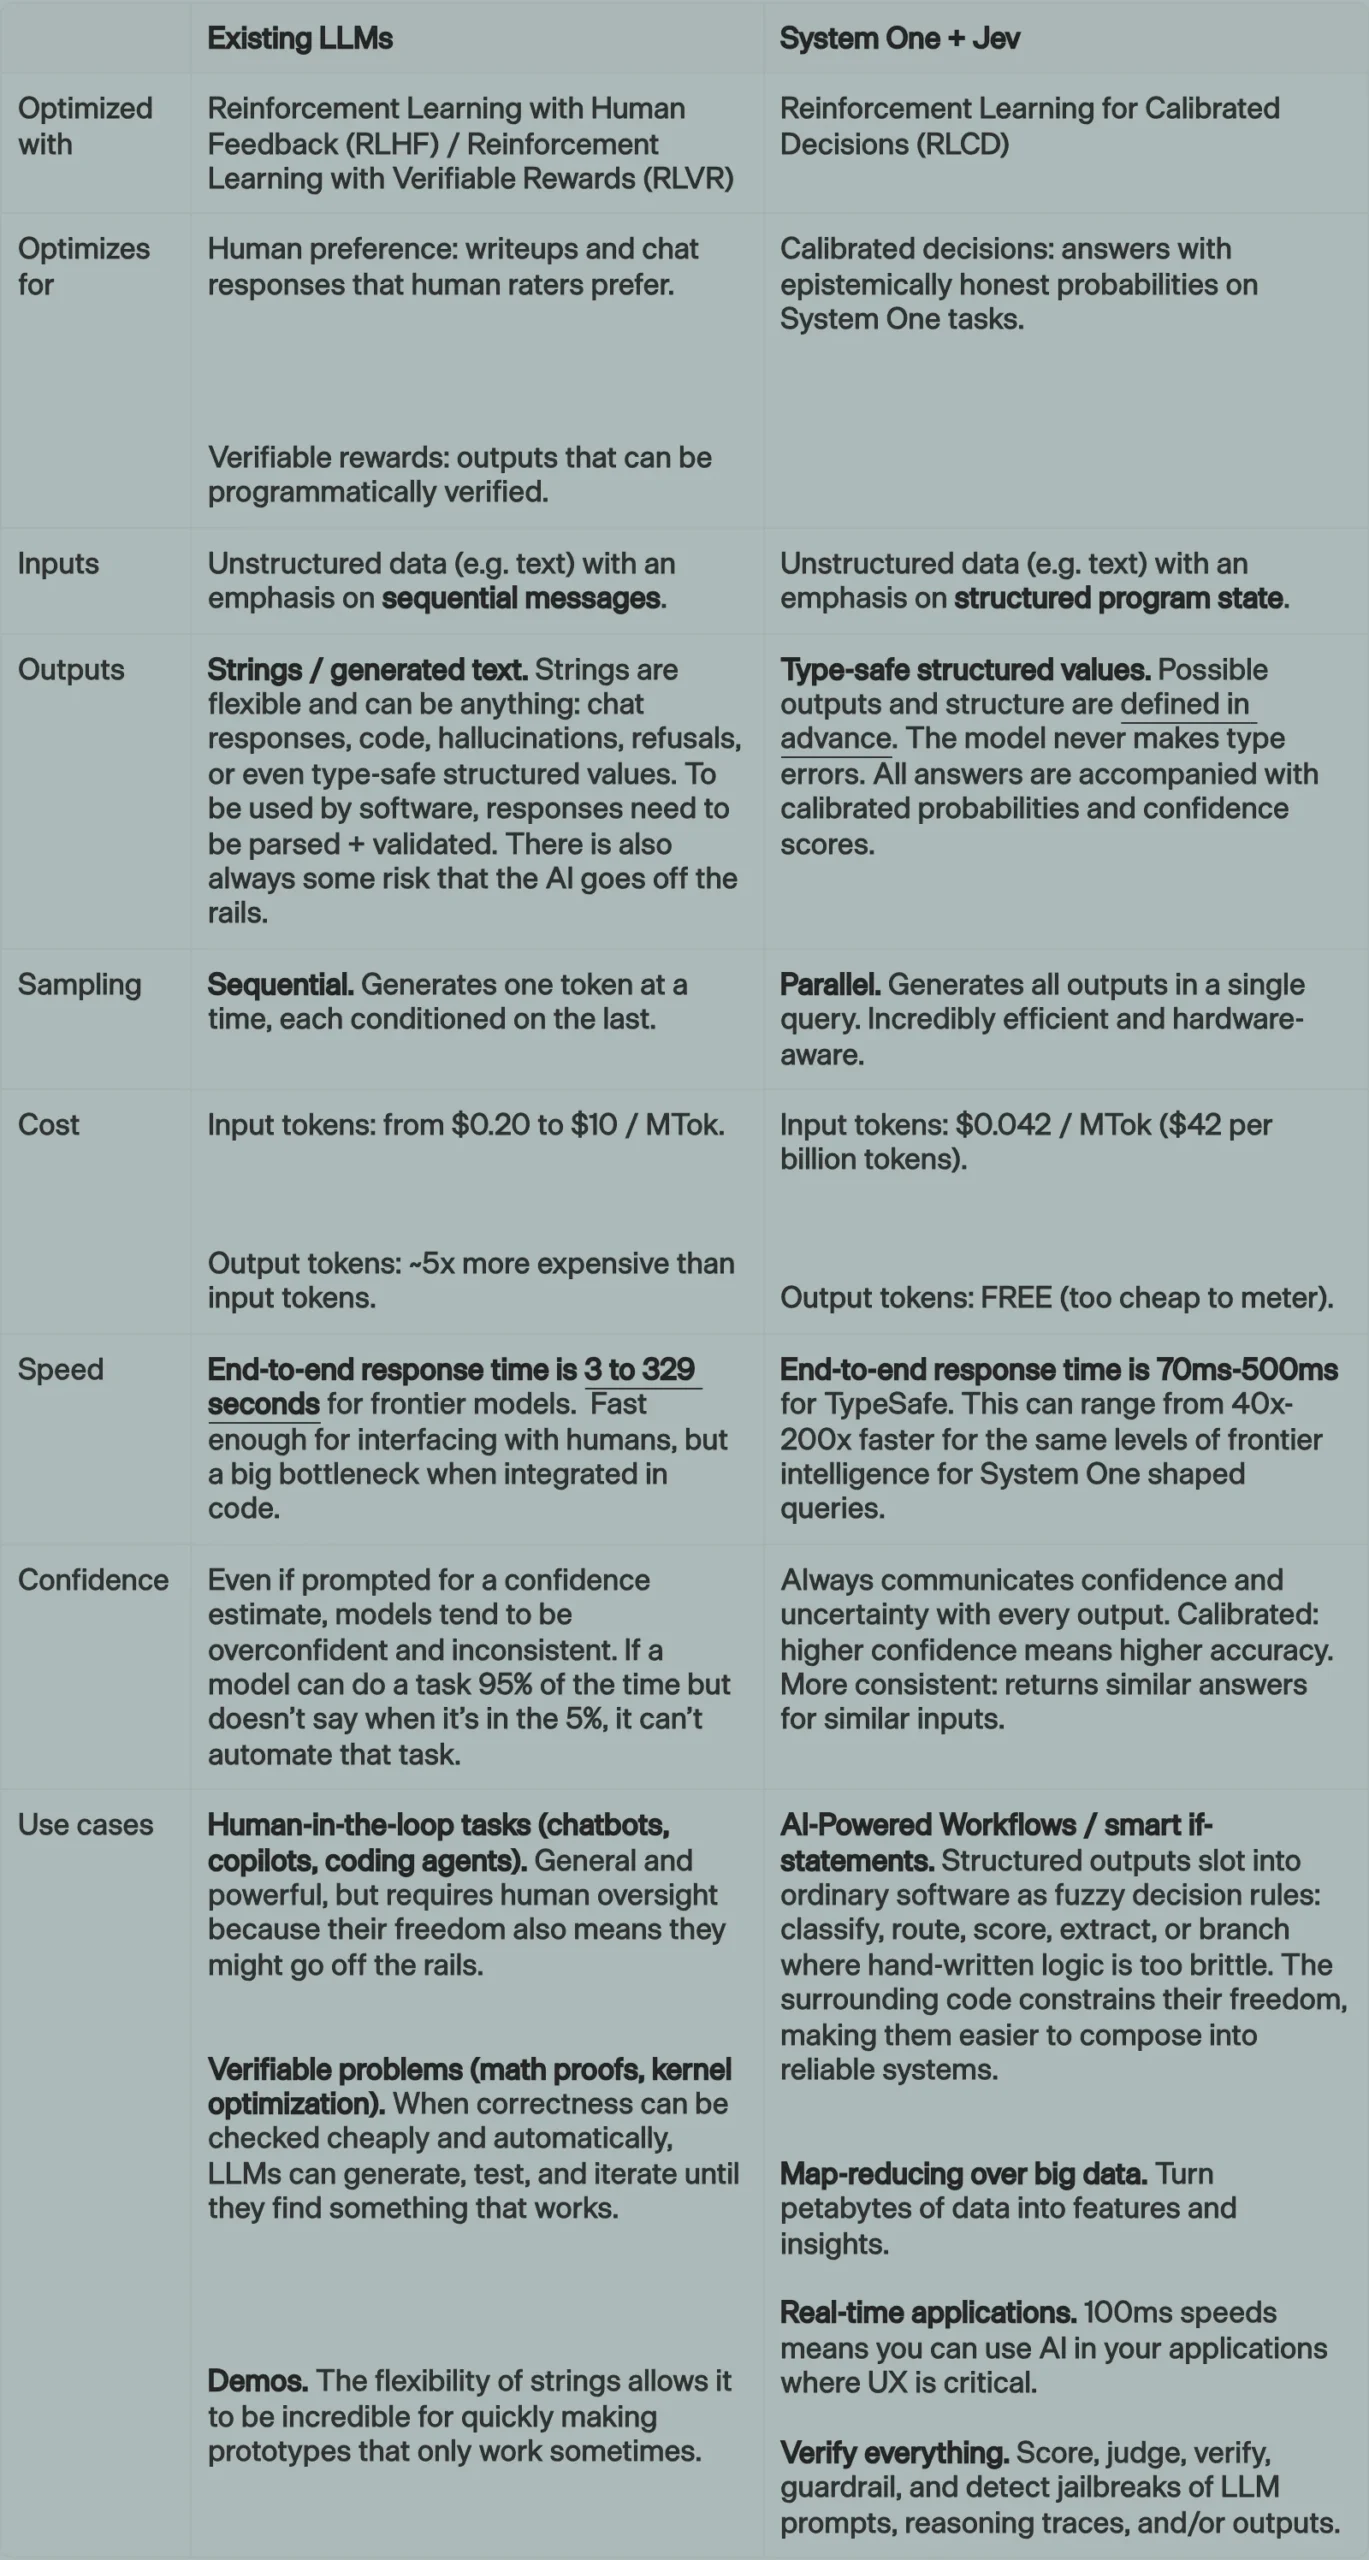
比較表最直接的工程含意,是決策如何交到程式手上、一次工作流要花多少,以及不確定性如何處理。Jev 減少從生成文字還原決策的工作;採用嚴格結構化輸出的 LLM 也能提供合法欄位。Jev 的輸出不另計費,但完整成本仍要看輸入與呼叫次數;它回傳機率與分布摘要,但能放行到什麼程度,仍要量測自己資料上的品質。
表裡最容易被忽略的是適用場景那一行。它寫的不是誰取代誰,而是分工:人機協作留給 LLM,軟體內嵌判斷交給 System One。公告頁在這一段附了並排比較的示範影片,同一組問題分別丟給 Jev 與 LLM,一邊是整批機率同時跳出來,一邊是文字慢慢接出來,速度差的視覺感受非常直接。
Jev 價格與速度宣稱:數字背後的條件
價格先講。官方定價是輸入每百萬 token 0.042 美元,即每十億 token 42 美元,輸出不收費。對照表引述的 LLM 輸入單價為每百萬 token 0.20 至 10 美元,輸出單價約為輸入的五倍;這是公告採用的比較範圍。實際帳單還取決於輸入長度、呼叫次數,以及對手要生成多少答案或推理 token。Jev 不另計輸出費,也不交付生成的推理文字,但不能只用輸入單價推算整個工作流能省多少。
換一個角度感受計價規模:TypeSafe 的計費以十億 token 為單位思考,TechCrunch 的說法是輸入按十億而非百萬計量。做一個可重現的假設計算:一百萬筆待分類的內容、每筆輸入兩千 token,輸入量是二十億 token,以官方單價計是 84 美元;同樣的量丟給每百萬 5 美元等級的 LLM,光輸入就要一萬美元,輸出費用還要依實際輸出量另計。這就是「大量資料的 map-reduce」被列為主打用途的原因:只有在這個單價上,對整個資料庫跑一遍智慧判斷,才會從專案變成例行公事。數字是假設換算,重點是量級,不是精確值。
速度的宣稱是 70 到 500 毫秒端到端,條件是 System One 形態的查詢;官方在同級智慧的條件下宣稱快 40 到 200 倍。還有兩個更嚇人的數字,193.6 倍加速與 444.6 倍降價,出現在 TypeSafe 首頁,來源是官方的 workflow evals,官方自己承認這屬於現實增益的偏高端,不該當成日常保證。速度也是官方認為最容易自行驗證的部分:evals 多數從美西的筆電直接跑,evals 站台公開在那裡,可以重跑。
第三方的獨立數字目前很少,TechCrunch 的報導訪到的兩個個案最有參考價值。Vercel 的工程師說,團隊原本用 OpenAI 的模型跑指令安全分類,換成 Jev 後速度快 5 到 18 倍,而且準確度更高。另一家 Bryo AI 的技術長拿 Jev 跟 Gemini 比商務 email 分類,結論是 Gemini 略準,但貴 10 到 20 倍,他更看重的是 Jev 回傳真正的機率,適合拿來驅動自動化流程。兩個都是單一個案、開發者的單方說法,不能推成普遍結果;但方向與官方宣稱一致,成本與速度的優勢比準確度的優勢明確。 被拿來當對照組的 Gemini 系列,Gemini 3.8 Flash 的價格與功能是一個可參考的座標。
We're seeing extraordinary results from @typesafeai. Default mode in 𝚏𝚡 is auto, with a safety reviewer analyzing every command.
— Guillermo Rauch (@rauchg) September 16, 2026
That reviewer runs on GPT Luna today. Jev is up to 18x faster (p95) *and* more accurate. It's coming to @vercel AI Gateway and likely new default. https://t.co/y5tFnlFN2l
價格宣稱的界線,官方自己講了三句話,值得原樣記住:定價透明,但無法證明沒有補貼;永續性需要時間證明;方向預期只降不升。新服務的低價可能來自規模效率,也可能來自成長期補貼,雲端服務史上兩種結局都出現過。要把 Jev 放進關鍵路徑之前,把「價格可能變動」寫進假設,是比較穩的做法。 用價格當武器的劇本在模型市場並不新鮮,Grok 4.5 拿評測成績對照 API 價格的打法,走的正是同一種競爭。
校準是什麼:Jev 品質宣稱的真正核心
校準指的是模型給出的機率與長期實際發生頻率一致:假設模型把一批事件的成立機率都估在 80% 左右,校準良好時,這批事件長期應約有八成成立。氣象預報是常見例子:預報降雨機率 70% 的那些日子,大約七成真的下雨。價格與速度之外,機率能不能用來決定下一步自動化,就看校準;它檢查的是一組預測的統計表現,不能保證某次判斷正確。
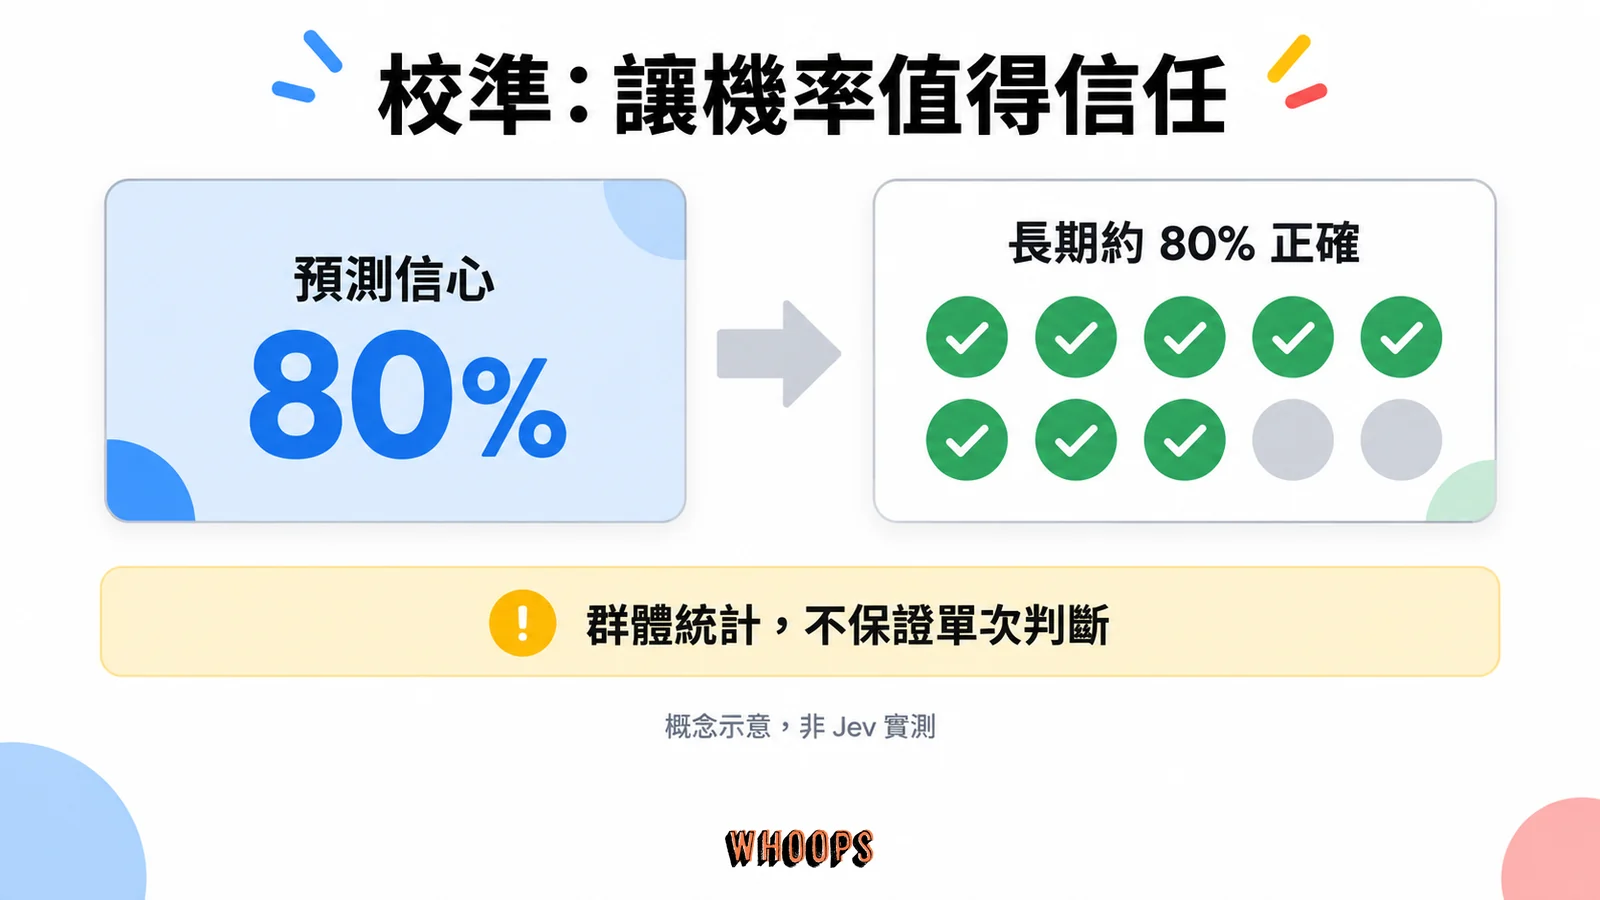
自動化的門檻需要有意義的機率。以退款機率 0.86 為例,若歷史資料顯示這個區間經常高估,就不能只因數字超過門檻而放行。TypeSafe 對 RLHF 的批評,是人類偏好的回答未必能表達可靠的不確定性;這是其訓練路線的理由,不能推成所有 LLM 都無法校準,也不能用 Jev 的設計目標代替實際量測。
RLCD 名稱裡的 Calibrated 指向同一個目標:機率與實際結果對齊。官方也追求語意相似的輸入得到相近判斷,但「相近」不表示任意改寫、正反問法或重複呼叫都會完全相同。採用時需要分別檢查校準與一致性,而不是從訓練方法的名稱推定兩者已經成立。
confidence 是分布的摘要,不是答對率
依官方 Confidence 文件,Choice 與 Score 的 confidence 是根據已回傳的機率分布計算出的統計值。假設兩組分布分別是 0.95/0.03/0.02 與 0.40/0.35/0.25,前者集中在一個選項,後者沒有明顯贏家。這是示意比較,並未代入官方未在該頁列出的計算公式。
confidence = 0.9 不能直接解讀成這次有 90% 機率答對。它有助於篩出模稜兩可的判斷,但自動處理門檻仍要用自己的資料調整。Noul 沒有獨立的 confidence,回傳值就是敘述成立的機率;例如 0.5 表示是與否的機率相同,不是某項能力只有中等程度。
校準與自動放行率要分開驗證
檢驗校準時,要先選對數值。對 Noul,可按 noul 分桶,再比較各桶事件真正成立的比例;對 Choice,可用所選答案的 probability 分桶,比較所選答案的正確率。把 0.5 至 0.6、0.6 至 0.7 等區間畫成可靠性圖,就能觀察有沒有系統性高估。每桶要同時看樣本數與統計不確定性,不能只看曲線是否漂亮,也不能把 confidence 的桶值直接當成預期正確率。
若用 confidence 設自動處理門檻,另一張表應記錄各門檻下的放行率、放行案件錯誤率與人工複核量。提高門檻可能減少錯誤,也會把更多工作交回人工。這樣才能看出門檻是否真的降低整體成本,而不只是讓留下的樣本看起來更準。
順帶把兩個常被混為一談的詞分開:校準與準確率是兩條獨立的軸。一個模型可以很準但校準很差,十題對九題,卻每題都說自己百分之百確定,錯的那一題照樣滿懷信心;也可以校準很好但不準,永遠回答五成把握,也剛好真的對一半,誠實但沒有用。自動化需要的是兩者都要:機率要誠實,判斷力也要夠,門檻才有意義。所以驗收不能只看答對率,兩條軸要分開量,這也是為什麼官方把校準放進訓練目標這件事,被當成產品的核心主張。
界線也要寫清楚:校準的證據目前全部來自官方的自辦 evals 與設計說明,第三方獨立的校準檢驗還沒有出現。採用者最能保護自己的動作,就是把分桶檢驗放進自己的驗收流程;這一套做起來比讀任何行銷材料都可靠,而且做完就是你的資產。
「結構上不可能幻覺」的意思與界線
先給答案:型別錯誤為零成立,但它是 schema matching 的數學保證,不是實測統計。輸出結構在查詢前定義,回傳值必須符合結構,型別錯誤的機率因此為零;這個零是設計上的保證,就像三角形不會有四個邊,不是跑了一萬次測試零失敗的統計。官方也明講,數字裡的 0% 型別錯誤就是這個數學保證,不是實測值,而數學保證的好處是單一反例就能推翻,屬於最容易驗證的宣稱。這也是整場發布裡最需要精確理解的一句宣稱。
這個保證買到的是形式永遠合法。欄位不會多、不會少,型別不會錯,軟體可以放心把回傳值直接放進型別系統裡。它不保證的是內容:分類可能分錯,評分可能評歪,機率可能失準。型別安全處理的是形式,不是語意。一個把所有客訴都標成「不重要」的模型,型別安全無懈可擊,用途卻是零。品質要同時看判斷是否正確,以及預測機率是否校準:被選答案的預測機率約八成時,實際是否約八成正確。
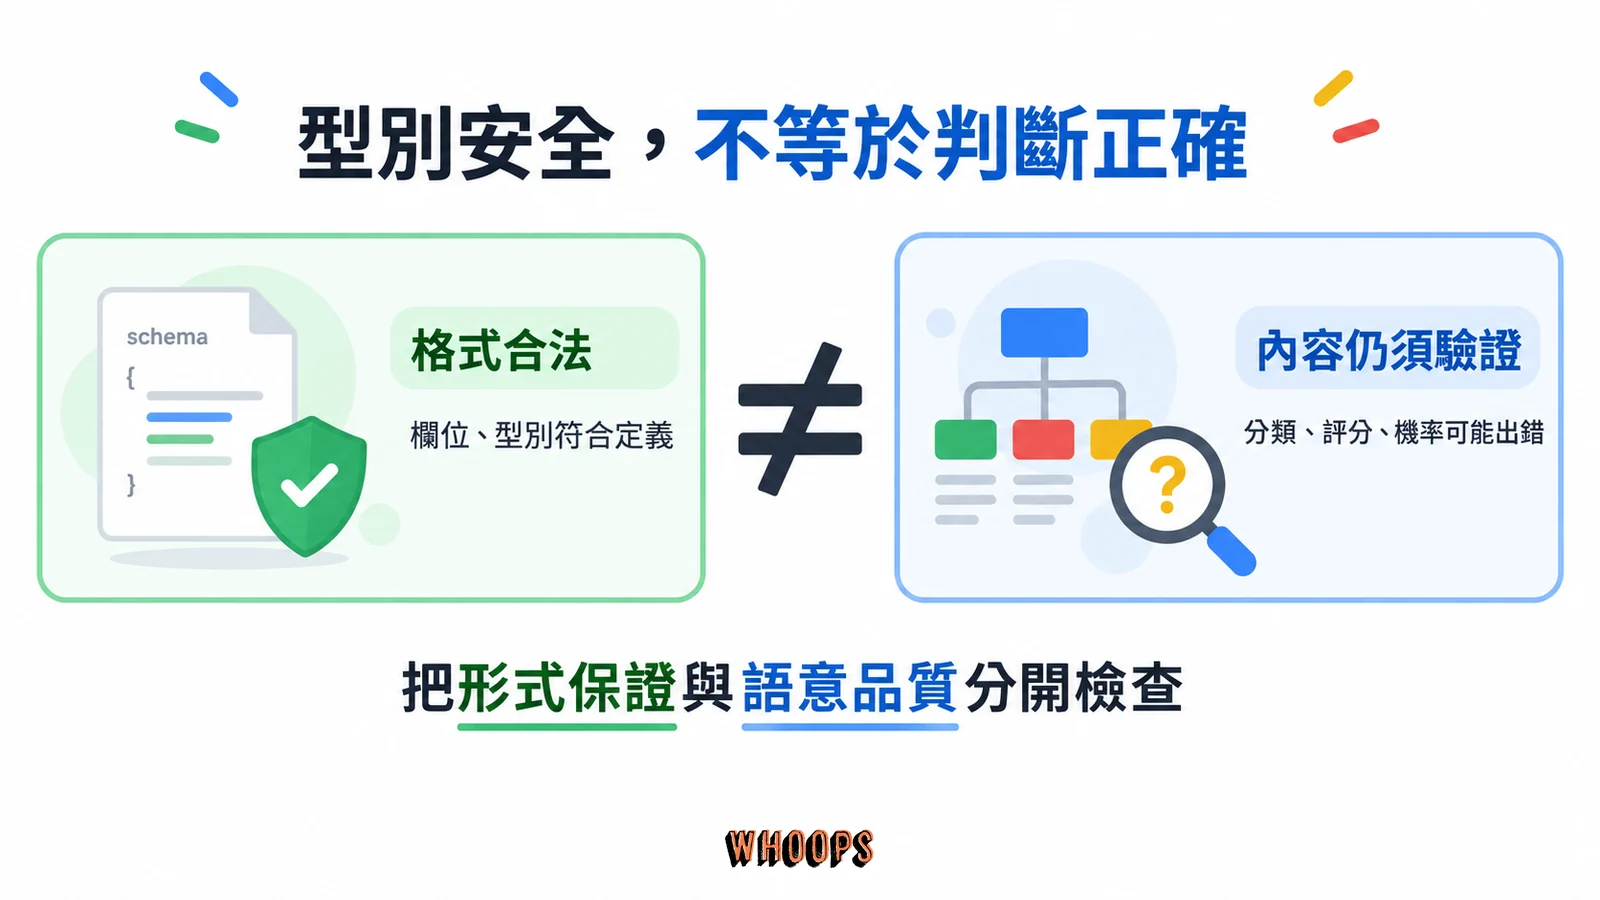
假設程式只列出 A、B、C 三個合法動作,受限輸出可以排除憑空產生 D,卻仍可能在該選 B 時選成 A。Browser Use 案例也是同樣的分工:程式提供當前頁面能做的動作,模型選下一步,執行與狀態更新由程式負責。上下文壓縮則可能每次都合法回傳保留或刪除,卻誤刪稍後會用到的紀錄。候選選項是否合法與選擇是否有用,需要各自驗證。
型別安全加校準機率,合起來才是完整的宣稱,而後半正是使用者的責任。打造開源模型工具 Pi 的 Armin Ronacher 對 TechCrunch 說得直白:這個設計某種程度上把幻覺問題委派給使用者,拿到 50% 機率時你要自己判斷這一題是擲硬幣、選擇忽略,95% 才值得動作。門檻怎麼設,取決於你的場景裡做錯的代價,這件事沒有辦法外包。
TypeSafe 圖表裡 LLM 的型別錯誤數字來自 OpenRouter,官方也註明可能有路由偏誤。這些數字不能代表所有模型在所有受限解碼設定下的表現。公平的比較應記錄是否啟用 strict schema、是否有拒答或截斷,以及欄位內容是否正確;單看格式錯誤率,不足以判定哪個工作流更可靠。
Workflow evals 的做法,與官方自己承認的偏誤
速度與成本的倍數宣稱,來自 TypeSafe 自製的 workflow evals,方法值得一字一句看。它不做的事:不最佳化 ground truth 分類,不允許修改評測用的 harness。它做的事:假設你有一個正確的 compute graph,也就是工作流本身的接線是對的,然後看不同模型把這個工作流跑完的表現。參考機率用官方形容最大、最貴的外部模型,GPT-6 Astra 與 Fable 5.1 的平均,站內對 GPT-6 Astra 另有專文介紹。這個設計值得多看一眼:它不假設自己有人工標記的正確答案,而是問「跟最貴的參考模型比起來,便宜快速的模型漏掉了什麼」,量的是與參考的同意度,不是與真理的距離。好處是任何真實工作流都能評,不需要先造標記資料;代價是參考模型本身會錯,共識不等於正確。
把 eval 的想像具體化:假設你有一條內容審核的管線,切成分類、評分、分支幾個節點,接線本身是對的。Workflow eval 就是讓不同模型輪流跑同一條管線,記下每個節點的判斷、整體的延遲與成本,再跟參考機率對齊。它評的不是「誰最能幹」,而是「誰在這條真實接線上,用這個速度與成本,給出夠接近參考的判斷」。這比通用 benchmark 離採用決策近一步,也比 demo 近一步;你自己工作流上的數字,永遠比別人工作流上的數字有說服力。
結論宣稱:Jev 在近兩個數量級的範圍佔據 Pareto 前沿。這裡的 Pareto 前沿要對照圖軸讀:下圖 Cost 模式的橫軸是每案例成本、縱軸是相對參考答案的 accuracy;切換到 Time 才換成時間軸。如果另一個模型同時更便宜又更準,原模型就不在成本與準確率的前沿上。Jev 位於這份官方評測的前沿,表示在此測試設定下呈現有競爭力的成本與判斷取捨,不能推成所有任務都更快、更準。
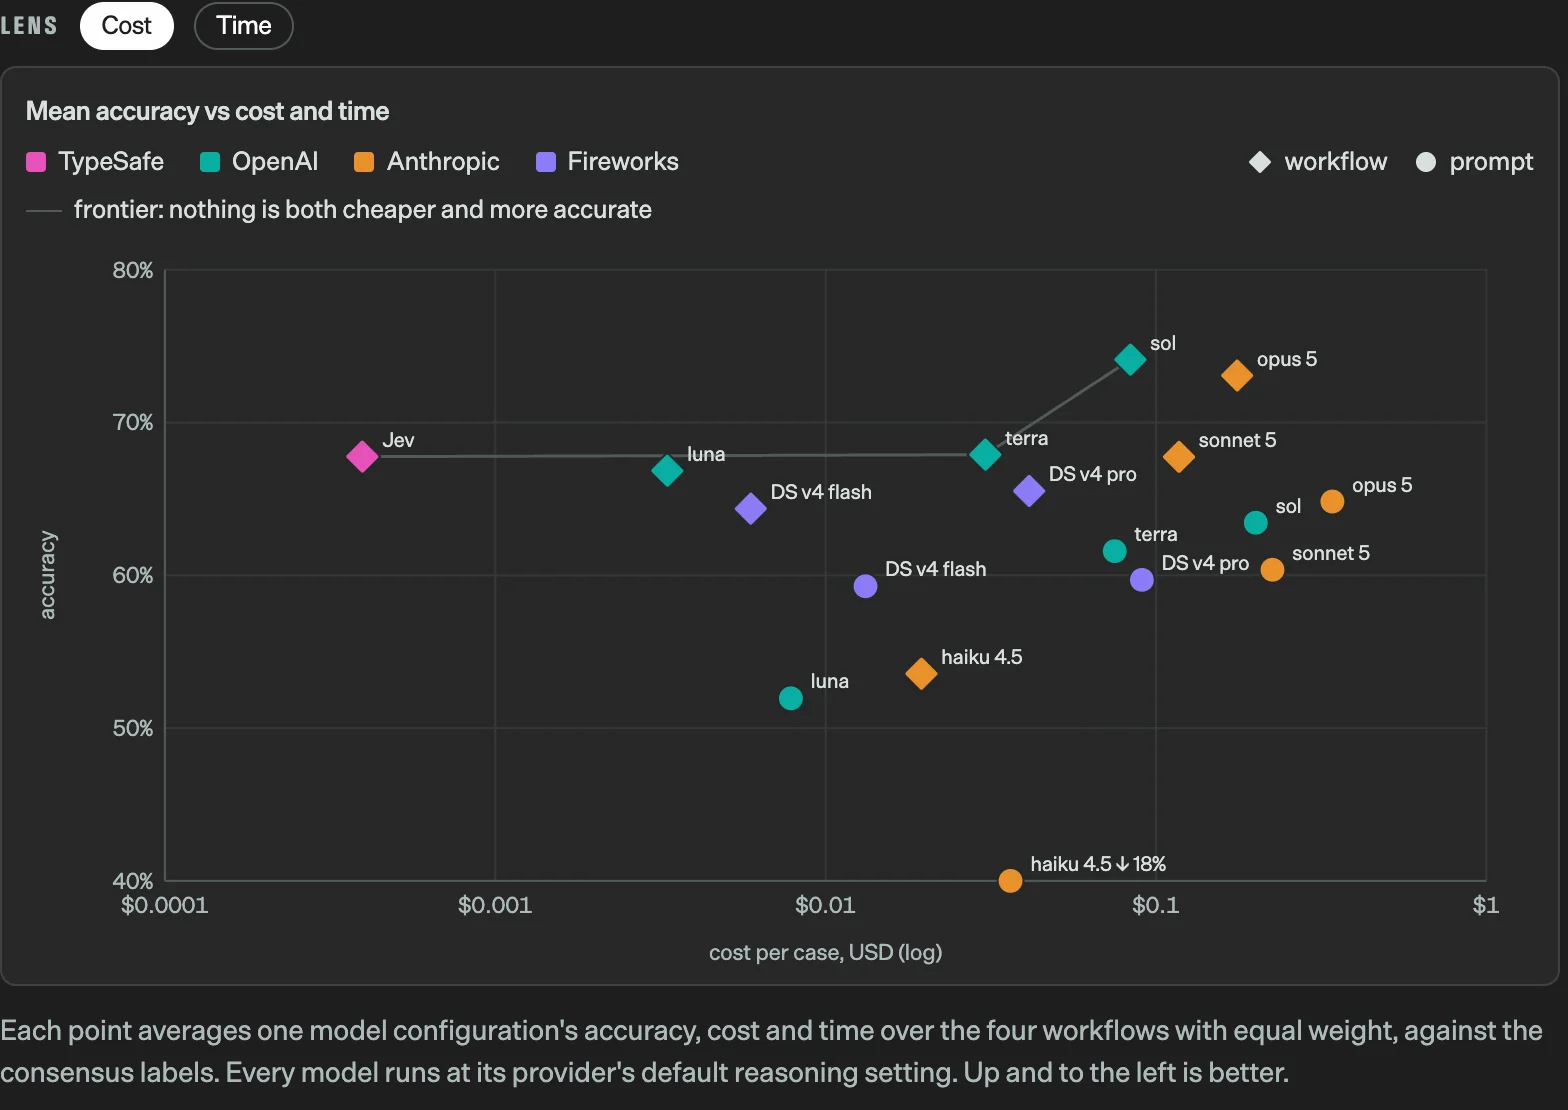
這種自辦考試的可信度,取決於但書講了多少,而 TypeSafe 這次講得異常完整,四條全部列出來。工作流由自家的 model capabilities 團隊製作,不是刻意挑選、也不在訓練分布裡,但可能有偏。參考答案來自 OpenAI 與 Anthropic 的模型,立場上可能偏袒參考方,也可能低估 TypeSafe 自家與 DeepSeek。示範用的輸入狀態刻意短而密,官方承認這對自家模型有利。受測的 LLM 用官方的 System One wrapper 包裝,較慢較貴,官方的說法是這樣量出來最準。
怎麼消化這些?把它當成廠商自辦、但揭露密度高於業界常態的內部評測。它不能證明 Jev 比較好,但它把驗證路徑打開了:測項明列、站台公開,你自己跑得到的數字才算數。這也正是官方對使用者的期待,與其爭公開排行榜,不如為自己的使用案例建 eval;而結構化輸出的任務恰好容易評,答案對不對常常可以程式判定。
官方 demo 各自展示什麼
發布公告附了三個 demo,各自回答一個疑問。並排示範回答「跟 LLM 比到底多快」:同一組狀態丟給 Jev 與 GPT-5.6 Terra 的預設推理設定,一邊整批機率同時回傳,一邊逐字生成。官方揭露了兩個細節,輸入狀態刻意短而密、對自家有利;雙方唯一分歧的一題是流失風險等級的判斷,官方自認那題答案本來就模糊。實際的查詢內容收在公告附的 playground 分享連結,可以自己打開對照。 並排示範挑的對手是 GPT-5.6 Terra,GPT-5.6 是什麼、定位在哪,站內專文另有整理。
Doom 打電動的 demo 回答「快到什麼程度」。示範用的 bot 每秒發出約 10 次查詢,官方估算成本每小時約 7 美元;判斷的依據是結構化的遊戲狀態,用文字描述的資料結構,不是螢幕影像。官方也很誠實地說,純粹要把 Doom 玩好,不靠 AI 的 bot 可以玩得更好;這個 demo 展示的是對不同的狀態表示有反應、而且遵循指令的即時判斷,100 毫秒等級的決策迴路裡放得進 AI,這在一年前的主流模型上排不進去。公告頁嵌了實機影片,官方預告會釋出深度教學並舉辦黑客松活動。
成本數字可以做一個可重現的換算,順便展示這類判斷的計費邏輯。每秒 10 次查詢,一小時是 36,000 次;以輸入每百萬 token 0.042 美元計,每小時 7 美元對應約 1.67 億 token 的輸入量,倒推每筆查詢平均輸入約 4,600 token。對一個用文字表示的稠密遊戲狀態來說,這個量級合理。換算也點出計費結構的含意:輸入是唯一的計費軸,查詢頻率乘上狀態大小就是帳單,狀態寫得越精練,錢花得越少。
Diogo Almeida:Jev 每秒約 10 次判斷的官方 Doom 影片
上方是創辦人發布的 Doom 原始影片貼文,本次查核時約有 123 萬次瀏覽。畫面展示的是連續決策能否跟上遊戲節奏;每秒約 10 次查詢與每小時約 7 美元均為官方對這個 demo 的回報,不能換算成所有即時應用的固定成本。
上述三個熱門案例,從 Made with Jev 收錄與連出的 87 則 X 候選貼文中,比對 63 則含影片貼文的公開瀏覽數,選取案例類別中最高的三則。這些數字透過 FxTwitter 讀取,會隨時間變動;這是可查候選集的排序,並非 X 全站完整排行,瀏覽數也不代表技術驗證。
Wikiracing 回答「快加便宜之後,能力會怎麼累積」。規則是從一個維基百科頁面出發,只靠頁面上的連結抵達目標頁,每一步要從數百到數千個連結裡挑下一個。這種結構把兩個優勢變成複利:每步判斷又快又便宜,整條搜尋路徑可以大量展開嘗試;選項基數高又不會幻覺,長的依賴不會在中間斷掉。官方的對照組用的是非推理模式的最低檔 Astra,所以加速倍數比其他 demo 小,但 Jev 用較少的步數完成,官方把這當成智慧較高的訊號。兩個工程細節要記住:單次查詢的選項基數上限 255;更高的基數用兩段式處理,先獨立評分再明確選擇。 把一個目標拆成大量平行判斷再收斂路徑,這個形狀跟 AI 搜尋的query fan-out 展開機制在概念上互相呼應。
官方 Wikiracing 示範影片位於原始發布公告的 Fun Demos 段落,可從前文的公告連結進入。
三個 demo 合起來看,行銷成分當然有,但展示的面向是挑過的:延遲、單位成本、決策密度。對照官方的計價與速度宣稱,數字彼此咬合,至少通過內部一致性的檢查。真正的外部驗證,還是要等第三方用自家工作流跑出來的結果累積。
想直接看這些 demo 的實際畫面,技術社群裡已經有觀看數二十八萬以上的解析影片,把 Jev 的定位與幾個 demo 逐一走過:
命名由來:System 1、Jevons 悖論,與一個關於未來的賭注
兩個名字,兩個典故。System One Models 來自 Kahneman 的《Thinking, Fast and Slow》:System 1 快而省力,負責直覺判斷;System 2 慢而費力,負責深思熟慮。名字裡藏著一個誠實的問題:心理學裡 System 1 的名聲不好,衝動、偏誤、易出錯。官方 FAQ 承認這層聯想,他們的立場是相信 System One Model 可以做得比替代方案更可靠,細節說未來會說明。這是個尚未兌現的承諾,先記下來。
不過直覺不可靠並不是心理學的最終結論,條件才是。Kahneman 與決策研究者 Gary Klein 後來合寫過一篇廣被引用的和解文章,結論大致是:直覺可以在窄而穩定的領域變成專業,條件是環境有規則可循、回饋清楚及時,西洋棋與消防員現場判斷是標準例子;環境亂、回饋慢的領域,直覺就退化成運氣。用這個框架看 System One Model 的設計,等於把「窄而穩定、回饋清楚」翻譯成工程條件:輸出空間被 schema 限窄,訓練回饋來自 RLCD 的校準訊號。直覺可不可靠,從天性的問題變成設計的問題;這個類比屬於延伸詮釋,不是官方說法。
Jev 命名自十九世紀的經濟學家 William Stanley Jevons。他在 1865 年的《The Coal Question》裡提出後來被稱為Jevons 悖論的觀察:蒸汽引擎效率提升之後,煤的消耗不減反增,因為便宜的能量開啟了更多用途。Jevons 當年算的是英國的處境:煤是工業動力的支柱,引擎不斷改良、每單位產出用的煤越來越少,他卻看出總消耗會持續攀升,理由是便宜的動力讓原本不划算的用途全部變成划算,用途的擴張速度蓋過了效率的節省。TypeSafe 把同一個邏輯搬到機器智慧上:智慧成本每降一個數量級,就解鎖數量級更多的使用案例。他們賭的是,今天因為太貴、太慢而根本不會想用 AI 的那些判斷點,在新的成本結構下會全部被打開。
這個賭注值得單獨想一想,因為它是整個產品的世界觀。Almeida 對 TechCrunch 描繪的未來是:智慧軟體到處都是、湧現而且分散,更像早期的網際網路,而不是少數幾個巨型應用。Jevons 悖論在技術史上確實反覆應驗,從煤到電力到頻寬;它會不會在機器智慧上重演,沒有人知道,而 TypeSafe 把公司押在「會」的那一邊。歷史經驗也提醒反面:效率的紅利要轉成總量成長,需要互補條件到位,這次的名單包括工具鏈、部署習慣,以及對機率輸出的信任。
Jev 適合放進哪些工作,哪些仍該用 LLM
要生成自由文字、與人對話的任務,像聊天、寫作、coding agent,仍該用 LLM;Jev 適合的是分類、路由、評分、擷取、分支這類輸出直接被程式消費的大量判斷,共通特徵是判斷量大、單筆價值中等、錯誤可以被機率門檻控制住。
官方文件的 use-case map 把應用歸成幾大類,讀起來比類別名稱具體得多。AI 自動化:程式碼掌握控制流程,不靠 markdown 對話稿,模型只負責語意判斷,可以在背景跑一百萬次,不需要人陪。即時應用:150 毫秒等級的前沿判斷,快到可以放進遊戲或介面互動。大量資料的 map-reduce:對巨型語料做檢索、分類、特徵抽取。通用驗證:審查 prompt、抽取結果、推理軌跡、工具呼叫,偵測越獄、引文錯誤、幻覺,成本遠低於被監控的 LLM 呼叫。Harness 工程:模型路由、語意檢索、錯誤偵測、護欄。地圖按產業列出例子,值得整份看完。
把這些類別落到具體行業,輪廓更清楚。電商可以把商品評論與客服來信做自動分類與路由,把可疑訊號交給評分判斷。媒體與內容平台可以把投稿分類、把留言審核、把新稿件跟既有內容做關聯。SaaS 產品可以把潛在客戶按意願評分再路由給業務,把功能請求自動歸類。檢索強化的場景裡,官方文件也把取代或補強 RAG 管線中的嵌入檢索列為自動化用途之一。共通點都一樣:判斷量大、單筆價值中等、錯誤可以被機率門檻控制住。
用更白話的方式整理,判斷一個工作適不適合,看三個條件。輸入是狀態不是對話:你餵的是資料,不是等人接話的聊天。輸出是決策不是文章:要的是分類、分數、選項,不是一段生成的文字。判斷會被程式消費:結果直接進 if 判斷或資料庫,不經人眼。三個都中,Jev 的形狀就對;缺任何一個,LLM 或傳統規則可能更合適。
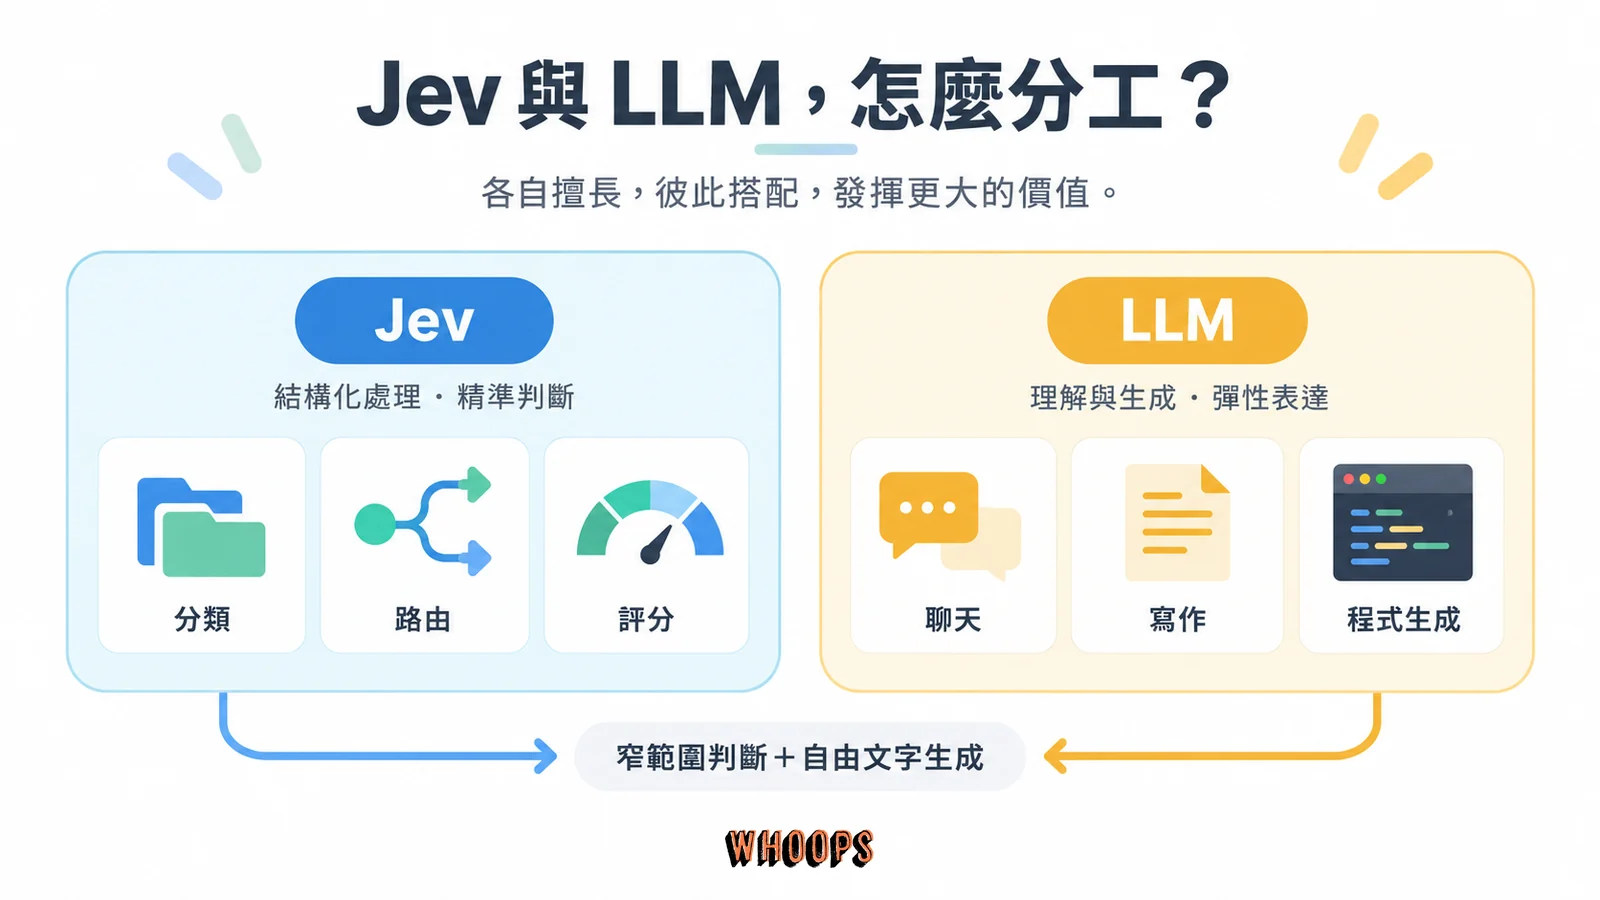
第三方報導裡的早期採用者,用的位置也都落在這個範圍。Vercel 拿它做指令安全分類,Bryo AI 拿它分類商務 email,Ronacher 點名的兩個方向是模型路由,以及用 Jev 監控 LLM agent 的行為軌跡,用便宜的第二意見看守貴的第一意見。把判斷點包進會自己跑的 agent 迴圈、再配上護欄,這套設計模式站內的迴圈工程指南有系統性整理,概念可以直接搬過來套用。
熱門案例:讓 Jev 篩選 Agent 的上下文
另一個高關注案例把判斷點放在 coding agent 的記憶管理。開發者 tamara 的 fast-jev-compaction 讓 Jev 判斷哪些工具呼叫與結果還有用,再由程式保留、截短或移除;保留下來的內容維持原文。它沒有要求 Jev 寫摘要,恰好用到了「只做決策」的介面。 上下文怎麼管理是 coding agent 圈共同的課題,Meta 的終端機寫程式代理 Muse Code走的也是同一條賽道。
tamara:用 Jev 評分工具呼叫並壓縮上下文的示範影片
這則影片在本次查核時約有 296 萬次瀏覽。吸引人的地方是把等待摘要的工作改成快速篩選;但刪除判斷仍可能失誤,原始專案也說明了門檻與回退機制。上下文縮短多少、關鍵資訊會不會遺失,以及後續任務成功率,才是採用時該驗的結果。
「用 AI 看 AI」這個方向可以再攤開一點,因為它是官方文件裡寫得最具體的一類。被監控的標的清單包括:進入模型的 prompt、模型抽取出來的欄位、推理軌跡、工具呼叫的參數;要抓的錯誤模式包括越獄嘗試、引文錯誤、幻覺、一般性的失誤。接法就是把這些文字當成輸入狀態,丟給一個事先定義好的風險判斷,機率過門檻就攔下或記錄。關鍵在成本結構:監控用的呼叫次數通常遠大於被監控的呼叫,監控者必須便宜一個數量級以上,這件事才會有人做,而這正是 Jev 宣稱的所在。
不適合的場景,官方比較表寫得不含糊:聊天機器人、copilot、coding agent、demo 原型,這些是 LLM 的地盤。市場現實還要加三個限制。early access 階段,供應穩定性未經時間考驗,TechCrunch 報導提過 API 一度因需求過載而中斷服務。單一供應商:這個類別目前只有一家,沒有備援。選項基數上限 255:超過要用兩段式拆,不是不能做,是設計時要知道。 這些 LLM 主場的產品裡,OpenAI 的 Codex 工程代理人是標準樣板:自己規劃、動手,再把成果交回給人驗收。
為什麼查不到公開 benchmark 成績
刻意不公布,這是官方立場,而且寫成了一篇完整的文章。TypeSafe 認為公開 benchmark 對新前沿的判斷力有限,計畫只在產品更新時做一次性評測;給使用者的建議是,不要用排行榜做判斷,為自己的使用案例建 eval,揭露細節與但書,就算領先也不要拿 benchmark 行銷。這套主張收在antibenchmaxxing 一文裡,公告 FAQ 直接引用。
這對採用決策是實際的麻煩。買 LLM 的時候可以看排行榜、看第三方整理的 benchmark 站比價比分,Jev 什麼都沒有,唯一的評分來源是廠商自辦的 workflow evals。緩解的因素有兩個:System One 任務的輸出是結構化決策,自建 eval 遠比評文字品質容易,答案對不對常常可以程式判定;evals 站台與 playground 都公開,驗證的門檻是時間,不是權限。換句話說,官方把驗證成本從「查排行榜」換成「跑自己的測試」,這對小團隊是負擔,對認真的採用者反而更準。
採用前要評估的風險
供應與價格的風險先算。這個類別目前只有一家供應商,沒有備援;服務處於 early access,發布初期 API 曾因需求過載短暫中斷;低價無法排除補貼,長期價格存在變數。對應的做法是把 Jev 的判斷點設計成可替換的介面:輸入輸出的 schema 是你自己定的,理論上換回 LLM 或換成未來的競爭者,改動都集中在介面層,不散落在業務邏輯裡。保留一條 LLM 對照路徑,也讓切換隨時可回。
品質的風險在證據結構。校準與智慧水準的宣稱全部來自單方:自辦的 workflow evals、自製的 demo、自行揭露的但書。披露確實比業界常態完整,但完整揭露不等於獨立驗證。對應的做法是影子模式:先把 Jev 接上線但只記錄不行動,讓它的判斷跟現行做法並行跑一段時間,用真實流量累積自己的準確率與校準資料,再決定放權到哪裡。
已知能力限制:精確計算、無關上下文與提示注入
官方的 Jev 1.13 限制文件具體列出幾種弱點:計數與精確數值計算、日期比較、多層間接推理,以及大量無關上下文。這是特定版本的說明,不能套成所有未來版本的結論。工程上的分工是先檢索與過濾資料,讓模型判讀語意,日期運算、加總及規則檢查交給程式。
同份文件也提醒,輸入資料裡的惡意指令或刻意誤導的敘述可能改變答案。型別安全不會自動帶來提示注入免疫。若用 Jev 當 LLM 的護欄,仍要測試對抗案例、限制後續工具權限,並保留可中止或轉人工的路徑。 限制工具權限這件事,coding agent 圈已經累積出成熟做法,Claude Code 的權限模式設計可以直接借鏡。
工程與組織的成本容易被低估。schema 設計是前置投資,欄位怎麼切、門檻設幾道,是把領域知識翻譯成結構的工作,做錯了模型再準也沒用;eval 的能力要自己養,分桶檢驗、對照測試、樣本管理,都是新的例行工作。對應的做法是從一個痛點開始,把一個判斷點的基準線做起來,再談擴大;基準線一旦存在,後面每個新模型、新版本都可以重複使用同一套量尺。
類別本身的風險也要記一筆。System One Model 是一個剛誕生的類別,術語、介面、限制條件都可能調整:Questions 的詞彙、基數上限、定價結構,都可能在 early access 期間改變。文件與官方公告是唯一權威,採用時以當下的文件為準,把版本變化當成常態來設計,而不是例外。
Jev 怎麼用:Early access 申請與上手方式
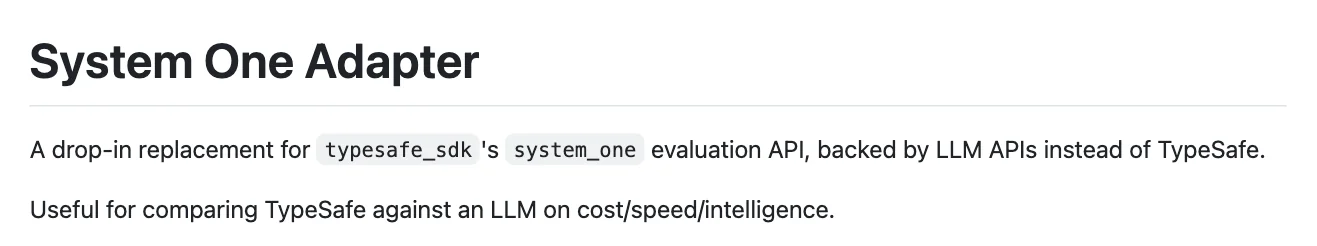
截至 2026 年 9 月 19 日,Jev 處於 early access 階段,取得方式是在 TypeSafe console 登記 waitlist,官方陸續放量。直接呼叫 Jev,可依官方 Quick start 使用 TypeSafe SDK。官方另有開源的 System One Adapter,用途是以 LLM API 模擬相同決策介面,方便比較成本、速度與判斷表現;它不是 Jev 模型,也不是呼叫 Jev 所必需的 SDK。發布後的需求強度有個指標:TechCrunch 報導提到 API 一度因為需求太高而短暫無法服務,早期要把關鍵路徑壓上去之前,穩定性要自己評估。
官方對外的技術揭露有限。Almeida 對模型架構保密,TechCrunch 提到外部觀察者猜測它是在 open-weight LLM 之上打造,這是猜測、不是證實;模型是 transformer 架構是報導的說法,訓練全用自製合成資料、以 RLCD 訓練是官方說法。訓練資料的官方答案很有性格,直譯的意思大致是:TypeSafe 本質上是資料研究實驗室,所有資料自己生,就算你拜託也不會拿你的資料來訓練;想知道更多細節,他們說,得先來上班。
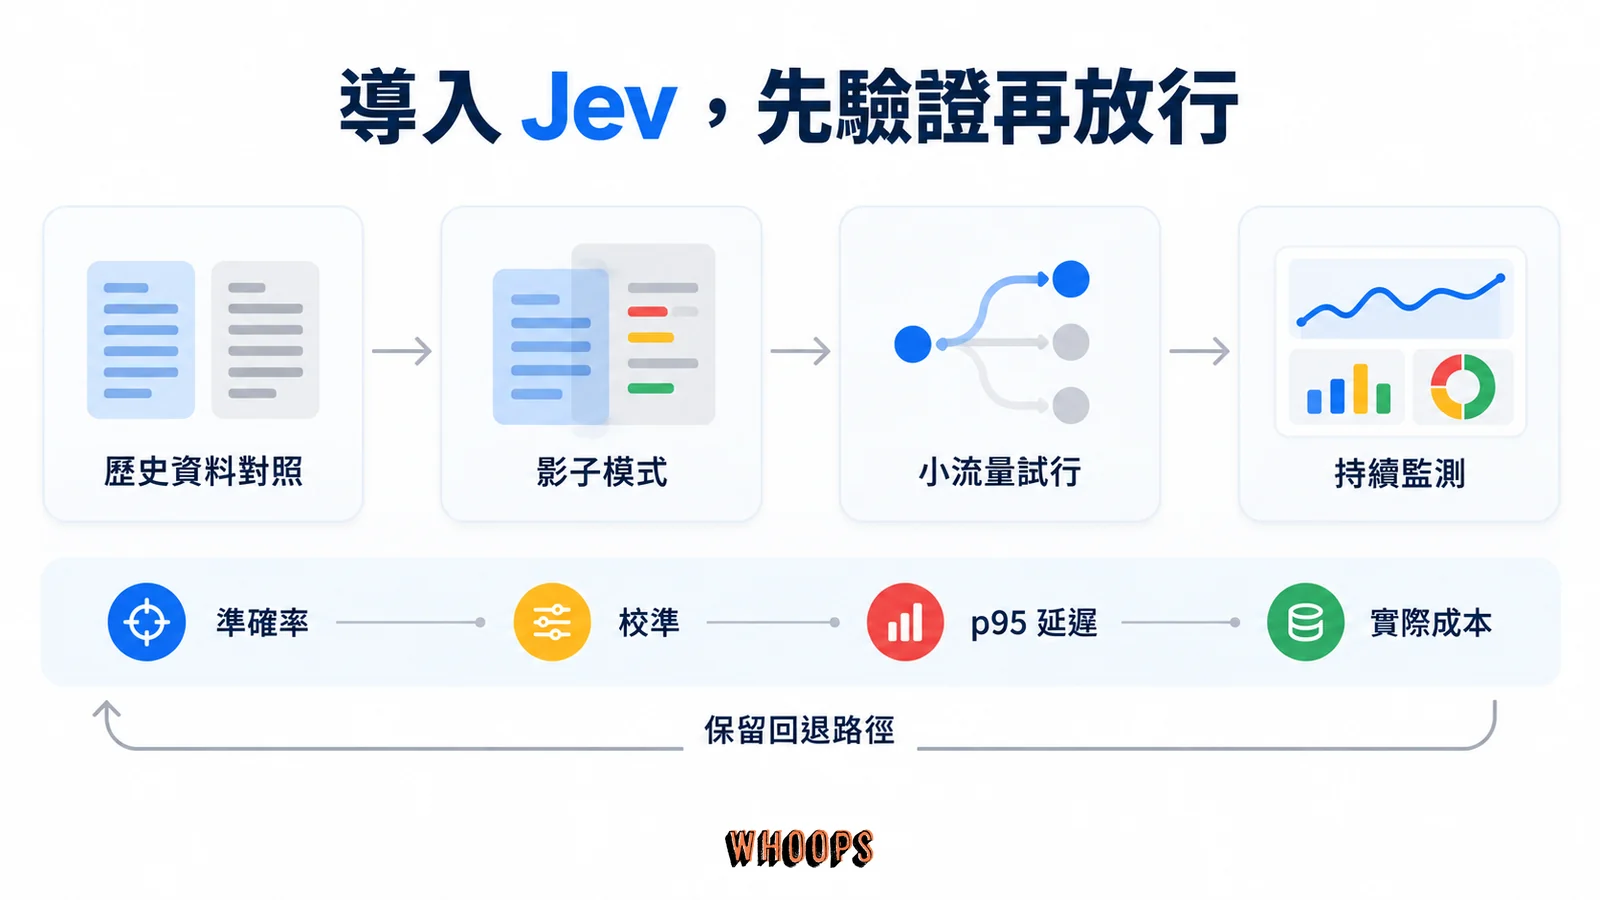
如果要試,建議的路徑照順序走。挑一個現存工作流裡的 LLM 小判斷,越痛的越好,延遲敏感或成本高的優先。把輸出 schema 定義出來;這一步本身就是設計,欄位怎麼切、機率門檻設幾道,都是你的領域知識。用同一批歷史資料對照跑,LLM 與 Jev 各跑一次,比的不只準確率,還有校準,所選答案的預測機率約八成時,實際有幾成答對。小流量上線,盯一段時間再決定擴大。整個流程每一步都可以在你自己的資料上完成,這也是官方反覆強調的精神。後續動態公告都發在官方 X 帳號。
Jev from @typesafeai is on AI Gateway.
— Vercel Developers (@vercel_dev) September 17, 2026
Build agents that decide, route, score, and stop in milliseconds:
𝚊𝚠𝚊𝚒𝚝 𝚎𝚟𝚊𝚕𝚞𝚊𝚝𝚎({
𝚖𝚘𝚍𝚎𝚕: '𝚝𝚢𝚙𝚎𝚜𝚊𝚏𝚎-𝚊𝚒/𝚓𝚎𝚟',
𝚜𝚝𝚊𝚝𝚎,
𝚚𝚞𝚎𝚜𝚝𝚒𝚘𝚗𝚜,
});https://t.co/rzyPuHIJin
驗收標準先寫好,測試才有結論可下。用人工確認的案例檢查判斷品質,若採參考模型則另列同意度;以事件機率或所選答案的 probability 做校準檢驗;用 confidence 設門檻時,記錄放行率與放行後錯誤率。再把 p95 延遲與實測帳單對照應用預算。這幾項都符合需求,才擴大流量;校準誤差可接受多少、哪些錯誤必須攔下,要按自己的業務代價訂。
常見問題
Jev 是 LLM 嗎?跟小型語言模型差在哪?
不是。官方的回答是「既不小、也不是 LLM」,因此不在智慧 Pareto 曲線上。LLM 與 SLM 都以生成文字為介面,差別在參數規模與成本,站內的小型語言模型解析把這條軸講得很清楚;Jev 換掉的是介面本身,不生成文字,輸出事先定義結構的決策與機率。兩者解決的問題不同:SLM 讓生成更便宜,Jev 讓判斷可以直接交給程式使用。
Jev 會取代 ChatGPT 或 Claude 嗎?
從公開資訊看是互補,不是取代。聊天、寫作、coding agent 是人機協作,官方比較表把這些劃給 LLM;Jev 處理軟體內部的分類、路由、評分。還有一種反向搭配:用 Jev 當便宜的第二意見,監控 LLM 的輸出與行為軌跡,官方與第三方報導都點名這個用法。 這條人機協作線上,Codex 與 Claude Code 的取向差異是好用的入門對照:一邊偏雲端代跑,一邊偏本機互動。
「Jev 不可能幻覺」是真的嗎?
要拆成兩層看。型別錯誤為零是 schema matching 的數學保證,設計使然,不是實測統計;這部分成立,而且單一反例就能推翻,屬於最容易驗證的宣稱。但型別安全不保證語意正確,分類可能錯、機率可能失準,這部分要靠你自己的資料驗證校準。
Jev 的費用怎麼算?
官方公布的定價是輸入每百萬 token 0.042 美元,等於每十億 token 42 美元,輸出不收費。對照官方引述的 LLM 行情,輸入每百萬 0.20 到 10 美元,輸出約是輸入的五倍貴。官方同時聲明無法證明沒有補貼,永續性需要時間證明,預期方向只降不升。
為什麼查不到 Jev 的公開 benchmark 分數?
官方刻意不公布,立場完整寫在 antibenchmaxxing 一文:不要用公開 benchmark 判斷新前沿,鼓勵使用者為自己的案例建 eval、揭露細節與但書。實際影響是採用前必須自建驗證;緩解是結構化輸出的任務容易評,evals 站台與 playground 都公開。
現在一般開發者用得到 Jev 嗎?
2026 年 9 月 15 日起開放 early access,在 TypeSafe console 登記 waitlist 陸續取得,截至 9 月 19 日仍開放登記。直接串接依官方 Quick start 使用 TypeSafe SDK;開源 System One Adapter 則供 LLM 對照評測使用。注意單次查詢的選項基數上限 255,更大的選擇集用兩段式處理;發布初期 API 曾因需求過載短暫中斷,關鍵路徑的依賴要謹慎。
Jev 的 confidence 就是答對率嗎?
不是。Choice 與 Score 的 confidence 由機率分布計算,反映答案分布的集中程度,不能把 0.9 直接解讀成九成答對。校準要用事件機率或所選答案的 probability 對照實際結果;confidence 門檻則要分開量測放行率與錯誤率。Noul 沒有獨立的 confidence 欄位。
Jev 能在一次請求裡完成多步推理嗎?
一次請求能平行評估共用同一份 state 的多個獨立問題,但同批答案不會互相傳遞。若後一步需要前一步的結果,程式須先接收結果、更新狀態,再發出下一輪請求。一次 API 請求也不能等同於底層只做一次神經網路前向運算。
Jev 能拿來寫程式、寫文章或聊天嗎?
不能。Jev 不生成自由文字,也不跟人對話;官方比較表把聊天機器人、copilot、coding agent 這些人機協作場景劃給 LLM。需要自由文字的步驟可以搭配 LLM:開源案例 fast-jev-compaction 用 Jev 篩選 coding agent 要保留哪些上下文,Browser Use 的查機票示範也是 Jev 負責選下一個動作、文字輸入交給小型 LLM 補上。
Jev 是誰做的?跟 OpenAI 有關係嗎?
Jev 由 TypeSafe AI 開發。共同創辦人暨 CEO Diogo Almeida 過去在 OpenAI 做讓模型學會遵循指令的研究,並列名 2022 年發表、後來被稱為 InstructGPT 的論文作者群;TechCrunch 報導列出的共同創辦人還有 Erik Gafni 與 Sasha Sheng。
Jev 跟 LLM 的 Structured Outputs 或 JSON mode 差在哪?
JSON mode 只保證輸出是合法 JSON;LLM 的嚴格結構化輸出透過受限解碼保證格式符合 JSON Schema,但欄位裡的判斷仍可能出錯。Jev 的差別在介面與訓練目標:輸出就是決策與完整機率分布,並把校準列為訓練目標;計費上輸出不收費。有意義的比較是同一份狀態與問題下,兩邊的正確率、校準、延遲與費用。
Jev 的 API 要怎麼申請、怎麼串接?
先到 TypeSafe console 登記 waitlist,early access 資格陸續開放;取得後依官方 Quick start 用 TypeSafe SDK 呼叫。開源的 System One Adapter 是拿 LLM API 做對照評測的相容層,不是串接 Jev 的必備套件。單次查詢的選項基數上限 255,超過要用兩段式拆解。
搜尋 JEV 出現的日本腦炎,跟 Jev 模型有關係嗎?
沒有關係,只是縮寫相同。AI 領域的 Jev 是 TypeSafe AI 的決策模型;醫學上大寫的 JEV 是 Japanese Encephalitis Virus 的縮寫,也就是日本腦炎病毒,要查疾病與疫苗資訊請以醫療與公共衛生機構的說明為準。
怎麼判斷 Jev 值不值得你關注
收攏成一個判斷框架。正在寫工作流的開發者,最實際的動作是挑一個最痛的 LLM 小判斷做對照測試,成本是一兩天的工,潛在回報是把那個判斷的成本壓低一到兩個數量級;就算到頭來不用 Jev,你也第一次有了自己案例的 eval 基準線。做技術決策的人,觀察三個訊號:價格守不守得住、同類競爭者什麼時候出現,Ronacher 的預期是很快,以及真實部署案例的累積速度。顧 AI 搜尋與內容工作的人,這是基礎設施層的變化,模型判斷變便宜變快,改變的是產品裡 AI 的密度;LLMO 的概念地圖站內另有專文,可以放進同一張心智圖。 模型層的變化遲早傳導到內容端,AI 搜尋怎麼挑引用來源,GEO 完整指南把內容端的因應整理成一套可執行的框架。
時間軸也值得設一下。early access 的觀察期以季為單位比較合理:價格能不能守、API 穩不穩、第一批非官方的校準檢驗什麼時候出現、競爭者會不會跟進,這些訊號在幾個月內會陸續揭曉。不需要急著在第一週下結論,也不需要等到「大家都用了」才看;把判斷點清單列好,訊號到了再動,比追新聞稿省力得多。
回到最初的問題:Jev 是什麼。一個把 AI 的輸出介面從文字換成決策的嘗試,來自一群對「模型很會聊天、自動化卻沒跟上」不服氣的人。它的宣稱數字驚人,但來源單一,驗證路徑已經打開,門檻是你自己的測試,不是別人的背書。TypeSafe 押的 Jevons 賭注,智慧越便宜、用得越多,會不會在接下來一兩年應驗,看的不是更多新聞稿,而是有多少個 if 判斷真的換了引擎。在那之前,把「宣稱」與「驗證」分開存放,是面對所有新前沿最穩的姿勢。

討論與提問