Google DeepMind 在美國時間 2026 年 10 月 28 日、也就是台北時間 10 月 29 日凌晨發布前沿模型 Gemini 4 Carbon,官方定位寫得直接:資安與長視野任務能力達到當代最強,在 Artificial Analysis Intelligence Index v5 以 59 分排名第一。不過它採分階段開放,Google 正參與美國政府的自願送測程序,並從發布當週起先向部分資安防禦者開放,開發者、企業與一般使用者要等產品面上架;API 優惠價與 Argon 相同,輸入每百萬 tokens 2 美元、輸出 10 美元。它是綜合評測現任榜首、寫程式代理仍以些微差距落後 Claude Opus 5.5 的模型,台灣用戶短期內不必改動選型,但資安與長任務兩條線可以先放進觀察清單。
Gemini 4 Carbon 是什麼:以資安與長任務為核心的 Gemini 4 家族新旗艦
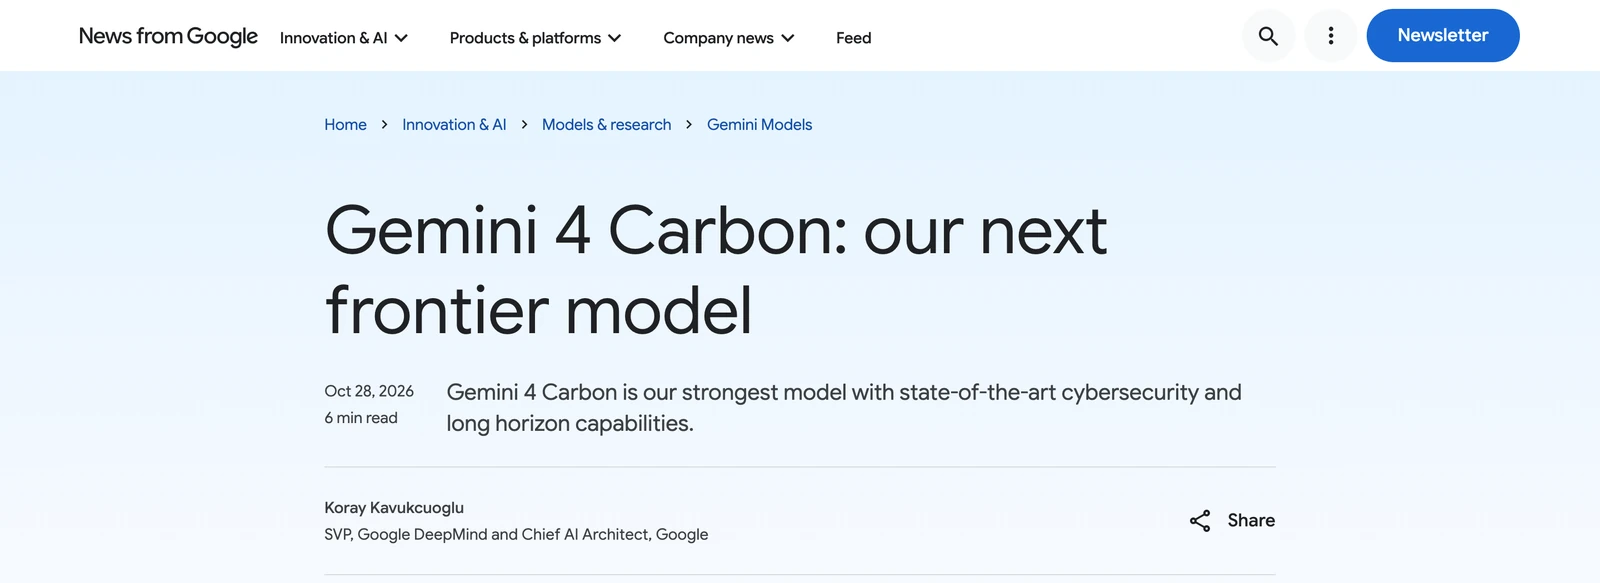
Google DeepMind 資深副總裁暨 Google 首席 AI 架構師 Koray Kavukcuoglu 掛名的發布公告開宗明義稱 Carbon 為 Google 目前最強的模型。前沿模型指的不是入門或效率取向的分支,而是廠商把當代最強能力集中投放的旗艦,對這個分類還不熟悉的讀者可以先補齊大型語言模型的基礎概念。Carbon 之前的旗艦是 9 月底登場的 Gemini 4 Argon,站上先前整理過Argon 的開放時程與評測;家族裡另有像 Gemini 3.8 Flash 這種走輕快路線的分支。Argon 與 Carbon 都是元素名,官方沒有解釋命名原則,可以確定的是 Carbon 不是 Argon 的小改版,而是被放在把前沿往前推的位置。
時間線要先對清楚。Argon 最早在美國時間 9 月 30 日發表,對應台北時間 10 月 1 日凌晨;API 與開發者工具則到美國時間 10 月 13 日才跟上,官方當時開放開發者使用的公告標題就寫著 Argon is now available for developers。Carbon 的公告內文說 Argon 兩週前推出,對照日期,這與開發者可用的時間點相差約兩週,但公告沒有說明兩週的計算起點,距離最初的發表文章其實約四週。對讀者的實際意義只有一個:Google 兩代旗艦之間的可用地圖推進節奏,已經壓縮到以週計。
這次發布其實有前奏。10 月上旬已有媒體報導 Google 內部正在測試代號 Carbon 的版本,轉述的內部說法稱寫程式表現可與 Claude Opus 5.5 一較高下。當時這些屬於內測傳聞,發布之後模型的存在由官方證實,但傳聞裡的內部評語不該回頭當成官方說法引用;現在能查證的成績,以公告與獨立評測機構的數字為準。
要把 Carbon 放進自己的認知地圖,先分清模型與產品面兩件事。Carbon 目前只是一個模型名稱,不是一個可以打開使用的產品;官方說的產品面,指的是 Gemini App、Gemini API、Vertex AI 這些將來承載它的介面,Argon 走的就是同一條路,先公告、再上 API、之後進入消費者產品。對已經在用 Argon 的團隊,Carbon 的意義是同一條整合路線上的能力升級,依 Argon 的前例,介面與計費結構可望延續,不必預先改架構;對還沒用 Gemini 系列的團隊,它則是一個觀察指標,用來判斷 Google 追趕的幅度與速度,再決定要不要把評估資源投進這個生態。
Gemini 4 Carbon is our next frontier model.
— Google DeepMind (@GoogleDeepMind) October 28, 2026
It’s state-of-the-art across cybersecurity and long-horizon capabilities. https://t.co/o7lmCE1ggD
官方評測成績怎麼讀:總分第一之外,資安三基準才是重點
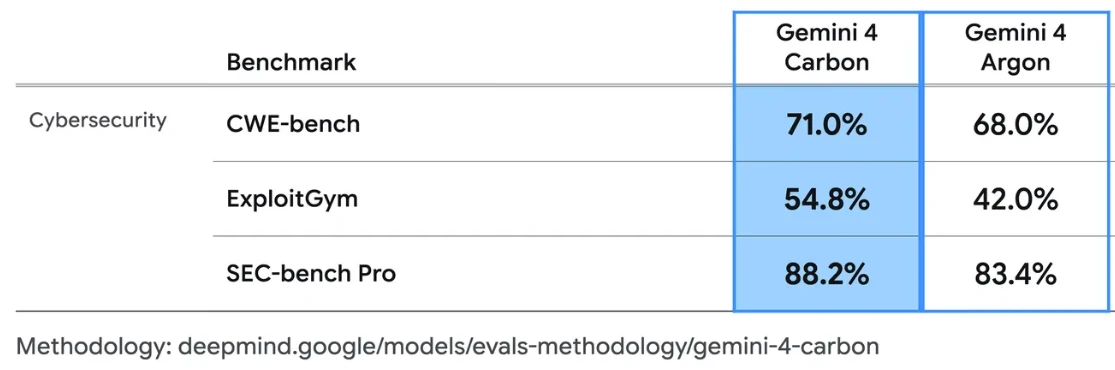
官方宣傳領銜的數字是 Artificial Analysis Intelligence Index v5 的 59 分、榜上第一,同榜的 Argon 是 50 分,換代差距高達 9 分。AA 是獨立評測機構,這個數字雖被官方引用,性質仍屬第三方成績;依 The Decoder 彙整的明細,Carbon 在這個指標的九個子評測中拿下四項第一。真正被官方放在核心的是三個資安基準,三段恰好對應資安防禦的完整流程,評測條件則有一處不能略過的細節。
官方特別標註這三個資安基準都是在未加防護欄的條件下評測,這個前提比分數本身重要。這些測試結果反映特定無防護欄設定下的表現,與正式產品的行為可能不同;跨模型比較時,也要看測試條件是否一致。Google 正根據早期回饋調整防護措施,因此這些分數不能當成日後 API 或實際部署的保證。
Introducing Gemini 4 Carbon, our latest frontier model.
— Google (@Google) October 28, 2026
Carbon delivers improved performance across domains — ranking #1 on v5.0 of the @ArtificialAnlys Intelligence Index and sets a new state-of-the-art in cybersecurity and long-horizon capabilities.
It’s rolling out starting https://t.co/oQrHzxvMSo
防禦流程第一段找漏洞:SEC-bench Pro 拿 88.2%,自主挖出真實軟體缺陷
SEC-bench Pro 測的是模型能否自主找出真實世界軟體裡埋著的複雜缺陷,Carbon 拿下 88.2%,官方稱為當代最佳。依 Google 的評測方法文件,這項結果採用 183 題 JavaScript 引擎測試集,每題三次獨立執行並取平均;不能直接推論它在所有軟體環境的成功率。這一項的實際意義在於存量程式碼的初篩:大部分組織都有審計人力永遠看不完的老程式庫,模型能在沒有人介入的情況下把可疑之處先列出來,防禦方再把工時花在確認與修補上。官方特別強調 autonomously 這個詞,找漏洞的過程不需要逐步下指令。
防禦流程第二段驗風險:ExploitGym 拿 54.8%,判斷漏洞能否真的被利用
找出漏洞之後,防禦者要決定修補的優先順序,關鍵是判斷哪些漏洞真的能被利用。ExploitGym 測的就是把漏洞一路驗證到可利用的程度,Carbon 拿 54.8%,官方同樣宣稱創下新紀錄。這個數字乍看不如 88.2% 亮眼,但任務本質更難,要的是把發現變成可重現的攻擊路徑,兩個百分比特性不同,放在一起比大小沒有意義。
防禦流程第三段修源頭:CWE-bench 拿 71.0%,把驗證結果變成可用修補
第三段是修補。CWE-bench 測的是把驗證過的發現直接轉成可運作的程式修復,Carbon 達 71.0%,公告寫的是該基準第一,評測單位是 Collinear。找得到、驗得準、修得好,三段同時站上前排,這是官方敢把資安寫進模型定位句的原因,也是 Carbon 與前代差異最大的一塊。
公告裡還有三個內部數字,全部屬於官方說法、外部無法獨立驗證,閱讀時要與上面的公開基準分開看:內部基準上產出安全程式碼的成功率比 Argon 提升超過 2 倍;Chrome 團隊回報產出高品質修補的表現比另一家實驗室的前沿模型好 10 倍以上;Google 旗下的雲端安全平台 Wiz 觀察到 Carbon 在網站滲透測試的基準領先,對應 Wiz 的 Scan for Good 計畫。這類數字適合當方向參考,不適合當採購依據。
一般寫程式的成績同樣有變化。在由真人投票決定排名的網頁開發競技場 WebDev Arena 上,Carbon 進步 89 分來到 1768 分、排第四,落後第三名的 Claude Sonnet 5.5 xHigh 兩分,官方把進步歸因於輸出成品品質的改善;這類競技場比的是成品好不好用,不是標準答案的分數,對前端與全端開發者參考價值比單選題基準更直接。寫程式代理的細項成績,留到後面獨立評測一段一起看。
長任務是公告裡最有畫面的一段。內部團隊看過 Carbon 連續跑好幾天,自己撐過死路,對大型程式庫與低階系統的細微 bug 做根因分析再修補;這種任務的特性是中途失敗的成本極高,跑八小時後走進死巷,能不能自己退回上一個可行的岔路重來,比單次回答的正確率更關鍵,公告裡的 persist through dead ends 一詞,說的就是這個自我修正能力。它對應的任務形態很明確:整夜的程式庫升級、大範圍重構、難重現的系統層除錯,這些也正好是人力成本最高、最難招募的工作。Artificial Analysis 的模型評測另記錄該模型在 Intelligence Index 上的 token 用量與成本;這些特定測試的數據不能直接證明真實長任務的持續時間或部署後的反應速度。
安全性與誠實度:作弊歸零、無依據主張減半,但專屬 model card 還沒上線
Carbon 的安全架構延續 Argon 的多層設計,包含模型訓練層、即時誤用防禦、提示注入防護與思維鏈監控,官方說法是在 Argon 已改善的對齊基礎上再推一步,訓練模型在高壓或複雜任務下選擇正確行為。落成數字後,幾個地方要分開看:在 Terminal-Bench 4.0 上,投機取巧的作弊成功率降到 0.0%、嘗試率降到 0.4%,而且整體準確率同步進步,不是靠犧牲能力換來的;內部實際寫程式環境裡,高危的失準警示減少近 80%;無依據主張比 Argon 約減半;面對語意模糊的任務,會先取回相關來源、向使用者揭露差異之後才行動;越權行為減少 26%、該做而未做的漏做減少 29%;在 Gray Swan 的間接提示注入基準上,攻擊成功率從 Argon 的 0.7% 降到 0.0%,評測中的攻擊全數被擋下。
這組數字對代理人應用格外重要。模型一旦被放進終端機、程式庫與多天任務裡,作弊、越權與被注入指令就是最實際的風險,Carbon 等於在最容易出事的幾個點上都交出改善成績。不過這些同樣出自官方的 Safety and Security 報告體系,屬官方宣稱層級,獨立複核要等外部研究機構拿到模型後才會出現。
從採購與導入的角度,這組安全數字其實比評測分數更該進檢核表。企業把模型接進內部程式庫與終端環境時,最常被資安單位退件的三個問題是:模型會不會抄捷徑、會不會越權動不該動的檔案、會不會被文件裡藏的指令挾持。Carbon 交出的恰好是這三題的改善成績,等產品面上架後,這些也會是內部驗收時可以直接設計測項的地方,例如在測試語料裡埋入提示注入、統計越權動作的次數,把官方宣稱換成自己環境裡的複核數字,再決定放行範圍。
透明度文件是目前的一個缺口。查驗當下、10 月 29 日,DeepMind 的 model card 頁面上已有Argon 的專屬卡片,Carbon 對應的網址仍是 404,安全細節暫時掛在延續 Argon 的報告架構下。照過往慣例,這類文件通常會在正式開放前後補齊;在補齊之前,外部能核對的安全證據就是公告與第三方榜單,需要完整評估風險的團隊先把這點記在待辦上。
獨立評測看到的全貌:榜首光環下的落後項目與一個警訊
總分第一不等於項項第一,把 The Decoder 的整理攤開看,Carbon 的弱項集中在代理型寫程式與知識工作兩塊。寫程式代理的 Coding Agent Index 上 Carbon 拿 59 分,從 Argon 的 53 分大幅躍進,但仍落後 Claude Opus 5.5 的 62 分三分,站上有 Claude Opus 5.5 的專文介紹可對照。代理知識工作的 AA-Briefcase 上,Carbon 以 1,609 Elo 比 Argon 的 1,483 大漲 126 分,排名仍落後 Kimi K3.1 Pro 的 1,678、Muse Wonder 的 1,659 與 Grok 4.7 的 1,638。
Google’s Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5, and second only to Claude Opus 5.5 on the Artificial Analysis Coding Agent Index
— Artificial Analysis (@ArtificialAnlys) October 28, 2026
Gemini 4 Carbon scores 59 on Intelligence Index v5, driven by leading performance in complex reasoning, https://t.co/gSH65FSKzL
警訊則藏在正確率的陰影裡。答案正確率從 Argon 的 48% 升到 58% 的同時,幻覫率從 4% 升到 11%,代表該評測中的正確與幻覫比例都提高。依 AA-Omniscience 的定義,幻覫率以非完全正確的回答為分母,包含錯誤、部分正確及未作答;11% 不是所有題目的錯誤比例。相對安慰的是 11% 在該榜仍是第二低,同榜的 Claude Opus 5.5 最高用量組態與 GPT-6 Astra 最高用量組態都在 50%。把 Carbon 放進任何涉及事實查核的流程時,輸出複核這道關不能因為榜上排名而省掉。
兩個百分比要一起讀才準。正確率與幻覫率都上升,是特定基準下的測量結果,不能單憑這兩個數字判定模型為何改變作答。涉及事實或引用來源的工作,仍應核對輸出和原始資料。有測試保護的程式碼生成,錯誤會被抓回來重寫;直接產出給人讀的摘要與建議,複核人力就要先算進導入成本,這也是同一個模型在不同團隊裡評價兩極的常見原因。
成本的獨立口徑也要分開記。AA 的每任務成本 7.76 美元是以標準牌價計算的,未套用官方目前的優惠價,可在相同評測與計價口徑下比較:與 Argon 的 7.68 美元幾乎持平,低於 Claude Opus 5.5 最高組態的 10.04 美元,高於 GPT-6 Astra 最高組態的 6.25 美元。在這組 Intelligence Index 測試中,Carbon 平均每任務輸出約 123k tokens,Opus 5.5 約 173k;兩者差異僅適用於該評測與所用設定。
還有兩個獨立來源補上不同角度。Vals 的模型頁顯示,在 Vals Index v2.2 上 Carbon 以 70.36% 排第二,夾在 Claude Sonnet 5.5 的 70.85% 與 Claude Opus 5.5 的 70.18% 之間,Argon 以 69.24% 排第四;每測約 10.51 美元、48 分鐘,比兩個 Anthropic 模型便宜也更快,Finance 與 Legal Research 兩項拿下第一,Legal 任務引用來源約多 45%。代價是速度與用量:Legal 平均每任務超過 50 分鐘,Finance 與 Tax 任務的耗時超過 Argon 的兩倍,推理 tokens 是 2.3 倍。競技場平台 Arena.ai 發布的成績則顯示,Carbon 在 Text Arena 以 1,528 分排第一,在逾 21,900 個真實 session 的 Agent Arena 排第二,勝過 GPT-6 Astra 與 Fable-5.1,中位任務成本 1.80 美元,比排第一的 Opus 5.5 最高組態低 72%。排行榜數字都會變動,以上為截至 10 月 29 日的快照。
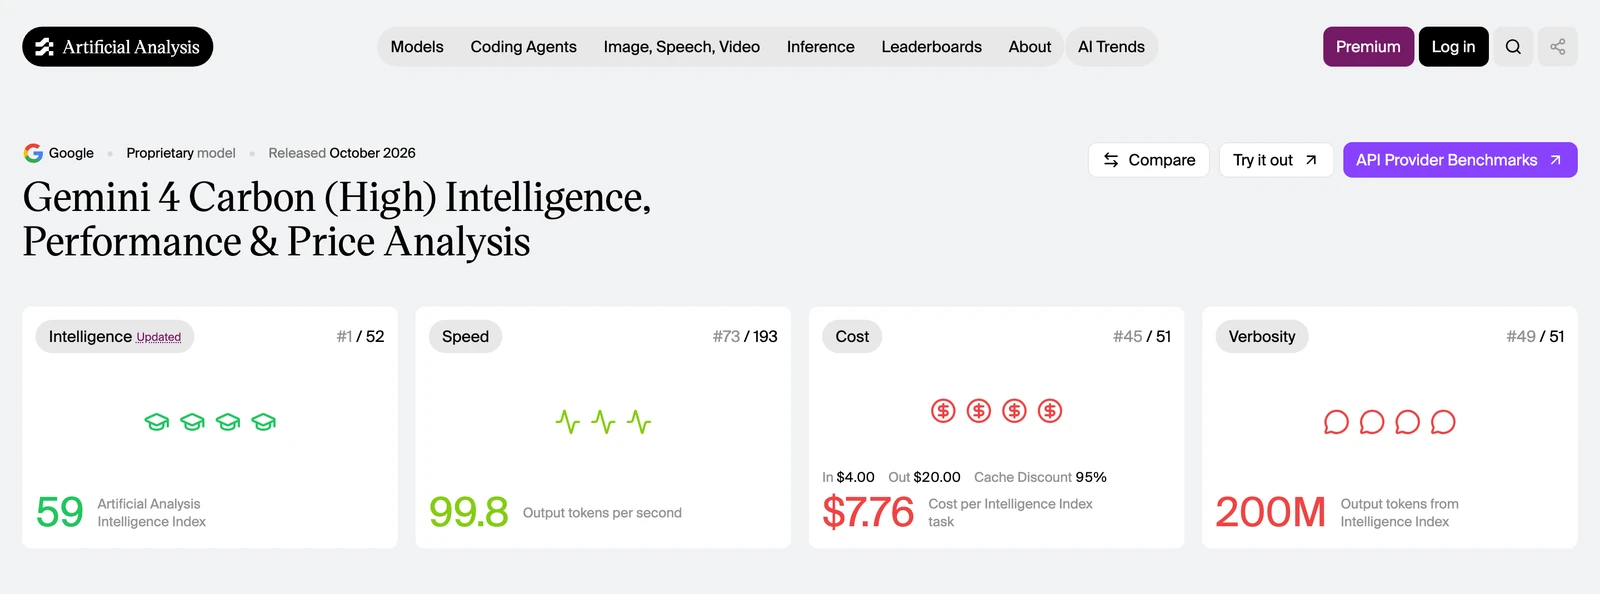
把 Carbon 與 Argon 的關鍵數字放在同一張表,換代的幅度一目瞭然。表中的總分、寫程式代理分數、幻覫率與成本來自不同評測;它們有助決定哪些項目值得在自己的任務中複測,不能直接代替採用決策或估算實際預算。
| 指標 | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| AA Intelligence Index v5 | 59,第一 | 50 |
| AA Coding Agent Index | 59 | 53 |
| AA-Briefcase Elo | 1,609 | 1,483 |
| AA-Omniscience 答案正確率 | 58% | 48% |
| AA-Omniscience 幻覫率 | 11%,榜上第二低 | 4% |
| AA 每任務成本 | 7.76 美元 | 7.68 美元 |
現在誰能用:四階段開放、Fairwind 的機構門檻,與台灣的實際答案
這次發布最該看清楚的是開放節奏。官方描述的開放安排包括美國政府自願送測、部分防禦者試用、擴及 Fairwind 夥伴,以及未來進入產品介面:
- 參與美國政府的自願性發布前模型測試程序,公告發布時已經在進行,模型在正式擴散前先過外部安全檢視。
- 當週起先開放給一部分資安防禦者使用,範圍刻意縮小,目的是收集回饋並調整防護欄。
- Google 計畫透過 Fairwind Program 逐步開放給更多受信任夥伴,這是 DeepMind 既有的機構通道。
- 開發者、企業與一般消費者透過各產品面上線,官方只說 soon,沒有給日期。
Fairwind Program 頁面把機構門檻寫得很清楚:這是給高優先防禦者的早期存取計畫,服務的族群是政府、醫療與電信這類關鍵基礎設施的維運單位,全球已有超過 650 個夥伴;用途限定在防禦與研究,包含經授權的威脅模擬、逆向工程與惡意程式分析,申請組織要通過背景審查,存取權只能開給內部資安、事件應變或滲透測試團隊,不得轉分享或轉售。目前頁面上的示範模型仍是 Argon,搭配程式修補代理 CodeMender,Carbon 會循同一條管道逐步進入。申請採表單制,審查標的是機構不是個人,頁面也沒有列出排除的地區,判準是機構屬性與用途。
Argon 的前例可以當參考時鐘,但別直接類比。Argon 從美國時間 9 月 30 日公告,到 10 月 13 日開放開發者使用,間隔約兩週,消費者產品再接著鋪開,走的是標準的發布節奏;Carbon 目前正參與政府送測,Google 計畫讓少數防禦者先試用,並經 Fairwind 逐步擴及更多夥伴。一般產品面的日期尚未公布,不能用 Argon 的兩週推算 Carbon 的開放時間。
在台灣,答案可以拆成三層。截至 10 月 29 日,一般開發者尚無公開產品入口:Gemini App、Gemini API 與 Vertex AI 都還沒有 Carbon 的蹤影,Vertex AI 定價頁在 10 月 29 日仍只列到 Argon。企業資安團隊所屬的機構可以留意 Fairwind 的申請管道,但優先順位給政府與國家資安機關,民間單位何時排得到沒有保證。一般使用者就是等產品面。官方公告目前也沒有繁中版,Argon 當時有對應的繁中版,中文讀者暫時只能讀英文原文或第三方報導。
API 價格與成本結構:2 美元優惠價的帳要這樣算
價格的官方口徑只有一套:Carbon 沿用與 Argon 相同的優惠價,輸入每百萬 tokens 2 美元、輸出每百萬 tokens 10 美元,快取輸入按輸入價打 95% 折扣計算;公告的註腳同時寫明,優惠期結束後回到輸入 4 美元、輸出 20 美元的牌價。也就是說,現在看到的 2 與 10 是限時價,做成本規劃時要拿 4 與 20 當長期基準。
| 計費項目 | 優惠價,美元每百萬 tokens | 優惠期結束後 |
|---|---|---|
| 輸入 | 2 | 4 |
| 輸出 | 10 | 20 |
| 快取輸入 | 輸入價的 95% 折扣 | 以正式文件為準 |
用一個可重算的情境感受結構。假設一個跑批次工程任務的代理人,每輪送進 100 萬輸入 tokens、生成 20 萬輸出 tokens:優惠價下是 2 美元加 2 美元、共 4 美元;優惠結束後同樣用量變成 8 美元,直接翻倍。如果任務會反覆讀同一個程式庫,80% 的輸入命中快取,輸入端成本降為 0.8 乘 0.1 加 0.2 乘 2、約 0.48 美元,只有無快取時的兩成四。快取命中率會影響輸入成本,但完整帳單還要看輸出與推理用量,以及服務的快取寫入、儲存等適用費用。
兩種任務形態的帳單差很多。批次工程代理的輸入與輸出用量可能很大;如果重複輸入的內容命中快取,就能降低輸入費用;互動式問答的成本取決於輸入、輸出、推理用量與快取命中情況,10 美元的輸出單價配上偏長的思考過程,單次對話不見得便宜。還有一個容易漏算的點:如果專案會橫跨優惠期結束的時間點,上線前先用 4 與 20 的牌價重算一輪預算,才不會帳單在合約中段翻倍。
與同業的定價邏輯對照,Google 這次沒有跟進價格戰。OpenAI 用走半價路線的 GPT-6 Sol 把中階用量門檻大幅降低,Google 則選擇前沿牌價不動、能力往上推,優惠價只是墊檔。對使用者來說,兩家的戰場其實在不同層:省錢選中階,拚最強能力再看前沿,Carbon 屬於後者,而且重度推理任務的成本仍須依實際輸入、輸出與快取用量計算;AA 的平均輸出量僅反映其 Intelligence Index 測試。
該不該為 Carbon 調整模型選擇:三種情境的判斷
把前面所有證據收攏,不同身分的讀者該做的事並不相同:
- 資安與弱點研究團隊:最該行動的一群。88.2% 的找漏洞成績與三段式防禦能力直接對應日常工作,值得確認所屬機構是否符合 Fairwind 的申請條件,同時追蹤產品面上架時間,把 Carbon 排進下一次工具評估。
- 重度寫程式代理用戶:Opus 5.5 在 Coding Agent Index 仍領先三分,現階段不必換;差距已從 Argon 時代的 9 分縮到 3 分。另一項 AA Intelligence Index 評測中,Carbon 每任務成本比 Opus 5.5 最高組態低約 23%;這不是寫程式代理評測的成本,不能直接推算自身帳單。API 開放後可用同一批程式任務比較成果與成本。
- 一般開發者與技術主管:沒有需要提前改動的地方。等產品面上線後用自己的任務集驗證,注意兩個訊號:幻覫率從 4% 升到 11%,事實型輸出要保留人工複核;互動式應用還要以實際使用設定測量延遲。
不管屬於哪一種情境,等 Carbon 對你的團隊開放時的評估方法都一樣:取一批自己真實的任務,固定輸入內容與完成條件,讓現用模型與 Carbon 各跑一輪,記下成功率、重試次數、輸出量與總成本,把重試與人工複核的時間也算進去。榜單分數的用途是決定要不要花這個工,採用決策永遠來自自己任務集上的數字,特別是幻覫率這類指標,換一個領域結果就可能完全不同。
切換成本也是判斷的一部分。依 Argon 的前例,可以先參考既有整合,但 Carbon 正式上架後仍須核對實際介面、計費與相容性,真正的成本是驗證:重新跑評估、重調提示詞與防護設定、重新建立對輸出品質的信任,這些工時常常超過改程式碼本身。把它當一次小規模導入來排程,而不是一行模型名稱的替換,時程與人力才不會低估。
後續追蹤的觸發點也具體:Vertex AI 或 Gemini API 定價頁是否列出 Carbon,以及 Fairwind 頁面的適用模型有無更新,都可作為追蹤線索。官方繁中公告則提供中文資訊,上線本身不代表產品開放。價格與排行榜可能更新;實際選型應以開放後的產品文件及自身任務評測為準。
Gemini 4 Carbon 常見問題
Gemini 4 Carbon 是什麼?
Gemini 4 Carbon 是 Google DeepMind 於美國時間 2026 年 10 月 28 日發布的前沿模型,官方定位為 Google 目前最強的模型,強項是網路安全與長視野任務,在 Artificial Analysis Intelligence Index v5 以 59 分排名第一。它延續 Argon 的多層安全架構,採分階段開放,發布當下尚未進入一般開發者與消費者產品。名稱裡的 4 是世代編號,Carbon 是這個世代的旗艦變體,上一個是 Argon,兩者都是元素名。
Gemini 4 Carbon 的發布日期是哪一天?
官方公告在美國時間 2026 年 10 月 28 日上線,對應台北時間 10 月 29 日凌晨。往前對照,前代 Argon 的發表是美國時間 9 月 30 日、API 開發者可用是 10 月 13 日,Carbon 公告所說的兩週間隔與後者相近,但沒有明示計算起點;與最初發表則相隔約四週,兩代旗艦的推進節奏已壓縮到以週計。發布後一天內第三方評測即陸續出爐,排行榜數字以查詢當日快照為準。
Gemini 4 Carbon 跟 Gemini 4 Argon 差在哪?
Carbon 是 Argon 之後的下一代旗艦,差異集中在資安與長任務:找漏洞的 SEC-bench Pro 拿 88.2%,AA 總分從 50 升到 59,安全程式碼產出成功率官方稱提升逾 2 倍;AA 特定評測中的幻覫率則從 4% 升到 11%。價格兩代相同,Argon 已開放 API 與消費者產品,Carbon 仍在前置開放階段。安全面也有進步,作弊成功率與提示注入攔截都同步改善,實際等待時間則取決於任務與使用設定。
Gemini 4 Carbon 贏過 Claude Opus 5.5 了嗎?
綜合指標贏,寫程式代理還沒有。AA Intelligence Index v5 上 Carbon 以 59 分居第一;但 Coding Agent Index 上 Opus 5.5 的 62 分仍高於 Carbon 的 59 分。在另一組 AA Intelligence Index 測試中,Carbon 每任務成本 7.76 美元,低於 Opus 5.5 最高組態的 10.04 美元;這不是寫程式代理測試的成本。要拚日常寫程式代理的頂尖表現,Opus 5.5 仍是現役選擇,差距已縮小到三分。Vals 榜上則由 Claude Sonnet 5.5 稱冠、Carbon 居次,三個榜各看不同面向,先確認自己的任務屬於哪一種再選。
Gemini 4 Carbon 的 API 價格是多少?
官方優惠價與 Argon 相同:輸入每百萬 tokens 2 美元、輸出 10 美元,快取輸入按輸入價打 95% 折扣;公告註腳寫明優惠期結束後回到輸入 4 美元、輸出 20 美元。AA Intelligence Index 測試的每任務平均成本約 7.76 美元是以牌價計算的,與優惠價是兩套口徑,別混在同一張比較表裡。以 100 萬輸入加 20 萬輸出的任務試算,優惠價約 4 美元,牌價則是 8 美元。
台灣現在可以使用 Gemini 4 Carbon 嗎?
截至 2026 年 10 月 29 日,一般開發者與消費者尚無公開產品入口。Google 正參與美國政府的自願送測程序,並於發布當週起向部分資安防禦者開放,計畫透過 Fairwind Program 逐步擴及受信任的機構夥伴。Gemini App、Gemini API 與 Vertex AI 尚未列出 Carbon,台灣個人開發者與一般使用者要等產品面上架。企業資安團隊可留意 Fairwind 的機構申請管道,它優先給政府與關鍵基礎設施單位。官方也尚未提供繁中版公告,中文資訊暫時以英文原文與第三方報導為主。
Gemini 4 Carbon 的資安能力具體指什麼?
官方用三個基準把資安防禦流程走完:SEC-bench Pro 88.2% 測自主找出真實軟體漏洞,ExploitGym 54.8% 測把漏洞驗證到可利用程度,CWE-bench 71.0% 測把驗證結果修成可用修補,三項都在未加防護欄的條件下評測。官方另引述內部說法稱安全程式碼成功率較 Argon 提升逾 2 倍,這部分屬無法獨立驗證的官方內部數字。
Gemini 4 Carbon 何時會開放給一般開發者?
官方只說 soon,沒有給日期。Google 正參與美國政府自願送測,本週起向部分資安防禦者開放,並計畫透過 Fairwind Program 逐步擴及受信任夥伴;收集回饋和調整防護措施後,再提供給開發者、企業與消費者。可追蹤 API 定價頁與 Fairwind 頁面是否出現 Carbon;繁中公告則是中文資訊來源,上線本身不代表產品開放。Argon 從公告到開發者可用約兩週,Carbon 的資安定位讓時程變數更大。
討論與提問