Kimi K3.1 Pro 是月之暗面(Moonshot AI)在 2026 年 10 月 23 日公告的新旗艦模型,換算台北時間為 10 月 24 日凌晨。它是 K3 的後訓練強化版,也是 K3.1 系列的第一個模型,採 2.8 兆(2.8T)總參數、104B 活躍參數的 MoE 架構,支援 100 萬 token 上下文。API 每百萬 token 輸入 2 美元、輸出 10 美元,均比 Kimi K3 低三分之一。目前先透過 Kimi 各產品與 API 提供服務;依官方發布公告,完整權重預計在 2026 年 11 月 4 日前釋出,截至 10 月 24 日仍應區分「已可使用」與「權重已開放」。
Kimi K3.1 Pro 主打寫程式、3D 建模與金融研究,支援 1M 上下文與原生視覺輸入;API 僅提供思考模式,可調整推理力道。
標準版 API 每百萬 token 輸入 2 美元、輸出 10 美元;Highspeed 版為 4 美元與 20 美元,官方稱速度約為標準版的 2 至 3 倍。
官方承諾完整權重於 11 月 4 日前釋出;企業組織上線時預設關閉此模型,需由管理員啟用。K2 系列則預計於 12 月底前退役。
影片解析:Kimi K3.1 Pro 值得換嗎?
以影片頁觀賞:Kimi K3.1 Pro 值得換嗎?3D 建模、API 價格與權重狀態
Kimi K3.1 Pro 是什麼?K3 之後的後訓練強化旗艦
Kimi K3.1 Pro 的能力基礎來自 Kimi K3。前代 K3 於 2026 年 7 月推出,權重與技術報告在 7 月 27 日開放,總參數 2.8 兆,同樣支援 100 萬 token 上下文與原生視覺理解。依K3 技術部落格,架構結合 Kimi Delta Attention(KDA)、Attention Residuals 與 Stable LatentMoE,從 896 個專家中選用 16 個;官方稱整體 scaling efficiency 約為 K2 的 2.5 倍。想複習大型語言模型的運作原理與模型競賽的脈絡,可以回頭看本站的LLM 原理與模型介紹。
K3.1 Pro 是 K3 的後訓練(post-training)強化版,投入了更多後訓練算力,透過大規模聯合強化學習涵蓋數百個下游領域。官方在發布部落格說明,這次同時優化 RL 框架、長上下文推論、訓練效率、沙箱基礎設施、任務排程與環境品質檢查平台,讓增加的 RL 算力能帶來較穩定的能力提升。後訓練也是近期模型更新的重要方向,可延伸閱讀GLM-5.3 的能力與後訓練更新。
預訓練建立模型的知識與基礎能力,後訓練再改善它遵循指令、推理與完成任務的表現。K3.1 Pro 的官方評測顯示,程式、財務與長程代理任務都有進步,但這些成績不能直接推成每個問題都能一次答對。API 的思考模式無法關閉;想平衡回應時間與推理深度,可以用 reasoning_effort 測試不同檔位,並另外要求最終答案的篇幅。
多模態輸入有實作限制。依官方 API 快速上手文件,圖片要轉成 base64 或先上傳檔案,視覺輸入不直接接受公網圖片 URL;影片則先經檔案 API 上傳,再用 ms:// 引用。檔案上傳與抽取服務目前暫時免費,將內容送入模型仍按 token 計費。一般 API 支援文字、圖片與影片輸入,輸出為文字;Kimi Code 等其他入口的協定與限制需分開確認。模型可以產出建模腳本,圖片生成仍須搭配其他工具。
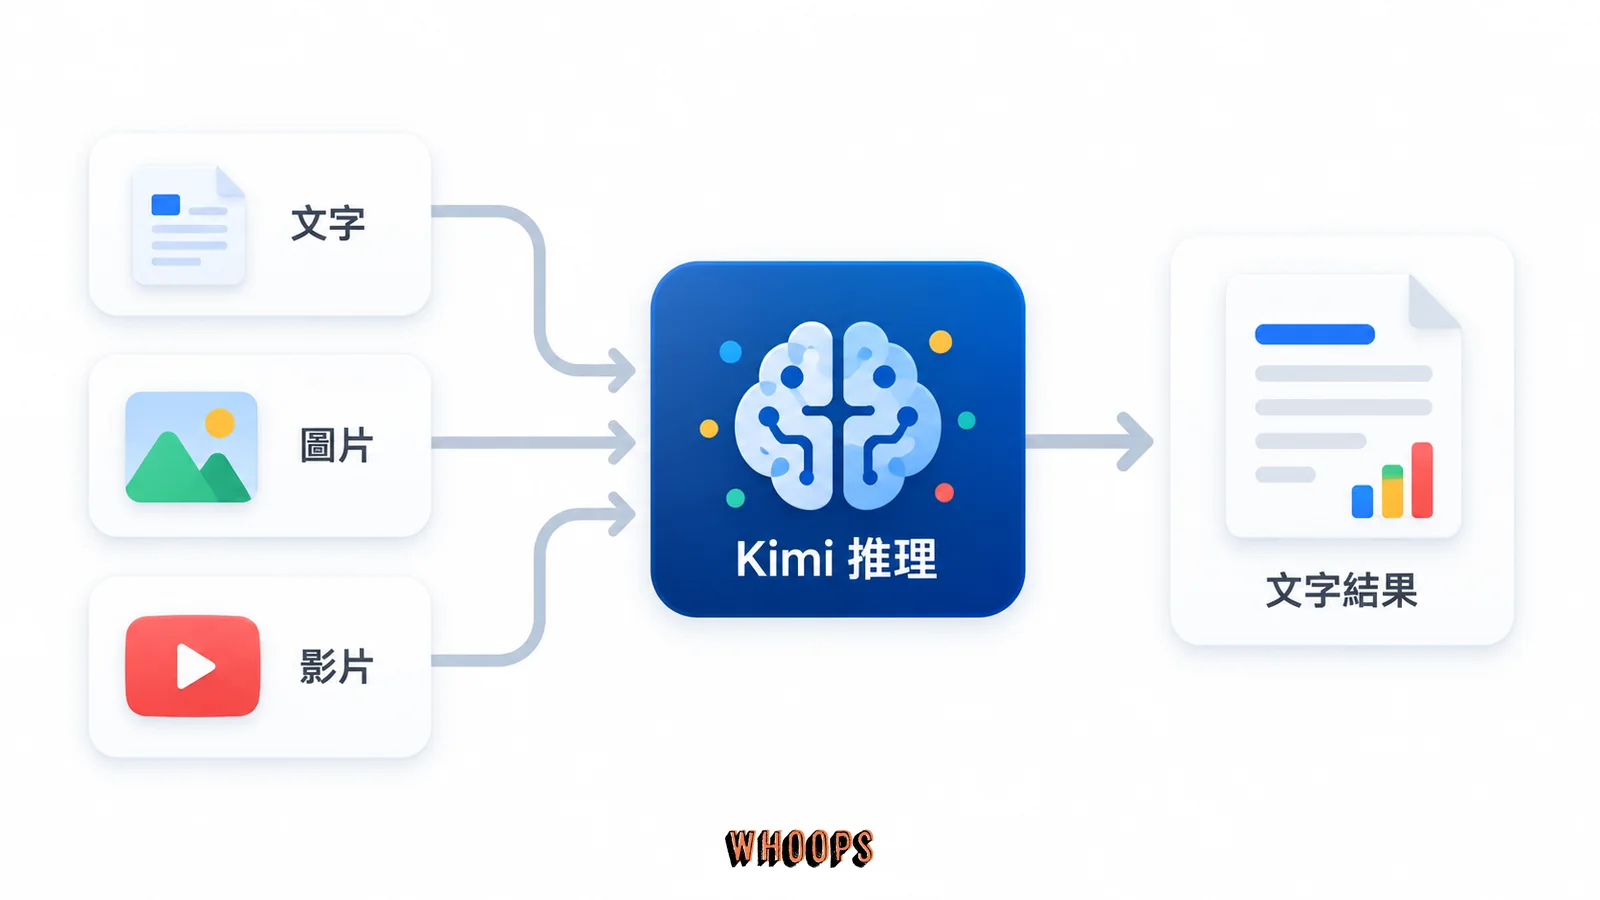
規格方面,官方 X 公告列出 1M token 上下文、2.8T 總參數/104B 活躍參數的 MoE 架構與多模態能力。API 的模型 ID 是 kimi-k3.1-pro;依開發者文件,reasoning_effort 支援 low、high、max,預設 max;temperature=1.0 與 top_p=0.95 為固定值,呼叫時應省略這些參數。
| 項目 | Kimi K3.1 Pro 規格 |
|---|---|
| 開發公司 | 月之暗面(Moonshot AI) |
| 模型定位 | Kimi K3 的後訓練強化版;K3.1 系列首個模型 |
| 參數 | 2.8T 總參數/104B 活躍參數(MoE) |
| 上下文 | 一般 API 最高 1,048,576 token;Kimi Code 依會員權益為 256K 或 1M |
| 一般 API 模型 ID | kimi-k3.1-pro/kimi-k3.1-pro-highspeed |
| 思考模式 | 強制開啟;low/high/max,預設 max |
| 輸入與輸出 | 一般 API 可輸入文字、圖片與影片;輸出文字,各產品入口限制另計 |
| 標準版 API 單價 | 每百萬 token:輸入 $2、輸出 $10、快取命中 $0.20,快取寫入依 TTL 分類 |
| 權重狀態 | 截至 2026-10-24 尚未釋出;官方承諾 2026-11-04 前公開完整權重 |
Introducing Kimi K3.1 Pro: our most capable 3T-class open-weight model.
— Kimi.ai (@Kimi_Moonshot) October 23, 2026
🔹 1M-token context, 2.8T total / 104B active params (MoE), Multimodal.
🔹 Full-project coding: games in Unreal, Unity & Godot.
🔹 Excels at parametric 3D modeling in Blender & CAD.
🔹 More reliable at… pic.twitter.com/klydcszv02
模型名稱與模型 ID 要依入口區分:一般 Kimi API 使用 kimi-k3.1-pro;Kimi Code 使用 k3.1-pro;Vercel AI Gateway 則使用 moonshotai/kimi-k3.1-pro。不能只把產品名稱貼進所有工具的模型欄位。
跑分與實際能力:寫程式、3D 建模與金融研究的提升
依官方公布的評測,K3.1 Pro 在 Terminal-Bench 4.0 拿到 65.7%,高於 GPT-6 Astra 的 58.2%,略低於 Claude Opus 5.5 的 66.4%;內部長程專案評測 Kimi Code Bench 3.0 從 K3 的 55.95% 提升到 61.2%。官方另展示 Unreal Engine、Unity、Godot 專案,包括含 3,600 萬個來源三角面的東方天宮場景,以及含 2,100 個 solid 元件、可呈現拆解動畫的渦輪發動機模型。這些是官方挑選的展示案例,部分專案也使用外部素材庫。
Terminal-Bench 4.0 測的是代理在終端機任務中的端到端表現,以各任務的測試判斷成功與否。65.7% 與 66.4% 相差 0.7 個百分點,但僅憑這兩個分數,不能判定差距是否具有統計意義。官方註腳也說明,各模型的 harness 與成績來源未必一致。BenchCAD 的 Voxel IoU 衡量重建幾何與參考物件的體素重疊程度;它能比較幾何相似度,無法單獨代表工程可用性或設計品質。
3D 建模的實際用途,是讓模型產出可再修改的建模腳本。K3.1 Pro 可以撰寫 Blender 的 Python 腳本與 CAD 定義,再透過執行環境建立、修改幾何、材質及場景。這種方式不必依賴 MCP 連接器,但仍需要可執行 Blender 或 CAD 軟體的工具環境。對遊戲開發、產品設計與建築視覺化團隊而言,輸出的腳本與模型檔可以作為後續編修的起點;尺寸、結構與製造需求仍須另行驗收。
在官方 BenchCAD 評測中,K3.1 Pro 使用工具時的 Voxel IoU 為 92.7%,Claude Opus 5.5 為 96.2%、GPT-6 Astra 為 95.9%,DeepSeek-V4.1-Flash-1017 為 81.6%;無工具條件下,K3.1 Pro 為 72.8%,Opus 5.5 為 73.0%。這裡的開放模型成績來自官方從 Vision2Code 資料集隨機抽取的 1,000 題子集,應連同工具條件與樣本範圍閱讀。
金融研究是第三個主打場景。官方報告 K3.1 Pro 在 OfficeQA Pro v2 拿到 64.4 分、在其比較表中居首,Frontier Finance 為 58.6 分;內部評測相較 K3,財務建模增加 7.2 分、金融研究增加 11.6 分,商業經營模擬則從 8.9 分提升至 37 分,約 4.2 倍。在官方 Kimi Hallu Bench Hard 壓力測試中,單項事實陳述的幻覺率從 K3 的 23.4% 降至 8.3%,含至少一項事實錯誤的回應比例為前代的 42.4%。這些是刻意挑選容易出錯情境的內部測試,不能當作日常使用的一般錯誤率。
長程代理(agentic)能力有一個官方案例:在開源人體解剖模型 human-atlas 上訓練行走控制器,K3.1 Pro 執行了 167 個任務、經歷 420 次獨立審查;當報酬調整失效時,它改用開環探測,找出並修正肩部肌肉力臂計算的 36 處錯誤,再重新訓練,讓模擬人從幾秒內跌倒進步到連續行走 11.2 秒。這個案例展示了多步診斷與修正,但不等於其他長程任務也有相同成功率。對 agentic AI 還不熟悉的讀者,可以參考本站的AI Agent 定義與原理。
想比較其他模型的功能、價格與使用入口,可延伸閱讀本站的Claude Opus 5.5 完整介紹與GPT-6 Astra 解析。選型時可先用同一批任務、工具與驗收標準試跑,再比較成功率、耗時與總成本;單一官方評測無法涵蓋所有工作需求。
API 價格多少?K3.1 Pro、Highspeed 與舊模型費率對照
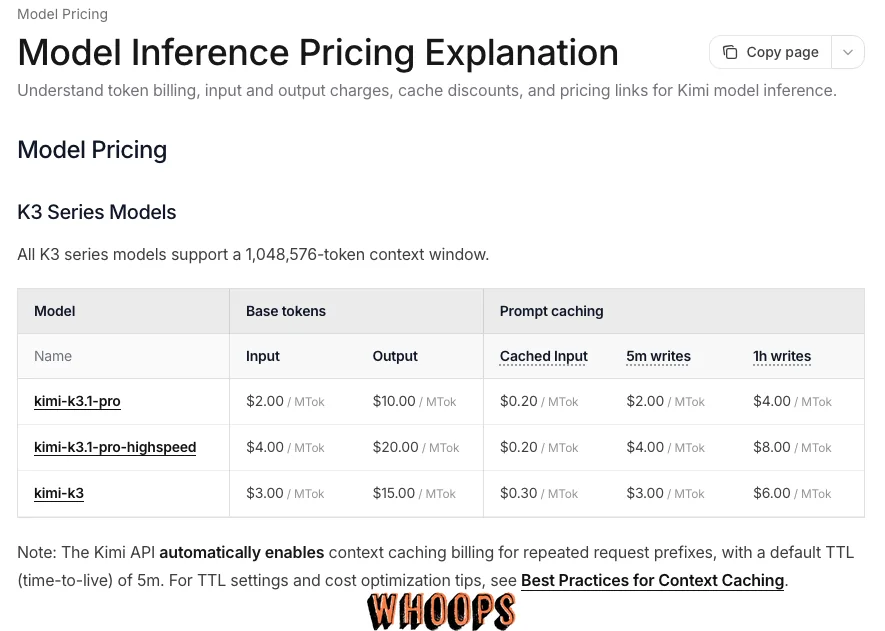
Kimi API 採用量計費,與 Kimi 會員訂閱分開。K3.1 Pro 每百萬 token(MTok)輸入 2 美元、輸出 10 美元,快取命中 0.2 美元;5 分鐘 TTL 的快取寫入為 2 美元、1 小時 TTL 為 4 美元。Highspeed 版輸入 4 美元、輸出 20 美元。相較 Kimi K3 的 3 美元與 15 美元,標準版輸入與輸出單價均降低三分之一。以下依官方 API 定價頁整理,幣別為美元、不含稅;需要比較另一種旗艦定價策略,也可參考GPT-6 Sol 的價格與定位。
| 模型 | 輸入 / MTok | 輸出 / MTok | 快取命中 | 快取寫入 5m | 快取寫入 1h | 上下文 |
|---|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 | 1M |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 | 1M |
| kimi-k3 | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 | 1M |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | — | — | 256K |
| kimi-k2.7-code-highspeed | $1.90 | $8.00 | $0.38 | — | — | 256K |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | — | — | 256K |
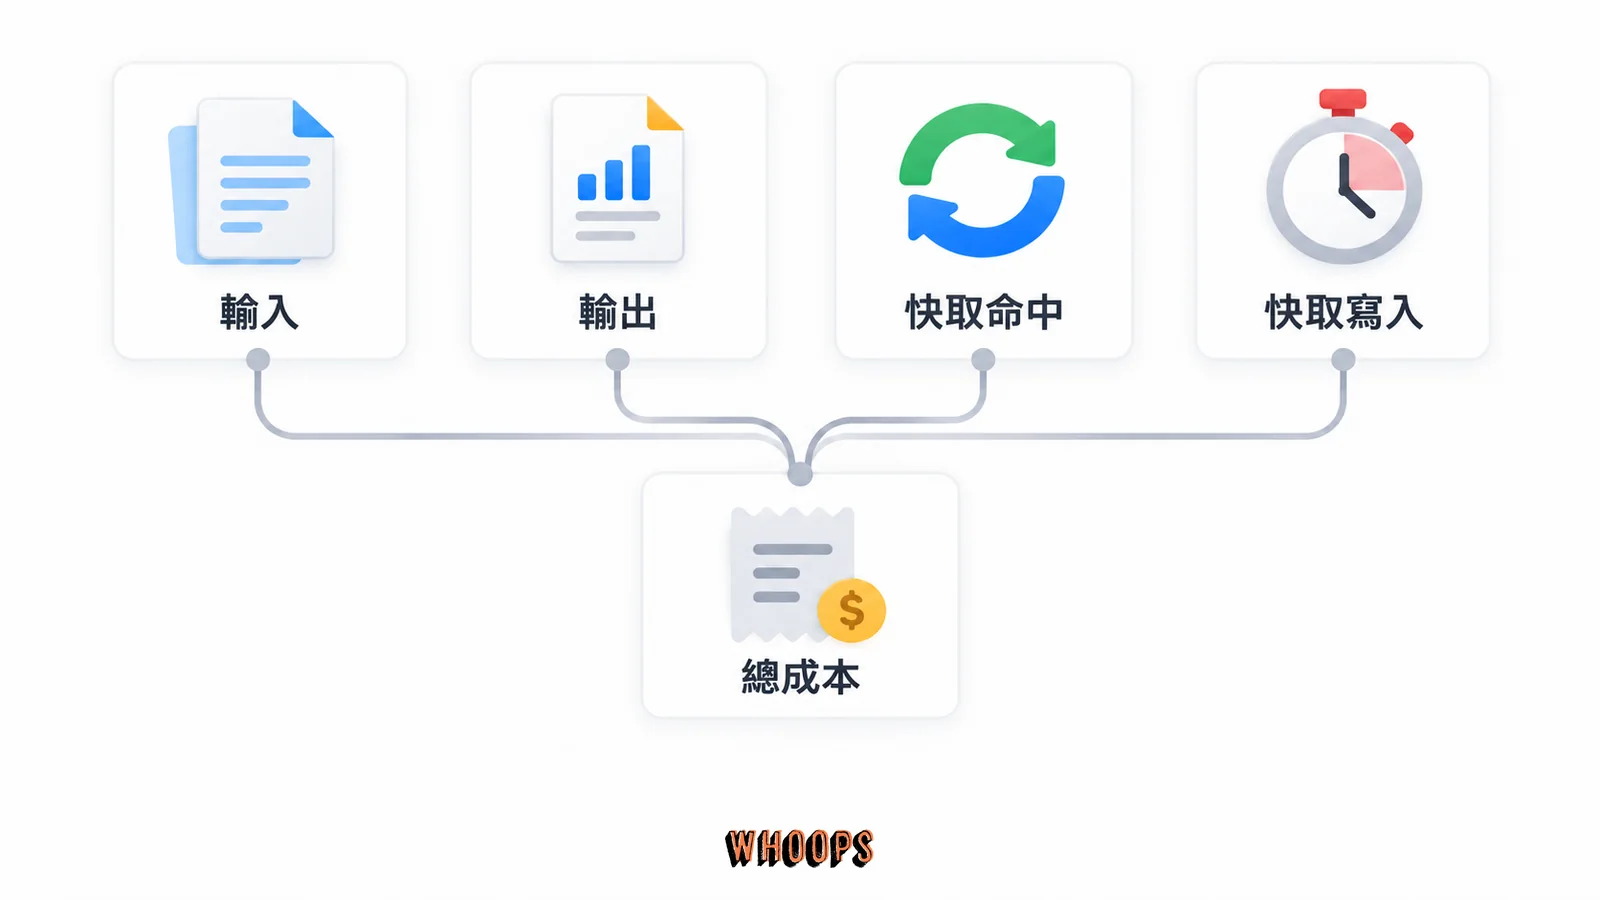
快取預設自動啟用,TTL 為 5 分鐘,重複且未變動的請求前綴可按命中價計費。依官方快取文件,cache read、cache write 與未快取餘額是互斥的 token 類別,加總等於總輸入量;同一個 token 不應重複加上一般輸入費與寫入費。檔案上傳與抽取服務目前暫時免費,但送入模型的內容仍須計費。Batch API 為標準價的 6 折,目前列出的支援模型是 kimi-k2.7-code 與 kimi-k2.6,未包含 K3.1 Pro。
使用門檻方面,帳號至少儲值 1 美元才能開始呼叫 API;累計儲值金額同時決定帳號層級與 RPM、TPM、TPD 等速率限制,細節見官方儲值與速率限制說明。以標準版計算,10 萬個未命中快取、或按預設 5 分鐘 TTL 新寫入的 token 為 0.2 美元,輸出費另計;若選 1 小時 TTL,新增快取寫入按對應費率計算。
以程式碼審查為例:假設固定程式庫放在前綴,共 120,000 token,後面新增問題與指令共 8,000 token,並輸出 6,000 token。首次請求的 128,000 個輸入 token,若按預設 5 分鐘寫入或未快取費率 2 美元/MTok 計算,成本為 0.256 美元;輸出另為 0.06 美元,合計 0.316 美元。若下一次仍有 120,000 token 前綴命中,只有 8,000 token 為新增輸入,輸入端成本為 120,000 × 0.2 ÷ 1,000,000 + 8,000 × 2 ÷ 1,000,000 = 0.04 美元;輸出量相同時合計 0.10 美元。這個試算未含稅,實際快取區塊與 token 分類以 API 回傳的 usage 和帳單為準。
獨立評測怎麼看:Artificial Analysis 的速度與智慧指數
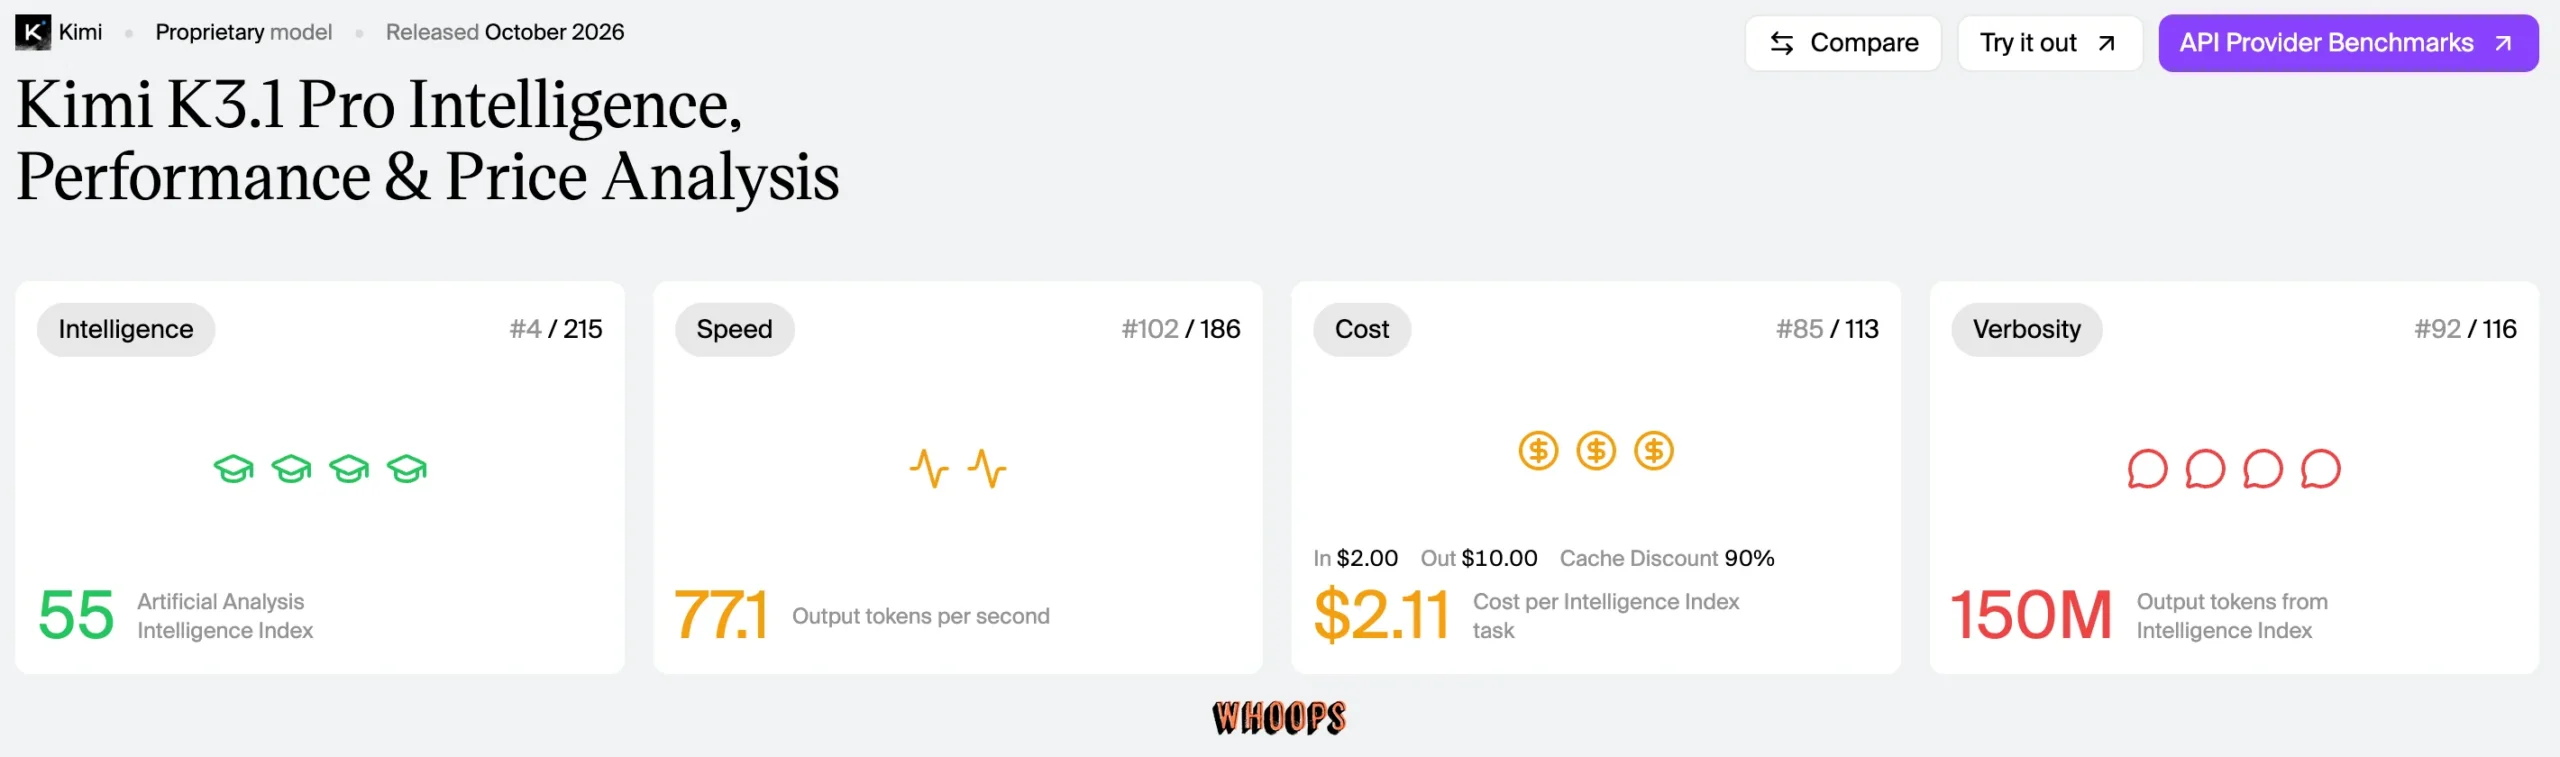
依 Artificial Analysis 的 K3.1 Pro 模型頁,截至 2026 年 10 月 24 日本次查閱,智慧指數為 55 分,摘要卡在同類比較的 215 個模型中列第 4;同價位比較中位數為 27 分。該頁觀測到的 Kimi API 輸出速度為 77.1 token/秒,同價位中位數為 79.4;首 token 延遲為 2.89 秒,中位數為 3.65 秒。其每百萬 token 混合價格為 1.54 美元,假設比例是「快取命中:未快取輸入:輸出=7:2:1」,未包含另外產生的快取寫入費,不能直接當作每項任務的成本。
Artificial Analysis 的智慧指數方法有公開權重與測試方式;它是多項評測的綜合分數,個別任務的表現仍須分開看。模型頁的名次也要連同比較群組閱讀,不能把同價位名次當成全榜名次。速度與延遲反映該站對 Kimi API 的觀測,會隨測試時間、請求長度與服務負載變化;首 token 可能仍是推理內容,並不等於使用者已收到最終答案。
同一份獨立評測顯示,K3.1 Pro 在智慧指數測試中輸出約 1.5 億 token,同價位比較中位數約為 8,700 萬。輸出量包含模型推理等消耗,不能直接解讀為最終答案較冗長,但確實會影響按 token 計費的總成本。導入時可分別測試 reasoning_effort 的 low 與 max,同時記錄答案品質、總 token 與完成時間。
聚合服務也已有官方支援。Vercel 於 10 月 23 日公告,AI Gateway 上線 K3.1 Pro 與 Highspeed,推論費率依供應商定價,不加價或另收推論平台費。這能讓原本使用 AI Gateway 的應用沿用既有入口,但仍要使用 Gateway 專屬的模型 ID,並確認資料處理與帳務設定。
台灣怎麼用?六個入口與免費、付費的界線
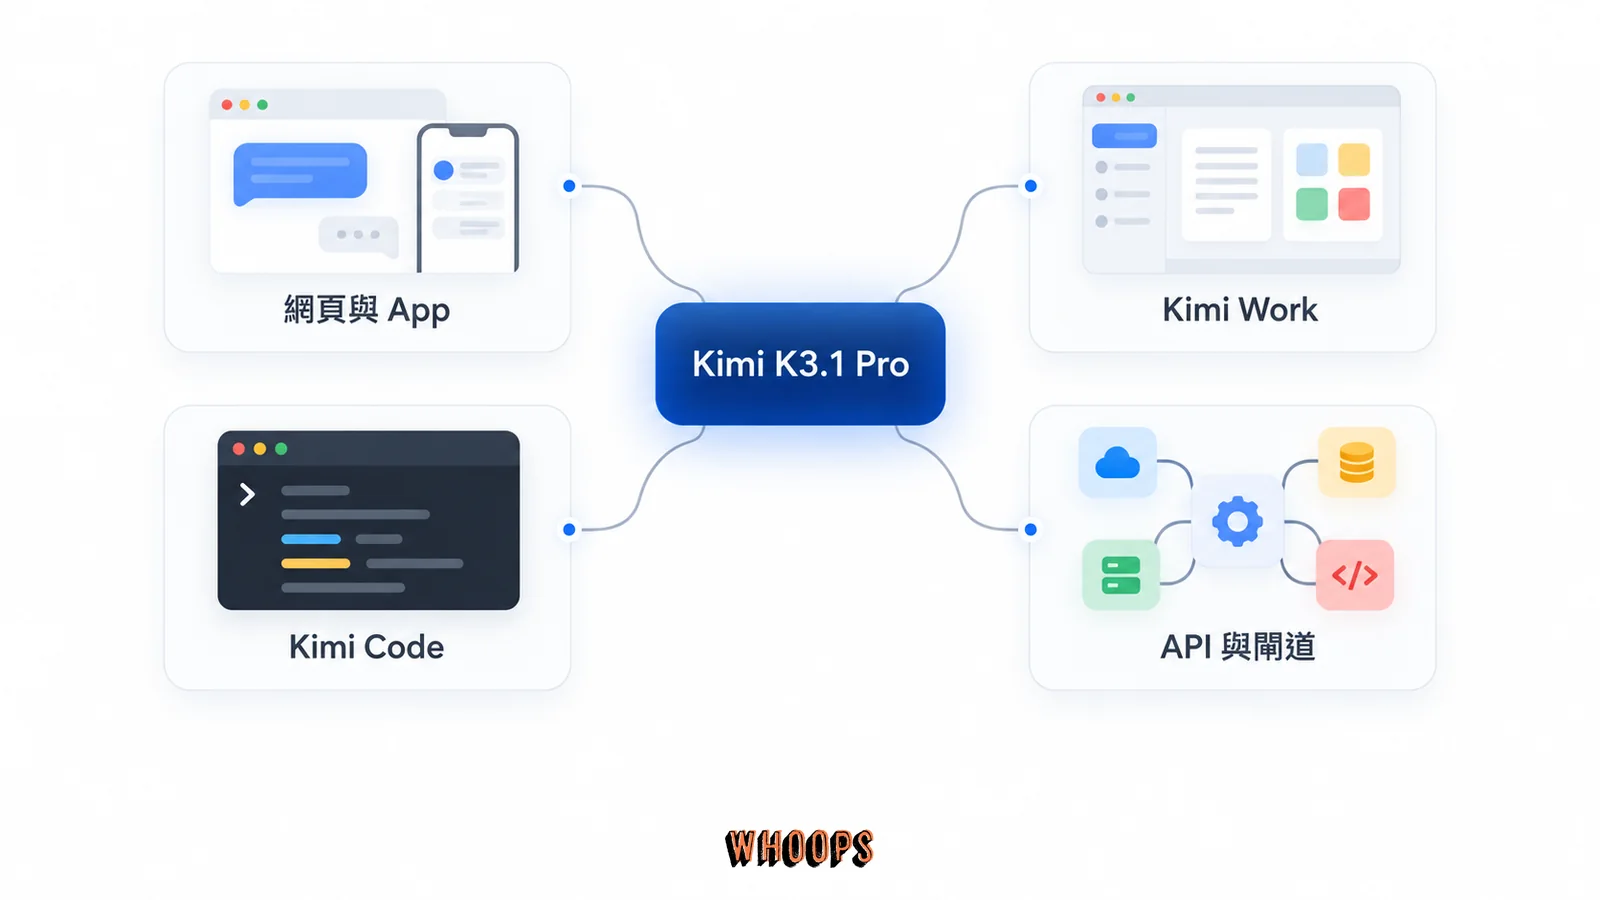
官方列出的入口包括 kimi.com 網頁版、Kimi App、Kimi Work、Kimi Code 與 API。網頁版與 App 的模型選擇、額度及地區可用性,以登入後實際方案為準,不能只因首頁公告新模型就認定每個免費帳號都能指定它。App 提供 iOS、Android 與 HarmonyOS 版本;發布公告列出的 Kimi Work 條件為 Windows 或 Apple silicon Mac、3.1.0 版以上。Kimi Code CLI 可用 /model 切換;依模型與會員權益文件,Plus/舊制 Moderato 以上可用 K3.1 Pro,最高 256K 上下文;Pro/舊制 Allegretto 以上才解鎖 1M 與 Highspeed。
開發者可以到 Kimi API 平台註冊、建立 API key,依平台要求至少儲值 1 美元,再呼叫 kimi-k3.1-pro。官方提供 OpenAI SDK 的 Chat Completions 範例,base URL 為 https://api.moonshot.ai/v1,完整寫法見快速上手文件;固定參數、推理欄位等差異仍須依 Kimi 文件調整。另一個入口是 Vercel AI Gateway;也能依官方文件接進 Codex、Claude Code、OpenCode、OpenClaw 與 Hermes Agent。原本習慣Claude Code,或正在比較Codex 與 Claude Code 使用差異的人,可以先用一個獨立測試專案確認相容性。
連接編碼代理前,先分清一般 API 與 Kimi Code。Kimi Code 的 Codex 指南使用原生 Responses API 與自訂 provider;Claude Code 則依官方指南設定相容端點。Kimi Code 訂閱金鑰與一般開放平台金鑰不能互換,base URL 與模型 ID 也不同。多輪對話與工具呼叫時,應依文件把完整 assistant message 傳回下一輪,不能只保存最終答案的 content。
Meet Kimi K3.1 Pro, our most capable 3T-class model. pic.twitter.com/TB8aTQggHT
— Kimi.ai (@Kimi_Moonshot) October 23, 2026
免費額度、會員訂閱與 API 用量計費,分屬不同產品規則。企業方面,官方提供 API Zero Data Retention(零資料保留)選項;K3.1 Pro 在企業組織推出時預設關閉,須由管理員啟用。處理公司程式碼、財務資料或客戶文件前,應確認所選入口的資料處理條款與適用設定。想了解 Kimi 在內容工作上的其他用法,可以延伸閱讀用 Kimi 技能做 SEO 的完整教學。
台灣讀者可先從 kimi.com確認帳號可選的模型與額度;需要可指定模型的開發測試,再依 API 快速上手文件跑通第一筆請求。取得結果後,用幾個真實任務比較品質、延遲與帳單,再決定是否接進原本的代理。會員訂閱與 API 儲值應分開評估,避免為錯誤的入口付費。
開放權重、資安治理與本地部署的現實
截至 2026 年 10 月 24 日,K3.1 Pro 已透過產品與 API 提供服務,官方承諾完整權重在 11 月 4 日前釋出。這是未來的開放權重計畫,不能直接寫成權重已經公開下載,授權條款與實際部署方式也要等正式釋出確認。前代 K3 的權重、模型卡與技術報告可在 Hugging Face 官方 Kimi-K3 頁面取得;它的授權不能直接當作 K3.1 Pro 的授權。
依官方資安章節,研究團隊發現弱點研究能力隨後訓練規模增加,因此從中期訓練語料與 RL 環境中移除資安相關資料。在內部 xdev-bench-hard 評測中,未採取這些風險降低措施的版本 pass@3 為 90.5%,最終 K3.1 Pro 為 81.0%。官方將此作為開放權重決策的一部分:避免把開放模型的攻擊能力推至絕對前沿,同時逐步提供防禦方可用的審計能力。這是官方訓練治理與內部評測的說明,不能推成模型已無資安風險。
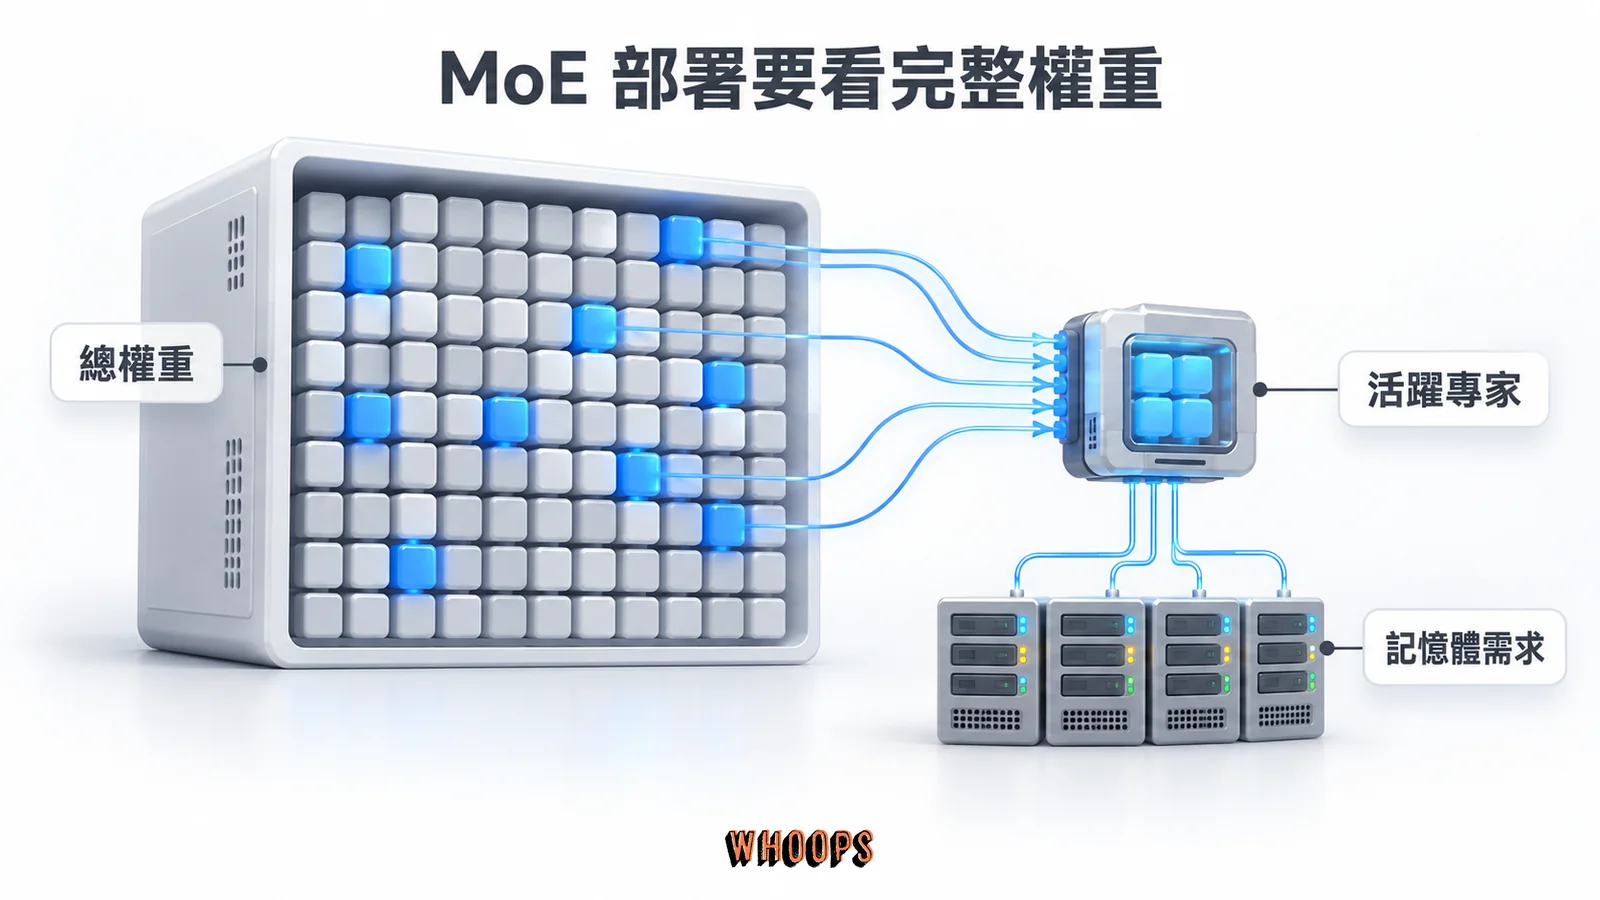
本地部署的第一個門檻是全部權重的儲存與記憶體需求。104B 活躍參數描述每次計算動用的規模,不代表只需存放 104B 參數就能保留完整模型。是否能用 Ollama、llama.cpp 或 vLLM 執行,還取決於權重格式、架構支援、量化方式、專家載入策略與硬體配置;K3.1 Pro 正式權重及部署文件尚未釋出,現階段沒有可據以保證的本地支援時程。
只做權重容量的粗估:2.8 × 10¹² 個參數 × 4 bit ÷ 8 ≈ 1.4 × 10¹² bytes,約為 1.4 TB(十進位),還未計入量化 metadata、執行環境與上下文所需記憶體。即使採用 1-bit,單算全部參數仍約為 350 GB;16GB 顯示卡無法一次容納這些完整權重。這些是儲存量估算,不能據此斷言必須使用幾張卡、是否能 offload,或未來量化版本的實際速度與品質。
若想對照其他開放權重模型的部署方式,可參考DeepSeek V4.1-Flash-1017 的權重與部署需求,分開評估完整權重、量化、KV cache 與 offload。
還在用 K2 系列的人要注意退場時程。官方公告自 2026 年 10 月 31 日起,不再向新註冊用戶提供 K2 系列,既有用戶暫不受這項新註冊限制影響;所有 K2 系列模型預計於 12 月底前退役。kimi-k2.5 與 moonshot-v1 系列則已於 8 月 31 日停止支援。可依官方模型總覽與退役公告盤點正式環境的模型 ID,安排遷移測試。
從 kimi-k2.6 遷移到 kimi-k3.1-pro 時,先檢查三處:第一,思考模式強制開啟,串流要分開處理 reasoning_content 與最終答案 content,工具對話需保留完整 assistant message;第二,temperature 與 top_p 為固定值,應移除不支援的自訂設定;第三,雖然可用上下文提高到 1M,仍須依實際輸入、推理、輸出與快取分類試算成本。參數細節以官方 K3.1 Pro API 文件為準。
值不值得現在換?三種情境的判斷
第一種情境:代理式寫程式與長文件工作流。1M 上下文與官方長程任務評測,讓 K3.1 Pro 成為可納入測試的選項。但程式庫或整批文件是否放得下,取決於 token 數、工具訊息與輸出預算;放得下也不等於所有內容都能被正確使用。可以先選一個小流量任務,以固定標準比較現用模型與 K3.1 Pro。
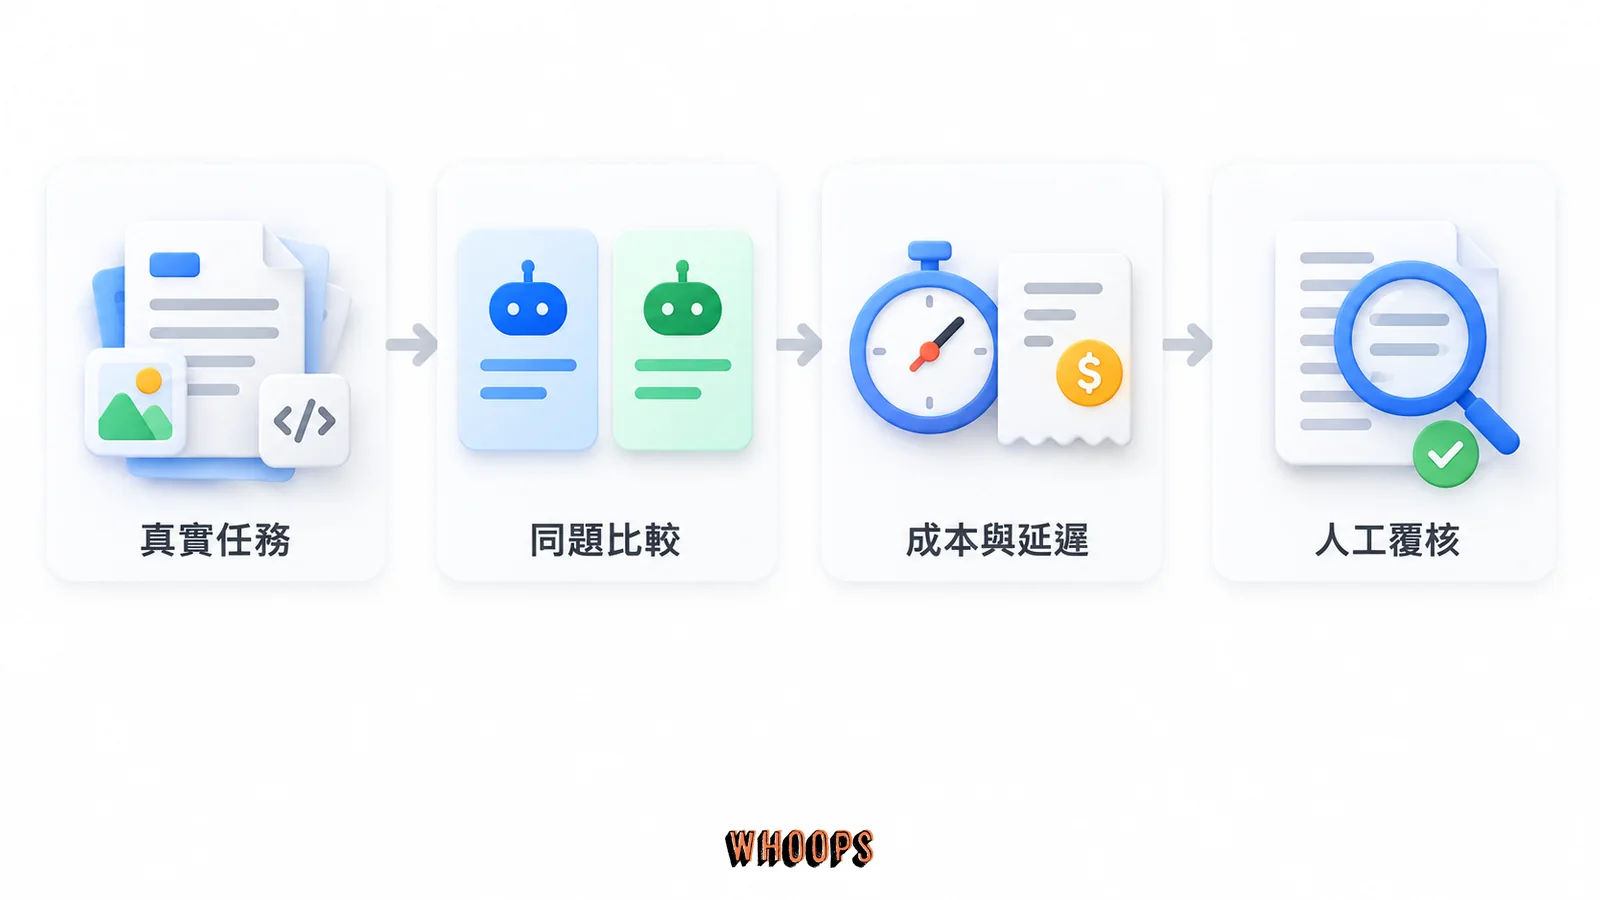
驗收可以照一個固定流程做,避免被單次好表現騙到:
- 挑 10 到 20 個你真實工作裡的任務,寫成可重跑的提示與固定的評分表,涵蓋簡單與困難兩種難度。
- 同一批任務用現用模型與 K3.1 Pro 各跑一次,記錄成功率、重試次數、總 token 消耗與實際完成時間,成本用同一份帳單口徑換算。
- 把 reasoning_effort 的 low 與 max 各測一輪,確認思考常開造成的輸出膨脹在你們的場景裡值不值得。
- 對輸出品質做抽查覆核,特別是數字與引用,幻覺率下降是壓力測試的結果,不能直接推成日常保證。
第二種情境:成本敏感的量產服務。除了輸入與輸出單價,還要比較推理 token、重試、快取命中率及完成時間。Highspeed 官方單價是標準版的兩倍,官方稱速度約為 2 至 3 倍;它可能縮短等待,但不會因此自動降低每次請求的 token 費用。對話助手可以測量第一段最終答案的等待時間,批次工作則比較整批完成時間與成功任務的平均成本。
如果任務只需很短的回答、延遲要求嚴格,或工作流高度依賴特定供應商的結構化輸出與函式呼叫行為,應優先測試這些條件。低單價無法補償不相容造成的重試與人工修正;仍在使用 K2 系列的服務,也要把官方退役時程納入維護成本。
第三種情境:已經依賴特定工具生態。使用相容介面有助於降低改接成本,但仍須驗證模型 ID、金鑰、端點、訊息格式、工具呼叫與快取行為。若採用條件包括自行託管,應等正式權重、授權與部署文件公開,再評估硬體及維運需求;11 月 4 日是官方承諾的權重時程,並非技術報告與所有工具支援都會同日備齊的保證。
Kimi K3.1 Pro 常見問題
Kimi K3.1 Pro 是什麼時候發布的?
官方 X 於 2026 年 10 月 23 日公告,換算台北時間為 10 月 24 日凌晨。模型服務已上線,完整權重則預計於 2026 年 11 月 4 日前釋出;兩者是不同階段。
Kimi K3.1 Pro 可以免費使用嗎?
網頁版與 App 的實際可選模型、免費額度及地區限制,以登入後方案為準,首頁公告不能保證免費帳號能指定 K3.1 Pro。一般 API 採用量計費,官方要求至少儲值 1 美元才能開始使用;Kimi Code 則需要符合資格的會員方案。
Kimi K3.1 Pro 和 Kimi K3 差在哪裡?
K3.1 Pro 是 K3 的後訓練強化版,延續 2.8T 總參數、104B 活躍參數與 1M 上下文。官方 Kimi Code Bench 3.0 Long-horizon 從 55.95% 提升至 61.2%,Hallu Bench Hard 的單項事實幻覺率從 23.4% 降至 8.3%;標準 API 輸入與輸出單價則從每百萬 token 3/15 美元降為 2/10 美元。
跟 Claude Opus 5.5 或 GPT-6 Astra 比呢?
在 Kimi 官方公布的 Terminal-Bench 4.0 成績中,K3.1 Pro 為 65.7%、GPT-6 Astra 為 58.2%、Claude Opus 5.5 為 66.4%;BenchCAD 使用工具時則分別為 92.7%、95.9%、96.2%。這些分數只反映各評測與工具條件,無法證明某模型在所有工作上都較好。
權重開放後,一般電腦能用 Ollama 跑嗎?
正式權重與部署文件尚未公開,現階段不能保證 Ollama 支援。光是 2.8T 全部參數用 4-bit 儲存,粗估就約 1.4 TB,未含其他開銷;16GB 顯示卡無法一次容納完整權重,offload 或量化的速度與品質需另看實作。
API key 怎麼申請?計費方式是什麼?
到 Kimi API 平台建立 API key,依官方要求至少儲值 1 美元;一般 API 模型 ID 為 kimi-k3.1-pro,OpenAI SDK 的 base URL 為 https://api.moonshot.ai/v1。標準版每百萬 token 輸入 2 美元、輸出 10 美元、快取命中 0.2 美元;新寫入快取依 5 分鐘或 1 小時 TTL,按對應寫入費率計算,與命中及未快取 token 分開分類。
Highspeed 版本是什麼?誰該用?
kimi-k3.1-pro-highspeed 是官方提供的高速服務版本,官方稱能力相同、速度約為標準版的 2 至 3 倍。輸入與輸出單價分別為每百萬 token 4 美元與 20 美元,適合需要較短等待時間的應用;仍應用實際任務比較延遲與每次成功任務的成本。
Kimi Code 的會員金鑰可以直接拿來呼叫一般 API 嗎?
不能。依官方錯誤排解文件,Kimi Code 與 Kimi 開放平台為不同系統,金鑰與 base URL 不能互換。Kimi Code 使用 k3.1-pro 等模型 ID,一般 API 則使用 kimi-k3.1-pro;設定工具前要先選定使用哪個計費入口。
討論與提問