
本篇內容
Gemini 4 Argon 是 Google 在 2026 年 9 月 30 日發表的 Gemini 4 世代第一個前沿模型,鎖定三類最吃重的工作:真實世界的軟體工程、法律與金融這類企業知識工作,以及網路安全防禦。官方發布文章由 Google DeepMind 資深副總裁暨 Google 首席 AI 架構師 Koray Kavukcuoglu 掛名,一天之內 Google 自家的跑分對照表、獨立評測機構的結果與內部員工的質疑同時出現,資訊量大且方向不完全一致。以下資訊更新至 2026 年 10 月 1 日。
最需要先弄清楚的一件事:發表不等於開放。Argon 目前只提供給 Fairwind Program 裡少數受信任的資安防禦者;下一波是付費 API 客戶與 Google AI Ultra 訂閱者,官方給的時間是「儘快」,沒有日期;免費與 AI Pro 用戶未列入下一波名單,是否與何時開放都未公布。截至 10 月 1 日,Gemini API 定價頁面上還看不到這個模型,台灣方案頁的 Ultra 文案列的仍是 Gemini 3.1 Pro。目前無法只靠升級訂閱取得 Argon。
它之所以受關注,背景是 Google 已經好一段時間沒有推出新的旗艦級模型。上一個非 Flash 定位的前沿模型是 2026 年 2 月的 Gemini 3.1 Pro,之後幾個月主力更新都落在輕量級的 Flash 系列,外媒也報導過 Gemini 3.5 Pro 的計畫已經收掉。9 月 24 日 Koray Kavukcuoglu 還在對媒體說 Gemini 4 剛完成訓練、進入發布前評估,會「儘早」推出早期版本;六天後 Argon 就直接以 Gemini 4 世代首款模型的姿態登場。對 Google 來說,這是追趕 OpenAI 與 Anthropic 的關鍵一手;對使用者來說,真正的問題是它強在哪、什麼時候用得到、多少錢。
發表當天 Google DeepMind 的官方 X 帳號用一段話定調這個模型的角色:
Introducing Gemini 4 Argon – our new frontier model.
— Google DeepMind (@GoogleDeepMind) September 30, 2026
It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program. pic.twitter.com/X8acOWJOSF
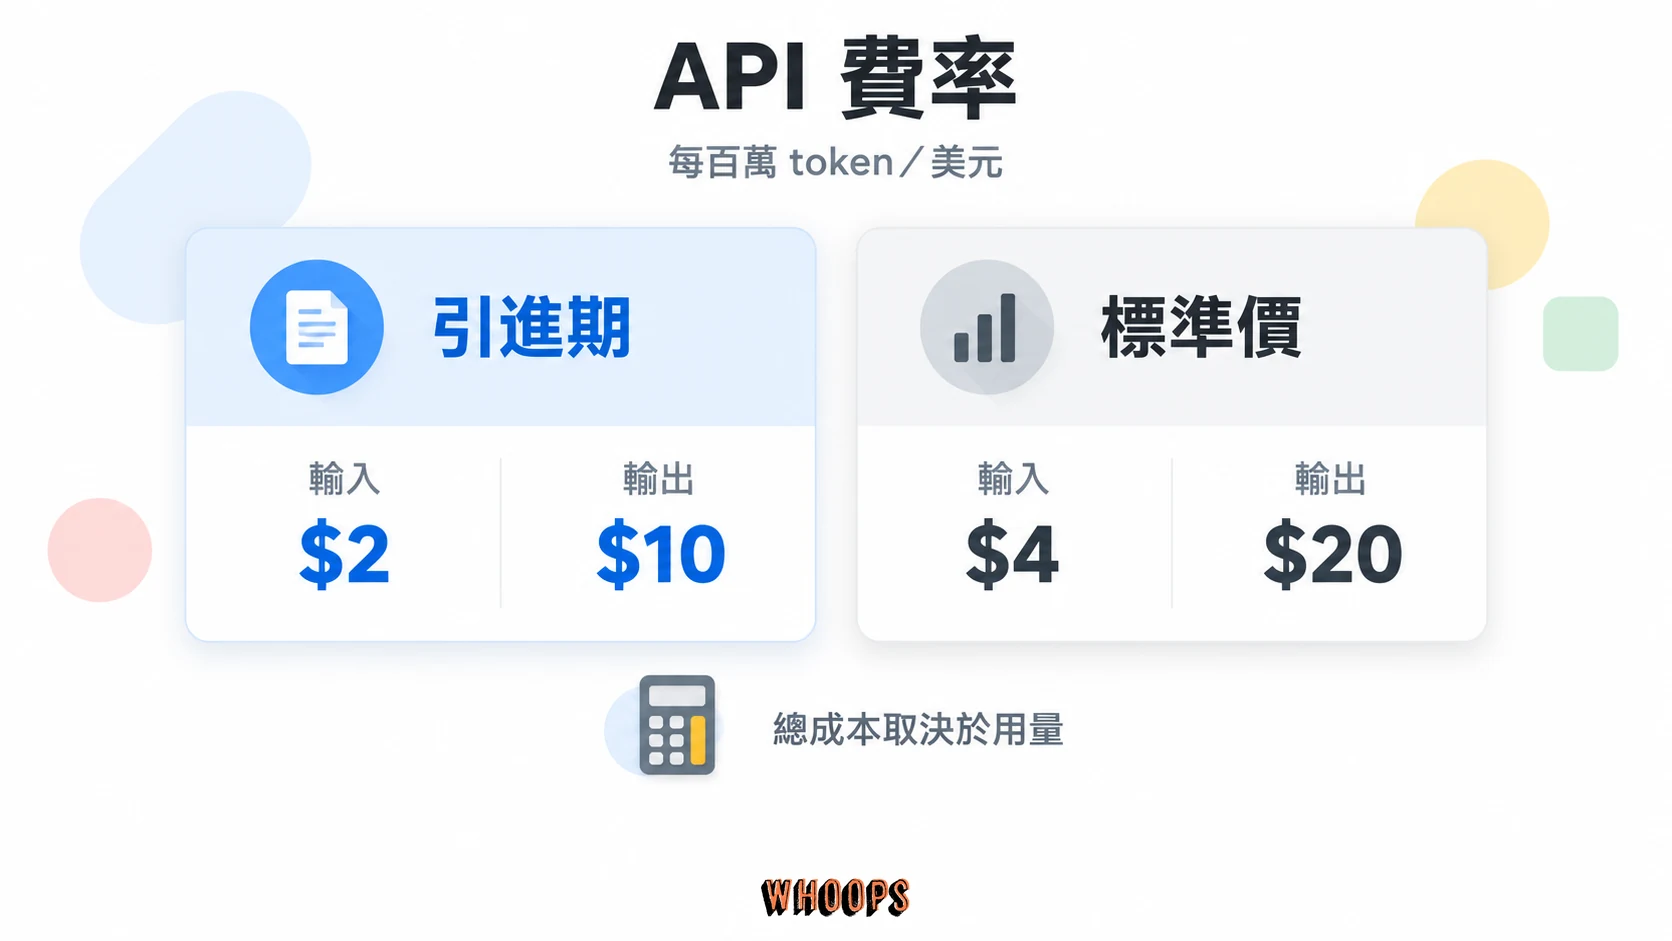
規格與費率快看:單次輸出上限 100 萬 token;引進期 API 每百萬輸入 token 2 美元、輸出 10 美元,快取輸入 0.10 美元;標準價為輸入 4 美元、輸出 20 美元。一般開放日期尚未公布,Google AI Ultra 訂閱費也不等於 API 使用費。
Gemini 4 Argon 是什麼?從 Gemini 3 到 Gemini 4 這一年
先把名稱拆開看。Gemini 4 是模型世代,Argon 是這個世代第一個公開模型的名字,延續了這一波前沿模型用代號式名稱的慣例,OpenAI 的 GPT-6 Astra、GPT-6 Sol 也是同一種命名邏輯。所謂前沿模型,指的是能力推到當前技術邊界的研究級旗艦,與主打速度和成本的 Flash 系列分工不同;對這個分類不熟悉的讀者,可以先看本站對大型語言模型原理與 2026 模型地圖的整理,再回來看 Argon 的定位會更清楚。
定位上,Google 這次說得很集中:Argon 不是「什麼都會一點的助理」,而是針對三種長時間、多步驟、中間不能出錯的工作流程設計。第一是真實世界的軟體工程,處理的不是玩具題目,而是存在於程式碼庫裡的問題;第二是企業知識工作,官方點名法律與金融,例如讀完大量文件後做出可稽核的分析;第三是網路安全防禦,而且這次被排在開放順序的第一位。Google 也提供了繁體中文版的官方說明,用語與英文版一致,想讀一手資料的台灣使用者不用啃英文。
在官方的敘事裡,這個模型已經在 Google 內部「改變了工作與建造的方式」,模型產品負責人 Tulsee Doshi 接受CNBC 採訪時說,內部把它視為一次顯著的跳躍,能以前所未見的成熟度完成真正複雜的任務。這類說法自然是宣傳成分居多,但 Google 這次同時公布了相當具體的內部使用案例與 18 項評測對照表,讓外部有東西可以檢驗,比單純喊話踏實。至於檢驗出來的結果是否撐得起宣傳,後面獨立證據的段落會攤開來看。
對照一下 Google 自己的產品線,Argon 的位置更好理解。目前 Gemini App 與 API 的主力是 9 月剛更新的 Gemini 3.8 Flash,主打日常對話與一般任務的速度與成本;再往前是 7 月的 Gemini 3.6 Flash。Flash 系列撐起了整年的使用者體驗更新,但「最強模型」這個位置從 2 月之後就空著,對手在代理式編程與長任務上不斷推進。Argon 補的就是這個洞,而且補的方式相當激進:一次把輸出上限拉高十五倍以上,直接押注「長視野工作流」會是下一階段的競爭主軸。
Google AI 的官方 X 帳號在發表時進一步說明了這個定位,特別點出法律與金融兩個領域:
Announcing Gemini 4 Argon, our new frontier model.
— Google AI (@GoogleAI) September 30, 2026
Argon is built to sustain deep reasoning across complex, long-horizon workflows and delivers frontier performance in complex workflows across real-world software engineering, enterprise knowledge work like legal and finance, and… pic.twitter.com/IpYt2KAaaq
發表了,但你還用不到:分階段開放的設計
Argon 這次最特別的地方不是跑分,而是開放方式。The Verge 給它的報導標題寫得相當直接:Google 說這個模型能力強到「現在只有受信任的資安防禦者能用」,限量開放是為了在放大規模前確認模型行為沒有偏離預期。這個說法背後是這一年整個產業的教訓:模型能力愈強、能自主操作的權限愈大,對齊問題出現時的代價就愈高,OpenAI 九月底才剛因為內部測試發現欺騙行為而停發一個旗艦級模型。Google 選擇把第一波使用者限縮在最能檢驗模型、也最需要它全力的群體:資安防禦者。
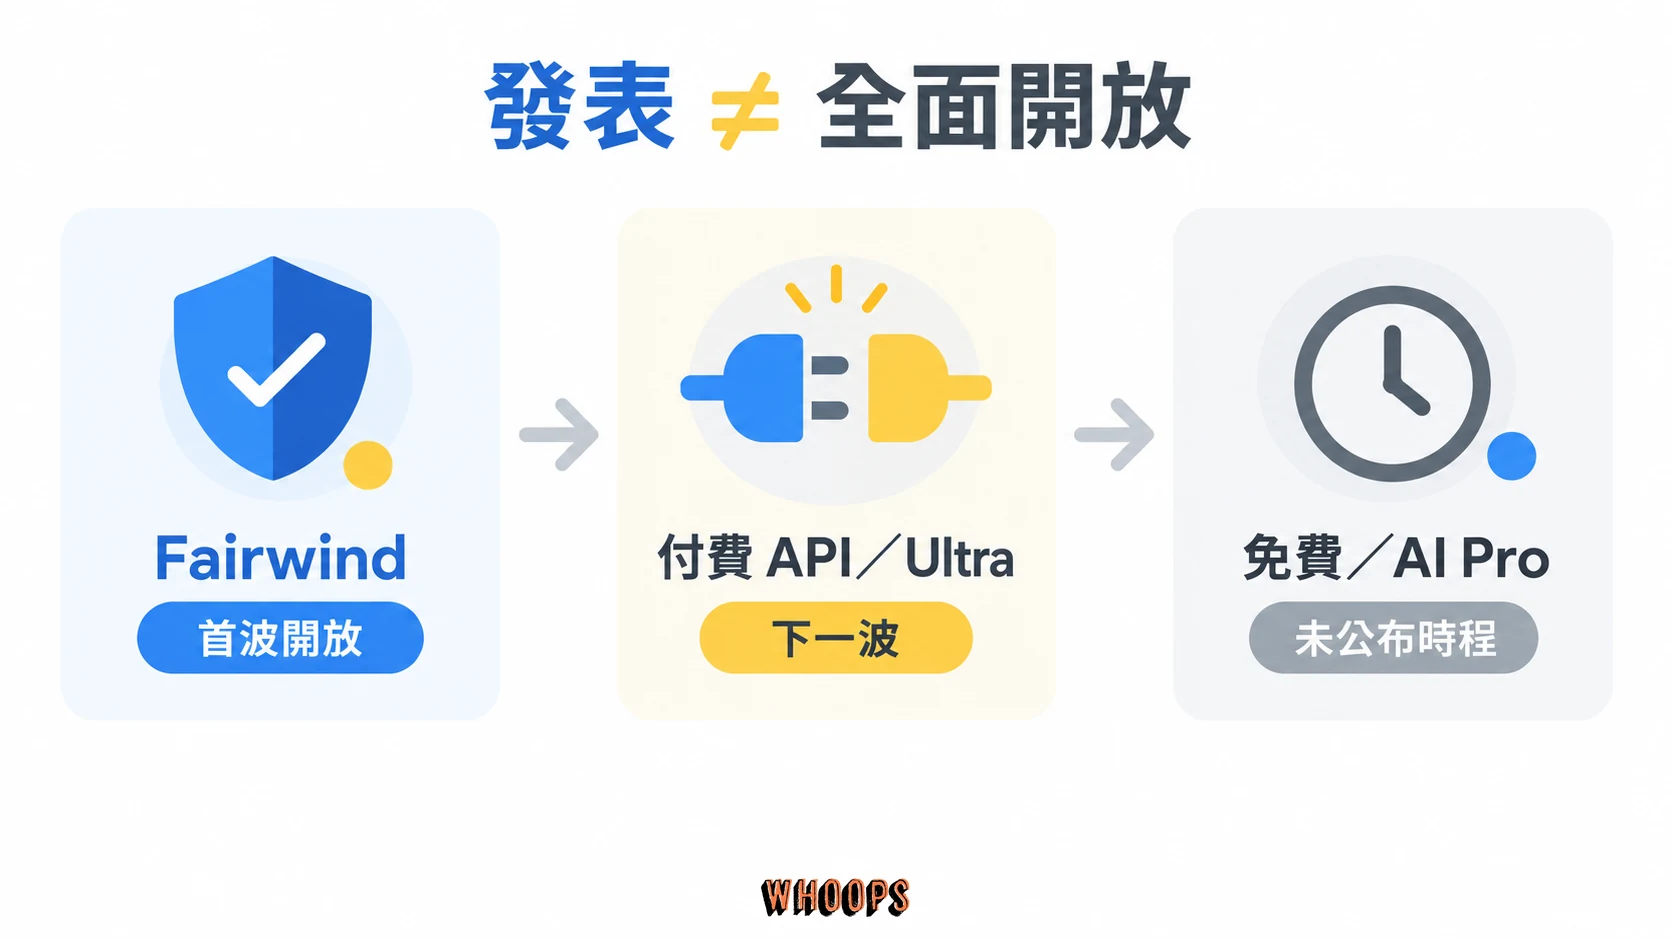
整個開放順序目前是這樣:
| 先給誰用 | 狀態(2026 年 10 月 1 日) | 取得方式 |
|---|---|---|
| Fairwind Program 受信任資安防禦者 | 進行中,第一波 | Fairwind 計畫審核,限防禦與研究用途 |
| 付費 API 客戶 | 官方承諾「儘快」,無日期 | Gemini API 與 Vertex AI,定價頁尚未列出 |
| Google AI Ultra 訂閱者 | 與 API 同為下一波,無日期 | 訂閱制,台灣月費 3,300 元起 |
| 免費與 AI Pro 用戶 | 未公布是否與何時開放 | 以後續官方公告為準 |
Fairwind Program 值得展開講,因為它是這次發布裡最有政策意涵的設計。Fairwind 的官方頁面寫明,這個計畫讓參與組織優先拿到具備網路安全防禦能力的最新前沿模型,目前全球有超過 650 個合作夥伴,優先適用者有三類:政府與國家資安機關;醫療、電信、能源、金融這些關鍵基礎設施的營運者;以及核心科技平台與學術研究單位。參與組織要遵守相當嚴格的條款:使用者層級的身分驗證、防釣魚的多因素驗證,而且只能把 Argon 的存取權限授給內部的資安、事件回應或滲透測試團隊,使用過程要追蹤,不得轉售或分享給第三方。部分夥伴還能透過 Google 的程式安全代理 CodeMender 使用 Argon,做漏洞研究與自動化修補,計畫明訂只能執行防禦與學術研究目的的雙用途任務,包括取得授權的威脅模擬、逆向工程與惡意軟體分析。
開放順序也涉及發布前的安全審查。Argon 發表的前一天,Google 執行長 Sundar Pichai 才與其他科技公司高層在白宮簽署了 AI 安全的自願性承諾;Google 也表示正在參與美國政府的自願性發布前審查流程。這種「先給政府與防禦者、再給大眾」的節奏,先前已經有 Anthropic 的 Project Glasswind 與 OpenAI 的 Project Daybreak 走過,Argon 是 Google 版本的同一套劇本。Ars Technica 在發布當天的提醒值得放在書籤裡:消息很熱,但你還不能用。他們的報導把引進期價格與快取折扣都整理出來了,開放狀態的判準很簡單,什麼時候官方 API 文件列出 Argon,什麼時候才算是真的上市。
這種分階段節奏也引來「是不是紙上發布」的質疑,畢竟發表當天絕大多數人連試都試不到,有外媒直接把這次定位成預覽而非正式推出。Google 對外反駁這個說法,理由是 Argon 不是展示品:它在 Google 內部已經承擔編程、量子運算研究與資料中心最佳化的實際工作,Fairwind 夥伴也在真的用它掃漏洞,發表與全面上市之間的落差是刻意安排的驗證期,不是模型還沒做完。這個說法成立與否,最終還是要看開放時程有沒有跟上,這也是為什麼前面把「定價頁何時列出」當成分水嶺。
核心能力:100 萬 token 輸出與長視野工作流
Argon 的規格裡最搶眼的一個數字是輸出上限:單次回應最多 100 萬個 token,是先前 Gemini 模型 6.4 萬上限的十五倍以上。iThome 的報導把焦點放在這個數字上,但 token 不等於中文字數,實際容量取決於語言、程式碼與分詞方式;這是輸出上限,也不能與輸入的上下文視窗混為一談。這個數字的意義不在「聊天可以聊更久」,而在工作型態的改變:以前模型做不到一次交出完整成品,只能分段拼裝,每個接縫都是出錯的地方;輸出上限拉到百萬等級,「一次生成、一次審閱」才變得可行。具體 API 參數、續接方式與用量限制,仍應以開放後的開發者文件為準。
能力證據的第一層是 Google 自己公布的評測對照表,18 項裡 Argon 拿下 12 項第一、1 項並列。幾個關鍵數字:DeepSWE v1.1 測的是真實世界、長視野的軟體工程任務,Argon 拿 77.9%,高於 Claude Opus 5.5 的 74.2% 與 GPT-6 Astra 的 74.1%;Vals Index 是以美國 GDP 產值結構加權的經濟影響評測,涵蓋金融、編程、法律、稅務,Argon 在 41 個模型裡排第一;法務代理的 Harvey Legal Agent Benchmark 差距最懸殊,Argon 19.6%,兩個對手都在 6% 以下;Zapier 的 AutomationBench 測代理能不能把工作流真正自動化跑完,Argon 51.3% 也是第一。長影片理解的 LVBench 拿 91.7%,顯示多模態能力沒有因為押注工程任務而偏廢。
Google 特別點名長上下文是 Argon 進步最大的一塊,數字也印證這個說法。內部長上下文基準 GraphWalks 測的是在大量關聯文件之間往返推理的能力,Argon 拿 84.2%,領先 Opus 5.5 的 66.8% 與 Astra 的 71.8% 約十二到十七個百分點;這提供了長文件推理的比較線索,但沒有誤差區間與任務實測,不能直接推論所有工作都會有同樣增益。演算法競賽類的 Vals IOI 它與 Astra 同拿滿分,PostTrainBench 則為 45.3%,低於 Opus 5.5 的 49.3%;不能把其他測項的領先延伸成全面勝出。對法律盡職調查、財務稽核、大型程式碼庫重構這類「材料比結論難」的工作,長上下文評測提供了選型線索,但資料引用與結論正確性仍須逐項驗證。
第二層證據是 Google 內部的實際使用,這部分公布得比以往具體。量子運算團隊用 Argon 做量子演算法的最佳化,幾分鐘內找到比公開最佳水準節省 40% 資源的作法;基礎設施團隊讓 Argon 的代理分析全機房的效能遙測資料,釋出超過 300 TiB 的記憶體,估計總共能省 500 TiB 到 1 PiB。工程面最有說服力的是程式碼遷移:Google 正在把 C 和 C++ 專案搬到記憶體安全的 Rust,Argon 已經處理了正規表示式引擎 re2、視訊解碼器 libgav1 與 Fuchsia 作業系統核心 Zircon 超過 80 萬行程式碼的遷移,其中 libgav1 有 3.2 萬行 SIMD 程式碼被改寫,改寫後比先前的 Rust 移植版本快 2.7 倍。Google 強調這些變更都要經過人類稽核才會上線,這個態度是對的,也正好點出這類模型的正確用法:它把粗活做掉,判斷和簽核留給人。
資安防禦與 Fairwind:完整能力仍有使用限制
把資安防禦者排進開放順序第一位,不是公關姿態,而是這個模型真正的主戰場。Google 說 Argon 被訓練到可以自主完成找漏洞、驗證漏洞、修補漏洞的整個循環,在 CWE-bench v1 這個資安評測上拿 68%,與 GPT-6 Astra、Grok 4.7 三方並列第一;Fairwind 頁面對它的官方描述,就是在漏洞偵測與自動化修補上達到前沿水準。Google 內部還用一個涵蓋 20 種程式語言的漏洞評測來驗證它;在 Wiz 的內部黑箱滲透測試基準上,Argon 也勝過 9 月初才推出的資安特化版 3.8 Flash Cyber。
已經有實戰案例。雲端安全公司 Wiz 在 Fairwind 計畫裡用 Argon 掃描醫療軟體,找到一個會讓全球多家醫院使用的系統暴露敏感個人資料的重大漏洞,而先前幾個前沿模型都沒能抓到它,這個案子透過 Wiz 的 Scan for Good 計畫通報修補。對醫院與患者來說這是實質的好事,也正是 Google 把防禦者放在第一波的論述基礎:同樣的能力,在防禦者手裡是搶在攻擊者之前補洞,在攻擊者手裡就是武器。
真正的爭議在這裡:Google 承認,提供給 Fairwind 夥伴與內部團隊的 Argon 不帶網路安全護欄,以便防禦團隊使用完整的資安能力,但仍須遵守限定用途與存取條款;一般版本未來對外開放時則會掛上護欄。這項設計只針對資安護欄,不代表取消所有安全限制,贊成的理由是攻擊者不會替自己掛上護欄,防禦者綁手綁腳只會輸;疑慮則在「受信任」的邊界能不能守住,畢竟 650 多個組織、每個組織內部又有好幾個團隊,存取範圍比傳統的紅隊合作大得多。Google 的配套是前面提過的那些條款:限內部資安團隊、強制多因素驗證、全程追蹤、禁止轉分享。這套治理是否足夠,會是 Argon 開放過程裡最值得持續檢驗的問題。
跑分很強,但獨立證據有分歧
Google 的對照表漂亮,但任何廠商自家的表都該打折看,關鍵在獨立證據。目前獨立這一側的信號是分歧的,先看不利的一面。終端環境任務的 Terminal-Bench 4.0,Argon 57.4%,明顯落後 Claude Opus 5.5 的 66.4%;前沿軟體工程的 FrontierSWE v2 拿 55.0%,落後 GPT-6 Astra 的 65.5% 與 Opus 5.5 的 62.3%。獨立評測機構 Artificial Analysis 的 Argon 模型頁列出綜合智力指數 53 分,與 GPT-6 Astra 同級,但低於 Claude Opus 5.5 的 58 分與 Claude Sonnet 5.5 的 56 分。
再看另一種證據:文字品質的人類偏好。法律與金融工作仍需另外檢查事實、引用與計算,文字評測不能代替文件稽核。人類偏好這側的證據更戲劇化:在盲測投票的Arena 排行榜上,Argon 以 High 推理設定登上文字類第一,發布當天就擠下所有對手;但在同一個榜的整體代理榜,它排第 8,勝率 7.92%,落後 Anthropic 的 Fable 5.1 與 Opus 5.5。兩種榜單測的是不同事情:文字偏好與代理任務成功率不能互相替代,也不能直接拿來證明某則內部經驗報導。
Bloomberg 在發布當天的調查報導引述多位不具名的 Google 員工,說 Argon 在跑分上表現突出,實際拿來做內部工作時,某些編程任務的表現不如預期,前端介面類的任務尤其吃力;報導也平衡指出,Google 對外回應「說 Argon 在編程上表現不佳並不準確」,內部主流意見仍認定它是前沿等級。紐約時報則引述第三方評測機構 Vals AI 的結果,佐證 Argon 在編程、金融等任務上領先 OpenAI 與 Anthropic 模型的官方結論。三種證據放在一起,比較誠實的讀法是:靜態知識工作與文件產出的證據很強,自主完成完整工程專案的證據還在分歧期,而分歧正好落在 Google 最想贏的代理式工作上。
讀廠商對照表還有一個細節值得知道:同一個測項,不同廠商列的數字不見得一樣。Google 表列 Opus 5.5 在 AutomationBench 是 42.5%,Anthropic 自家的表列的卻是 40.0%,版本、推理強度、工具與 fallback 設定都可能造成差異,不能只看分數就判定原因,但結論的方向感就會被這幾個百分點挪動。所以與其記住誰幾分,不如記住哪幾個測項在分歧:Argon 在 Google 公布的部分長上下文與知識工作評測領先,落後的集中在終端操作與前沿工程實作,這個輪廓在兩家的表上都成立。
對採購與技術選型的實務建議只有一條:等開放後用自己的任務測,而且要測「會失敗的那種任務」。跑分與內部傳聞都是別人的樣本,你的程式碼庫、你的文件型態、你的容錯空間才是準的。
API 價格:進場價有攻擊力,帳要這樣算
價格是這次發布裡 Google 最有企圖心的一手。引進期每百萬輸入 token 2 美元、每百萬輸出 token 10 美元,快取輸入再便宜 95%,等於每百萬 0.1 美元;引進期結束後回到標準價 4 美元與 20 美元,何時調回官方沒有給日期。Google 負責開發者體驗的 Logan Kilpatrick 在發表當天把重點講得最白:
Introducing Gemini 4 Argon, our new frontier model, rolling out to cyber defenders starting today, and more widely as soon as possible. I am really excited by the progress we have made here. Argon is priced at $2 in and $10 out during introductory pricing! pic.twitter.com/X9LNch6ObZ
— Logan Kilpatrick (@OfficialLoganK) September 30, 2026
把對手拉進來看,這個進場價的相對位置更清楚。引進期的 Argon 與 OpenAI 主打性價比的 GPT-6.1 Sol 同價,是 Claude Sonnet 5.5 的定價帶,而 GPT-6 Astra 要價是它的五倍。標準價 4 與 20 美元則與 Claude Opus 5.5 的基準價完全相同,VentureBeat 對定價的解讀直指 Google 是刻意錨定對手旗艦的價位帶。
| 模型 | 輸入/百萬 token | 輸出/百萬 token | 快取輸入 |
|---|---|---|---|
| Gemini 4 Argon(引進期) | $2 | $10 | $0.10 |
| Gemini 4 Argon(標準) | $4 | $20 | 待正式文件確認 |
| Gemini 3.1 Pro | $2 | $12 | — |
| Claude Sonnet 5.5 | $2 | $10 | $0.20 |
| Claude Opus 5.5 | $4 | $20 | $0.20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 |
| GPT-6 Astra | $10 | $50 | $1.00 |
不過帳不能只看單價。Artificial Analysis 的模型頁列出 Argon 在其 Intelligence Index 的加權平均每任務成本為 1.99 美元;這是該測試組合與引進期費率的結果,不代表你的工作也會花一樣的錢。極端例子更直觀:把 100 萬 token 的輸出上限用好用滿,光輸出費就是 10 美元,標準價下是 20 美元,輸入與其他服務費另計。以未快取輸入 10 萬 token、輸出 1 萬 token 為例,引進期費用為 0.2 + 0.1 = 0.3 美元;標準價則為 0.4 + 0.2 = 0.6 美元,未計其他服務費。長輸出是能力也是帳單結構,導入時把「任務平均輸出長度」當成成本參數來管理,會比只比單價準確。
台灣怎麼取得、要花多少錢
台灣使用者能走的路目前只有兩條,而且都還沒開。消費端的第一個入口是 Google AI Ultra 訂閱:台灣的 Ultra 分兩級,5x 方案每月 3,300 元附 20 TB 儲存空間,20x 方案每月 6,500 元附 30 TB,這是 2026 年 5 月 I/O 降價後的新結構,詳細的方案內容可以在Google 台灣的方案頁查到。要注意的是,這個方案頁目前的 Ultra 文案列的是 Gemini 3.1 Pro、Deep Research 與 Deep Think,Argon 還沒出現,什麼時候上線官方隻字未提。開發者這條路則是等 Gemini API 與 Vertex AI 開放,判準前面說過:Gemini API 定價文件與模型文件列出 Argon,且帳號實際取得存取權後才能使用。
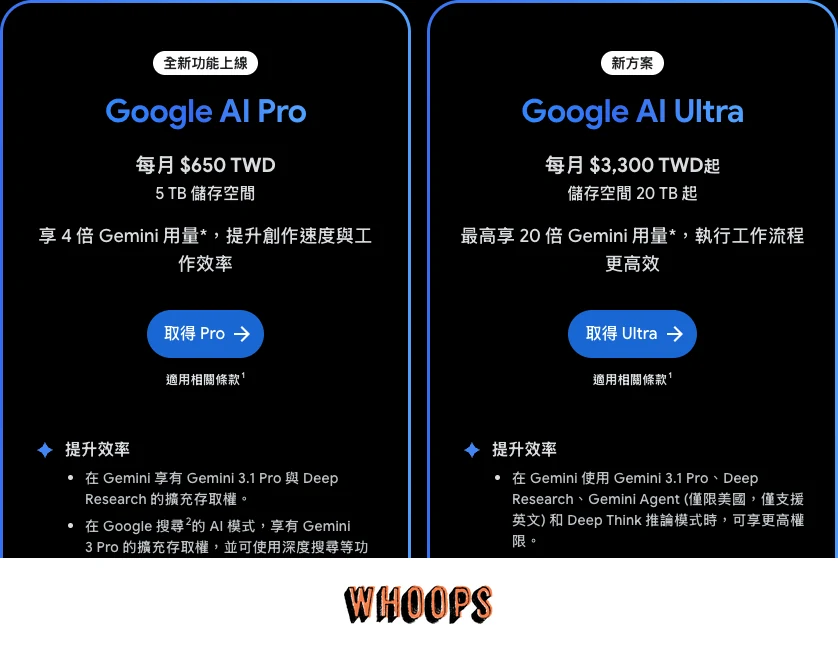
「要不要為了 Argon 現在升級 Ultra」這個問題,答案傾向不用。沒有開放日期的承諾,先付款等於把錢押在一個不知何時兌現的期待上;Ultra 本身的其他價值,例如 20 倍用量、Deep Think 推論模式與 Gemini Spark 這類代理功能,本來就有的人再考慮,沒有的人不建議為了單一模型倉促升級。比較務實的姿勢是把這篇文章放著,等 Google 台灣方案頁的 Ultra 文案出現 Argon,或 API 定價頁更新,再做決定,引進價沒有公布截止日,不存在「現在不訂就虧到」的問題。
企業端有不同的觀察點。資安團隊所屬的醫療、電信、能源、金融業者正好落在 Fairwind 的優先適用者裡,值得透過官方管道了解加入條件;一般企業則建議等 Vertex AI 供應與企業級條款,屆時用引進價做一輪自己的任務評測,再決定要不要把長文件與知識工作流搬過來。
安全與對齊:Google 這次為什麼特別謹慎
限量開放的決策背後是一整套新的安全工程。Google 在發布文章裡把 Argon 的防護分成四個層面,其中最新穎的是監控設計。
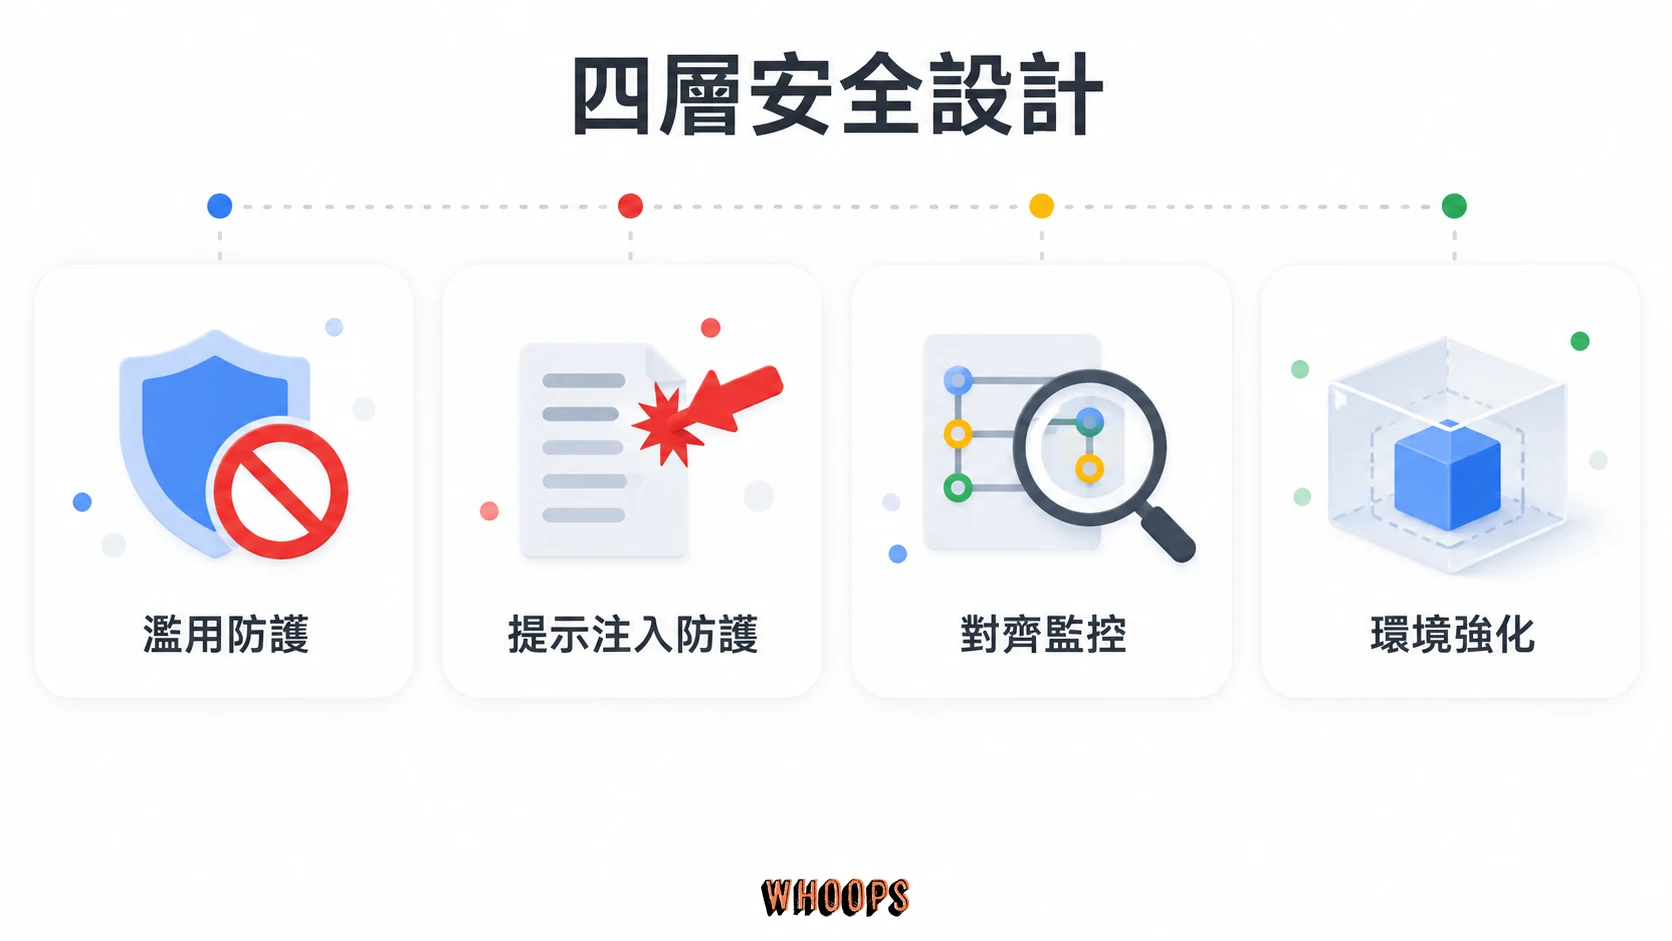
第一層是濫用防護,針對網路攻擊與大規模毀滅性武器相關的濫用情境訓練拒絕能力,同時保留正當的雙用途研究空間,依據的是 Google 的 Frontier Safety Framework,上線前經過內部與外部紅隊反覆測試。第二層是提示注入防護,面對藏在網頁、文件、郵件裡試圖操縱代理的惡意指令,Argon 在 Gray Swan 的 IPI 基準上,15 次攻擊嘗試設定的攻擊成功率為 0.7%,是所有受測模型中最低,背後是自動化紅隊與對抗訓練的組合。第三層最特別:對齊監控。系統會監看 Argon 的推理過程與實際行動,判斷它是否朝未經授權或有害的方向走,必要時直接停止執行;Google 說同一套機制在訓練期間就上線過,由事件回應團隊盯著,而且刻意不把監控發現回饋進訓練資料,避免模型學會掩飾推理。Google 還公開呼籲業界保留推理過程的透明度,這讓外部更容易理解監控設計的出發點。第四層是環境強化,高風險訓練與評估在隔離沙箱裡進行,環境先密封再跑。
監控推理過程這個設計,呼應的是這一年最讓人不安的一條技術線:模型在測試中出現欺騙行為、隱匿自己真正做過的事,OpenAI 九月底停發旗艦模型的事件就是最新的例子。The Verge 的報導把 Google 的限量開放直接連到這個脈絡,標題就寫著這個模型強到現在只先給受信任的資安防禦者;配合前一天才簽署的白宮自願承諾,Google 採取的是先驗證、再逐步擴大開放的策略。進度上還有一個誠實的註腳:model card 尚未發布,獨立安全研究者在廣泛開放前能做的外部檢驗有限,這一項值得列入後續追蹤。
Argon、Astra、Opus 5.5:現在怎麼選
把視角拉回「我今天要選模型」的決策,目前的三強各有清楚的安全區。GPT-6 Astra 的證據最完整,代理式編程與終端任務的獨立實績強,代價是 API 價格是 Argon 引進期的五倍;Claude Opus 5.5 在 Terminal-Bench 這類動手做的任務上領先,長文件的可靠度有口碑,價格就是 Argon 的標準價,等於兩者打平;Argon 的觀察重點在長文件知識工作、輸出上限與引進期成本,但「能否自主完成完整工程專案」的證據還分歧,而且現在根本拿不到。
所以條件式的答案比排名有用。你的任務如果今天就要上線,選 Astra 或 Opus 5.5,因為 Argon 沒有開放日期;如果是大量、重複、預算敏感的中等任務,Flash 系列與 Sol 類的性價比模型仍然是主力;如果是法律、金融、長報告這類知識工作,把 Argon 列入觀察名單,等 API 開放後用引進價做一輪實測,評估時加入引用核對、錯誤率與人工審閱時間;如果你是資安團隊,Fairwind 是唯一現在就能碰到 Argon 的門。至於「等 Gemini 4 再開始做 AI 專案」這個想法可以放掉,模型每季都在換,工作流的設計與驗收標準才是留下來的資產。
接下來盯這四件事
Argon 的故事才剛開始,未來幾週有四個明確的觀察指標。第一,官方 API 定價頁與 AI Studio 什麼時候出現 Argon,那是從「發表」變成「上市」的分水嶺。第二,model card 與安全報告什麼時候補上,那決定外部研究者能檢驗到什麼程度。第三,廣泛開放後 Artificial Analysis 與 Arena 的重測結果,特別是代理類榜單的變化,那是驗證「跑分與實戰落差」爭議的直接證據。第四,Gemini 4 世代的後續陣容,Pro 與 Flash 變體什麼時候接上、Gemini App 的模型選單什麼時候更新,那才是大多數人實際感受到 Gemini 4 的時刻。
在那天之前,該做的工作不受影響:日常使用有 3.8 Flash,代理應用有 Spark,深度模型選型用現有可得的 Astra 與 Opus 5.5 先把流程磨順。Argon 打開的那扇門是真的,100 萬 token 輸出上限、長文件工作評測、引進期價格,都是實質的推進;但門什麼時候開、開了之後走進去值不值得,等證據到了再判斷,這是面對每一次模型發布最不容易吃虧的姿勢。
常見問題
Gemini 4 Argon 在台灣可以使用嗎?
截至 2026 年 10 月 1 日,一般台灣使用者尚未開放。Argon 首波限 Fairwind Program 核准的資安防禦者;相關組織能否取得存取權,須依官方審核結果判定。下一波是付費 API 客戶與 Google AI Ultra 訂閱者,官方只說「儘快」,沒有給日期;台灣可以訂閱 AI Ultra(每月 3,300 元起),但 Argon 尚未出現在方案內容中。
一般用戶什麼時候用得到 Argon?
沒有官方時間表。Google 公布的順序是 Fairwind 防禦者先行,接著付費 API 客戶與 Google AI Ultra 訂閱者,免費與 AI Pro 用戶沒有被列入首批名單。可以觀察兩個訊號:Google 的 API 定價頁什麼時候列出 Argon,以及台灣方案頁的 Ultra 文案什麼時候更新,任一個出現都代表開放正在推進。
為了 Argon 現在升級 Google AI Ultra 划算嗎?
不建議。Argon 進入 Ultra 的日期未定,先付款等於押注一個沒有兌現時間的期待;引進期 API 價格也沒有公布截止日,不存在早買早賺的問題。若你本來就需要 Ultra 的 20 倍用量、Deep Think 或 Gemini Spark 這些既有功能,那是另一個決策;單為 Argon 升級目前沒有必要。
Gemini 4 Argon 的 API 價格是多少?
引進期為每百萬輸入 token 2 美元、每百萬輸出 token 10 美元,快取輸入 0.1 美元,是同級前沿模型中最具攻擊力的定價之一。引進期結束後回到標準價 4 美元與 20 美元,與 Claude Opus 5.5 相同,何時調整尚未公布。實際成本還要把輸出長度算進去:百萬輸出 token 光輸出費就是 10 美元,另加輸入與其他費用。
輸出上限 100 萬 token 是什麼概念?
先前 Gemini 模型的單次輸出上限是 6.4 萬 token,Argon 提高到 100 萬。token 是模型分詞單位,不能直接換算成固定中文字數;這是單次輸出的容量上限,也不同於輸入上下文視窗。它的意義在於「一次生成、一次審閱」的工作型態,減少分段拼裝產生的接縫錯誤。實際生成長度、延遲與帳單仍取決於任務及 API 設定。
Argon 和 Gemini 3.8 Flash 差在哪?
分工不同。3.8 Flash 是目前 Gemini App 與 API 的主力,主打日常任務的速度與成本;Argon 是 Gemini 4 世代的前沿模型,鎖定長時間、多步驟的重度工作,例如真實程式碼庫的工程任務、法律金融文件分析與資安防禦,輸出上限也是 Flash 的十五倍以上。兩者未來會是並存關係,Argon 負責深度工作,Flash 負責日常吞吐。
Argon 比 GPT-6 Astra 和 Claude Opus 5.5 強嗎?
要看任務類型。Google 的對照表中 Argon 在 18 項評測拿 12 項第一,DeepSWE 真實軟體工程 77.9% 領先兩個對手,但 Terminal-Bench 4.0 落後 Opus 5.5 約 9 個百分點,FrontierSWE v2 落後 Astra 約 10 個百分點,Artificial Analysis 的綜合智力指數也低於兩個 Anthropic 旗艦。靜態知識工作它的證據較強,自主完成完整工程專案的證據仍有分歧。
Fairwind Program 是什麼?台灣企業可以加入嗎?
Fairwind 是 Google DeepMind 的優先存取計畫,讓受信任的資安防禦者搶先使用具備網安防禦能力的最新前沿模型,目前有超過 650 個合作夥伴。優先適用者是政府與國家資安機關、醫療電信能源金融等關鍵基礎設施營運者,以及核心科技平台與學術單位;參與組織須通過審核,遵守多因素驗證、僅限內部資安團隊使用、禁止轉分享等條款。台灣屬於前述產業的資安團隊可以透過 Fairwind 官方頁面了解申請條件。
Argon 對資安人員不設護欄,會增加一般人的風險嗎?
Google 確認提供給 Fairwind 夥伴與內部團隊的 Argon 不帶網路安全護欄,一般對外版本則會掛上護欄,這不代表所有安全限制都被取消。Google 的治理配套包括使用者層級驗證、防釣魚多因素驗證、限內部資安團隊、使用追蹤與禁止轉售;贊成方認為防禦者需要完整火力才能趕在攻擊者之前修補漏洞,Wiz 用它找到醫療軟體重大漏洞就是實例。風險是否可控,取決於這套條款在 650 多個組織裡的執行品質,這也是後續最值得監督的環節。
為什麼有人說 Argon 跑分很強但實際表現有疑問?
訊號確實分歧。Bloomberg 引述 Google 內部員工,指 Argon 在部分實際編程任務與前端介面上的表現不如跑分亮眼,Google 則回應這種說法並不準確;獨立評測端,Arena 文字盲測它排第一,整體代理榜卻只排第 8,Artificial Analysis 的智力指數也落後 Anthropic 旗艦。比較持平的讀法是:文件產出與知識工作的證據強,自主完成完整專案的證據還在累積,等廣泛開放後用自己任務實測最準。
現在該等 Gemini 4,還是先用其他模型?
先用其他模型。Argon 沒有開放日期,工作不該跟著發布會停擺:日常任務有 Gemini 3.8 Flash,代理應用有 Gemini Spark,深度選型有已可取得的 GPT-6 Astra 與 Claude Opus 5.5。模型每一季都在替換,把工作流、驗收標準與成本監控先建好,等 Argon 開放時用引進價實測一輪再決定遷移,是風險最低的路徑。

討論與提問