Gemini Omni 1.2 Flash 是 Google 於 2026 年 11 月 5 日正式推出的商用 AI 影片生成與編輯模型,模型識別碼為 gemini-omni-1.2-flash。 這個模型可以原生生成 3 至 15 秒帶音訊的影片、用多輪對話修改已生成畫面,並以最多 6 張參考圖鎖定角色與商品的一致性。720p 生成的標準價為每秒 0.07 美元,依影片輸出 Token 單價計算,比上一代 Gemini Omni 1.1 Flash 降低約 31.4%。開發者透過 Google AI Studio、Gemini API 與 Google Cloud 付費呼叫;不寫程式的使用者可以從 Google Vids 免費生成每月三支 15 秒影片。2026 年 12 月 3 日起,發往舊版 1.1 的 API 請求會自動轉移到 1.2。
規格與費率核對日期:2026 年 11 月 8 日。以下以 Gemini API 為主,Google Cloud 與第三方託管的差異另行標示;帳號權益以各產品實際開放為準。
Gemini Omni 1.2 Flash 已於 2026 年 11 月 5 日全面開放:原生 3 至 15 秒帶音訊影片、多輪對話式局部編輯、最多 6 張參考圖鎖定角色與商品一致性,輸出固定 24 fps,支援 16:9 與 9:16。
720p 生成標準價為每秒 0.07 美元(精確值為每秒 0.069504 美元),比 1.1 版調降 31.4%;Gemini API 沒有免費層級,Google Vids 提供每月最多三支 15 秒影片的免費額度。
2026 年 12 月 3 日起,發往
gemini-omni-1.1-flash的請求自動轉移到 1.2,程式碼不用改、新費率直接生效,但模型行為可能跟著改變,遷移前應先用代表任務測試。
Google AI 在官方 X 上以一段示範影片同步宣布這次改版:15 秒的生成與編輯上限、更穩的場景連貫性,以及升級的角色語音表現,都隨這一代一起到位。
Meet Gemini Omni 1.2 Flash ⚡️
— Google AI (@GoogleAI) November 5, 2026
We’ve made the model more cost-effective, bumped the video generation and editing limit up to 15 seconds, and made updates to how scenes hold together over time. We've also given character speech an upgrade, reduced visual glitches like jump cuts,… pic.twitter.com/jjhjFmIs5p
Gemini Omni 1.2 Flash 是什麼?模型定位、版本家族與規格總覽
Gemini Omni 1.2 Flash 是 Google DeepMind 模型家族中專為高頻率商業視覺內容打造的低延遲、高一致性影片生成與多輪編輯模型。 Google 在2026 年 11 月 5 日的官方發布公告中,把更新重點放在 15 秒影片、更低成本、參考素材遵循度與場景連貫性。Gemini Omni 1.2 Flash 與主要輸出文字的 Gemini Flash 文字模型用途不同:Omni 這條產品線處理影片生成與編輯,Flash 文字模型處理文字與程式任務,兩個模型家族不互相取代。
這條產品線目前有三個需要分清楚的名稱。gemini-omni-1.2-flash 是現行穩定版;gemini-omni-1.1-flash 仍屬穩定版,但 2026 年 12 月 3 日起自動路由到 1.2;更早的 gemini-omni-flash-preview 已經關閉。Google AI Studio 的模型版本頁還標示一個容易忽略的差異:1.1 的輸出只有影片、不包含原生音訊,帶音訊輸出與 15 秒上限都是 1.2 才補齊的能力。搜尋結果裡還留有 Cloud 通道的 omni-flash-preview 舊頁,讀者查資料時應以模型識別碼對準版本,避免把 preview 時期的規格當成現況。
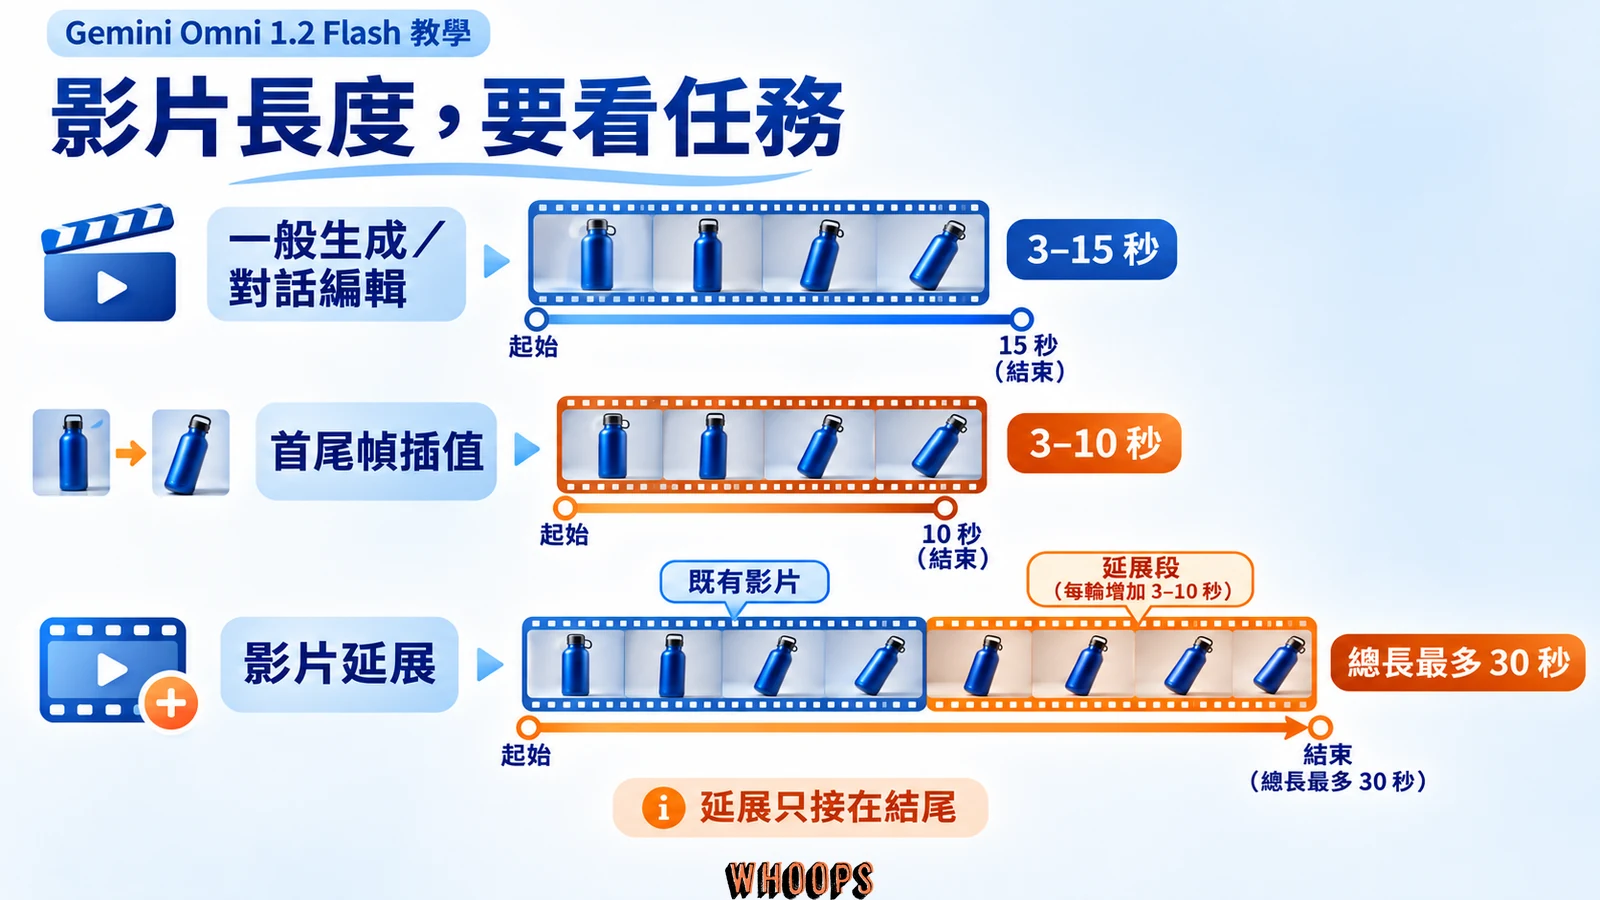
從文字、圖片或影片輸入開始,透過 Interactions API 生成與修改,再選擇輸出解析度,是這個模型的基本使用循環。一般生成、首尾幀插值與影片延展各有不同的時長上限,不能共用同一個 15 秒數字。Gemini Omni 1.2 Flash 的五項主要能力如下。
- 原生 15 秒影片生成與逐秒控制:Gemini Omni 1.2 Flash 支援原生生成 3 秒至 15 秒的完整影片,把上一代 Gemini Omni 1.1 Flash 的 10 秒上限提升 50%。開發者可用 API 以整數秒設定 3 至 15 秒片段,直接產出完整的社群短影音廣告或產品解說素材。
- 多輪對話式狀態編輯(Stateful Video Editing):使用者透過自然語言對話直接修改已生成的 15 秒影片,下達「將背景改為下雨的夜晚並保留其他所有元素」這類指令,模型會依前一輪內容修改商品、場景、光影或構圖,並盡量保留未要求修改的部分;定稿前仍應逐格檢查。
- 6 張參考圖與跨鏡頭主體一致性(Subject Reference):單次請求最多輸入 6 張參考圖片(最多 2 個角色、每個角色最多 3 張角度圖),並可搭配最長 3 秒的動態參考短片。Google 表示這一代強化了主體與場景的一致性;這是官方能力說明,細小包裝文字、五官與跨鏡頭細節仍應用實際素材檢查。
- 自然語音生成與嘴型同步(Lip-Sync):Gemini Omni 1.2 Flash 內建原生音訊生成能力,同步輸出環境音效、背景音樂與角色對話,並改善人物說話時的嘴型同步精準度、語氣自然度與多說話者(multi-speaker)的聲音分配。
- 電影級連續運鏡控制(Cinematic Camera Control):Google 表示這一代減少了無故跳剪(jump cuts)與比例漂移。創作者可用提示詞指揮 FPV 穿越機長鏡頭、戲劇性拉遠與環繞運鏡等連續運鏡。
| 規格項目 | Gemini Omni 1.2 Flash (gemini-omni-1.2-flash) | Gemini Omni 1.1 Flash (gemini-omni-1.1-flash) | 升級幅度與差異說明 |
|---|---|---|---|
| API 模型 ID | gemini-omni-1.2-flash | gemini-omni-1.1-flash | 2026 年 12 月 3 日起 1.1 請求自動轉移至 1.2 |
| 原生生成秒數 | 3 至 15 秒(可逐秒設定,預設 10 秒) | 3 至 10 秒 | 單段影片最長時長增加 50% |
| 首尾幀插值秒數 | 3 至 10 秒 | 3 至 10 秒 | 維持最高 10 秒過渡動畫限制 |
| 輸出解析度 | 原生 360p / 720p;放大 1080p / 4K | 原生 360p / 720p;放大 1080p / 4K | 預設輸出為 720p @ 24 fps |
| 支援畫面比例 | 16:9(橫式預設)、9:16(直式) | 16:9、9:16 | 支援多輪對話中直接切換畫面比例 |
| 圖片參考數量 | 最多 6 張參考圖(最多 2 角色 × 3 張) | 基礎參考圖支援 | 官方表示主體與場景一致性有所改善 |
| 原生音訊輸出 | 環境音、音樂與角色對話同步輸出 | 輸出僅影片,不含原生音訊 | 帶音訊輸出為 1.2 新增能力 |
| 影片輸出費率 | $12.00 / 百萬影片輸出 Tokens | $17.50 / 百萬影片輸出 Tokens | 依影片 Token 單價計算降低約 31.4%(720p 約 $0.07/秒) |
上表有兩個容易誤讀的地方。第一,「3 至 15 秒」只適用一般生成與對話編輯;首尾幀插值上限是 10 秒,影片延展每輪也是 3 至 10 秒。第二,解析度欄位的 1080p 與 4K 是把 360p 或 720p 原生渲染結果經超解析管線放大,不是模型直接以高解析度渲染,費率因此與原生檔差一個等級。實際計費邏輯在下一節展開。
三種角色適合的切入點不同。開發者與技術團隊直接走 Gemini API 或 Google Cloud,把影片生成嵌進自家產品與自動化流程,重點在參數規則、額度與成本控制;行銷與電商團隊重視一致性與量產,6 張參考圖鎖定商品包裝、多輪對話替換場景、360p 草稿加一次放大的流程就是為這類需求設計;個人創作者與不寫程式的使用者從 Google Vids 或 Flow 開始,用免費額度或訂閱權益先熟悉模型行為,再決定要不要升級到 API。同一個模型對三種角色的價值分別是整合能力、產線穩定性與低門檻取得。
實測表現怎麼看:官方評測資料、獨立排行榜與已知弱項
Google 自評 Gemini Omni 1.2 Flash 在全部 11 項並排偏好指標上都贏過 Gemini Omni 1.1 Flash,但查核當下兩大獨立影片排行榜都還沒有 1.2 的成績。 換句話說,「1.2 比 1.1 好」目前是 Google 自己的評測結論加上合作夥伴的定性回饋,第三方盲測資料尚未跟上,採購決策應把這個證據狀態列入考量。
Google 在官方模型頁採用的評測形式是並排偏好比較:同一批提示詞分別交給 1.2 與 1.1 生成結果,再由評測者二選一。11 項指標涵蓋編輯、文生影片、圖生影片與參考生成四類。差距最大的三項都落在這一代主打的一致性上:多參考身份一致性 63% 對 37%、參考生成整體偏好 63% 對 37%、文生影片視覺一致性 62% 對 38%。差距最小的是參考生成提示遵循,52% 對 48%,代表「照著提示詞做事」進步幅度有限。
| 任務類別 | Google 評測指標 | 1.2 偏好率 | 1.1 偏好率 | 差距 |
|---|---|---|---|---|
| 編輯 | 指令編輯(Instruction Editing) | 57% | 43% | 14 個百分點 |
| 編輯 | 編輯指令遵循 | 54% | 46% | 8 個百分點 |
| 文生影片 | 提示遵循 | 55% | 45% | 10 個百分點 |
| 文生影片 | 視覺一致性 | 62% | 38% | 24 個百分點 |
| 文生影片 | 視覺品質 | 54% | 46% | 8 個百分點 |
| 圖生影片 | 整體偏好 | 59% | 41% | 18 個百分點 |
| 圖生影片 | 參考身份一致性 | 60% | 40% | 20 個百分點 |
| 圖生影片 | 視覺一致性 | 57% | 43% | 14 個百分點 |
| 參考生成 | 整體偏好 | 63% | 37% | 26 個百分點 |
| 參考生成 | 提示遵循 | 52% | 48% | 4 個百分點 |
| 參考生成 | 多參考身份一致性 | 63% | 37% | 26 個百分點 |
讀這張表要守住三個原則。偏好率是評測者二選一的傾向,不是準確率或品質分數,不能換算成「畫質提升 24%」這類說法;Google 沒有公布提示數量、評測者組成、評測日期與信賴區間,結果無法推論統計顯著性;公告裡的示範影片是精選案例,不是平均輸出的保證。第三方 Kingy AI 的規格與評測整理記錄了同一批數字,並明言這些比較無法當成通用品質排名。
四類指標各自對應一種使用情境。編輯類兩項量的是「改了該改的、沒動不該動的」,直接對應多輪對話工作流的成品率;文生影片類量的是從零生成的提示遵循與畫面穩定度;圖生影片與參考生成類量的是上傳素材後身分與細節的保持能力,電商與品牌情境最依賴後兩類。設計自評時,測試提示詞應覆蓋自己實際會用的類別:工作流以編輯為主就多跑幾輪修改,以商品參考為主就把實際包裝照放進去,而不是照官方基準的平均分布出題。
獨立排行榜的現況如下。Artificial Analysis 的 with-audio 文生影片榜在查核當下,1.1 排第 10 名(1129 ± 13,7,666 個樣本);Arena 文生影片榜的 2026 年 9 月 21 日快照顯示,1.1 曾以 1516 ± 15 的分數排第 1(1,784 票)。兩個排行榜都還沒有 1.2 的成績,而且兩者的評測族群、提示集與尺度互不相同,排名不能互相換算,也不能拿 1.1 的名次推測 1.2 的表現。方法上,Arena 的分數來自訪客對成對影片的投票,Artificial Analysis 採同一提示成對盲測、由通過驗證的評測者評分,兩種機制量到的東西本來就不同。
官方自己標出的弱項也值得記下:Google 在公告中寫明,快速運動、急速更換腳本與複雜物理仍是持續改善中的領域。實務上比較可靠的做法,是在量產前用自己的素材做一輪小評測:同時測長片段與短片段、放進實際會用的參考圖、跑過工作流真正依賴的編輯輪數,記錄每一次計費嘗試,再計算「每支可用成品的成本」。這個數字才是決定要不要把專案搬上這個模型的關鍵,定價表與精選示範都回答不了這個問題。
Gemini Omni 1.2 Flash 價格精算:每秒多少錢、Token 怎麼算
Gemini Omni 1.2 Flash 在 Gemini API 的標準計費為每百萬個影片輸出 Token 收費 12.00 美元,換算 720p 標準解析度的生成費用約為每秒 0.07 美元,精確值是每秒 0.069504 美元。 上一代 Gemini Omni 1.1 Flash 的影片輸出單價是每百萬 Token 17.50 美元,依 Token 單價計算降幅約 31.4%;Google 在公告中取整數稱 30%,兩個數字指的是同一件事。
完整的Gemini API 官方價格表把帳單拆成三個部分:文字、圖片與影片的輸入 Token 每百萬 1.50 美元;文字輸出(含思考過程)每百萬 9.00 美元;影片輸出每百萬 12.00 美元。多數工作量的主要成本落在影片輸出,但參考圖多、提示詞長或對話輪數多的工作流,輸入費用會變得不可忽略。Gemini Omni 1.2 Flash 的 API 沒有免費層級,必須綁定付費帳單帳戶(Tier 1 以上)才能呼叫。
輸入費用在兩種工作量下會明顯放大。參考圖密集的工作流每次請求帶 6 張圖,圖片輸入按 Token 計費,多輪編輯又會重複送出素材;長提示詞與逐輪加長的對話歷史也會累積文字輸入費用。控制方法是縮短每輪提示詞、草稿階段先減少參考圖數量,定稿輪再放完整素材;實際占比以帳單明細回推最準。
Google 官方帳號在 X 上直接點出這次的計費策略:先以 360p 或 720p 草稿確認構圖,再把選定的版本放大到 1080p 或 4K,把 720p 的單秒成本壓在 0.07 美元的水準。
Meet Gemini Omni 1.2 Flash, our updated video generation model from @GoogleDeepMind 🎬
— Google (@Google) November 5, 2026
Get stronger consistency, more creative control, and faster, more cost-effective video creation at scale:
⚡ Fast & 30% lower cost: Draft at 360p or 720p ($0.07/s) and upscale to 1080p or 4K… pic.twitter.com/vBoyjdKHlg
不同解析度在 Gemini Omni 1.2 Flash 中消耗的每秒影片輸出 Token 數量不同,這是所有費用換算的基礎。 下表依官方價格表公布的 Token 用量換算,金額均為美元,Google 欄位僅計影片輸出:
| 輸出解析度模式 | 每秒消耗影片 Tokens | Google API 每秒費用 | 10 秒費用 | 15 秒費用 | 100 支 15 秒費用 |
|---|---|---|---|---|---|
| 360p(原生快速草稿) | 1,931 Tokens | $0.02317 | $0.23 | $0.35 | $34.76 |
| 720p(原生預設輸出) | 5,792 Tokens | $0.06950(官方稱 $0.07) | $0.70 | $1.04($1.04256) | $104.26 |
| 1080p(超解析放大) | 8,688 Tokens | $0.10426 | $1.04 | $1.56 | $156.38 |
| 4K(超解析放大) | 17,376 Tokens | $0.20851 | $2.09 | $3.13 | $312.77 |
註:上表僅計算影片輸出 Token($12/百萬 Tokens)。實際帳單還包含文字、圖片與影片輸入、文字輸出,以及儲存或傳輸費用,占比依工作量而異;四捨五入單價與 Token 精算值之間存在小幅差異,例如 720p 15 秒以 $0.07 乘算是 $1.05,以 Token 精算是 $1.04256。
與 1.1 的比較還有另一種算法更貼近實際:10 秒 720p 在 1.1 費率下的影片輸出費是 1.0136 美元,15 秒 720p 在 1.2 費率下是 1.04256 美元。多付約 2.9% 的費用,換到 50% 更長的片段。預算規劃應對「實際需要的候選次數」抓,而不是只看定稿單價;若一支影片平均要抽三次卡才有可用版本,每支的真實成本就是三次生成加一次放大。
降本工作流:360p 起草、多輪修改、定稿一次放大
Google 建議的省費順序是先在 360p 或 720p 起草,用對話修正細節,確定版本後才放大到 1080p 或 4K。 內容還會反覆修改時,可依下列三階段減少高解析度重做:
- 第一階段(360p 快速抽卡與構圖驗證):以 360p 生成 15 秒初稿,單次影片輸出費約 0.35 美元;實際等待時間依服務負載、素材與帳號額度而異。
- 第二階段(多輪對話微調):針對 360p 或 720p 初稿,以
previous_interaction_id繼續對話式局部修正,例如改燈光或替換手中商品,避免每次微調都重新生成整支高解析度影片。 - 第三階段(定稿放大):確認運鏡、嘴型與商品細節後,只對採用的版本執行一次 1080p(15 秒約 $1.56)或 4K(15 秒約 $3.13)放大。
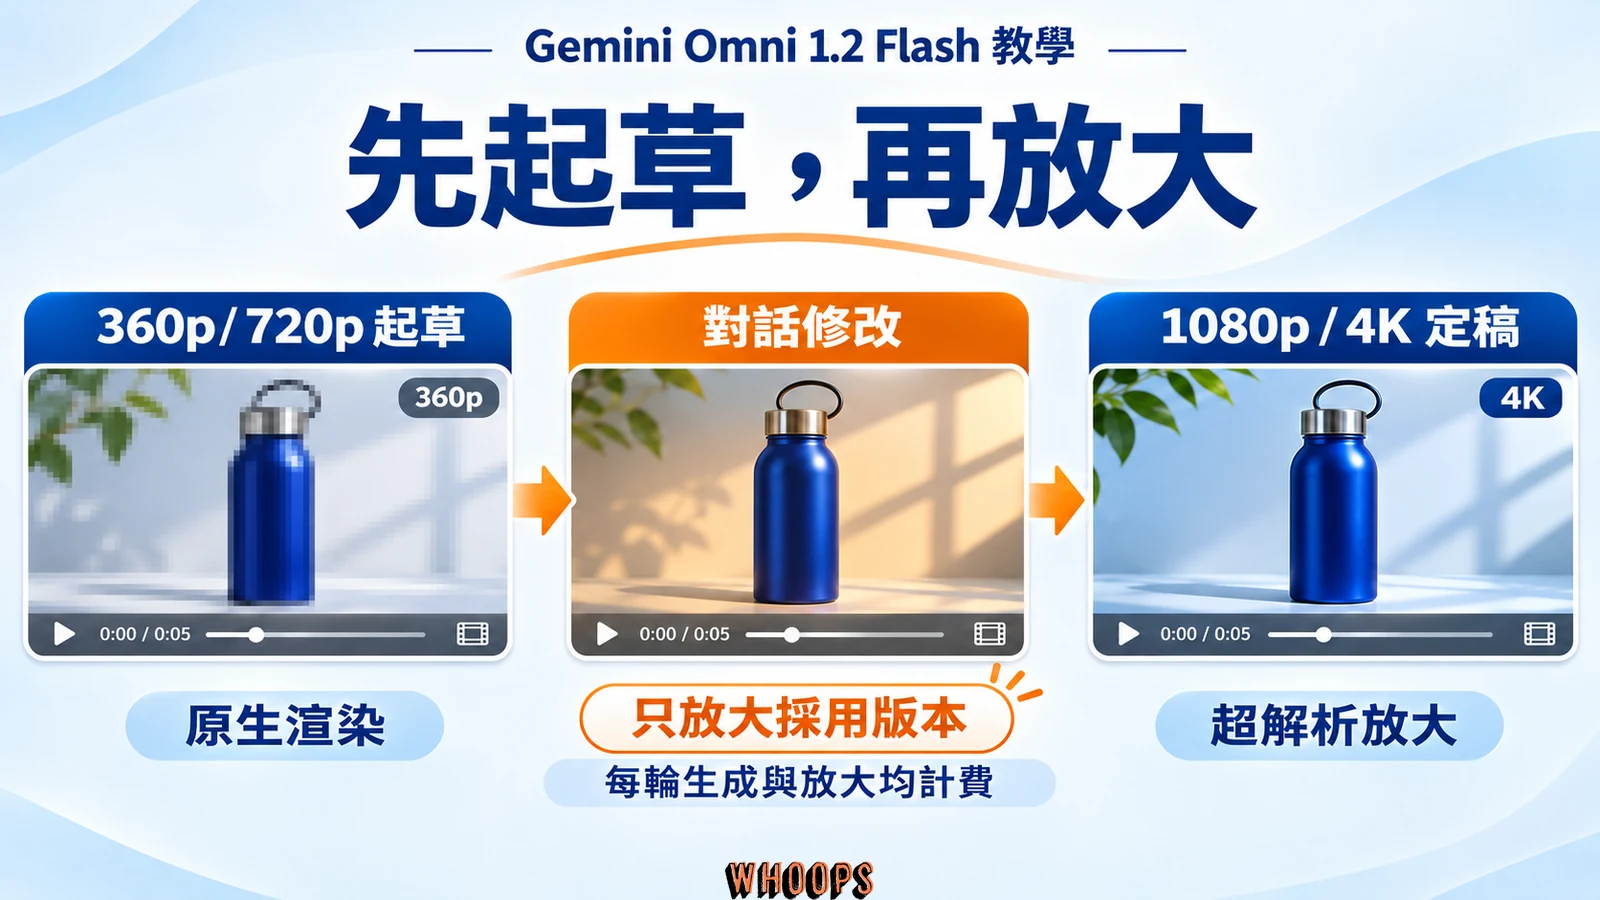
用一個可重算的情境看差距。假設製作 100 支 15 秒影片,每支共產出三個版本,只比較影片輸出費:三個版本都以 4K 輸出是 100 支 × 3 次 × $3.13 = 939.00 美元;改成兩個 360p 草稿版加一個 4K 定稿版是 100 支 ×($0.35 × 2 + $3.13)= 383.00 美元,相差 556 美元(約 59.2%)。這是四捨五入單價下的算例,未包含輸入、文字輸出與其他費用,不能當成實付節省的保證。
三種工作量的月費估算
把單價換算成月費,比較容易判斷預算規模。以下三個情境只計 15 秒影片的影片輸出費,公式完整列出,方便用實際支數重算:
- 自媒體創作者:每月 20 支 720p 成品、其中 5 支再放大 4K。影片輸出費為 20 × $1.04 + 5 × $3.13 = $20.80 + $15.65 = $36.45,加計輸入與文字輸出後約落在 40 美元上下。
- 電商團隊:每月 200 支 360p 草稿加 60 支 1080p 定稿。200 × $0.35 + 60 × $1.56 = $70.00 + $93.60 = $163.60;草稿占比高是刻意設計,換到的是低成本的構圖驗證。
- 廣告代理商:每月 500 支 360p 草稿加 200 支 4K 定稿。500 × $0.35 + 200 × $3.13 = $175.00 + $626.00 = $801.00;這個量級會常態觸及 Tier 1 的每 10 分鐘 10 美元上限,應提前規劃帳號層級與批次節奏。
三個數字都是可重算的估算,不是實付保證;重試次數、編輯輪數與失敗重跑會讓真實帳單上浮。量產前先用小批量把「每支可用成品的成本」測出來,再套用到全月規劃,這個數字比任何單價都更能回答預算問題。
Replicate 等第三方託管的溢價
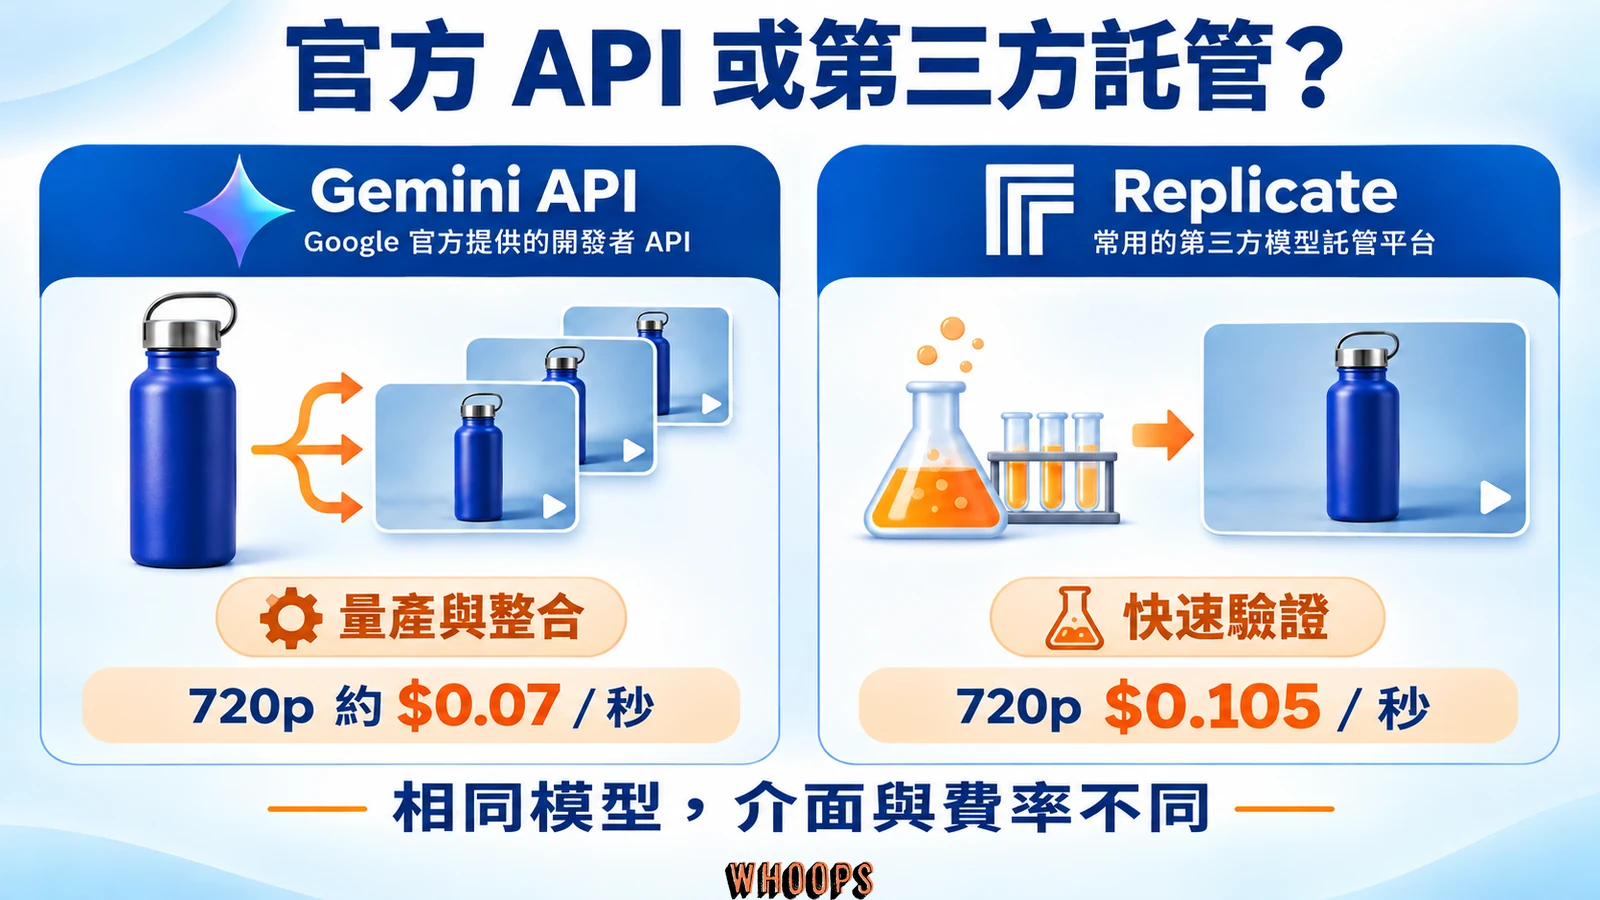
不管理 Google 帳單的團隊可以在 Replicate 的 gemini-omni-1.2-flash 託管頁直接呼叫,價格高出官方 API 約五成。 託管每秒費用為 360p $0.035、720p $0.105、1080p $0.155、4K $0.310,對照官方每秒 $0.02317、$0.06950、$0.10426、$0.20851,溢價約 49% 至 51%。少量驗證或快速原型用託管方便,量產走官方 API 明顯划算。託管頁的輸入欄位名稱(image、last_frame、reference_images)屬於 Replicate 自己的介面,與 Google Interactions API 的輸入格式不同,複製程式碼時要對準目標平台。
消費速率限制:每 10 分鐘滾動上限
除了每分鐘請求數限制,Google AI Studio 對付費帳戶另設每 10 分鐘滾動消費上限:Tier 1 帳戶每 10 分鐘最高消費 10 美元,Tier 2 與 Tier 3 帳戶每 10 分鐘最高 200 美元。 以 4K 15 秒一支約 3.13 美元估算,Tier 1 帳戶在一個滾動視窗內大約能生成三支 4K 長片。這類限制是否適用依帳號狀態與帳務歷史而異,遇到 429 RESOURCE_EXHAUSTED 時應依Gemini API 配額文件降低速率、等候視窗重置或申請提高額度;Google Cloud 的預置吞吐量是另一個部署管道,不能直接解除 Gemini API 的限制。
不寫程式怎麼用:Vids、Flow、Gemini App 與 AI Studio 五個入口
Gemini Omni 1.2 Flash 在 2026 年 11 月 5 日同步推進 Google Cloud、Flow、Google Vids、Google Ads、Google AI Studio 與 Gemini API 六個表面,消費者端的 Gemini App 則向 Google AI 訂閱用戶分批推送。 先記結論:完全免費的唯一途徑是 Google Vids 的每月免費額度;有訂閱的創作者看 Flow 與 Gemini App;開發者從 Google AI Studio 做原型,再進 API 付費量產。各入口的額度與功能不同,同一個模型在不同入口的限制也不一樣。
Google Vids 對所有 Google 帳號與 Google Workspace 訂閱者,提供每個月最多三支 15 秒影片的免費生成額度,這是不綁信用卡就能用到 Gemini Omni 1.2 Flash 的方式。Vids 內還能把生成的片段與虛擬人像、音樂、配音組合,做成產品解說、預告、社群貼文與銷售簡報,官方新聞帳號當天同步宣布了這項額度:
Google Vids now runs on Gemini Omni 1.2 Flash, our latest video generation model from @GoogleDeepMind.
— News from Google (@NewsFromGoogle) November 5, 2026
Starting today, anyone with a Google account or @GoogleWorkspace subscription can generate up to three 15 second videos per month in Vids at no cost. pic.twitter.com/hSapvjqlCO
Flow 是 Google 面向創作者的 AI 影片工具,提供場景導演與多輪對話修改,用自然語言指揮運鏡與場景變化。Gemini App 的影片生成功能向全體 Google AI 訂閱用戶分批推送,15 秒片段先向 Google AI Ultra 訂閱用戶開放,台灣用戶的訂閱費用與用量級距可參考我們的 Ultra 費用整理。Google Ads 則把模型用於規模化影片廣告製作,實際資格與額度依帳號而定。
企業端還有兩個通道值得注意。Google Ads 把模型接進影片廣告的規模化製作,讓廣告主從商品照直接產出投放素材,資格與額度依廣告帳號而定;Google Cloud 公告則預告 Gemini 商務版(Gemini for business)很快就能在對話介面裡,直接從提示詞或一張商品照生成短影片,把影片生成放進日常工作流程,不必再切換工具。兩者都還在分批推送階段,實際開放以帳號介面為準。若成品要用於廣告投放,可接著看 Google Ads 的預算與轉換追蹤設定,把素材製作與投放成效分開管理。
開發者的起點是 Google AI Studio:直接選 gemini-omni-1.2-flash 做互動原型,不需要先寫程式,滿意再搬到 API。官方模型文件列出模型定位、時長與遷移時程,可作為 API 工作的依據。下圖先按使用目的整理常見入口:
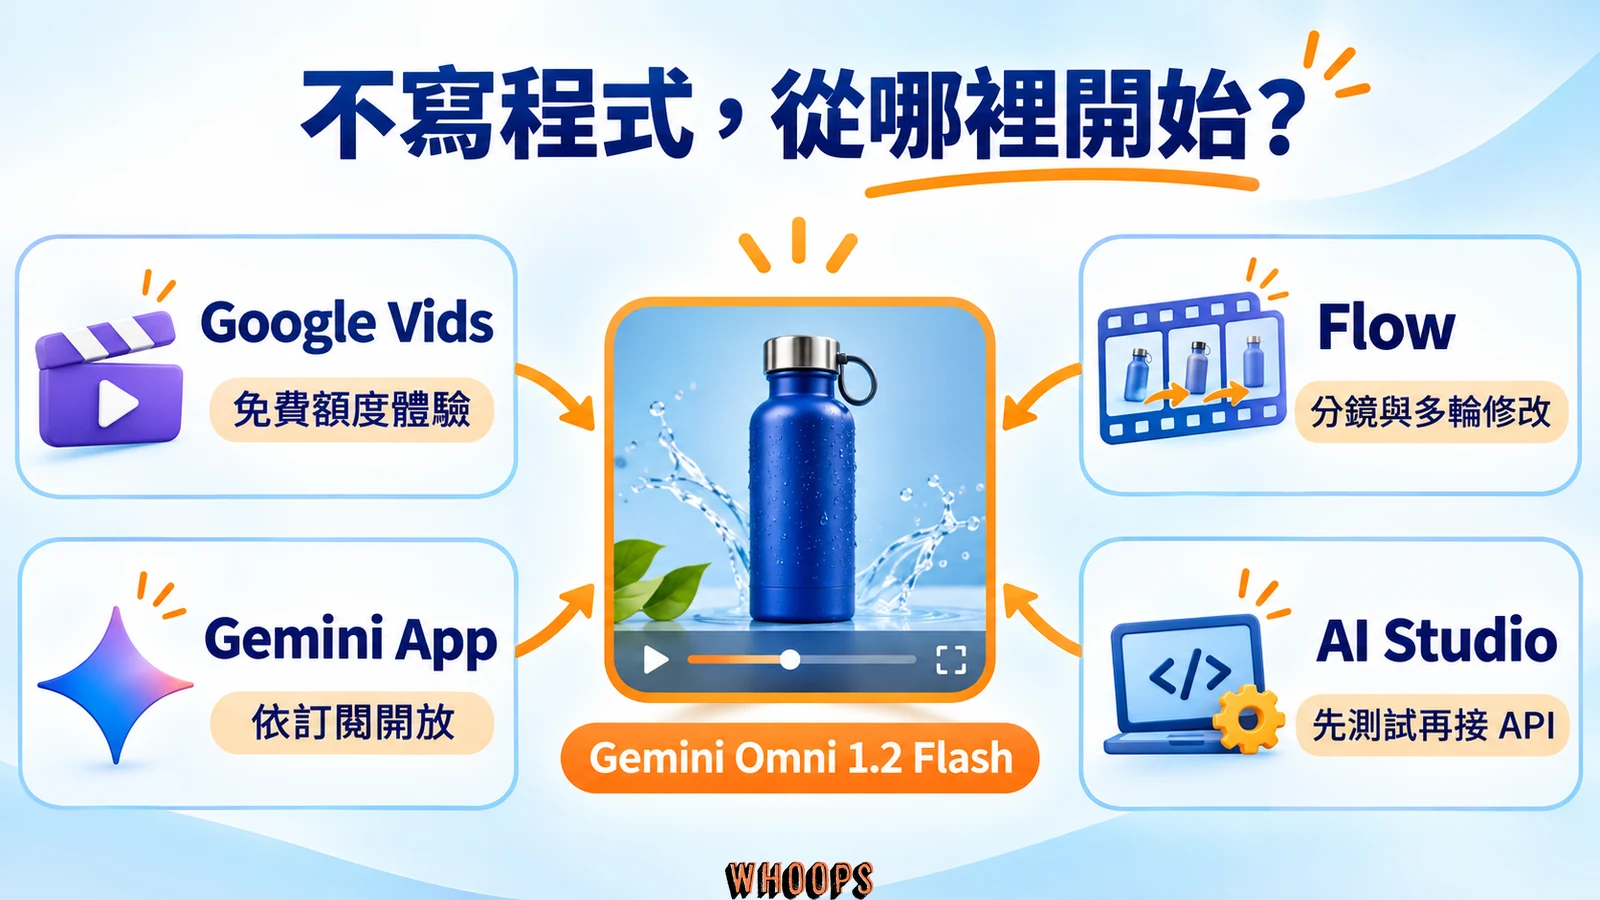
五個入口的計費方式與適合族群差很多,下表把決策需要的欄位放在同一頁。費用以 2026 年 11 月的公開資訊為準,各入口的實際額度依帳號與地區狀態浮動:
| 入口 | 費用結構 | 最長影片 | 適合誰 |
|---|---|---|---|
| Google Vids | 每月三支 15 秒免費,超出走 Workspace 方案 | 15 秒 | 不寫程式、零成本體驗與輕量簡報影片 |
| Flow | Google AI 訂閱方案內點數制 | 依方案 | 創作者做場景導演與多輪修改 |
| Gemini App | Google AI 訂閱方案,15 秒先向 Ultra 開放 | 15 秒 | 想在對話裡快速生片的訂閱用戶 |
| Google Ads | 廣告帳號內提供,資格依帳號而定 | 依產品規則 | 廣告主從商品照產投放素材 |
| AI Studio 與 Gemini API | 按 Token 計費(720p 約 $0.07/秒),無免費層 | 15 秒(延展至 30 秒) | 開發者原型測試與量產整合 |
選入口的原則一句話:先在 Vids 或 AI Studio 確認模型做得到你要的效果,再決定把預算放在哪個入口。免費額度適合驗證創意方向,訂閱點數適合個人生產,API 計費適合需要穩定整合與成本控制的團隊。
Python API 實戰:Interactions API 六種生成與編輯模式
開發者透過最新版 google-genai Python SDK 的 client.interactions.create 方法呼叫 gemini-omni-1.2-flash。 完整的端點參數說明在Google AI Studio 的 Gemini Omni Flash 官方技術文件,以下依六種模式整理實作方式與參數規則;先安裝或更新 SDK,並在執行環境安全設定 GEMINI_API_KEY。
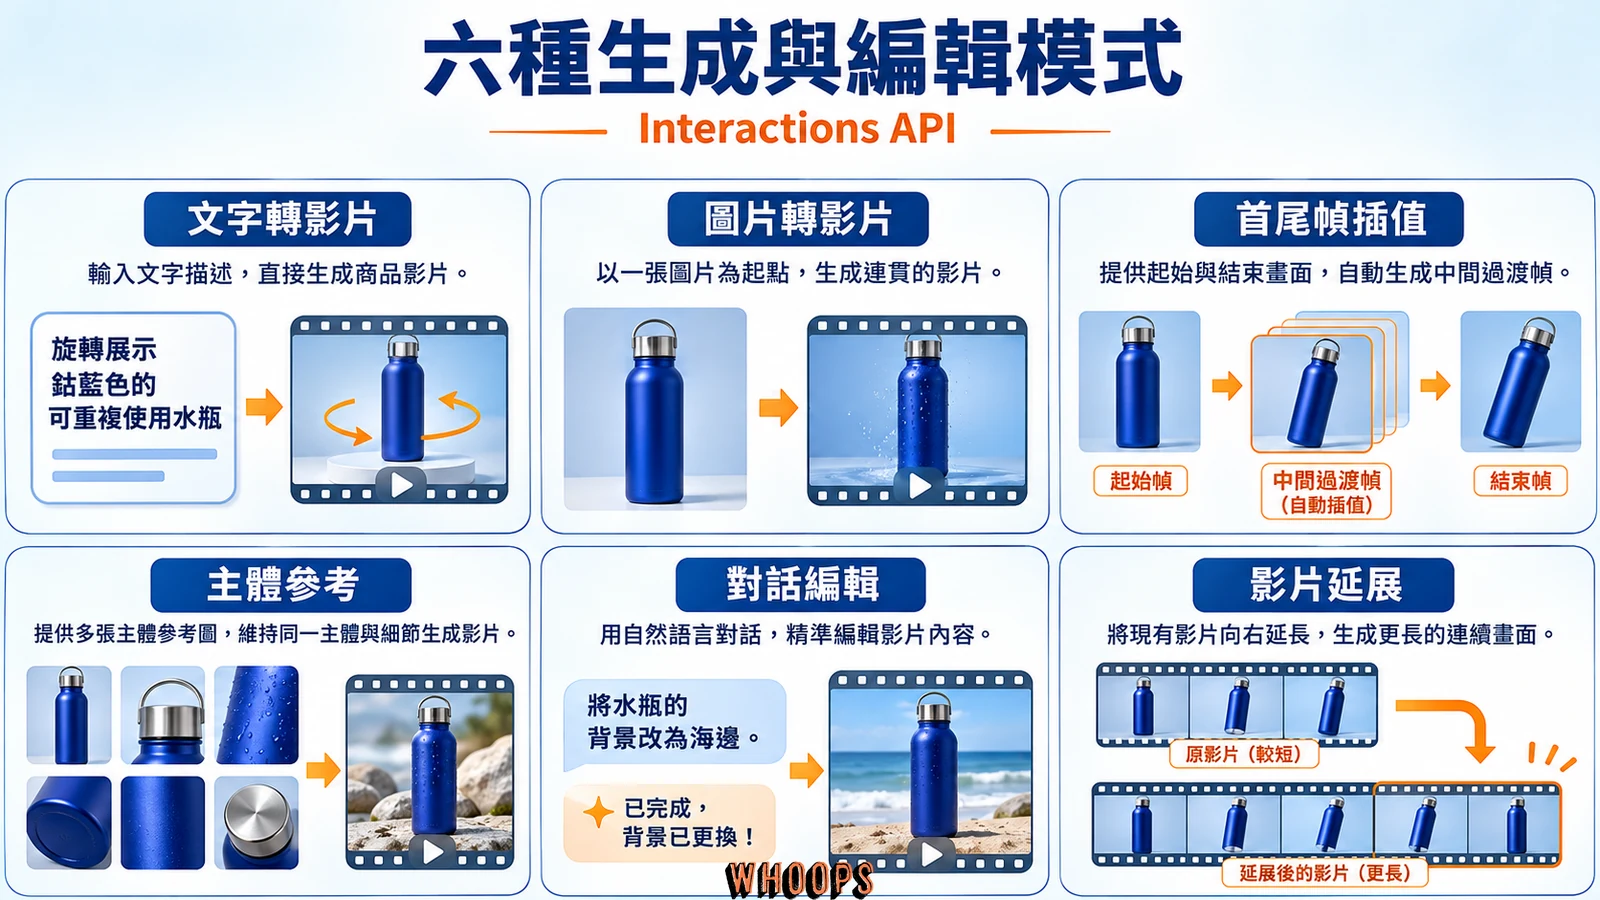
Interactions API 的基本單位是「互動」(interaction):每一次生成或編輯請求都會建立一筆互動紀錄並回傳識別碼,模型在對話中記得影片內容,下一輪只下達修改指令,不必重新描述整個場景,也不用重新上傳前一支影片。這個設計就是把「生成、修改、延展」變成一場有狀態的對話,理解了互動識別碼的延續方式,六種模式就能串成同一條工作流。
模式一:文字轉影片,以回應格式控制時長與解析度
Gemini Omni 1.2 Flash 支援以純文字提示詞生成包含同步音效與對話的 3 至 15 秒影片。 官方文件示範的文字轉影片範例,是一段一鏡到底的工作室彈珠軌道影片:
以下程式依官方 Interactions API 範例調整,會產生付費請求,並把回傳影片存成 MP4:
import base64
from google import genai

# 初始化 Google GenAI 客戶端
client = genai.Client()

# 呼叫 gemini-omni-1.2-flash 生成 15 秒直式 9:16 帶音訊影片
interaction = client.interactions.create(
    model="gemini-omni-1.2-flash",
    input=(
        "一鏡到底的 FPV 跟拍鏡頭,跟隨一架紙飛機穿過繁忙的古典圖書館。"
        "背景有書頁翻動的沙沙聲,圖書管理員在紙飛機飛過時輕聲說:『嘿!請保持安靜。』"
        "無背景音樂,溫暖的鎢絲燈光,淺景深。"
    ),
    response_format={
        "type": "video",
        "aspect_ratio": "9:16",  # 支援 "16:9" (預設) 或 "9:16"
        "resolution": "720p",    # 支援 "360p", "720p" (預設), "1080p", "4k"
        "duration": "15s"        # 支援 "3s" 至 "15s" 整數秒,超過 15s 會回傳 Invalid Argument 錯誤
    }
)
with open("gemini-omni-demo.mp4", "wb") as output:
    output.write(base64.b64decode(interaction.output_video.data))
print(f"Interaction ID: {interaction.id}")
時長控制有三條規則。未在 response_format 指定 duration 時,模型預設生成 10 秒;設定 duration 後,API 參數優先於提示詞文字裡寫的秒數描述;把秒數設成超過 15 秒會直接回傳 invalid argument 錯誤。畫面比例以 aspect_ratio 設定,橫式 16:9 為預設,直式選 9:16。
模式二:單張圖片轉影片,讓商品照動起來
單張靜態圖片可以作為起始畫面,被轉化成最長 15 秒的動態影片。 這個模式適合把電商平台現有的商品去背照或模特兒棚拍照直接變成動態展示:輸入商品正面照,描述鏡頭環繞、光線流動與背景質感,模型會讓畫面從這張圖開始動作。圖片是「起點」而不是束縛,後續動作由提示詞決定。
模式三:首尾幀插值,上限只有 10 秒
同時輸入起始幀與結束幀兩張圖片,模型會自動補齊兩個畫面之間的連續運鏡與動態過渡。 這個模式必須注意時長限制:首尾幀插值只支援 3 至 10 秒,同時傳入兩張幀圖片又把 duration 設成 11 至 15 秒,Gemini API 會拒絕請求並回傳 invalid argument error。需要 15 秒過渡動畫的腳本,要拆成兩段生成再剪接。
模式四:主體參考,6 張參考圖與動態參考短片規則
Gemini Omni 1.2 Flash 允許單次請求傳入最多 6 張參考圖片,維持人物、服裝、商品或視覺風格的一致性;參考圖不是死板的首幀,而是主體參考。 Gemini Interactions API 以 input 陣列提供 type: image 素材;部分第三方介面使用的 reference_images 欄位名稱不屬於這個 API,複製範例時要對準平台。若要先整理商品視覺與角色參考圖,可延伸閱讀 Nano Banana 2.1 的圖片生成與編輯方式,再按本節規則準備影片輸入素材。數量規則如下:
- 多角色分配:單次請求最多鎖定 2 位特定角色,每位角色最多 3 張不同角度的參考照片,例如正面、側面與全身。
- 動態參考影片:生成 3 至 10 秒影片時,最多附帶 3 段參考影片(每段最長 3 秒);生成 11 至 15 秒影片時,最多附帶 1 段參考影片(最長 3 秒)。參考影片只提供視覺樣貌,影片裡的聲音會被忽略,而且只能用於生成新影片,不能用於編輯或延展。
- 參考圖的適用範圍:參考圖片在所有時長都支援,而且生成、編輯與提示詞式延展三種任務都能使用,是維持跨鏡頭一致性的主要工具。
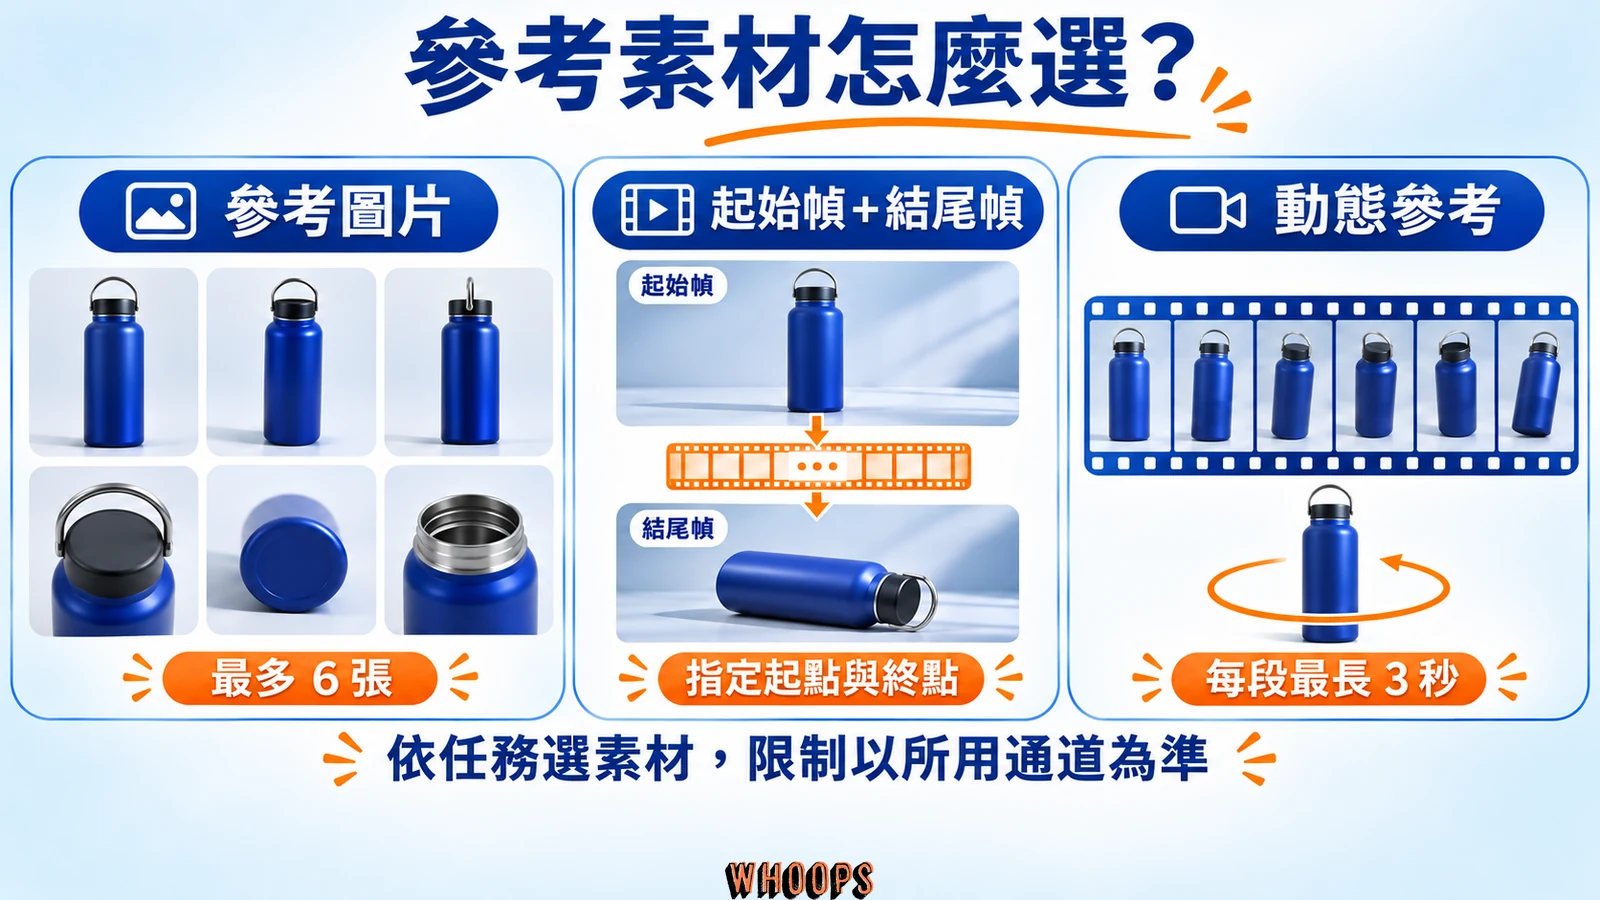
素材規則要依所用平台判斷。Gemini API 官方限制明列:參考圖片可用於新影片生成、影片編輯與提示詞式延展;參考影片則只可用於生成新影片,不能用於編輯或延展。官方公告也示範以多輪對話切換畫面比例。Replicate 的素材互斥、duration 或 aspect_ratio 規則屬於其託管介面,不能直接當成 Gemini API 的通用限制;實作時應核對所選端點的當前文件。
模式五:多輪對話編輯,用 interaction ID 接續修改
第二輪以後的修改,靠 previous_interaction_id 追蹤對話狀態;模型生成的影片與透過 Files API 上傳的既有影片(最長 15 秒)都能編輯。 使用者可以在第二輪直接要求「把桌上咖啡杯替換為品牌氣泡水罐,並把窗外天氣改為暴風雪」,模型會依對話嘗試保留其餘動作與運鏡,實際保留程度仍要檢查輸出。編輯提示詞越短越好,過度描述反而容易帶來非預期變動,改動特定項目時附上「其他一切保持不變」是最實用的一句話。
官方文件以一段小提琴街頭影片示範多輪編輯的前後差異:先用文字生成原始版本,再透過對話指示把小提琴改成隱形,演奏者的動作與場景幾乎原封不動:
狀態編輯有一個工程上要留意的參數:store=false 會讓生成結果不保存在互動狀態裡,之後就無法用 previous_interaction_id 編輯。追求速度的一次性生成可以設 store=false、background=false 與 stream=false;需要多輪修改的工作流必須保留狀態,兩種設定不要混用。
模式六:影片延展,每輪 3 至 10 秒、總長最多 30 秒
影片延展針對模型已生成的影片或 Files API 上傳的影片做時間軸延長,依官方延展文件,模型取輸入影片的結尾 10 秒作為上下文,每輪延展 3 至 10 秒,延展後總長最多 30 秒。 兩個硬規則要知道:延展只能加在影片結尾,不能往前加或在片中插入;上傳的影片裡若有人正在說話,不能用延展追加新對白(角色可以保持沉默,或改用模型生成影片的多輪延展)。超過 30 秒的敘事要分段生成再剪輯,不能假設鏡頭完全連續。
進階提示詞技巧與三種實戰工作流範本
寫提示詞的基本結構是五個欄位依序交代:鏡頭構圖與運鏡、主體與動作、光影與場景、聲音設計、不要的元素。 對白用引號包起來並指名說話者,環境音與音樂直接描述,不要的東西明寫「無對白」「無音樂」「無額外音效」。Gemini Omni 1.2 Flash 沒有獨立的 negative prompt 參數,否定條件寫進一般提示詞即可,例如「不要出現文字浮水印」直接寫在句尾。
單場景控制是最常見的卡點。模型的預設行為是把提示詞剪成數個鏡頭、鋪一個小敘事;需要一鏡到底時,必須明寫「單一連續鏡頭」「無場景切換」這類指令。運鏡詞彙用專業術語效果穩定:push in(推近)、orbit(環繞)、dolly zoom(滑動變焦)、FPV drone(穿越機視角)都在官方建議清單內。
編輯提示詞的原則是短。官方文件給的四個範例都是一句話:「把這支影片變成動畫」「為這個人戴上一頂時尚帽子」「光線改得更戲劇化」「把招牌文字改成 Omni Flash」。改動特定項目時附上「其他一切保持不變」。參數方面,Gemini API 介面不支援系統指令、temperature、top_p、stop sequences 與 negative prompts 參數,控制風格的責任全部落在提示詞文字上;Google Cloud 通道有列出 temperature 與 top_p,跨通道搬移程式碼時要重新確認參數可用性。
官方公告裡三段示範值得對照著看,每段各展示一種能力的邊界。展覽海報案例把同一張海報與五層動畫提示分別交給 1.1 與 1.2,1.2 能逐層組裝出玻璃、燈絲與字型細節並保持到結尾畫面,展示的是參考遵循度;帳篷場景案例從同一支母片出發,逐輪把背景換成橡樹林、馬廄、市集與石砌城堡,兩位角色的表演、盔甲反光與運鏡保持不動,展示的是多輪編輯的穩定性;音樂學院案例以一張場景圖搭配四張角色與嘴型參考、一段一秒語音,1.2 把每個聲音正確分配給對應角色,展示的是多說話者的聲音路由。三段都是 Google 精選的示範,當作能力上限的參考,不要當成平均輸出的預期。
效能相關的兩個設定:輸出影片大於 4MB 時,在 response_format 使用 delivery="uri" 以檔案連結交付,避免回應大小限制;草稿階段固定用 360p 生成,選定提示詞後再用高解析度重跑,是官方與託管平台一致建議的省費習慣。以下三個工作流範本把上述技巧放進具體場景,範本用來安排素材與修改順序,需依實際輸出調整。
實戰場景一:電商服飾 15 秒 360 度虛擬試穿
服飾展示先提供單一角色與服裝的參考圖,再描述轉身、走近或換景動作。 在 15 秒內安排多套服裝會增加一致性檢查工作,應先驗證單套服裝,再增加變化。量產這類素材之前,先用關鍵字研究流程確認每支影片對應的品類搜尋需求,避免生成沒有人找的內容。
- 輸入配置:以
input陣列提供一位角色與服裝的參考圖片,總數不超過 6 張;同一角色最多 3 張參考圖。設定duration="15s"、aspect_ratio="9:16"。 - 提示詞範本:
Studio fashion lookbook video, 15 seconds continuous sequence with match cuts. The model from reference image 1 stands in a minimalist concrete studio with soft diffused key lighting. From 0s to 5s, the model wears outfit A from reference images 2 and 3, performing a smooth 360-degree turn showing the exact back seam and fabric drape. At 5s, a seamless match cut transitions to outfit B from reference images 4 and 5 as the model walks toward the camera. Maintain strict facial identity, garment typography, and fabric texture consistency. Subtle camera shutter clicks and ambient studio room tone, no background music.
實戰場景二:專業棚拍發言人與可控體態演示
製作線上課程、健身動作教學或後期多國語言配音素材時,創作者需要穩定的肢體結構與可控的嘴型狀態。 要直接生成帶台詞的發言人影片,在提示詞用單引號標註台詞並指定語速,例如 speaks clearly at a measured pace: '...'。工作流若是先生成無聲棚拍、後續再接外部語音軌道,則在提示詞結尾明寫「閉嘴微笑或自然呼吸、無對話」(mouth remains gently closed with natural breathing, silent presenter, no speech, no background music),輸出後仍要檢查有沒有不需要的嘴部動作。
- 提示詞範本(健身器械標準動作演示):
Medium full shot on a fixed tripod camera in a brightly lit professional gym studio. The fitness instructor from reference images 1-3 performs a slow, controlled dumbbell lateral raise with strict anatomical form and steady tempo. Camera holds completely still with zero jump cuts and consistent body scale. The instructor maintains focused eye contact with the camera, mouth closed with steady breathing, no dialogue. Soft commercial lighting, subtle ambient gym room sound only.
實戰場景三:一鏡到底產品微距運鏡與多輪在地化改稿
行銷團隊可用同一支母片建立場景與比例變體,每一輪只調整明確項目,較容易檢查主體、包裝與鏡頭是否有非預期改變。 三輪流程如下:
- 第一輪(生成基礎母片):輸入產品包裝正側面參考圖 3 張,以 720p 生成 15 秒桌上微距環繞運鏡,水珠滑落瓶身,背景為夏日海灘陽光。
- 第二輪(對話替換季節場景):帶入
previous_interaction_id,輸入指令:Keep the exact bottle motion, water droplets, and camera orbit identical. Change the background environment to a cozy winter wooden cabin with snow falling outside the window and warm fireplace lighting. - 第三輪(切換投放比例並放大):確認畫面無誤後,在對話中要求切換為 9:16 直式構圖並執行 1080p 超解析放大,再檢查包裝文字、畫面裁切、音訊與素材權利,確認符合投放規格。要把影片放進網站內容時,可依AI SEO 的內容證據與引用檢查順序補上能獨立閱讀的文字說明;想先補齊搜尋基本功,可回頭讀SEO 完整新手指南。生成影片本身不保證搜尋曝光。
API 限制、報錯排查與台灣使用者要注意的規則
遇到 400 INVALID_ARGUMENT 先比對操作模式、秒數與素材格式;遇到 429 RESOURCE_EXHAUSTED 再查請求速率與帳號額度。 除錯時以同一平台的文件為準,不要把 Replicate、Gemini API 與 Vertex AI 的欄位混用。可按下列順序檢查:
- 確認 API 欄位:Gemini Interactions API 使用
input素材陣列與response_format;第三方平台的image、last_frame或reference_images欄位不能直接搬進來。 - 檢查模式時長:一般生成為 3 至 15 秒;首尾幀插值僅 3 至 10 秒;影片延展每輪 3 至 10 秒、總長最多 30 秒,且只能加在結尾。
- 確認素材組合:參考圖生成、編輯與延展都可用;參考影片只能用於生成新影片且聲音會被忽略;上傳供編輯的影片必須在 15 秒以內;系統不支援跨多支影片的推理,多影片提示可能導致效能下降或非預期輸出。
- 地區限制:歐洲經濟區(EEA)、瑞士與英國的使用者,無法透過 Gemini API 對自行上傳的影片執行編輯或延展,也不能上傳或編輯含未成年人的圖片;模型生成的影片仍可多輪編輯。含特定可識別公眾人物的圖片在所有地區都不支援上傳編輯。
- 分清音訊輸出與輸入:Gemini API 支援生成原生音訊,但不支援音訊參考輸入與 voice editing;YouTube 影片不能作為素材來源。Google Cloud 公告中的音訊參考另採 allowlist 白名單,Cloud 權限不能套用到 Gemini API。
台灣使用者的兩個邊界要特別記下。第一,台灣不在 EEA、瑞士與英國的限制範圍內,上傳影片編輯與延展功能可用,但實際開放仍依所用平台的支援地區、付費資格與帳號狀態而定。第二,官方文件明言英文獲得完整支援,其他語言尚未評估:中文提示詞可以送出,模型通常能理解,但輸出品質與指令遵循可能浮動,重要專案建議以英文提示詞為主、中文逐步檢查。內容安全過濾同時作用在輸入提示與輸出影片上,且各地區標準不同,被系統判定違規的請求會直接失敗並回傳 content error。
每一支生成的影片都會嵌入 SynthID 隱形浮水印,肉眼看不到、但可以程式驗證來源。SynthID 是來源標記,不代表商用授權;商用前仍須確認所用產品的服務條款、素材權利與人物授權。想實際驗證影片的浮水印訊號,可以參考我們的SynthID Detector 浮水印驗證教學。
上線前檢查清單
把專案推上生產環境之前,依序確認七件事,可以避開大部分常見問題:
- 帳單帳戶與層級:確認 Tier 1 以上已生效,並估算每 10 分鐘滾動消費上限對批次量的實際影響。
- 模型識別碼:程式裡固定寫
gemini-omni-1.2-flash,不要依賴 12 月 3 日之後的自動轉移機制。 - 時長與模式對照:逐一檢查每個生成路徑,確認 15 秒、10 秒與 30 秒三個上限各自適用哪個模式。
- 素材組合驗證:把參考圖、參考影片、首尾幀與上傳影片的互斥規則寫入程式碼的送出前檢查,而不是等 API 報錯。
- 提示詞與素材版本控制:每次取得可用成品時,同步保存提示詞、參考素材與設定;之後的請求可能改變團隊想保留的細節。
- 語言策略:以英文提示詞為主、中文逐步檢查,關鍵腳本先用小樣本對照兩種語言的可用率再定案。
- 輸出驗收:建立包含包裝文字、臉部一致性與嘴型同步的檢查表,每批抽樣核對,並持續記錄每支可用成品的成本。
選型指南:與 Veo、Sora 的現況對照,以及 Cloud 和 Gemini API 的差異
要新建影片生成或對話修改管線,Gemini Omni 1.2 Flash 是 Google 現行主力;Veo 與 Sora 的舊入口已經停止,不適合作為新專案的部署目標。 搜尋常見的「Gemini Omni 對比 Flow」其實不是模型對模型:Flow 是搭載 Omni 的產品入口,底層同一個模型,差別在介面與額度。
| 模型或服務 | 目前要確認的事 | 閱讀與選擇重點 |
|---|---|---|
| Gemini Omni 1.2 Flash | 一般生成 3 至 15 秒,支援多輪修改;Gemini API 無免費層 | 以參考素材、對話編輯、帳號額度與每次生成費用評估 |
| Google Veo | Gemini API 的 Veo 3.1 Preview 已於 2026 年 10 月 22 日停止 | 依 Google 文件遷移至 Omni,或另核對 Cloud 的可用版本 |
| OpenAI Sora | Sora 網站與 App 已於 2026 年 4 月 26 日結束,API 於 9 月 24 日結束 | 不適合作為現在新接入的量產服務 |
部署狀態依Google Veo 官方文件與 OpenAI 的 Sora 停止服務說明整理。舊專案若已使用 Veo 或 Sora,先確認原端點是否仍提供服務,不能只拿歷史展示比較畫質與秒數。
企業採用面,Google Cloud 的 GA 公告列出八家已在生產流程採用的公司與平台:Artlist 用於參考式生成與影片延展、FLORA 用對話指令換配色或背景而保持商品不動、invideo 在內部評測後用於大規模快速產片、Krea 用於角色與場景替換、Picsart 以草稿模式多輪修改再輸出 4K、Runway 整合進企業方案、Photoroom 把模型用於商品廣告產生器、QuickFrame AI 以 15 秒 1080p 單次生成完整 CTV 廣告。這些是 Google 刊出的合作夥伴說法,屬於採用訊號,不是獨立效能驗證。
同一個模型在 Cloud 與 Gemini API 兩個通道的規格不同,挑錯通道會誤判限制。Cloud 的模型規格列每個提示最多 10 張圖片、輸出上限 260,640 Tokens、提供全域端點與預置吞吐量(Provisioned Throughput),並列出 temperature 與 top_p;Gemini API 的文件列 6 張參考圖、輸出上限 65,536 Tokens,不支援預置吞吐量與那些取樣參數。兩邊文件各自成立,不要把最大值拼在一起用。
通道選擇用三個問題判斷。團隊已經用 Google Cloud 帳單與身分權限管理基礎架構,或需要預置吞吐量保證量產速率,就走 Cloud;要快速原型、按用量計費、直接在 AI Studio 測試,就走 Gemini API;需要 10 張參考圖或 temperature 微調的專案,目前只有 Cloud 通道支援。兩個通道背後是同一個模型,差異在額度、參數與企業功能,不是模型版本不同。
若需求偏向本機部署或原生音訊工作流,可延伸閱讀 MiniMax H3 的影片與音訊工作流;若主要需求是讓數位角色照腳本說話,HeyGen 的數位人製片流程更貼合任務。這兩條路線與 Gemini Omni 1.2 Flash 是互補關係,不是替代關係。
從 1.1 遷移到 1.2:時程、資費與生命週期規劃
Google 已宣布 gemini-omni-1.1-flash 進入為期 4 週的過渡期,2026 年 12 月 3 日起所有舊版請求自動路由到 gemini-omni-1.2-flash,程式碼不用改、新費率直接生效。 自動轉移代表模型行為可能在你沒改任何程式的情況下變化;過渡期內應把代表任務先跑過 1.2,記錄可用率與成本再讓流量自動切換。還沒接觸過這個系列的讀者,可以先看Gemini Omni 前代的完整操作教學。關鍵時程如下:
- 2026 年 11 月 5 日(正式全面開放):Google 發布
gemini-omni-1.2-flash,同步上線 Google AI Studio、Gemini API、Google Cloud、Google Vids、Flow 與 Google Ads,Gemini App 先向 Google AI 訂閱用戶分批推送。 - 2026 年 11 月 5 日至 12 月 2 日(雙版本並行過渡期):舊版
gemini-omni-1.1-flash維持可用,工程團隊應在此期間測試 15 秒時長參數、6 張參考圖與多輪編輯在自家提示詞上的表現。 - 2026 年 12 月 3 日(自動轉移日):所有發往 1.1 的 API 請求自動導向 1.2,費率降為 1.2 的每百萬 12.00 美元,不需修改任何程式碼。
- 2027 年 11 月 5 日或之後(Cloud 退役時程):Cloud 模型生命週期頁列出此日期;這是 Cloud 通道的退役安排,不能當成所有 Gemini API 服務的一年支援承諾。
過渡期內的測試要對準四個會改變行為的點。時長上限從 10 秒放寬到 15 秒,舊提示詞裡寫死的秒數描述要重新對照 API 參數;6 張參考圖與 2 角色 × 3 張的分配是新上限,參考素材多的腳本要重測一致性;多輪編輯的保留程度以 1.2 的行為為準,舊專案的編輯鏈要整條重跑;費率降為每百萬 12.00 美元,把 1.1 的歷史帳單按新費率重算,預算模型才不會失真。四項都驗過,12 月 3 日的自動轉移就不會有意外。
Google 也在官方 X 上公布這波更新的完整部署範圍,從 Google Cloud、Flow、Vids、Ads 到 Gemini API 一次到位,Gemini App 先向 AI Ultra 訂閱用戶開放 15 秒片段:
Gemini Omni 1.2 Flash is rolling out starting today across @GoogleCloud, @FlowByGoogle, Google Vids, Google Ads, @GoogleAIStudio and the Gemini API.
— Google (@Google) November 5, 2026
Also rolling out to @GeminiApp for all Google AI subscribers, with 15-second clips available to Ultra.
Learn more ↓…
Gemini Omni 1.2 Flash 常見問題快速解答(FAQ)
Gemini Omni 1.2 Flash 可以免費使用嗎?
Gemini Omni 1.2 Flash 的開發者 API 不提供免費額度,必須綁定 Tier 1 以上的付費帳單帳戶才能呼叫。一般使用者想免費體驗,可以開啟 Google Vids,以一般 Google 帳號或 Workspace 訂閱,每個月免費生成最多三支 15 秒影片;Flow 與 Gemini App 的影片功能屬於 Google AI 訂閱方案權益,Ultra 訂閱用戶先取得 15 秒片段。目前可確認的免費入口是 Google Vids;其他入口的權益與額度,請以帳號介面為準。
Gemini Omni 1.2 Flash 台灣可以用嗎?
台灣不在 Gemini API 外部影片編輯與延展的 EEA、瑞士與英國限制範圍內,上傳影片的編輯與延展功能可以正常使用。實際使用仍要符合各平台的支援地區、付費資格與帳號配額。語言方面,官方文件明言只完整支援英文,中文提示詞可以送出、模型通常能理解,但輸出品質與指令遵循可能浮動,重要專案建議以英文提示詞為主力。
Gemini Omni 1.2 Flash 支援 4K 畫質與幾幀(FPS)輸出?
Gemini Omni 1.2 Flash 支援最高 4K 解析度輸出,所有影片固定為每秒 24 幀(24 fps)。360p 與 720p 是原生渲染解析度,1080p 與 4K 則是把原生結果經超解析管線放大,每秒費用因此差一個等級:720p 每秒約 0.07 美元、15 秒約 1.04 美元,4K 每秒約 0.21 美元、15 秒約 3.13 美元。要控制成本,先用低解析度草稿確認構圖再放大,而且放大只對選定版本做一次,避免每一輪修改都用高解析度重跑。
Gemini Omni 1.2 Flash 生成的影片有浮水印嗎?可以商用嗎?
每一支生成的影片都會自動嵌入肉眼無法察覺的 SynthID 隱形數位浮水印,可以用程式檢測來源,方便出版方與平台驗證。SynthID 屬於來源標記,不等於商用授權;商用前仍要確認所用產品的服務條款、素材權利與人物肖像授權,部分產品入口也可能另有可見的浮水印或標識。
Gemini Omni 1.2 Flash 可以用中文提示詞嗎?
可以。中文提示詞能直接送出,模型通常能理解並生成結果;不過官方文件明言英文獲得完整支援、其他語言尚未評估,中文輸出的指令遵循與細節品質可能浮動。建議的做法是以英文提示詞生成主力素材、再用中文逐步檢查與修正,關鍵腳本先做小樣本的雙語對照,確認可用率後再放量。
Gemini Omni 1.1 Flash 什麼時候停用?需要改程式碼嗎?
不會突然停用。2026 年 11 月 5 日起是 4 週並行過渡期,1.1 維持可用;2026 年 12 月 3 日起,所有發往 gemini-omni-1.1-flash 的請求自動轉移到 1.2,程式碼不需要修改,費率直接降為每百萬 12.00 美元。要注意的是模型行為可能隨轉移改變,建議在 12 月 3 日前用代表任務先測過 1.2,重點放在 15 秒時長參數、6 張參考圖與多輪編輯的實際表現,並把 1.1 的歷史帳單按新費率重算。
Gemini Omni 1.2 Flash 一次可以生成多長的影片?可以延展嗎?
一般生成與對話編輯最長 15 秒,可在 3 至 15 秒之間逐秒設定,預設 10 秒;首尾幀插值上限 10 秒。影片延展每輪可加 3 至 10 秒,以輸入影片的結尾 10 秒為上下文,延展後總長最多 30 秒,而且只能加在影片結尾;更長的敘事要分段生成再剪輯,不能假設鏡頭自然連續;上傳供編輯或延展的影片本身也必須在 15 秒以內,超過要先剪短再送出。
Gemini Omni 1.2 Flash 和 Veo 有什麼不同?該選哪一個?
Veo 3.1 Preview 已於 2026 年 10 月 22 日從 Gemini API 停止,Google 文件給出的現行遷移路徑就是 Gemini Omni 1.2 Flash,新專案不應再把 Veo 當部署目標;OpenAI Sora 的網站與 API 也已分別結束服務。要新建影片生成管線就選 Gemini Omni 1.2 Flash,真正要比較的是入口(API、Cloud、Vids、Flow)與用量費用。若需求是讓數位角色照腳本說話,或要與其他模型混用部署,可另行評估 HeyGen 與 MiniMax H3 兩條路線,與 Omni 屬互補關係。
討論與提問