
本篇內容
Google 在 2026 年 10 月 1 日更新「網站上使用生成式 AI 內容」官方指引,首次明文要求:發布前必須人工查證並審查所有 AI 生成內容的準確性與可信度。
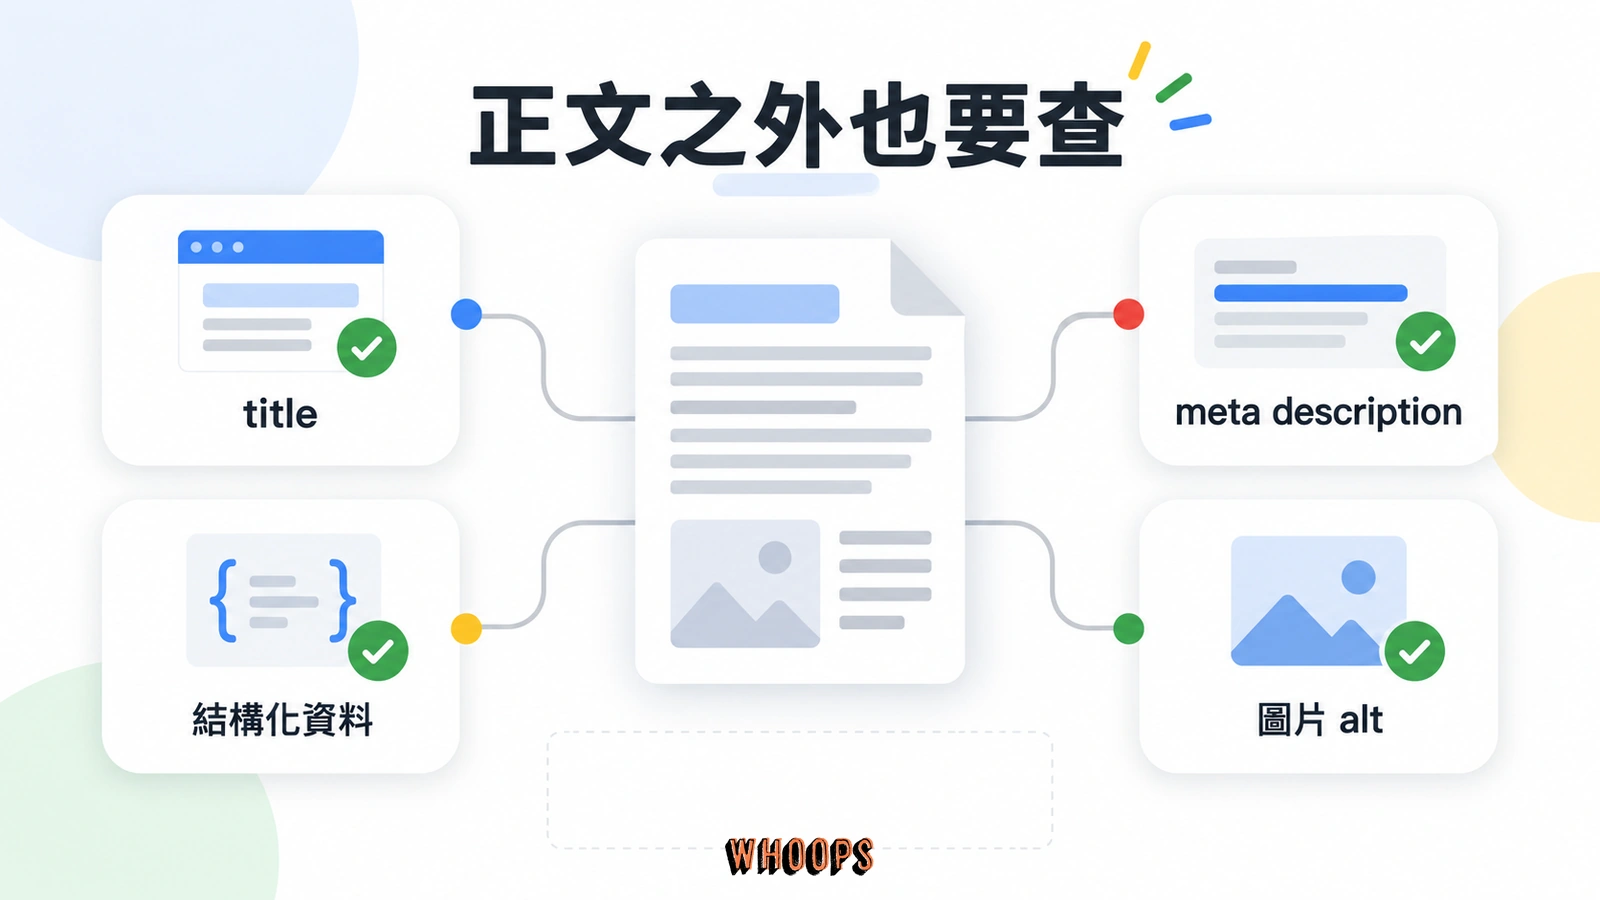
查證範圍不只正文。title、meta description、結構化資料與圖片 alt 文字,都被劃進同一套人工審查。
官方定位是把搜尋品質評估者指南的資訊同步進文件,不是宣布新政策;大量產製操縱排名的內容本來就違規,這次是把既有要求講得更明白。
2026 年 10 月 1 日,Google更新了生成式 AI 內容使用指引,頁腳的更新時間載明 2026-10-01 UTC。這份文件放在 Google Search Central 開發者文件裡,講的是網站經營者如何「以符合 Google 政策的方式」使用生成式 AI 產製內容。對大量用 AI 產文的團隊來說,這次更新值得逐句讀完,因為它新增了一句過去從未出現在這份文件裡的要求:It is critical to manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing,發布前必須人工查證並審查所有 AI 生成內容的準確性與可信度,這一點至關重要。
單看字數,改動不大:一節裡插入三個句子、一句改寫、其餘原文不動。放進官方論述三年多來的演變脈絡,力道就不一樣了。過去官方談 AI 內容,主軸始終是無論內容怎麼產生,都以品質與使用者為先;這次把「模型不檢索事實、會產生幻覺、所以發布前必須人工查證」寫成環環相扣的因果句,還把中繼資料劃進同一套審查範圍。措辭從原則宣示走向操作要求。
這次到底改了什麼:三個新增句子與一次範圍改寫
這份指引的英文全名是 Google Search’s guidance on using generative AI content on your website,位置在 Google Search Central 開發者文件。更新前的版本頁腳日期是 2025 年 12 月 10 日 UTC;Wayback Machine 在 2026 年 9 月 27 日留下的快照保存了更新前的原文。兩相對照,變化全部集中在「Focus on accuracy, quality, and relevance」這一節。
先看這份文件的整體輪廓,才知道這次更新落在哪個位置。文件開頭就定位:無論內容怎麼產生,都應以服務使用者為本,並說明如何以符合 Google 政策的方式使用生成式 AI;中段劃出大規模內容濫用的紅線,並引用搜尋品質評估者指南的兩節標準;後段建議給使用者脈絡,說明內容如何產生,並另列電商網站的 AI 內容標示要求。這次新增的句子落在開頭的品質原則區,位置本身有訊息:查證不是附加在尾端的規則,是品質原則的一部分。
更新後的這一節,把機制說明、風險後果與查證要求串成了一段連續的論證。
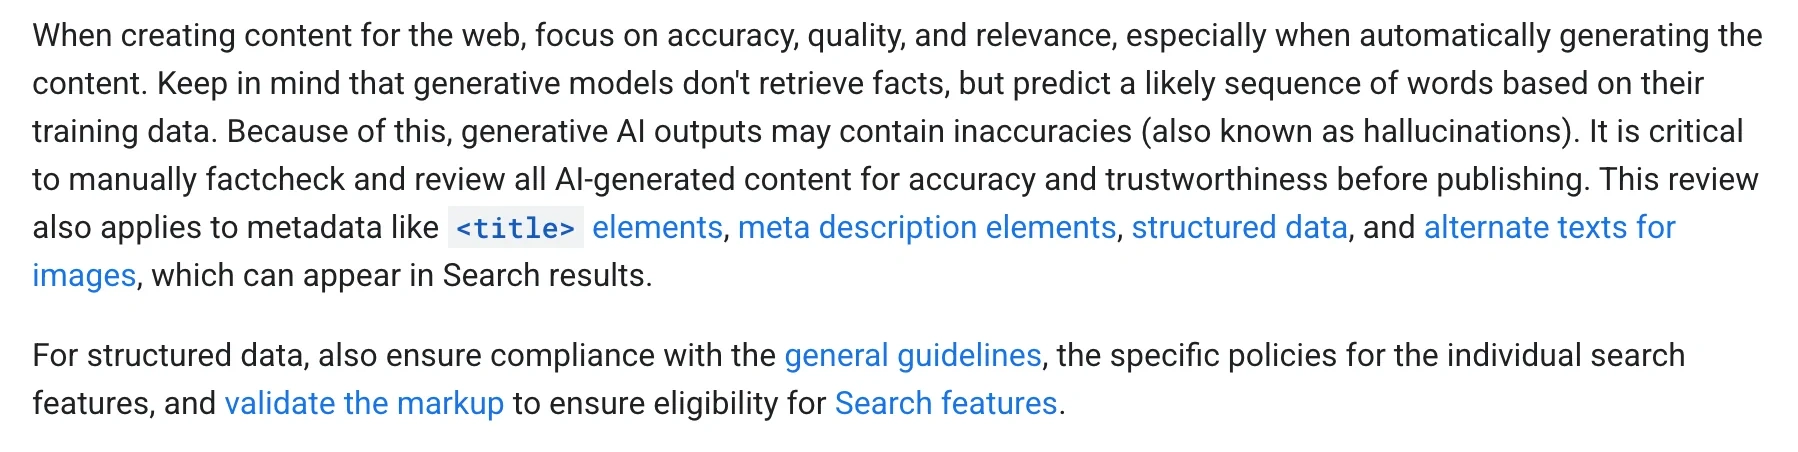
這一節更新後的完整中譯如下,關鍵詞保留英文原文:為網路創作內容時,專注於準確性、品質與相關性,尤其是自動產製內容的時候。要記得,生成式模型不檢索事實,而是依訓練資料預測可能的文字序列。因此,生成式 AI 的輸出可能包含不準確之處,也就是幻覺(hallucinations)。發布前必須人工查證並審查所有 AI 生成內容的準確性與可信度,這一點至關重要。這套審查也適用於中繼資料,例如 title 元素、meta description 元素、結構化資料與圖片替代文字,它們可能出現在搜尋結果中。至於結構化資料,還要確保符合通用規範與各搜尋功能的個別政策,並通過標記驗證,以確保取得搜尋功能的資格。
第一個新增是機制說明:生成式模型不檢索事實,而是依訓練資料預測可能的文字序列。第二個是後果:輸出可能包含不準確之處,官方直接用了 hallucinations 這個詞,也就是一般說的幻覺。兩句合起來,等於官方在文件裡承認 AI 生成內容的錯誤不是偶發意外,而是這種產製方式的固有特性。想深究幻覺的成因,可以從大型語言模型的原理與極限看起:模型最佳化的是下一段文字接得像不像,不是這句話是不是真的。搜尋、檢索增強生成(RAG)或外部工具可以提供來源,但有來源仍不代表引用與結論已核對正確。
從這個機制可以推出查證的優先順序。愈是需要精確檢索的主張,模型愈容易出錯:具體數字與統計、逐字引述、人名職稱、近期才發生的事件,都是幻覺的熱點,因為預測機制給得出「像真的」細節,給不出「是真的」保證。這是從機制推出的編輯判斷,但它直接決定審查力氣往哪裡花:可核對的事實主張逐條回源,整體敘述也要審查,避免把抽樣當成發布前查證的替代。
把機制寫進文件還有個附帶效果:查證要求被錨定在產製方式本身,而不是某一版模型的缺陷。模型換代可能降低出錯頻率,但只要產出文字的方式仍是預測,幻覺的可能性就會在,人工查證就不會因為「模型變強了」而變得多餘。這是從文件因果句推出來的編輯判斷,不過方向與官方措辭一致。
第三個新增是要求本身:It is critical to manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing。產業媒體 Search Engine Roundtable 率先報導這次更新時特別點出,這是該指引第一次用 critical 這個字眼要求人工查證。critical 在官方文件裡不是隨手可見的形容詞,它標示的是必要條件,不是加分項。
句子裡的 all 值得停下來看。它界定的是產製方式,不是生成比例:全文由模型直出、初稿由模型生成再改寫、或只讓 AI 補一段摘要與標題,只要內容是 AI 生成的,就在這句要求的射程內。對混合流程的團隊來說,這代表查證的單位不是「哪幾篇是 AI 寫的」,而是「哪幾個環節有 AI 介入」;介入多深,查證就相應排到哪裡。這是從措辭推出的讀法,方向與文件一致。
再把句子拆細一點,factcheck 與 review 是兩個動作。查證對的是事實主張:數字、日期、引述、因果,逐一回到來源核對。審查對的是整體:內容是否準確、是否值得信任,包括立場有沒有被證據支撐、語氣與證據是否相稱。官方把 accuracy and trustworthiness 並列,等於說兩種失敗都算數:講錯事實是一種,事實沒錯但整體誤導是另一種。manually 一詞則把責任放在人身上,用工具輔助查證沒有被禁止,但人工確認這一步無法外包,讓模型互相檢查不等於人工查證。
第四個變化是改寫而非新增。舊版寫 This includes metadata like <title> elements, meta description elements, structured data, and alternate texts for images,中繼資料被當成「專注於品質」原則附帶提到的一環;新版改成 This review also applies to metadata,直接把 title、meta description、結構化資料與圖片 alt 劃進「發布前人工查證與審查」的範圍。差別在義務的歸屬:以前中繼資料是品質建議的一部分,現在是查證義務的一部分。
對照更新前,同一節只有一段提醒,全文沒有出現人工查證的字眼。
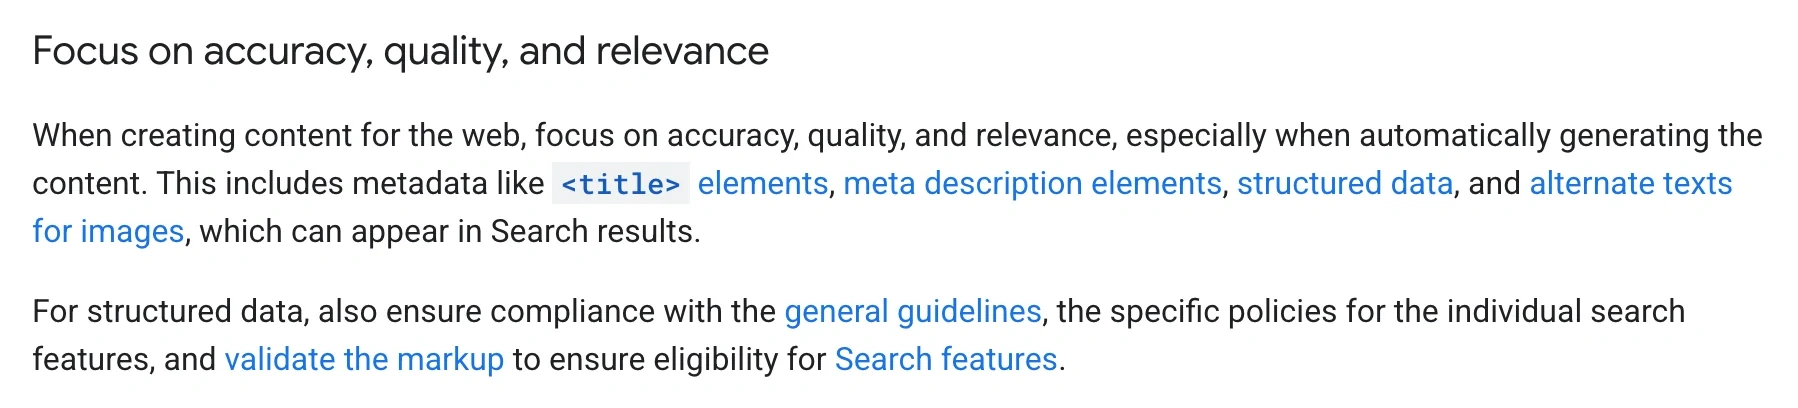
把兩個版本並列,變化的輪廓更清楚:
| 面向 | 更新前(頁腳 2025-12-10) | 更新後(頁腳 2026-10-01) |
|---|---|---|
| 模型機制說明 | 無 | 新增:生成式模型不檢索事實,依訓練資料預測可能的文字序列 |
| 幻覺警示 | 無 | 新增:輸出可能包含不準確之處(hallucinations) |
| 人工查證要求 | 無明文 | 新增:發布前必須人工查證並審查所有 AI 生成內容,官方以 critical 強調 |
| 中繼資料 | This includes metadata,屬品質原則的附帶範圍 | This review also applies to metadata,納入同一套人工審查 |
| 結構化資料合規與驗證 | 要求合規與驗證 | 不變 |
結構化資料合規與驗證的要求維持原樣,整個編輯動作相當外科手術:只強化查證與審查的框架,不動技術規格。這也暗示這次更新想處理的是態度與流程問題,不是技術標準問題。
還有一個細節:新版把「品質」從抽象原則接到可執行的動作上。舊版裡 accuracy、quality、relevance 是三個並列的名詞,至於怎麼達成,文件不展開;新版在名詞後面接了機制說明與查證要求,品質不再是形容目標的詞,而是有前置動作的工作項。對執行者的差別在於可驗收:原則進不了檢查表,動作可以。這節的淨效果可以一句話說完:文件把「用 AI 可以,但要有人對準確性負責」從隱含推論變成明文規定。
中繼資料納入同一套審查:四個最容易被漏掉的位置
對多數團隊來說,正文會有人看,中繼資料不一定。AI 產文流程常見的分工是:編輯逐段修正文,title 與 meta description 交給工具自動帶出,圖片 alt 交給上傳外掛批次生成,結構化資料由佈景主題或 SEO 外掛自動拼裝。這條生產線很順,直到有人在搜尋結果裡看到標題寫著內文沒有承諾的東西,或結構化資料裡的答案根本不在頁面上。
官方這次把話講明:這些中繼資料「可能出現在搜尋結果中」,所以與正文適用同一套人工審查。這四項也不是隨機清單,而是搜尋結果頁面的組成零件:標題與說明文字構成摘要,結構化資料驅動複合式結果,alt 支援圖片的理解與無障礙呈現。文件挑中的是介面層,錯誤會直接展示在使用者眼前。逐一拆開看,四個位置的風險樣態不一樣。<title> 是搜尋結果最顯眼的一行,AI 生成的標題常見毛病是過度承諾,把內文勉強支撐的小結論放大成斬釘截鐵的斷言:把單一研究講成普世結論、把統計相關講成因果、把預期講成保證,都是反覆出現的句式,「2026 最新」寫進標題、內文資訊卻停在舊版,則是常見的日期不實。meta description 的寫法不直接計入排名,卻可能成為使用者決定要不要點進來的說明文字,事實寫錯了,等於對還沒進站的使用者先說了一次謊。
中繼資料還有一個特殊性質:它是多數使用者接觸頁面的第一眼。正文裡的錯誤,要點進來才讀得到;title 或 meta description 裡的錯誤,在結果頁就攤在所有人面前,還會被搜尋功能與其他聚合場景引用使用。換句話說,中繼資料的錯誤暴露面比正文大,把它納入審查不是文書要求,而是風險排序的自然結果。也不必把查證和點閱率對立起來:標題與說明文字承諾得準,使用者帶著正確預期進站,體驗反而完整;敢下強標題的前提,是斷言先過了查證。可信與吸睛不衝突,衝突的是未查證的吸睛。
結構化資料的事實一致性更需要留意,因為它直接餵給搜尋功能。指引在這節保留的要求有三層:符合結構化資料通用規範、符合各搜尋功能的個別政策、通過標記驗證,以確保頁面取得搜尋功能資格。AI 生成的文章或商品標記如果包含頁面上不存在的資訊、錯的日期或錯的作者,問題不只是標記無效,而是對搜尋系統與使用者同時做出不實陳述,還可能連帶失去複合式結果的資格。
從常見欄位就能看出檢查量在哪裡:文章標記的發布日期與作者、商品頁的價格與供貨狀態,每個欄位都是對搜尋系統的具體陳述。Google 已在 2026 年 5 月停用 FAQ 複合式結果,6 月移除相關文件;保留 FAQPage 標記不能再被當成取得 Google FAQ 版面的做法,也沒有保證 AI 引用的效果。若仍使用問答標記,內容一樣要與頁面上的問答一致。
這裡要分清楚驗證與真實的差別。標記驗證檢查的是格式與資格:欄位齊不齊、語法對不對、有沒有違反功能政策。它不會告訴你答案是不是編出來的、日期是不是抄錯了。真實性這一關,文件把它交給人工審查,工具接手不了。
圖片 alt 是最常被批次流程略過的一項。alt 的原始用途是描述圖片內容,服務讀屏使用者與圖片載不出來的情境。AI 批次生成的 alt 常見兩種失效:一種塞滿關鍵字但沒有描述圖片,一種自信地虛構圖片裡不存在的細節。圖表類圖片還有第三種失效:alt 直接寫出圖上沒有的數字或趨勢結論,等於對看不到圖的使用者再多做一次不實陳述。三種都違背 alt 的目的,也都在這次的審查範圍內。
舉個假設情境說明縫隙在哪裡。模型替一篇搜尋動態文章生成了「某次垃圾內容更新影響超過六成網站」這句話,正文審查時因為查不到出處被刪掉了;但同一批生成結果產出的 meta description 與 FAQPage 標記裡還留著這個數字。頁面上讀不到的錯誤主張,就這樣留在中繼描述與機器可讀的標記裡。頁面本身看起來乾淨,錯誤卻從後門出貨。「審查也要套用到中繼資料」堵的正是這條縫。
這個情境帶出的原則可以講得更白:查證的單位是主張,不是文件。同一個主張出現在正文、meta description、結構化資料或 alt 的任何一處,標準都一樣;正文查過,不代表複製到標記裡就免檢,因為出錯的位置在結果頁,不在頁面正文裡。這也解釋了為什麼展示層的錯誤代價更高:使用者是帶著標題與說明文字的承諾點進來的,承諾落空比內容平庸更傷信任。
實際流程怎麼排,後面有完整建議;這裡先記住判斷原則:中繼資料是對搜尋系統與使用者做出的陳述,陳述就該被查證。這對搜尋工作還有一層意義:title、meta description 與結構化資料本來就是搜尋最佳化的操作範圍,這次更新等於把後設資料的最佳化與內容查證合流;把它們當純技術欄位塞字的時代,方向徹底反了。想把這種逐項校對內建成編輯紀律,可以參考從 Google 改寫自家文件的習慣整理出的精準編輯法,把每次更新都當成一次可追溯的修訂,而不是整包重貼。
官方怎麼定位這次更新:文件同步,不是宣布新政策
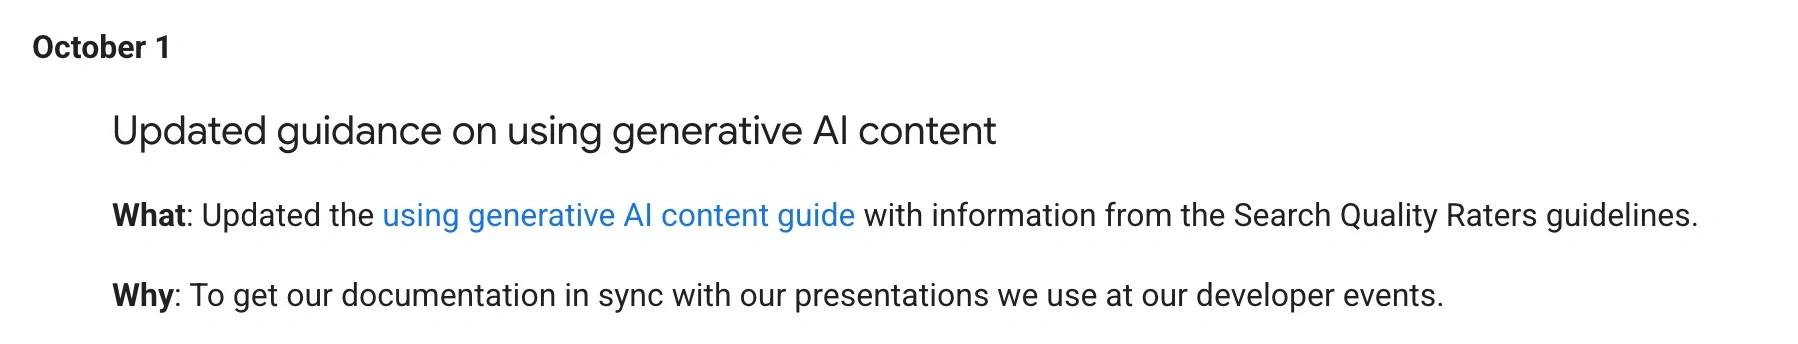
判斷一次官方文件更新的分量,先看官方自己怎麼說。Google Search Central 的更新日誌在 2026 年 10 月 1 日記了一筆:What 欄寫的是「把搜尋品質評估者指南的資訊,更新進生成式 AI 內容使用指引」,Why 欄寫的是「讓文件與我們在開發者活動上使用的簡報一致」。
這個定位必須如實理解:這是文件同步,不是政策發布。垃圾內容政策裡的大規模內容濫用條款早就存在,無論內容由人或機器產生,大量產製為操縱排名而非服務使用者的內容,本來就違反Search Essentials 的垃圾內容政策。官方日誌沒有宣布新增處罰或擴大執法範圍,做的是把散落在評估者指南與開發者活動簡報裡的要求,同步進網站經營者實際會讀的這份文件。
日誌的 Why 欄還透露一件事:這些內容 Google 早就在開發者活動上講過,文件是跟上簡報的腳步。這對解讀很關鍵。多數站方只看文件,於是容易把這次更新當成新訊號;但按官方自己的敘述,說法本身不新,新的是它第一次以文字形式放進人人都讀得到的指引,從口頭簡報變成可引用、可核對的標準。訊號強度其實提高了:口頭說過的話寫進文件,代表官方認為它該被當真。
評估者指南又是什麼?Google 聘請的搜尋品質評估者依照這份指南人工評估搜尋結果品質,評估者制度的公開說明寫得明白:評估者的分數用來評估搜尋系統整體表現,不直接改變個別網站的排名。這份指引引用了其中兩節:4.6.5 大規模內容濫用(scaled content abuse),以及 4.6.6「主要內容幾乎沒有付出努力、缺乏原創性或附加價值」。換句話說,Google 內部給評估者看的標準,與給網站經營者看的建議方向一致,這次只是把兩邊的文件對齊。內容可信度的實務補強,可以對照E-E-A-T 的經驗、專業與信任原則。
評分不直接影響個別排名,站方為什麼還要理會評估者標準?因為那是 Google 對「什麼是好內容」的操作化定義:評估者拿它評搜尋系統,文件同步它,站方等於第一次讀到同一套判準的站方版本。4.6.6 描述的「主要內容幾乎沒有付出努力、缺乏原創性或附加價值」,正是無人查證的規模化 AI 產文最常落入的樣貌;這次同步,等於把評估者觀察到的問題,翻譯成對站方的行為要求。這兩節的後果也不一樣:4.6.5 的濫用屬於政策違規,走垃圾內容的處理;4.6.6 的低價值屬於品質問題,影響的是內容在系統裡的評價。人工查證有助於降低事實錯誤,但仍要檢查原創性、附加價值與產製目的;只做查證不能讓大規模操縱排名的內容變成合規。
對「該多緊張」的判讀因此有兩面。不需要把這次更新讀成新的處罰訊號,官方日誌裡沒有任何執法動作;也不該因為「只是文件同步」就輕忽,文件措辭變得更具體、更強,代表 Google 認為這件事值得每個使用生成式 AI 的網站都知道。文件裡另一段「給使用者脈絡」的建議也維持原樣:主動說明內容如何產生,例如揭露自動化的使用方式;商品內容可對照 Merchant Center 對 AI 生成內容的政策,AI 生成圖片可用 IPTC 數位來源中繼資料標記來源。要注意的是,揭露與查證回答的是兩個不同的問題:揭露回答「內容怎麼產生的」,查證回答「內容是不是真的」,兩個都該答,答案不能互相替代。
政策脈絡:從 2023 年的立場到 2026 年的執法節奏
這份指引不是憑空出現的。Google 在2023 年 2 月的官方文章裡確立基調:無論內容如何產生,搜尋獎勵的是品質。這個原則貫穿至今,也是什麼是 SEO 的核心;差別在於 AI 產文規模化之後,原則必須落成更具體的要求。這份指引文件本身在 2025 年 5 月 21 日列入官方日誌,這次更新前的版本頁腳日期是 2025 年 12 月 10 日 UTC,媒體報導曾稱前次更新在 2025 年 10 月,精確的修訂史以官方日誌為準。
拉長時間看,官方對 AI 內容的論述走了三個階段。2023 年的文章處理資格問題:用 AI 生成內容本身不違規,搜尋看的是品質。2025 年上線的這份指引處理方法問題:怎麼用才符合政策,包括大規模濫用的界線與給使用者脈絡。2026 年 10 月的更新把方法再壓到動作層:發布前人工查證,範圍含中繼資料。問題一層層變具體,回答也一層層變得可執行。
2026 年的更新時程提供了另一層背景。8 月垃圾內容更新已於 8 月 21 日完成;9 月垃圾內容更新的時程與自查指南對應 9 月 24 日開始的更新。依 Google 官方狀態紀錄,截至 2026 年 10 月 3 日查閱時,尚未公告完成。這類更新處理垃圾內容系統,與核心更新的調整不同;10 月 1 日的文件修訂也不能直接當成針對特定 AI 內容的執法公告。Search Engine Roundtable 主筆 Barry Schwartz 在報導與 X 貼文中整理了這次指引變更。
Google updates the AI content guidelines to say you should "manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing"https://t.co/F0KgV2XO31
— Barry Schwartz (@rustybrick) October 2, 2026
同一篇報導裡,Barry Schwartz 推測指引更新的時間點與 9 月垃圾內容更新相鄰,可能不只是巧合。這是他的推測,官方日誌沒有把兩件事連在一起,閱讀時應該分清楚:文件同步是官方給的理由,時間相鄰是外界觀察到的現象,兩者可以並存,但只有前者有官方出處。他的搜尋動態整理影片也討論了 9 月垃圾內容更新,可作為產業觀察的補充。
時間相鄰不等於因果。官方沒有把這次文件更新與 9 月垃圾內容更新連結,也沒有公布 9 月更新專門針對某種 AI 內容。站方可以對照兩份文件檢查產製流程,但不應把流量波動直接歸因於這句新增的查證要求。
報導很快在產業媒體間擴散:Search Engine Land 跟進報導,Search Engine Journal 也做了整理,重點都放在「首次以 critical 要求人工查證」這個措辭變化。看報導有個提醒:只讀轉述、不讀原文,很容易把「文件同步」讀成「政策轉向」;並列新舊原文之後,變化的實際範圍其實很收斂。顧問圈的反應則是直接引用:資深 SEO 顧問 Glenn Gabe 把關鍵句原文一字不改貼上 X。
"It is critical to manually factcheck and review all AI-generated content for accuracy and trustworthiness before publishing." https://t.co/q7ZE40Ynks
— Glenn Gabe (@glenngabe) October 2, 2026
把視角拉回政策本身:垃圾內容政策的大規模濫用條款處理的是行為,大量產製操縱排名的內容;這份指引處理的是方法,用了 AI 之後,準確性與可信度要怎麼守。這條紅線比 AI 工具更早存在,AI 改變的是跨過它的成本,「大量」突然變得便宜了。政策對付的從來是規模化操縱,不是工具本身,這也是為什麼這次文件同步裡沒有出現任何新的禁止事項。兩者相加才是全貌:用 AI 產文沒有問題,用 AI 大量產製沒人查證、沒有附加價值的內容,才是政策與指引同時指住的目標。
把指引落成流程:發布前的人工審查怎麼排
指引寫的是要求,網站要自己把要求變成流程。有效的查證不是發布前才開始,而是從產製階段就留下可查的線索:餵給模型的素材標明出處、要求模型把沒把握的說法標記出來、草稿階段就記下每個事實主張的來源。等稿件到了發布前那一關,審查才有東西可對,而不是憑印象放行。
產製階段的紀律可以更具體。給模型的素材附上來源連結,要求答案只使用素材內的資訊;引述要逐字,數字要連單位、期間與分母一起記;模型主動補上的出處先當成未查證處理,因為編造一個看起來完整的引用,正是幻覺最典型的形態之一。這些要求不會讓產能歸零,卻能讓發布前的查證從大海撈針變成逐單核對。
所謂事實主張,範圍比想像中寬:數字與統計、日期與時程、人名與職稱、機構隸屬、價格與方案、法規狀態、因果關係的斷言,都算。正文之外,四個中繼資料位置要逐一過關。可以整理成一張發布前檢查表:
- 正文事實:數字、日期、引述、統計與因果關係逐條有出處;查不到出處的,改寫成有把握的說法或刪除
- title 與 meta description:與頁面內容一致,不含內文沒有的承諾或斷言,meta description 裡的數字與日期逐一核對
- 結構化資料:欄位與頁面事實一致,例如 FAQ 答案確實出現在頁面上、日期與作者正確;標記通過驗證,符合對應搜尋功能的個別政策
- 圖片 alt:描述實際圖片內容,不塞無關鍵字,不虛構圖中細節
- 揭露與授權:依網站政策說明產製方式,圖片與資料來源的授權正確無誤
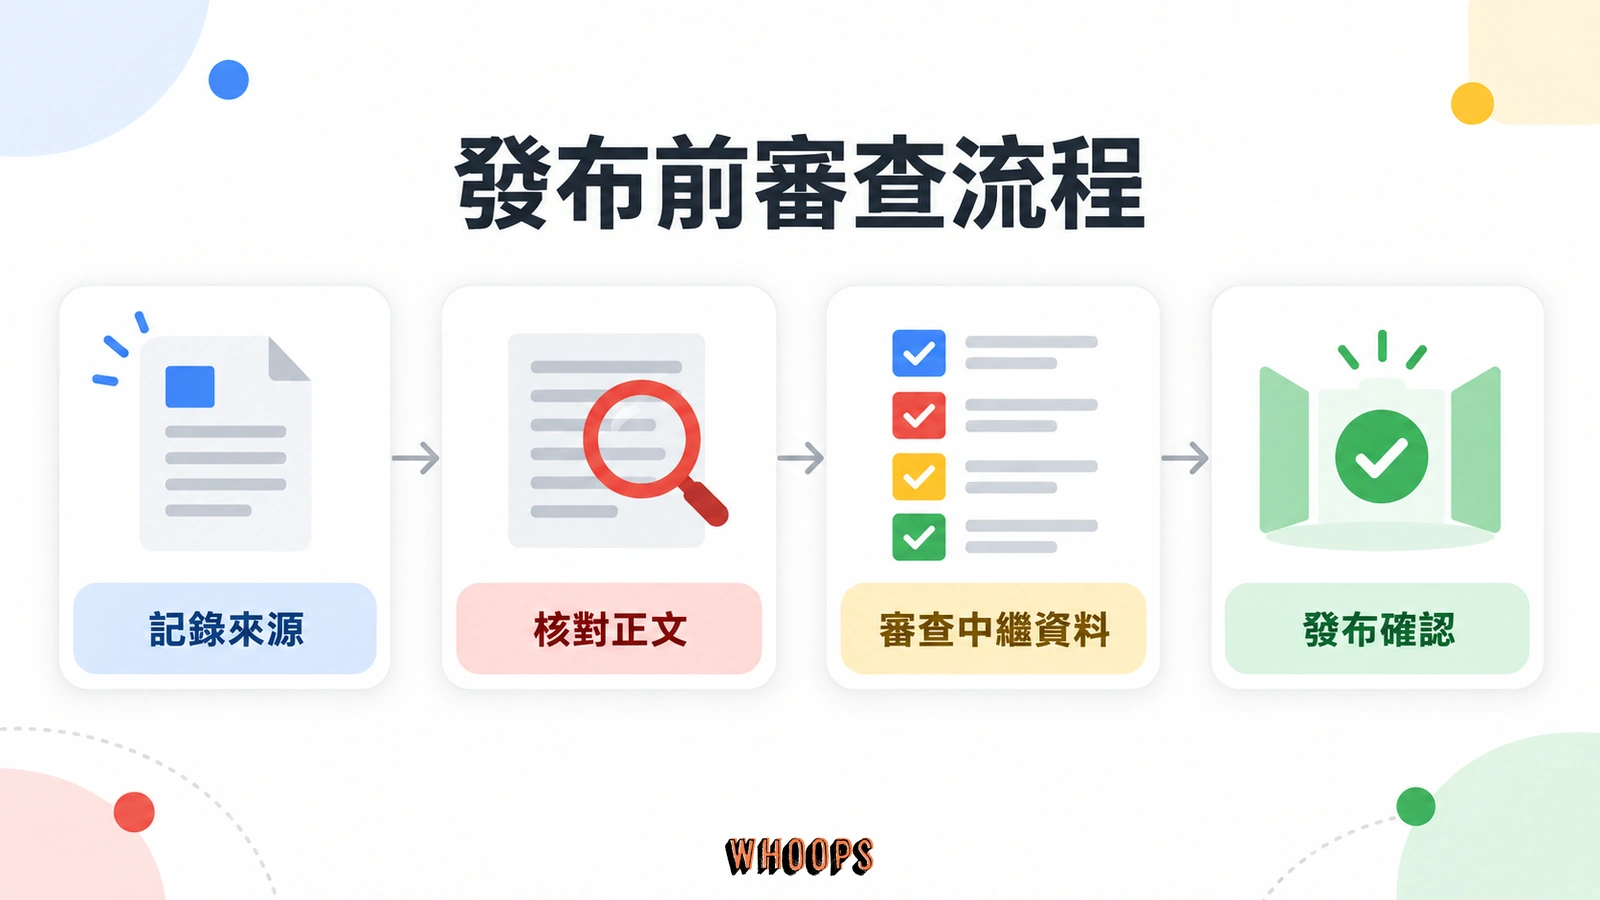
這張表不需要做成系統,表單或試算表欄位都夠用;關鍵是發布流程裡必須存在一道人工確認,而且確認範圍包含中繼資料。把它掛在流程上,而不是掛在個人的記性上,是查證能長期活下來的條件。
分工上,產文的人不一定是最合適的查證人。規模允許的團隊可以把生成與審查分給不同人;規模不夠,至少安排一趟只看事實、不管文筆的獨立過濾。查證的人如果同時在修句子,注意力會被風格問題吃掉,事實漏洞反而容易漏掉。用 ChatGPT 這類工具輔助關鍵字研究與初稿沒有問題,ChatGPT SEO 的完整教學整理過整套做法;工具提速多少,人工查證就該守多緊,這兩件事是綁在一起的。
再往細拆,流程裡可以有三道關:寫手交稿時附上每個主張的出處,編輯做一趟事實過濾,發布者按表列四項過中繼資料。小團隊一人分飾三角時,至少要做到換關卡換檢查表:同一次掃讀很難同時兼顧句子通順與數字正確,分開跑兩趟短查,比混在一趟長掃裡漏得少。
效率與嚴謹可以並存,關鍵是把查證分級。可變動的資訊,例如價格、額度、方案內容、活動時程,發布前重查當前值,因為舊查證會過期;穩定的事實,例如歷史事件、原理說明,查證一次後記下出處與查閱日期,下次改版只需複查結論有無翻案。時效性內容也適用同一條紀律:寧可慢半小時把數字查明,不要帶著錯的數字搶快。這套分級讓查證成本集中在真的會出錯的地方,而不是每個字重看一遍。
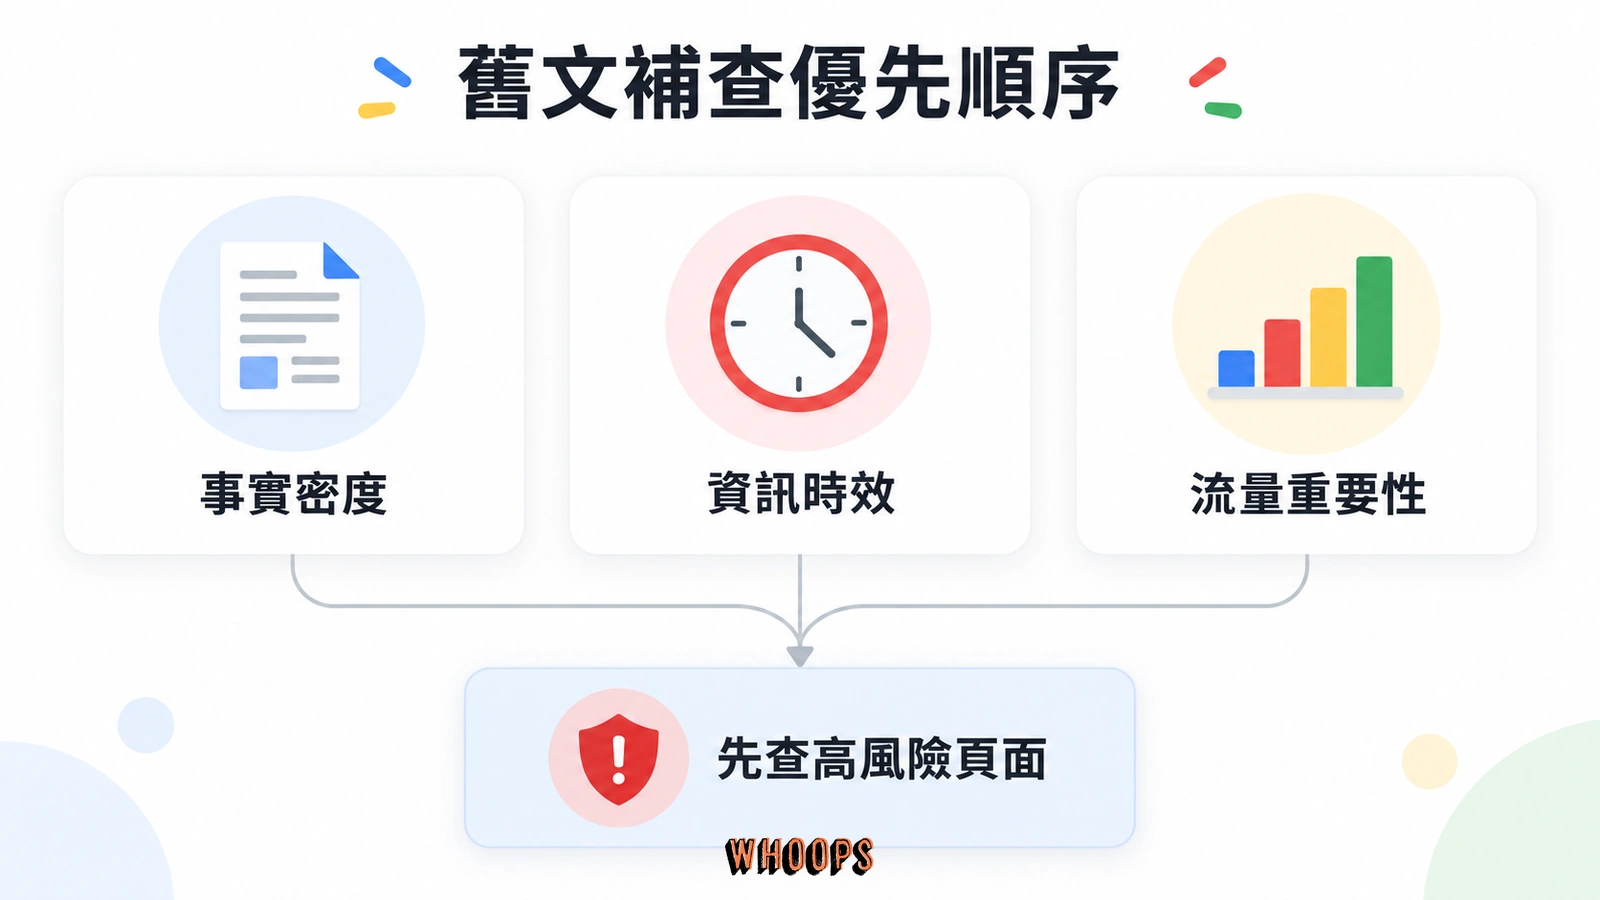
舊文的補查可以用同一套邏輯排序:事實密度高、流量依賴重、時效敏感的頁面先動,其中又以會出現在搜尋結果裡的陳述優先;title、meta description 與結構化資料的性價比最高,因為修正它們同時降低展示層的錯誤暴露。查證記錄留檔也是同一關的延伸:每個主張記下來源連結與查閱日期,改版時只複查出處是否翻案,爭議發生時才有得回溯。
內容上線後,再將流量與索引狀態的變化放回演算法與垃圾內容更新的背景判讀。8 月更新已完成,9 月更新截至本次查閱仍未公告結束,單日波動不足以判定原因。Search Console 若列有人工處置,可依人工處置的辨識、清理與重新審查流程處理;沒有人工處置通知,也不能排除自動系統的影響。
流程跑起來之後,怎麼知道它有效?幾個輕量指標就能看趨勢:抽樣覆核的錯誤率、檢查表的完成率、發布後七天內的事實修正次數。數字不需要複雜工具,重點是讓查證從「有做」變成「看得到」,因為看不到的流程,通常是第一個被產能壓力犧牲的。
視野再拉遠一點。Google 另有一份針對生成式 AI 搜尋的最佳化指南,談內容在 AI 搜尋場景裡如何被看見與引用;AI SEO 的做法與成效量測提供同一條線的實務框架,AI 搜尋怎麼挑來源可以看ChatGPT 搜尋的信任圈分析,AEO、SEO、GEO 的分工差異有概念解析,Google 端也有偏好來源這類新機制在演進。這些發展都建立在同一個前提上:內容本身經得起查證。一個經不起查證的頁面,談再多最佳化都是空的。
這次更新沒有改變規則,只是把規則寫得更難錯過。AI 產文的產能優勢是真的,幻覺風險也是真的,中間的橋樑就是人工查證的紀律:查證範圍畫到中繼資料,查證動作排進發布前,監測接在發布後。把這三件事做掉,指引的要求就落地了。至於 AI 時代裡搜尋工作者的位置,SEO 會被 AI 取代嗎的答案,剛好也落在同一條判斷線上:被放大的是產能,被要求的判斷,從來沒有便宜過。
常見問題
Google 這次是宣布新的垃圾內容政策嗎?
不是。官方更新日誌把這次變更定位為「把搜尋品質評估者指南的資訊同步進文件」,目的是讓文件與開發者活動的簡報一致。垃圾內容政策本身沒有修改,大規模內容濫用的定義與處理方式都維持原樣。這次更新改變的是指引的措辭與明確程度,不是政策範圍。
Google 禁止網站使用 AI 生成內容嗎?
沒有禁止。這份指引開宗明義就說明如何「以符合 Google 政策的方式」使用生成式 AI 內容,官方立場自 2023 年以來一致:無論內容如何產生,搜尋獎勵的是品質。會違規的是大量產製為操縱排名而非服務使用者的內容,與產製工具是否為 AI 無關。
人工查證的範圍包含哪些中繼資料?
指引明列四項:<title> 元素、meta description、結構化資料與圖片 alt 文字。官方的理由是這些資訊可能出現在搜尋結果中,因此與正文適用同一套發布前人工審查。結構化資料還要額外符合通用規範、各搜尋功能的個別政策,並通過標記驗證。
不做人工查證會被 Google 處罰嗎?
指引本身不是處罰工具,官方也沒有隨這次更新宣布執法行動。實際風險走兩條路:內容若構成大規模內容濫用,適用既有垃圾政策的處理,可能觸發人工處置或搜尋可見度下降;內容若充斥錯誤資訊,傷害的是品質評估與使用者信任。查證是降低這兩類風險的方法,不是新的申報義務。
什麼是幻覺(hallucinations)?
幻覺指生成式模型產出看似流暢合理、實際上與事實不符的內容。模型本身依訓練資料預測文字,不等於已核對事實;即使工具提供檢索來源,仍可能出現引用錯誤或錯誤推論。因此,發布者仍要核對事實與來源。
這次更新和 2026 年 9 月的垃圾內容更新有關嗎?
時間上相鄰,但官方沒有把兩件事連結。9 月垃圾內容更新自 9 月 24 日開始,截至 10 月 3 日查閱仍未公告結束,10 月 1 日指引在此期間更新;Search Engine Roundtable 的 Barry Schwartz 推測時間點可能相關,這屬於外界觀察,官方日誌只載明文件同步的目的。讀的時候把官方理由與外界推測分開即可,不需要自己補上因果。
已經發布的 AI 內容需要回頭全部查證嗎?
指引規範的是發布前的行為,沒有要求回溯清理。實務上可以依風險排序補查:事實密度高、流量重要、近期本來就要更新的頁面優先,檢查時把 title、meta description 與結構化資料一併看過。這是編輯判斷,不是官方要求。
圖片 alt 文字也要人工查證嗎?
要。指引把圖片 alt 列入人工審查適用的中繼資料,理由同樣是它可能出現在搜尋結果中。AI 批次生成的 alt 常見兩種問題:塞滿關鍵字但沒有描述圖片,或虛構圖片裡不存在的細節,兩種都在查證範圍內。alt 應該忠實描述實際的圖片內容。
結構化資料的查證具體要驗什麼?
三件事:欄位內容與頁面事實一致,例如 FAQ 標記裡的答案要真的出現在頁面上、日期與作者要正確;標記本身通過驗證;符合結構化資料通用規範與目前仍支援的搜尋功能個別政策。不合規或無效的標記,可能讓頁面失去取得搜尋功能的資格。
在頁面上揭露內容由 AI 生成,是不是就不用查證了?
不是,兩件事互相獨立。揭露的目的是給使用者脈絡,說明內容如何產生;查證的要求針對準確性與可信度。指引在「給使用者脈絡」一節建議主動說明產製方式,但揭露不能替代查證,查證也不能替代揭露。
遵守這份指引會讓排名變好嗎?
指引不是排名保證,官方也沒有承諾遵守指引會獲得特定排名或在 AI 搜尋中被引用。它的直接作用是降低內容出錯與違反政策的風險;排名由內容品質、相關性與整體政策遵守情況共同決定。把查證當成品質流程的一環,比當作排名開關更符合這份文件的定位。
人工查證怎麼做才不會拖垮產能?
把查證分級並往前挪。產製階段就記錄每個事實主張的出處;可變動資訊如價格、額度、時程,發布前重查當前值;穩定事實查證一次後記下出處與查閱日期,改版時只需複查有無變動。審查時安排一趟只看事實、不管文筆的獨立過濾,注意力才不會被風格修改分散。


討論與提問