
本篇內容
你用手機讀得到小島「初學者吉他課」,搜尋工具打開同一頁,卻可能只看到登入畫面。讀者能看,不代表工具也拿得到正文。
在選定的公開頁面挑一句正文,分別查讀者和搜尋工具能否讀到。小島原句是:「沒有吉他也歡迎來試上,我們可以協助安排。」預約確認、借用範圍和準備規則都還沒寫。缺的答案留在改稿清單,這次查的是工具有沒有讀到已有的文字。
寫文章的人先做下面的公開頁閱讀與連結檢查,結果記進檢查表。有 Search Console 查看權限,再查 Google 取得的內容;後半章的程式碼與設定,留給查到問題時和網站維護者一起看。
先用沒登入的視窗讀一次
在 Chrome 開無痕視窗,Windows 用 Ctrl + Shift + N,Mac 用 Command + Shift + N,把課程頁完整網址貼進網址列。首頁能開,不代表這篇也能開。
- 看最後停在哪裡:課程頁、首頁,還是登入頁?
- 找到那句正文,選取後複製到工作單,核對文字是否完整。練習別的網站,就選它已有的一句說明。
- 從首頁或選單找到這篇,再點開相關指南與詢問入口,記下哪個入口找不到或去了別頁。
- 用手機讀一次,看看按鈕是否蓋住文字,表格裡的條件是否看得完整。
重要說明如果只放在圖片裡,就記下要補文字的位置。看得到「歡迎來試上」,卻找不到借琴條件,要補內容;連這句已寫好的正文都讀不到,才查是什麼擋住讀取。
讀到頁面、放進搜尋、被 AI 引用,是不同的事
一本書放在圖書館,不等於已登進查詢目錄,更不等於有人寫報告時引用了它。網站也要分開看這幾件事:
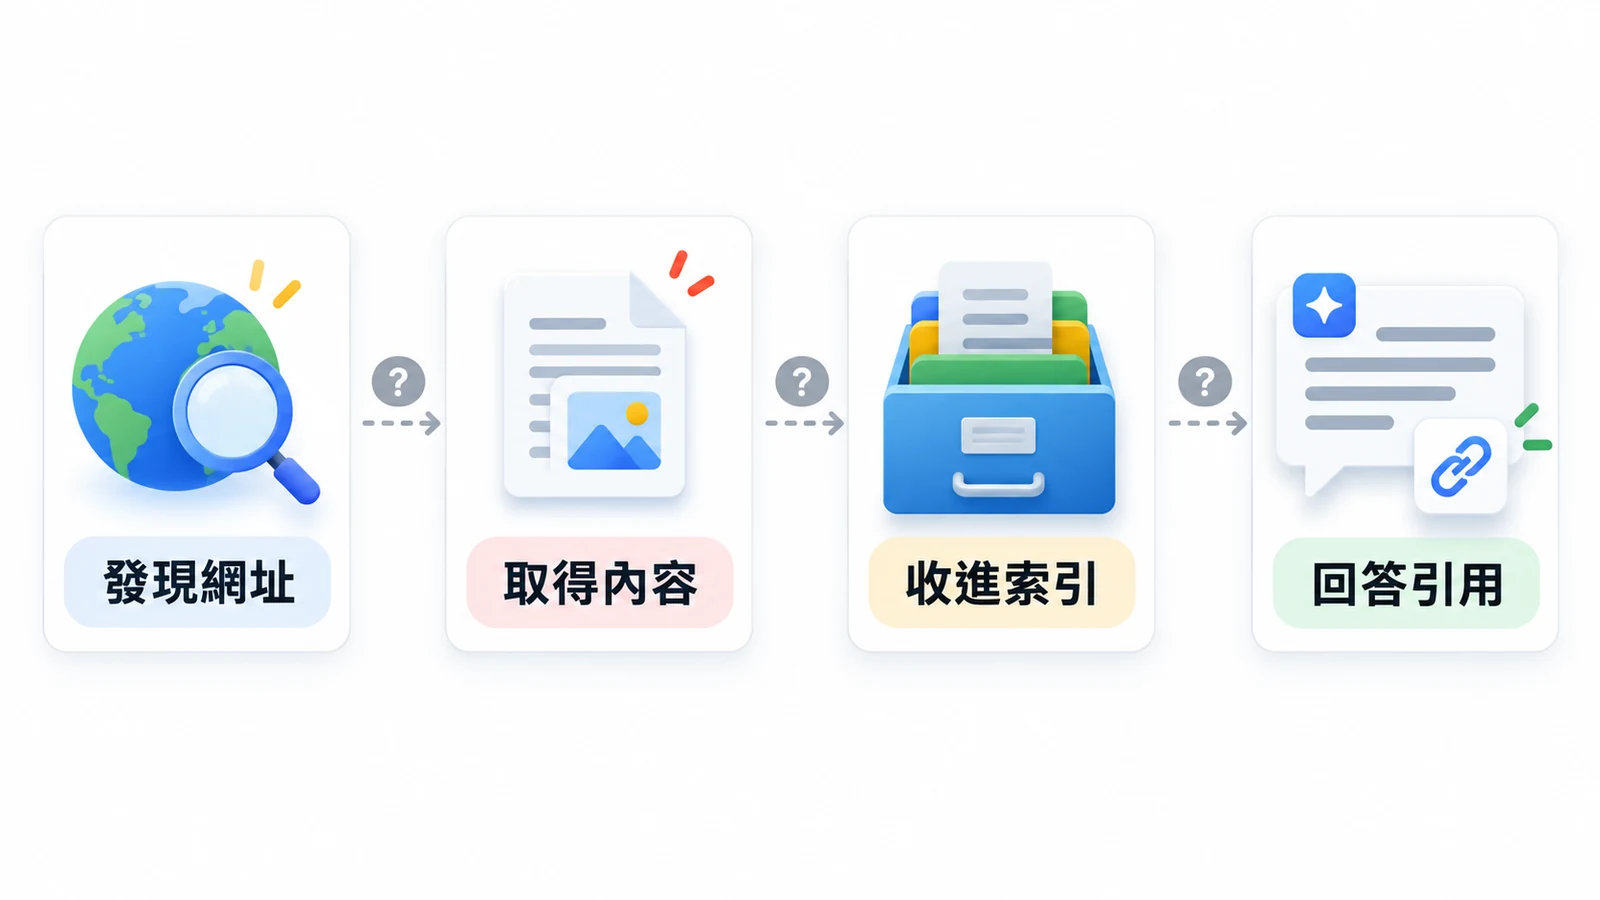
| 發生什麼事 | 網站上對應什麼 |
|---|---|
| 知道書在哪裡 | 搜尋工具發現網址,站內連結可以提供路線 |
| 拿到書的內容 | 工具取得頁面,叫「抓取」 |
| 登進查詢目錄 | 搜尋系統把頁面放進可查的資料庫,叫「索引」 |
| 報告用這本書作依據 | AI 回答使用文章資訊,並附上來源連結 |
手機能讀到,表示讀者這一邊通過了檢查。Google 是否抓到、是否放進索引,得查它的紀錄;AI 有沒有引用,則要打開實際回答看來源。
Search Console 的資料需要有查看權限的帳號才能讀。沒有權限,就在下面的檢查表將這兩項結果填「尚無權限查看」,請站主提供資料。現在仍可把公開頁閱讀結果記好,接著去第 5 章改稿。
有查看權限時,比對 Google 的已抓取資料與即時測試
Search Console 是 Google 的網站檢查工具,能查看先前抓到的資料,也能現在重讀一次。兩份資料裡的 HTML 是描述網頁內容的程式碼。這次只找剛才選的正文句子,看看 Google 有沒有拿到它。
取得 HTML 後,可把內容存成或複製到文字文件。Windows 按 Ctrl + F,Mac 按 Command + F,貼上要找的句子。整句找不到,再找其中一小段文字,HTML 標記可能把句子隔開。用有權限的帳號打開 Search Console,查同一個完整網址:
- 在左上方的網站下拉選單,選包含課程頁的資源。「資源」(property)是帳號已加入的一個網站或網址範圍。
- 在頂端的網址檢查欄貼上課程頁完整網址,按 Enter。不要只填首頁或
/courses/beginner-guitar/。 - 展開
Page indexing(網頁索引),保存畫面顯示的索引狀態與Last crawl(上次抓取時間)。 - 在索引結果開啟
View crawled page,查看HTML,找剛才保存的原句。記下實際取得的文字與檢查時間。沒有這個入口或拿不到 HTML,就填「已抓取版本內容未確認」。 - 按
Test live URL(即時測試)。確認正在看Live Test,開啟本次測試的頁面詳細資料(View tested page),在HTML找同一句文字。成功取得時也可看Screenshot(畫面截圖)。
View crawled page 顯示先前抓取的 HTML,即時測試則現在重新取得頁面。不是每個網址都能查看已抓取資料,拿不到就記為未確認。
Last crawl 只告訴你上次何時抓取,不會告訴你讀到了哪句話。要比較正文,得保存實際取得的 HTML 文字。
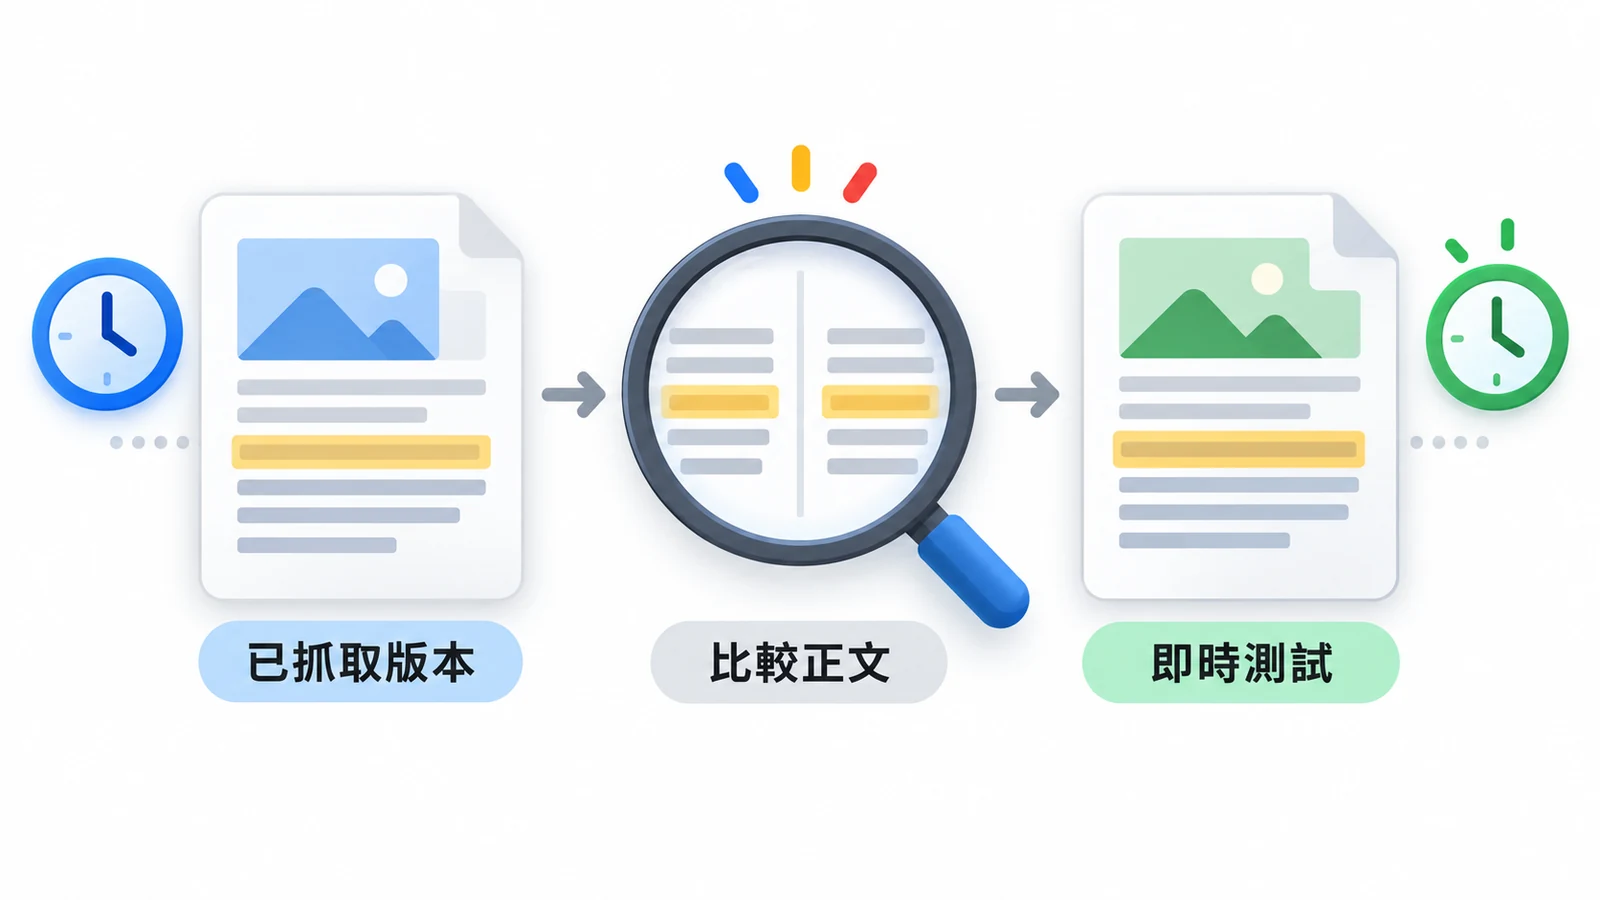
| 你拿到的結果 | 可以怎麼記 |
|---|---|
| 已抓取 HTML 與即時測試都有原句 | 兩份取得的內容都有原課程說明,仍缺借琴條件 |
| 之後改頁時,已抓取 HTML 有原句,即時測試有改後句 | 已取得兩份不同內容,保存各自的原文 |
| 即時測試有正文,但拿不到已抓取 HTML | 目前可讀;Google 已抓取版本的內容未確認 |
| 只有索引狀態與抓取時間 | 已保存索引欄位,尚未確認正文版本 |
即時測試讀得到內容,頁面仍可能沒有被索引或引用。遇到「已抓取,尚未索引」,保存訊息原文,再請維護者查正文、重複內容與站內入口。
找不到網站或看到權限訊息,就記下畫面提示。自己管理網站但還沒加入資源,可以照 Google 加入網站資源說明設定,或請已驗證的站主授予權限。
用你選的頁面,完成一張檢查表
把剛才看到的結果放進同一張表,沒查到的資料也記下來:
| 用什麼工具 | 查什麼 | 看到什麼 | 接著做什麼 |
|---|---|---|---|
| Chrome 無痕視窗 | 課程頁與原句 | 網址未跳走,可複製「沒有吉他也歡迎來試上,我們可以協助安排。」 | 保存原句與畫面,列出借琴答案缺什麼 |
| 網站選單與連結 | 能否走到課程頁及詢問入口 | 記下點哪段文字、最後到哪頁 | 找不到時,記插入位置或錯誤網址 |
| Search Console 索引結果 | 狀態及已抓取 HTML | 保存狀態;HTML 有取得就抄相關句子,否則填版本未確認 | 請站主或維護者提供缺的資料 |
| Search Console 即時測試 | 當下能否取得正文 | 保存工具訊息與 HTML 原句 | 讀不到時,按下方對應問題往下查 |
把表放進工作單,每筆寫上日期、完整網址,以及截圖或文字存在哪裡。
表裡要看得出哪個工具讀不到哪一頁、哪一句,以及還缺什麼資料。有人修好後,用原工具查同一網址,把新結果放在舊結果旁。
查到問題後,再讀相應的技術段落
完成上面的檢查表,就可以帶著缺的答案去第 5 章改稿。下列技術內容依遇到的問題選讀,維護者可以照結果查設定:
| 你遇到什麼 | 去看下方哪段 |
|---|---|
| 頁面打不開,或搜尋工具收到不同內容 | 查網站回應 |
| 要確認有沒有阻擋抓取或索引的設定 | 看 robots.txt 與 noindex |
| 手機有文章,但工具取得的 HTML 沒正文 | 查文章載入方式 |
| Google 選了另一個主要網址 | 核對主要網址設定 |
| 已索引,要查 Google AI 的其他納入條件 | Google AI 納入條件 |
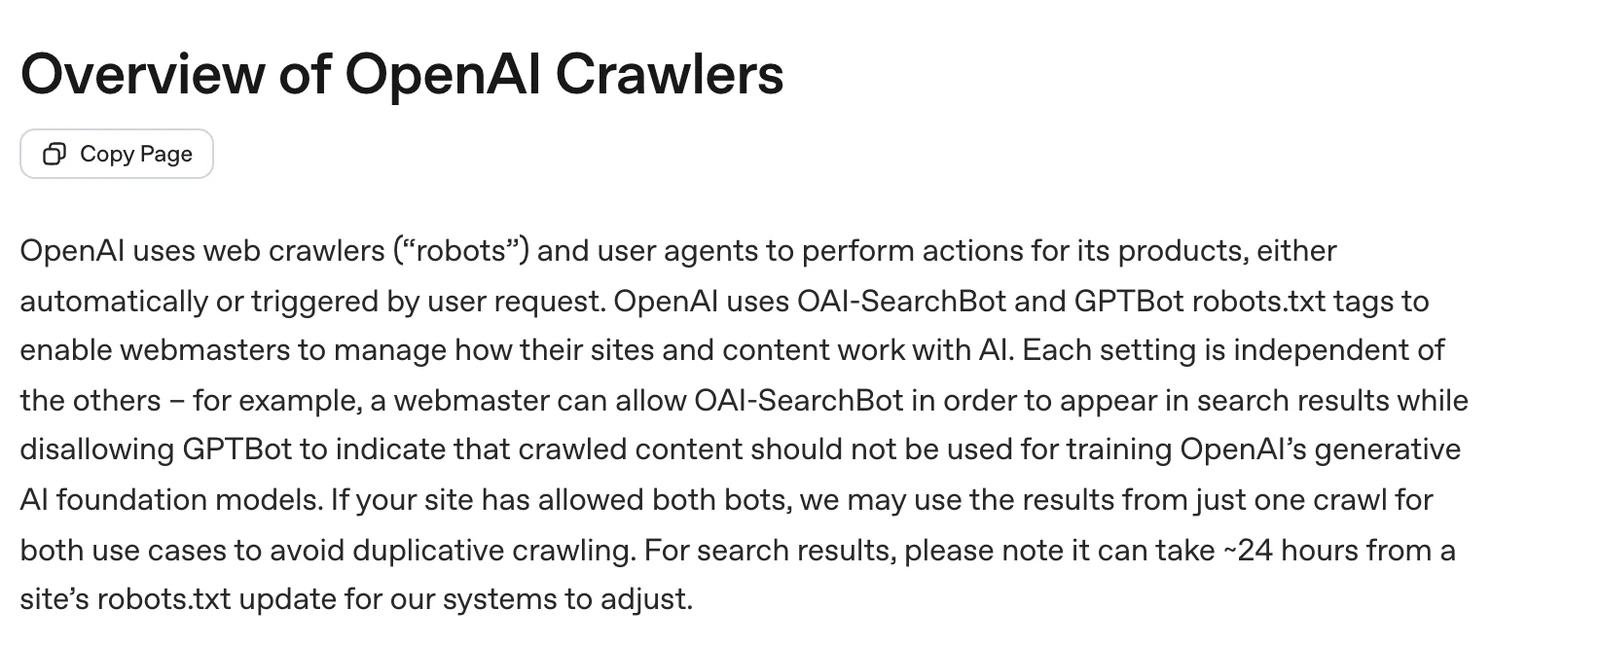
| 要分清 ChatGPT 搜尋與模型訓練的網站請求 | 先分清工具用途 |
打不開,或工具收到不同內容:查網站回應
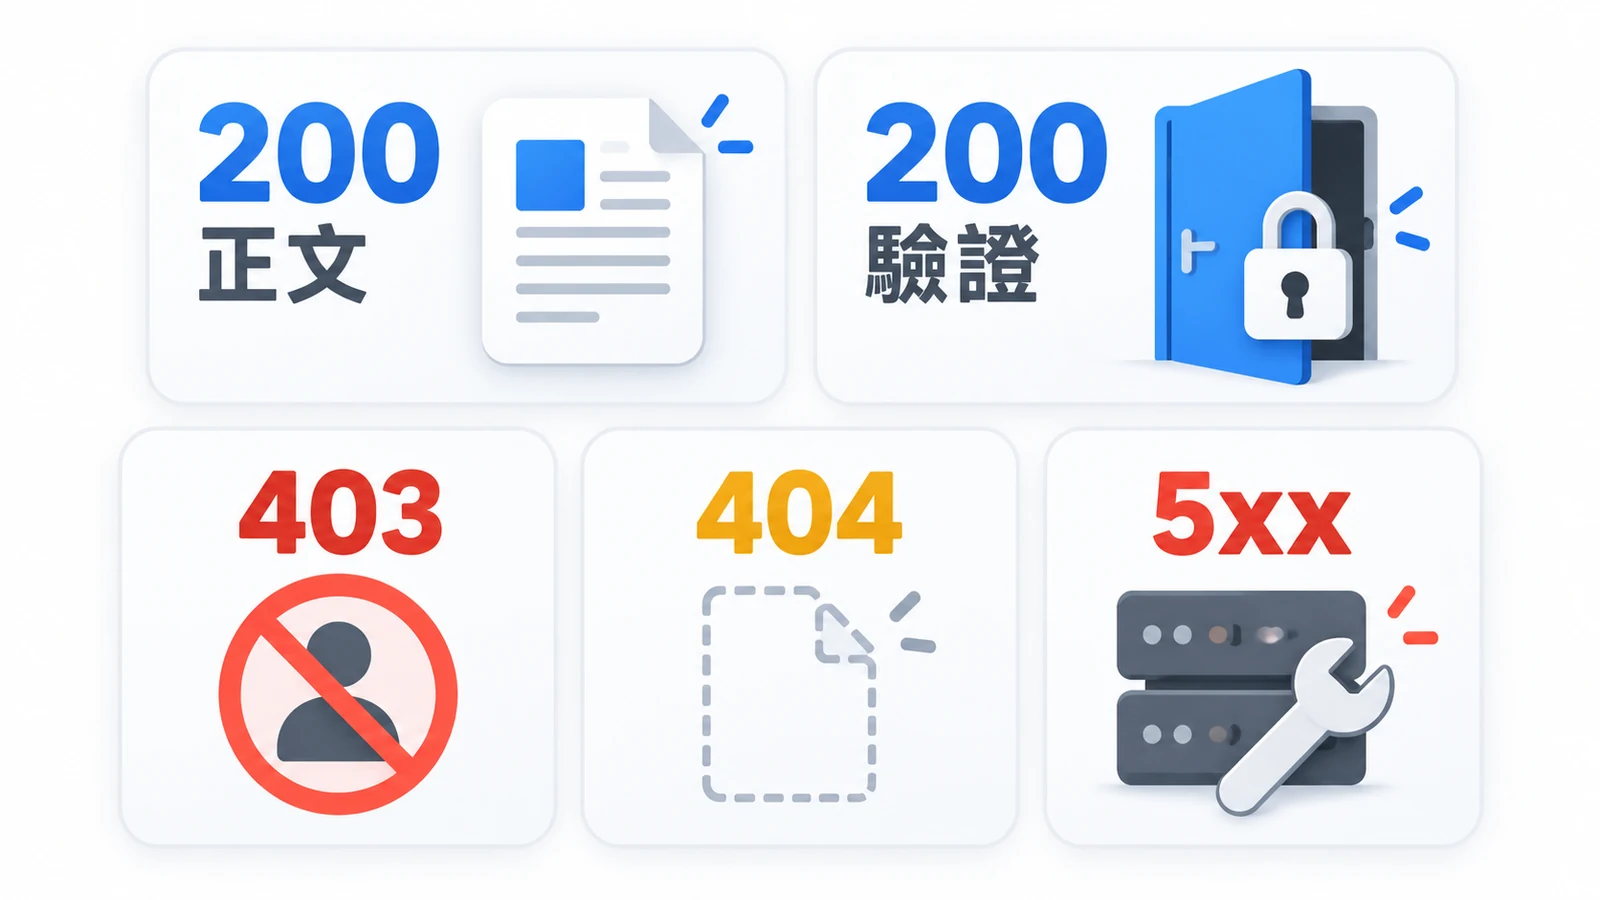
瀏覽器向網站要資料,網站會回覆狀態碼,告訴你這次請求的結果。這套交換方式叫 HTTP。代碼就像領件時得到的回覆:「拿到了」「拒絕領取」「找不到」。
| 狀態碼 | 網站在說什麼 | 管理者接著查什麼 |
|---|---|---|
| 200 | 這次請求成功 | 交出的是否為正確正文 |
| 403 | 拒絕存取 | 哪條防護或權限規則擋住請求 |
| 404 | 找不到 | 網址是否正確,文章是否搬走 |
| 500 等 5xx(後面兩個數字可以不同) | 提供網頁的電腦(伺服器)出錯 | 當時哪個服務故障 |
Google 的最低技術條件是:Googlebot 能進來、網站回傳 HTTP 200,而且文字格式是 Google 能讀的,內容也不違反它的垃圾內容政策。Googlebot 是 Google 讀網頁的自動工具;符合條件後,Google 仍會決定是否把頁面放入索引。
看到 200(成功)狀態碼,還得讀內容。網站可能成功回覆了「請完成驗證」,卻沒有交出正文,就像領到包裹,裡面不是你要的講義。
網站回覆時會附帶一些資訊,叫作「回應標頭」,有些搜尋設定就放在這裡。下面從狀態碼和正文查起,再看這些設定。
瀏覽器每向網站要一份資料,就送出一次請求。一頁可能需要文字、圖片等許多資料,Network(網路紀錄)會列出面板開著時送出的請求,所以清單通常不只一筆。在 Chrome 開啟開發人員工具,可以照下面步驟查自己收到的狀態碼:
- 打開課程頁,從右上角選單進入
More tools > Developer tools(更多工具 → 開發人員工具),選Network。 - 保持這個面板開著,重新整理課程頁,按
Doc篩選網頁文件。 - 點選列表中一筆網頁文件,在
Headers(標頭)的General(一般資料)核對Request URL(請求網址)。如果不是課程頁完整網址,回到列表換一筆;確認是選定頁面後,再讀Status Code(狀態碼)。 - 切到
Response(回應內容),搜尋剛才選的正文句子,把結果和時間記下來。
這裡查到的是你的瀏覽器收到的內容。Google 收到什麼,要回到 Search Console 即時測試,在本次測試的頁面詳細資料裡,從 More info 查看回應標頭等資料。瀏覽器收到 200,還不能證明搜尋工具也讀得到;Network 面板顯示的是這次瀏覽器請求的回應資料。
讀者能看、搜尋工具卻收到 403 時,請管理者按檢查時間找防護紀錄。網站可能使用 CDN,也就是替網站分送內容的服務,阻擋規則可能設在那裡。找出擋住這篇文章的規則後,再處理它。
維護者修好後,仍用原本失敗的工具查同一個課程網址,核對狀態碼和那句正文。工具、頁面和句子都相同,才比較得出問題有沒有解決。
已能取得頁面,仍要查搜尋限制:看 robots.txt 與 noindex
這兩種搜尋指示,控制的是不同步驟:
| 指示 | 意思 | 在哪裡找 |
|---|---|---|
| robots.txt | 指定哪些路徑可以抓取 | 網站的抓取規則檔 |
| noindex | 請搜尋系統不要把這頁放入索引 | 頁面程式碼或回應標頭 |
robots.txt 控制能不能抓取內容,像「這個房間別進去」,管能不能拿書;noindex 像「這本別登進目錄」,管會不會列進目錄。分開查,才知道工具卡在哪一步。
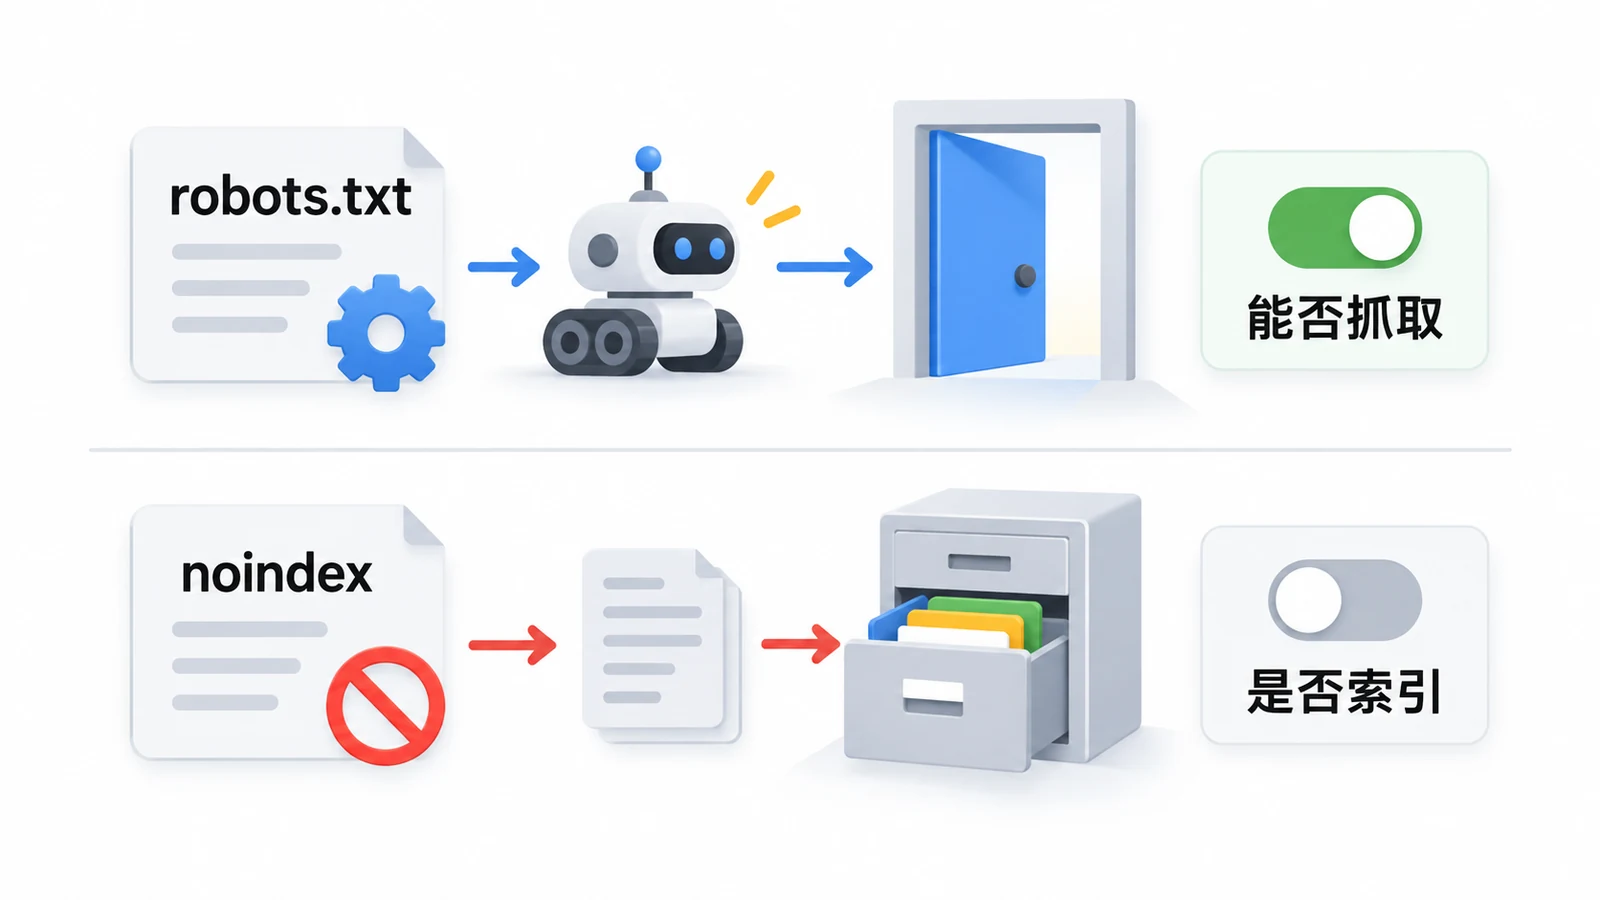
robots.txt 通常可以直接用瀏覽器讀。假設課程頁是 https://example.com/courses/beginner-guitar/,規則檔的完整地址就是 https://example.com/robots.txt。規則檔放在網站網址的起點,這個位置叫網站根目錄。用自己的網址時,這樣找:
- 從完整頁面網址的
http://或https://後開始,找接下來第一個/。 - 保留這個
/前的所有文字,不改動任何字元。 - 把從這裡起的頁面路徑換成
/robots.txt。 - 把改好的網址貼進瀏覽器,保存看到的規則內容或畫面訊息。
檔案裡有多組工具名稱或路徑,看不出哪條影響課程頁,就把內容交給維護者,對照 Google 的robots.txt 位置與規則核對。
noindex 可能寫在 HTML 裡,看到下面一行就代表要求不要索引:
<meta name="robots" content="noindex">在 Chrome 打開課程頁後,用檢視網頁原始碼的快捷鍵:Windows 按 Ctrl + U,Mac 按 Command + Option + U。再按 Ctrl + F(Mac 用 Command + F)找 noindex。找到時保存包含它的完整標記;這個字也可能出現在說明文字裡,要看是否真的寫在 robots 等索引指示中。
另一個位置是「回應標頭」。先照前面「查網站回應」的操作開啟 Network,選課程頁那筆請求,在 Headers > Response Headers 找 X-Robots-Tag,看看值裡有沒有 noindex。Google 說明,noindex 也能放在回應標頭裡;原始碼沒找到,不代表標頭也沒有。兩處都記下結果,複雜設定交給維護者判讀。
課程頁如果在開發時加了 noindex,上線後要確認是否仍需要。公開課程說明希望讓人搜尋到,私人紀錄則要限制存取,管理者得按每頁用途設定。
Google 要先讀得到頁面,才看得到 noindex。若 robots.txt 同時要求別抓這頁,就像在門口寫著別進去,又期待館員看到房內的紙條。要移除或恢復搜尋內容,請管理者一起安排抓取與索引設定。私人資料用登入和權限保護;robots.txt 與 noindex 管理的是搜尋工具,無法代替這些保護。
手機有正文,取得的 HTML 卻沒有:查文章載入方式
有些網頁一開始就交出完整文字,有些只先交出外框,再用 JavaScript 把文章填進去。將資料和程式處理成能閱讀的頁面,叫「渲染」。
想像先拿到一張空白課表,老師稍後才填上各節課;你在填寫前後查看,讀到的內容就不同。
前面的「已抓取資料/即時測試」比的是上次與現在。這裡則看同一次讀取:一開始有沒有正文,執行 JavaScript 後又有沒有?
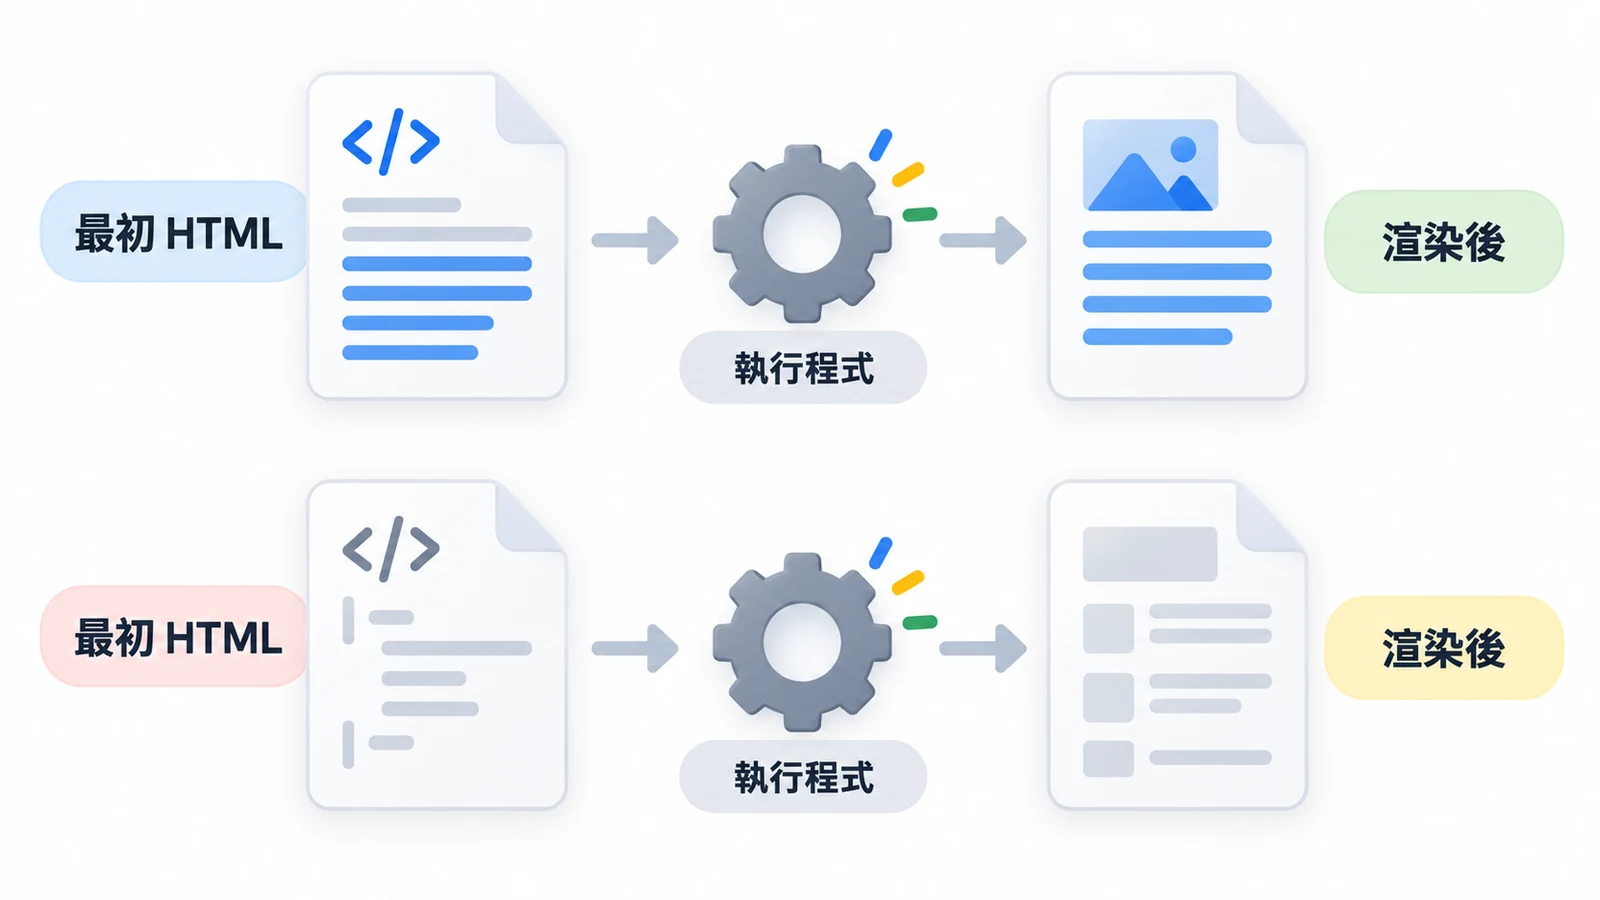
請維護者提供同一頁最初送出的 HTML,以及這個搜尋工具渲染後的內容。註明每份資料由哪個工具取得,再搜尋同一句正文。
| 看到什麼 | 接著做什麼 |
|---|---|
| 最初的 HTML 和渲染後都有你選的那句文字 | 保存兩份內容 |
| 最初只有外框,渲染後有你選的那句文字 | 記下這個工具可取得正文;其他工具分別測試 |
| 渲染後仍找不到你選的那句文字 | 查文章載入時出錯或被阻擋的位置 |
Google Search 能處理 JavaScript,所以最初的 HTML 沒有正文時,接著看 Google 的渲染結果。其他工具則各自測試。
小島可以請維護者把固定試上規則放進網站最初送出的 HTML,剩餘時段再由預約系統提供。像活動通知先寫集合方式,名額另外查;讀者不用等預約系統載入完,才知道基本安排。
影片可以示範怎麼做,旁邊再用文字列出要準備什麼、要先問什麼,讀者就能邊看邊查。
Google 選了另一個網址:核對主要網址設定
同一篇文章可能有原本網址,也有加上廣告追蹤資料的網址,像同一份作業存了幾個副本:內容相同,地址不同。
網站可以用 canonical 指定偏好的主要網址,告訴搜尋系統:「這幾份裡,我希望以這個網址為主。」它是一個選擇主要版本的訊號,Google 也會綜合其他資料作決定。
回到同一網址的 Search Console 索引結果,展開 Page indexing,保存 User-declared canonical(網站指定的主要網址)與 Google-selected canonical(Google 選的主要網址)。這兩欄顯示主要網址;正文讀到了什麼,仍要查 HTML。Google 選哪個網址,要看索引資料,即時測試不能預測。
請維護者比較這兩個網址。哪一欄顯示首頁,就把欄位名稱和首頁網址記下來;網站指定首頁,和 Google 自己選了首頁,得分開找原因。讀過首頁與課程頁,查清為什麼指向首頁,再處理設定。
課程頁幫人選課,準備頁告訴人當天要做什麼,回答的是不同問題,兩頁都要保留自己的完整內容。
已索引,還要確認 Google AI 納入條件時
要有機會成為 Google AI 回答中的來源連結,頁面需要已索引、能顯示搜尋摘要,網站的 AI 納入設定也要允許。摘要就是搜尋結果下方那一小段文章內容。下面就查摘要限制與納入設定。
nosnippet 是要求不顯示搜尋文字摘要的指示。請維護者沿用前面查 noindex 的方法,在 HTML 的 robots 標記與回應標頭 X-Robots-Tag 中核對摘要限制,再另查下面的 Google AI 納入選項。
Search Console 另有 Settings > Search generative AI,控制網站連結與內容是否納入所列 AI 功能,包括 AI Overviews、AI Mode 與 Google Discover 的生成式 AI 功能。
它有納入、排除與繼承三種選擇。「繼承」是沿用較上層資源的設定,Search Console 把這種上層稱為「父資源」。網址前綴資源只包含指定網址開頭的頁面,例如 https://example.com/courses/ 只涵蓋這個網址開頭的頁面。WordPress 裡建一個分類,不會自動新增 Search Console 資源。
假設站主已分別加入下列三個資源,課程區選繼承時,可以看出兩種結果:
| 已加入的資源 | 情況一 | 情況二 |
|---|---|---|
example.com 整站 | 排除 | 排除 |
https://example.com/ 網址前綴 | 繼承整站的排除 | 手動選納入 |
https://example.com/courses/ 課程區 | 繼承,最後是排除 | 繼承上一列的納入 |
Google 的AI 設定與繼承規則是:沒有父資源時預設納入;有父資源時預設繼承。要分清網站資源涵蓋哪一段網址,可以對照網域與網址前綴資源的範圍。
請管理者記下查的是整站還是課程區、是否繼承,以及實際生效的選擇。調整前,確認站主想開放哪些頁面、設定會影響哪裡。這個選項只管所列 Google AI 功能,一般搜尋的納入、排名和模型訓練要分開看。
設定符合條件後,搜尋系統仍會決定每次回答選哪篇。實際用了哪一頁,要回到回答裡看來源。
要查 ChatGPT 搜尋或模型訓練:先分清工具用途
模型是 AI 裡用來產生回答的部分。製作或調整模型時,用許多資料讓它學習怎麼產生內容,叫作訓練。
搜尋是回答眼前這題時,去查外部網頁,像寫報告時翻書。搜尋和訓練用途不同,站主可以分別決定是否開放。
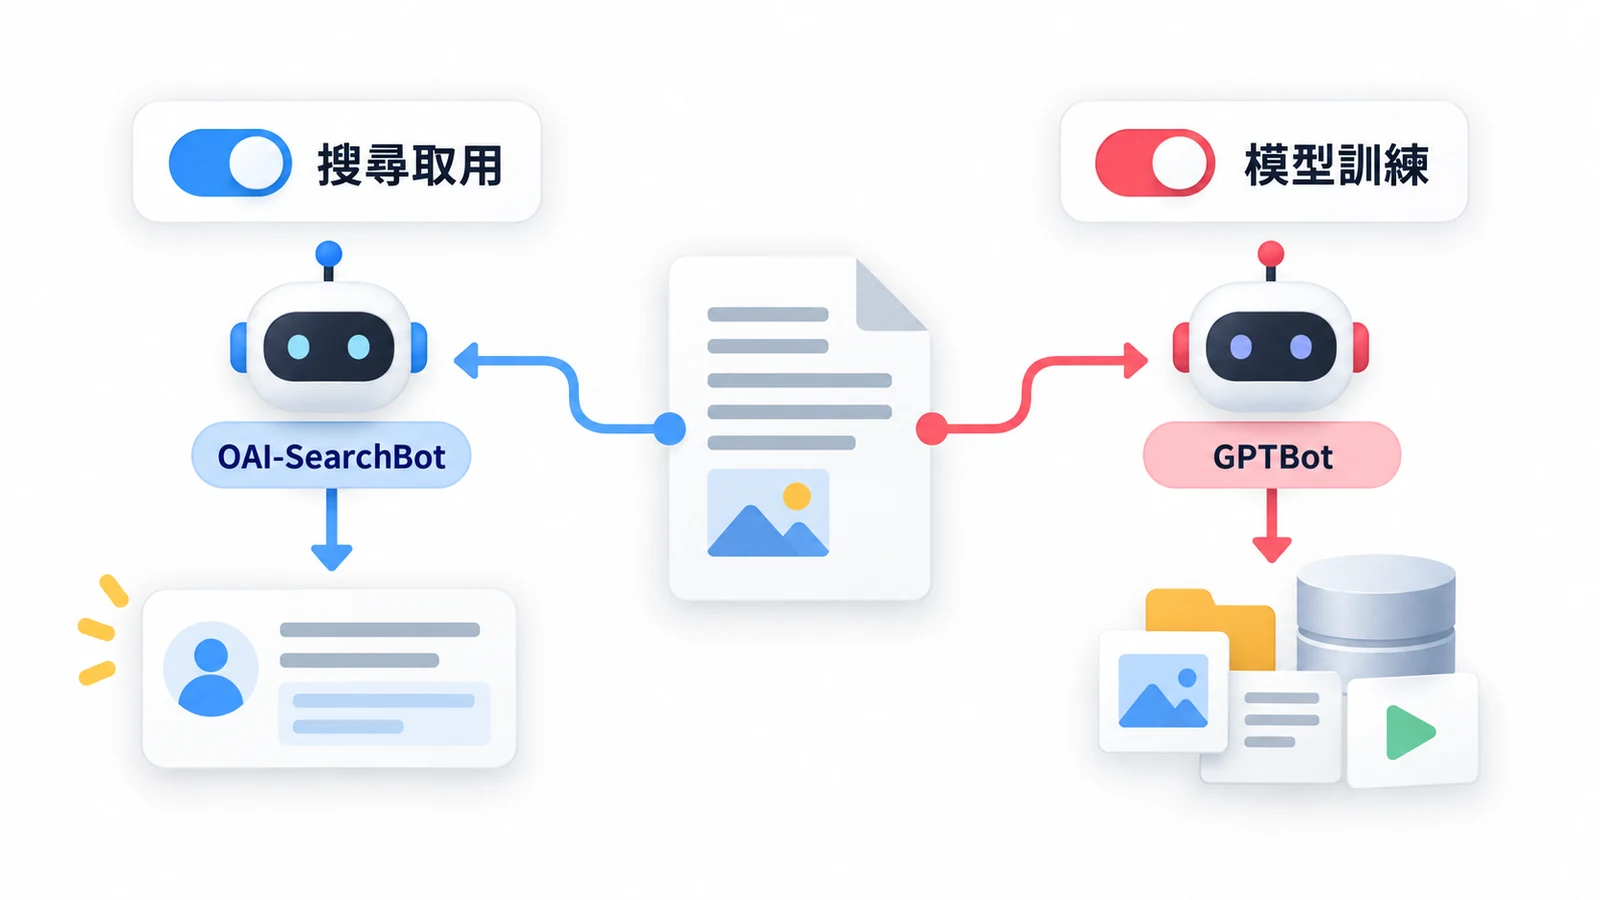
網站紀錄裡的 User-Agent 是工具報上的身分文字。來源位址(IP)則像寄件地址,表示請求從哪個網路位置送來,與文章網址不同。維護者要對照官方公布的工具名稱和 IP,確認請求是否真的來自那個工具。新手先說清「想查搜尋取用,還是模型訓練」,維護者才知道要查哪一列。
| 名稱 | 它在做什麼 | 管理者查哪裡 |
|---|---|---|
| Googlebot | 替 Google Search 讀網頁 | Google 搜尋的抓取規則與實際回應 |
| Google-Extended | 控制指定 Google 產品的模型訓練及回答時取用外部資料 | robots.txt 的這項控制;它沒有獨立 HTTP User-Agent,也不控制 Google Search 納入或排名 |
| OAI-SearchBot | 替 ChatGPT 搜尋取得內容 | 抓取規則,以及官方公布的 IP 是否被網站防護擋住 |
| GPTBot | 取得可能用來訓練模型的內容 | 站主對訓練用途的選擇 |
| ChatGPT-User | 因使用者提問等動作而訪問部分網頁 | 該次使用者觸發的請求;它不自動抓遍網路,也不決定搜尋納入,robots 規則可能不適用 |
Google-Extended 的適用產品,要對照 Google 的爬蟲說明;OpenAI 各爬蟲的用途與來源 IP,則以 OpenAI 公布的資料核對。
例如,站主可允許 OAI-SearchBot 取得公開課程說明,同時拒絕 GPTBot 的訓練用途。要查 ChatGPT 搜尋是否讀得到,就用搜尋那一列的資料;要查它是否引用,再打開回答中的來源連結。