
本篇內容
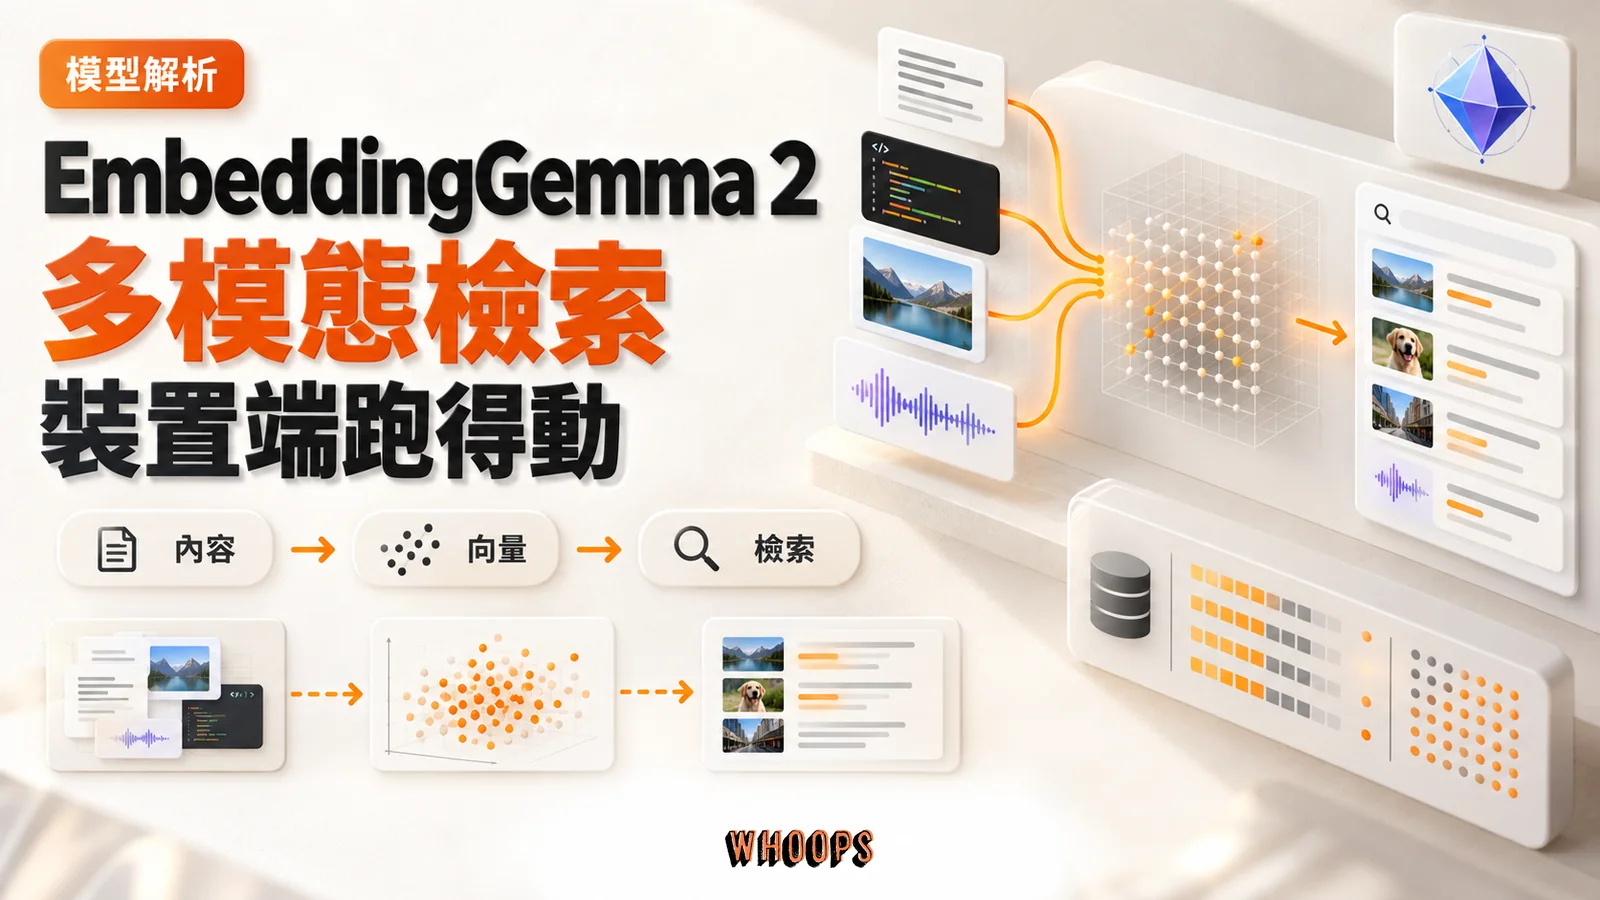
Google DeepMind 在 2026 年 10 月 6 日於官方部落格發表 EmbeddingGemma 2,一款以 Apache 2.0 授權開源的多模態嵌入模型,總參數 740M,能把文字、程式碼、圖片、影片與音訊映射到同一個 768 維的向量空間,設計目標是在手機、筆電這類消費端硬體上直接執行檢索與搜尋,本地部署時可讓輸入資料留在裝置上。
先講會影響使用判斷的關鍵條件。它是嵌入模型,不是生成模型:它不會幫你寫文章或回答問題,而是負責把各種內容變成可以比對相似度的向量,讓「用文字描述找到某張照片」「在幾小時的錄音裡搜尋某段對話」這類任務在本地完成。負載可以拆開裝:純文字場景最低只需要 270M 參數,量化後在 Google Pixel 11 Pro 上約占 191MB 記憶體;載入全部視覺與音訊編碼器的全模態配置約 567MB。它與 Gemini Embedding 系列出自同一套技術,但以開放權重的形式釋出。
EmbeddingGemma 2 是什麼:把五種內容放進同一個向量空間
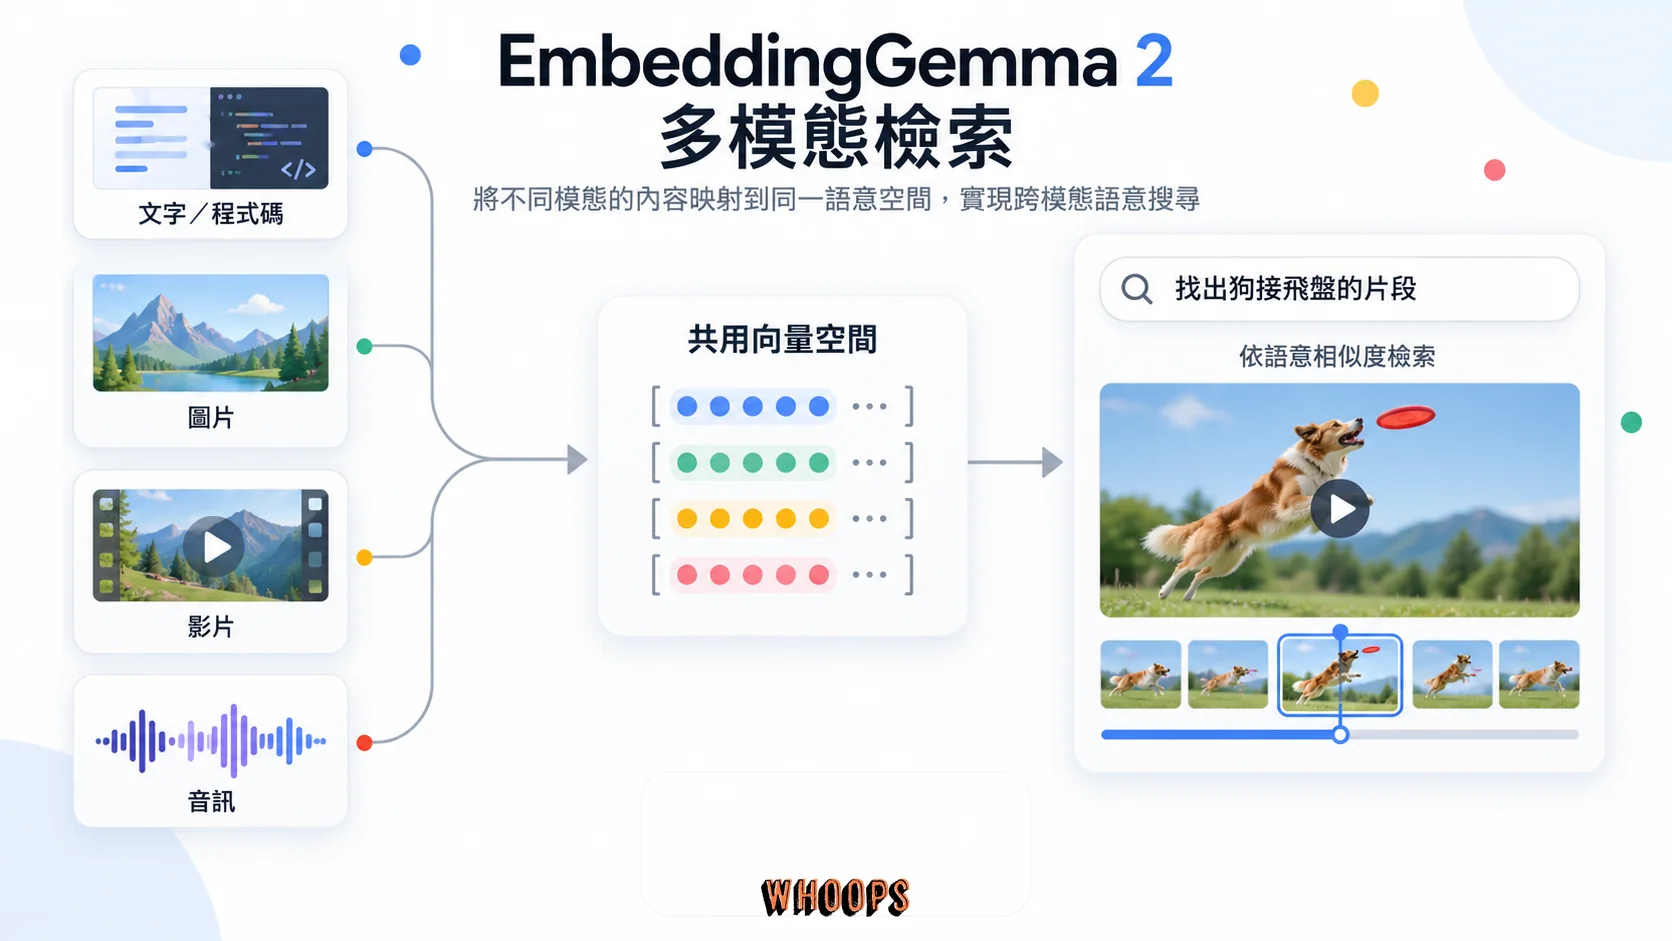
嵌入模型做的事可以一句話講完:把一段輸入轉成一串數字,語意越接近的東西,向量之間的距離越近。應用程式拿到向量之後,「語意搜尋」就變成數學上的距離計算,不需要逐字比對關鍵字。舉例來說,把「狗接飛盤」這四個字和整支影片的每個片段都轉成向量,找出距離最近的片段,就等於用文字「看懂」了影片內容。生成式模型與它剛好互補:生成模型負責讀完資料後寫出答案,嵌入模型負責在大量資料裡先把對的東西撈出來。想先補齊生成式模型基本原理的讀者,可以參考站上的大型語言模型運作解析。
EmbeddingGemma 2 的特殊之處在於「原生多模態」。過去想在應用裡同時支援文字、圖片與音訊檢索,常見做法是分別接一套文字嵌入模型、一套視覺模型、一套音訊模型,再想辦法把三組向量對齊。EmbeddingGemma 2 用單一模型、單一檢查點,把文字(含程式碼)、圖片、影片影格與音訊全部映射進同一個 768 維向量空間,所以純文字的查詢向量可以直接跟全模態文件的向量比對相似度,不需要額外的對齊層。它基於 Gemma 4 架構,理解 100 種以上語言,訓練資料橫跨超過 140 種語言。
從定位看,Google 把它放在 Gemma 開放模型家族的嵌入側:生成對話交給 Gemma 4,檢索與比對交給 EmbeddingGemma 2。公告由 Google DeepMind 研究工程師 Sahil Dua 與 Henrique Schechter Vera 署名,開宗明義把它描述為「目前最強的裝置端多模態嵌入模型」,主打隱私優先的使用情境。
跟第一代 EmbeddingGemma 差在哪:文字基底反而變小,換到四種模態
第一代 EmbeddingGemma 在 2025 年 9 月推出,是純文字嵌入模型,總參數 308M,基於 Gemma 3 並以 T5Gemma 初始化,上下文視窗 2K token,量化後可在 200MB 以內的記憶體執行。它的方法細節也整理成論文,發表在 arXiv 上。官方在這次公告中提到,第一代的累積下載量已超過 2,000 萬次,被大量用在裝置端搜尋與隱私優先的檢索增強生成管線。這個成績也解釋了 Google 為什麼願意投入做第二代。
第二代的變化不是單純放大。純文字的工作負載從前代的 300M 級降到 270M,變小的這部分空間換給了兩個可選編碼器:170M 的視覺編碼器與 300M 的音訊編碼器。上下文視窗一口氣放大 4 倍到 8K token,程式碼檢索分數則從 MTEB Code 的 68.76 提升到 78.68。用一張表對照兩代規格:
| 對照項 | EmbeddingGemma 第一代 | EmbeddingGemma 2 |
|---|---|---|
| 推出時間 | 2025 年 9 月 | 2026 年 10 月 6 日 |
| 基礎架構 | Gemma 3 | Gemma 4 |
| 總參數 | 308M | 740M(純文字最低 270M) |
| 支援模態 | 純文字 | 文字(含程式碼)、圖片、影片、音訊 |
| 上下文視窗 | 2K token | 8K token |
| 輸出向量 | 768 維,可截斷 | 768 維,可截斷至 512/256/128 維 |
| MTEB Code(NDCG@10) | 68.76 | 78.68 |
| 量化後記憶體 | 低於 200MB | 純文字約 191MB、全模態約 567MB(Pixel 11 Pro 實測值) |
| 授權 | Gemma 使用條款 | Apache 2.0 |
分數面的細節可以在官方model card 的評測頁逐項查核。除了 MTEB Code 進步 9.92 分(約 14%),多語言文字基準 MTEB multilingual v2 從 61.15 微升到 61.36,代表第二代在這項多語言基準上大致持平;語音檢索 MSEB 拿到 69.54,音訊嵌入基準 MAEB 為 49.39,圖文文件檢索 VisDoc 為 67.84。官方的總結是:在 sub-1B 多模態嵌入模型中同級領先,部分任務勝過兩倍大的專家模型。這是官方宣稱,第三方獨立評測到本文撰寫時仍在累積,選型時建議拿自己的資料實測。
查「EmbeddingGemma 2B」之前:先拆掉一個常見混淆
EmbeddingGemma 2 的「2」是第二代的意思,不是 2B 參數。依官方模型卡,實際可選的配置是 270M、440M、570M 與 740M,沒有 2B 版本;Gemma 家族早年的 2B 生成式模型則是另一個產品,不能與 EmbeddingGemma 2 混用。
270M 指的是 EmbeddingGemma 2 的純文字配置。它基於 Gemma 4 語言模型架構,但輸出是用來檢索與比對的向量,不是聊天答案;在 RAG 應用裡,找資料與生成回答仍由不同模型負責。
740M 為什麼敢說裝置端:模組化載入與量化後的記憶體帳
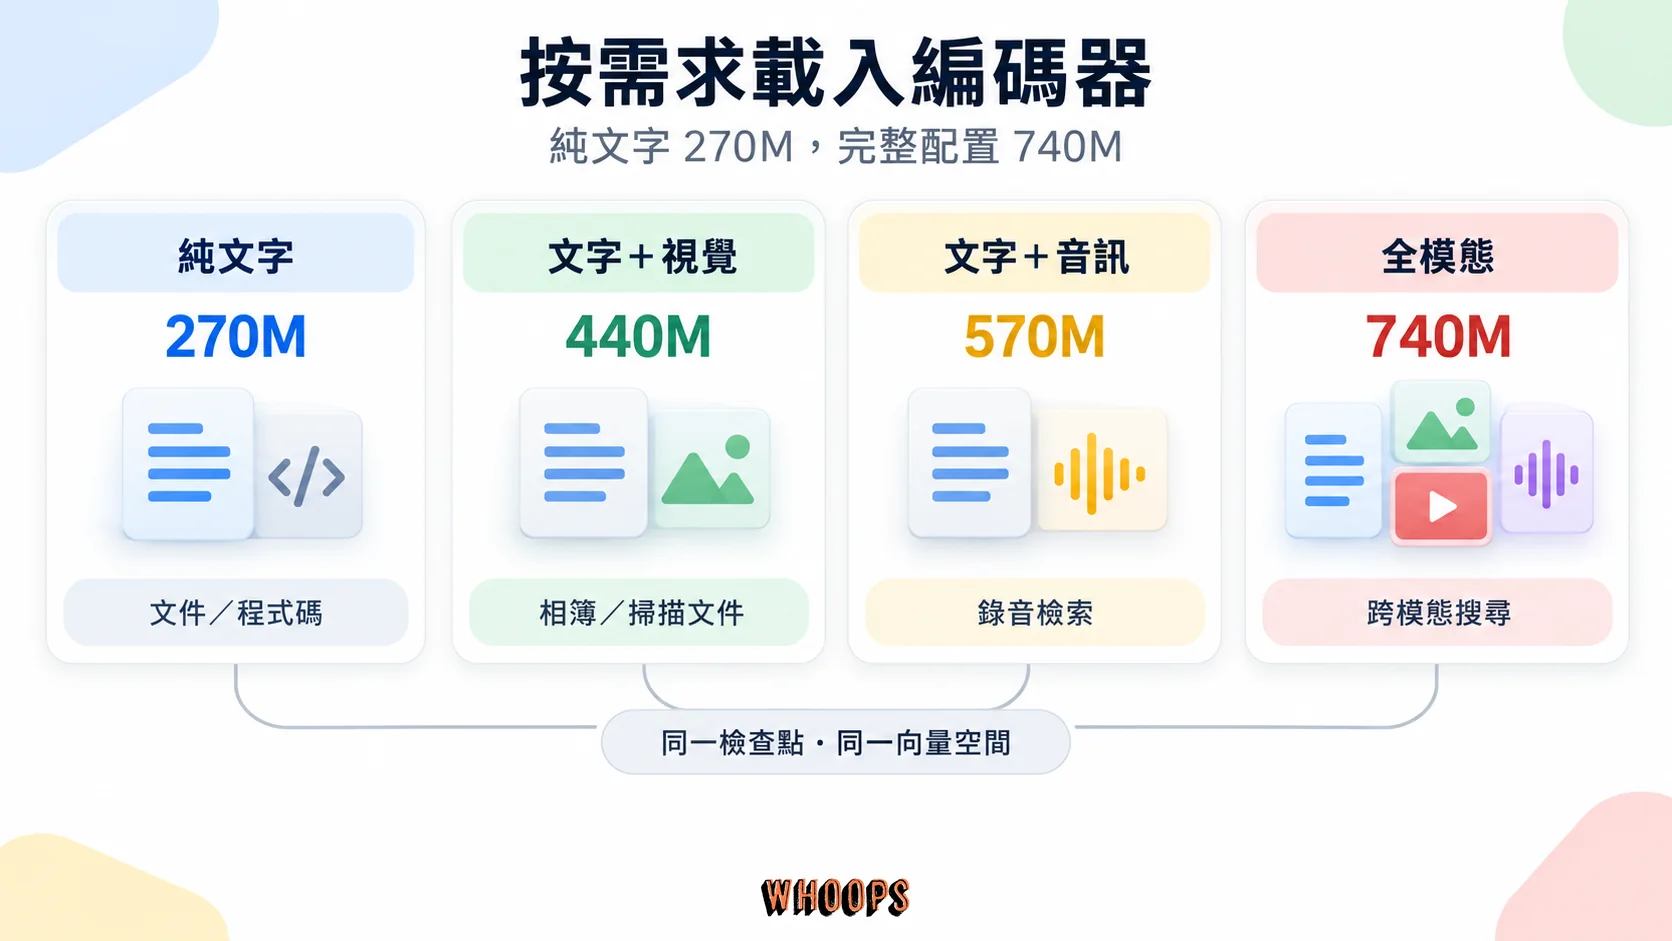
EmbeddingGemma 2 的 740M 是「全配」的數字,實際載入多少取決於你開啟哪些編碼器。文字模型本體 270M,由 130M 主幹與 140M 嵌入層(embedder)組成,視覺編碼器 170M,音訊編碼器 300M;在設定檔把視覺或音訊配置設為 None,對應編碼器就完全不載入記憶體,權重與峰值配置都省下來。四種配置對應的場景大致如下:
| 載入配置 | 參數量 | 適合的應用 |
|---|---|---|
| 純文字 | 270M | 文件搜尋、知識庫檢索、RAG、程式碼索引 |
| 文字+視覺 | 440M | 相簿語意搜尋、圖片與掃描文件檢索 |
| 文字+音訊 | 570M | 語音備忘錄、會議錄音、逐字稿前檢索 |
| 全模態 | 740M | 文字、圖片、影片、音訊混合的跨模態搜尋 |
四種配置共用同一個檢查點與向量空間:手機版 App 可用 270M 產生文字查詢向量,伺服器端用 740M 建全模態索引,兩邊可以比對。依官方配置說明,只新增視覺或音訊編碼器時,既有文字向量不必重算;模型版本、任務前綴與輸出維度仍應一致,換成其他模型或微調權重則需重新評估索引。
記憶體面,模型經過量化感知訓練(QAT)壓到 INT4/INT8 後,官方在 Pixel 11 Pro 上量到的數字是:純文字權重約 191MB 活躍記憶體,全模態約 567MB。Google for Developers 在 2026 年 10 月 12 日的討論串也以小於 600MB 的部署足跡介紹這個模型。這些數字來自特定裝置與量化配置,實際用量還會受到輸入長度、執行框架與應用程式影響。想了解這類 sub-1B 模型如何靠蒸餾、量化與剪枝塞進手機的整體脈絡,可以延伸閱讀站上的小型語言模型指南。
Skip the clunky ML pipelines. Instead of stringing together separate vision, audio, and text models, EmbeddingGemma 2 maps multiple modalities natively into the same space. By deploying it with Google AI Edge, you get server-grade AI in a footprint small enough (<600MB) to run
— Google for Developers (@googledevs) October 12, 2026
速度也有官方參考值:在 MacBook M5 Pro 的 GPU 上,每張圖片的視覺嵌入耗時 37.3 毫秒,等於每秒可處理約 26.9 張。這是在每張圖 70 個視覺 token 預算下的數字,實際速率會隨輸入設定與硬體不同而變化。
8K token 上下文實際能裝多少內容
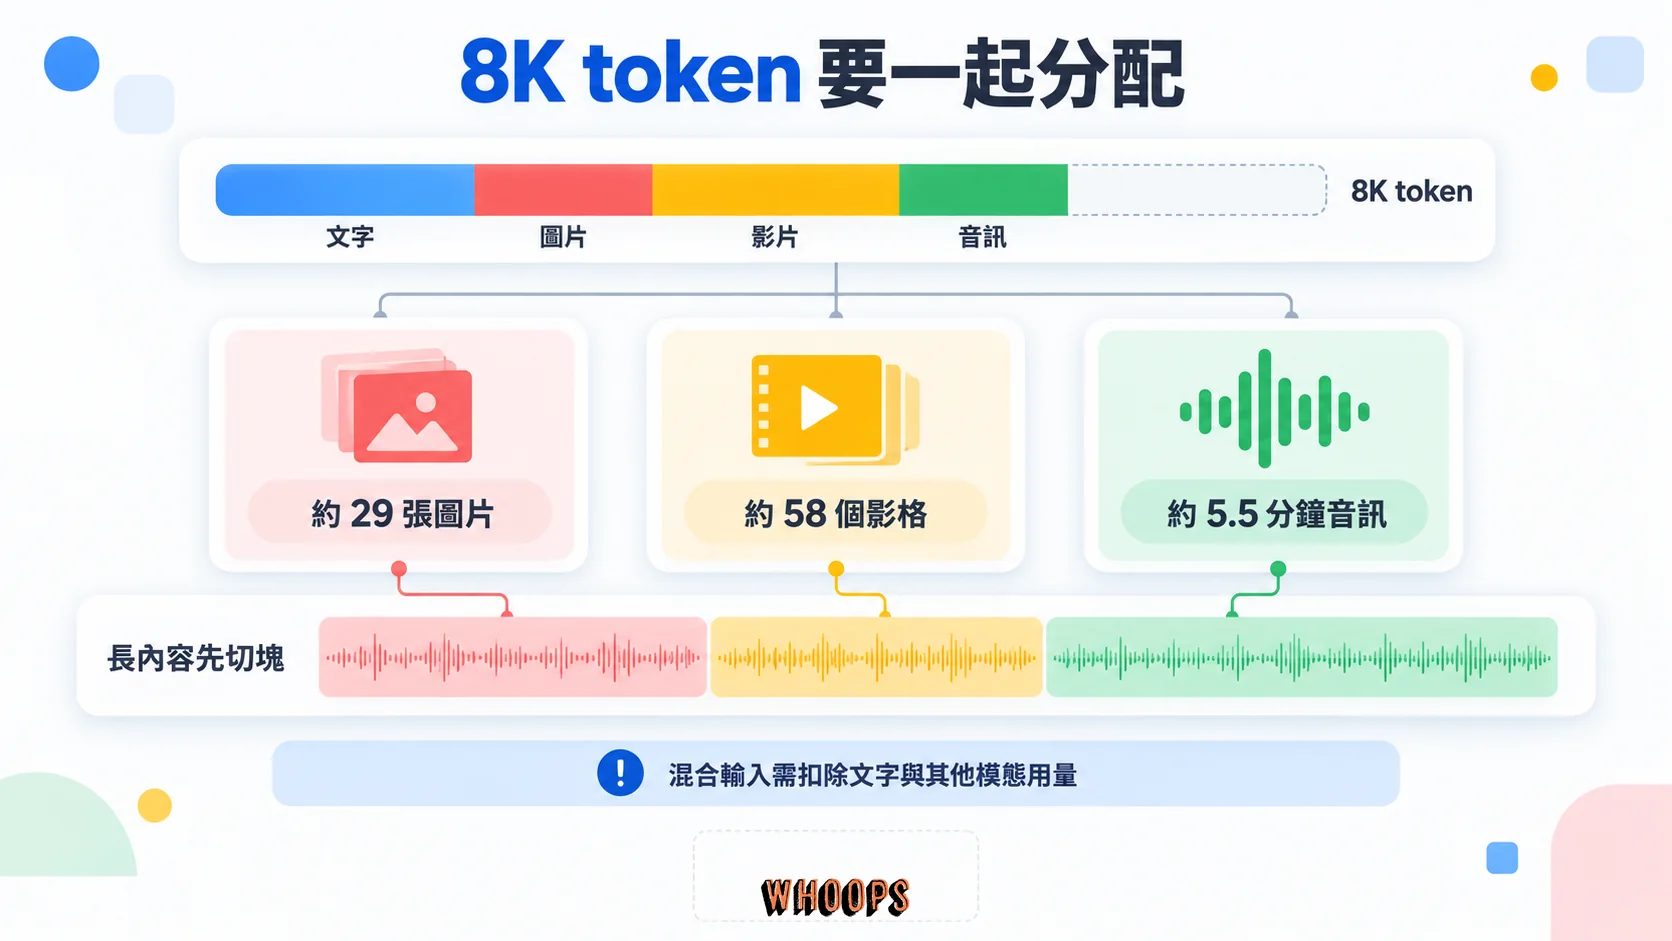
上下文視窗 8,192 token 是第一代的 4 倍,而且由全部模態共享。依官方 token 預算,單一模態、沒有伴隨文字時,大約能裝 5.5 分鐘音訊、29 張圖片,或 58 個影片影格。預設消耗是每張圖 280 token、每個影格 140 token、音訊每秒 25 token;影片預設每秒取 1 格,所以 58 個影格約對應 58 秒視覺資料。加入文字、圖片或音訊後,能放進去的影片長度會縮短。
對實際應用的意義是:兩分鐘的影片可以先切成帶有時間戳的片段,再逐段建立畫面與聲音索引;會議錄音也能先分段,直接以文字查詢,不必先產生逐字稿。片段大小應符合共享的 8K token 預算,不能只用影片總時長判斷。Google AI Edge 的 Video Moments Finder就是先對影片的視覺與音訊區段建索引,再回傳相關時間點;Hacker News 的發布討論串也有文件切塊與授權選擇的討論。
實際能做什麼:四種官方示範情境
Google AI Edge Gallery App 裡放了兩個可以直接試的範例。Instant Media Search 做的是相簿語意搜尋:邊打字邊出結果,向量存在本地 SQLite,用餘弦相似度排序,查詢可以是文字,也可以直接拿一張照片當查詢去找相似畫面。Video Moments Finder 更能展現多模態的價值:它對影片的視覺與音訊區段同時建索引,完全不需要字幕或轉錄,輸入「狗接飛盤」就回傳出現的時間點。官方建議想動手的人從Google AI Edge 團隊的部署指南開始。
Build apps that can search through photos, videos, and audio just by describing what's in them.
— Google for Developers (@googledevs) October 12, 2026
Here’s how everyday developers are pairing EmbeddingGemma 2 from @googlegemma with Google AI Edge to make it happen, completely on-device 🧵👇
第三個示範是 Mac 上的 AI Edge Foresight,一個完全本地的會議助理:EmbeddingGemma 2 把筆記、文件、逐字稿與畫面截圖放進同一個向量空間做跨模態檢索,Gemma 4 負責把速記補成完整筆記、即席回答問題,整個流程不上傳任何資料。第四個是 MediaPipe 的 Decision Task API,把嵌入模型當零樣本決策引擎用,直接比對輸入與分類標籤的向量距離,不需要訓練資料;官方給的參考數字是評估 500 個棋步選項耗時低於 100 毫秒,Semantic Retriever 的近似最近鄰搜尋則在個位數毫秒內回傳排序結果。
裝置端 RAG 與程式碼檢索:開發者最常用的兩條路
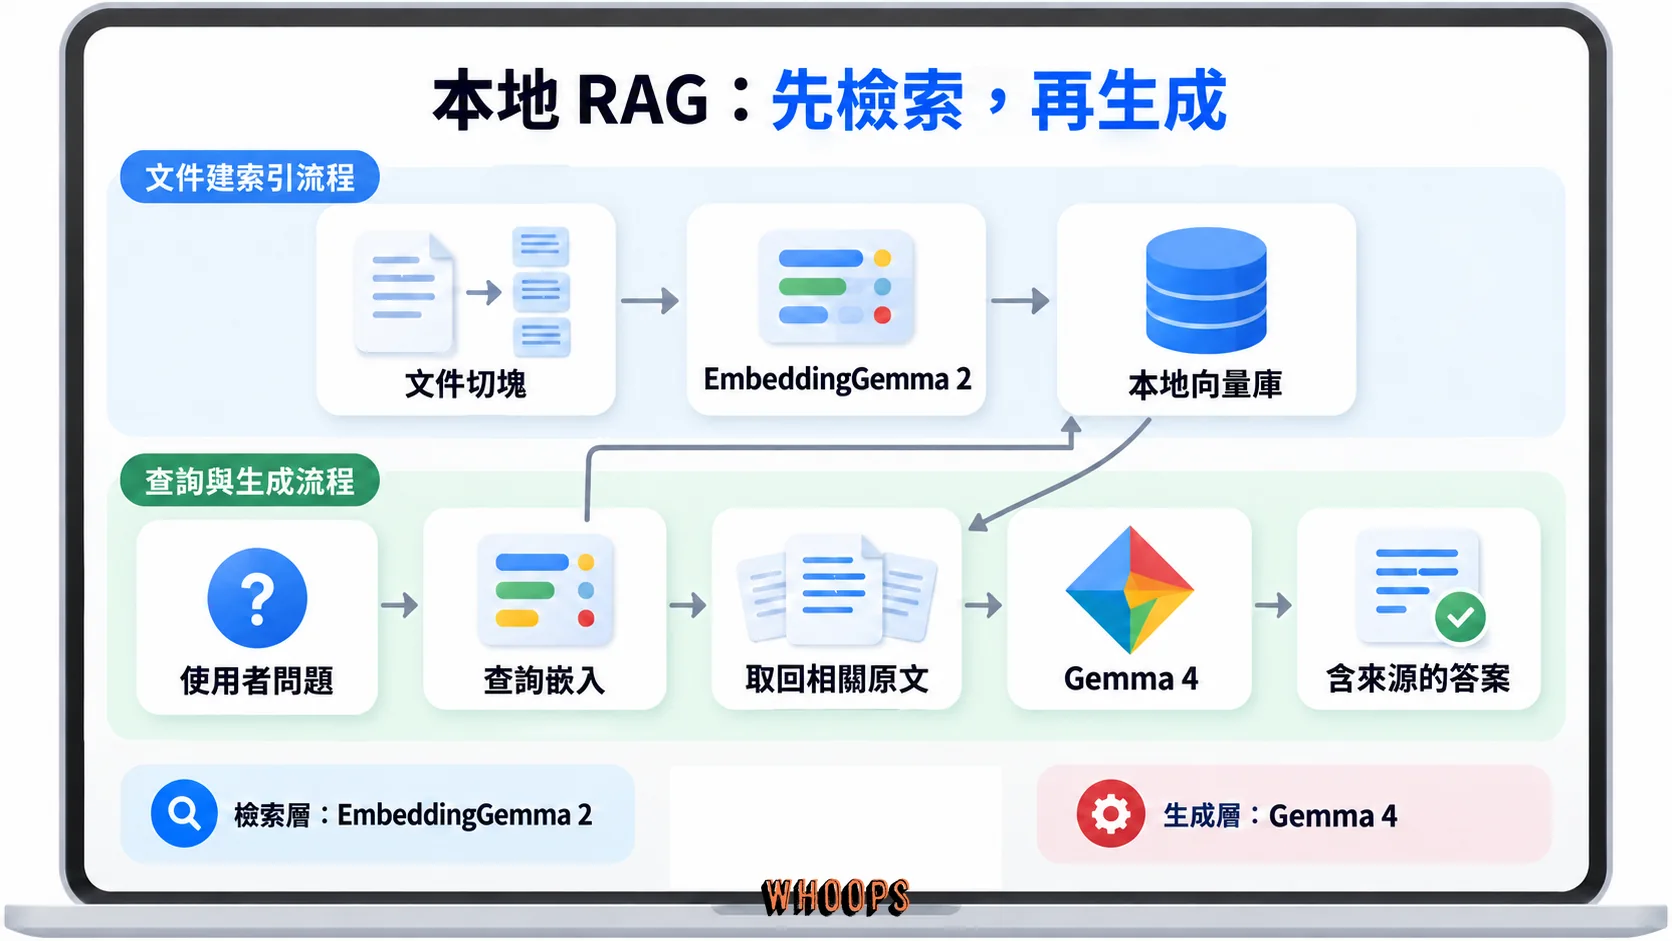
檢索增強生成(RAG)的原理不複雜:先檢索,再生成。使用者的問題先被轉成向量,從本地知識庫裡找出最相關的幾段內容,餵給生成模型組出答案。EmbeddingGemma 2 在這條管線裡扮演檢索層,生成層交給 Gemma 4。因為兩者共用文字 tokenizer 與音訊編碼器,一起部署時可以共用部分元件,總記憶體足跡低於各接一套模型;官方總覽也建議,行動優先的 RAG 管線搭配 Gemma 4 E2B 一起跑。
一條最小的裝置端 RAG 管線大概是這個形狀:先把文件切成適當大小的區塊,用文件端前綴逐一嵌入,連同來源資訊存進本地向量資料庫;使用者提問時,用查詢端前綴嵌入問題,對向量庫做近似最近鄰搜尋取回前 K 筆;把這幾筆原文連同問題一起交給 Gemma 4 生成答案。整條鏈的瓶頸通常不在嵌入本身,而在區塊大小與檢索筆數的取捨:區塊太大會稀釋語意、太小會切斷上下文,K 值太大撐爆生成模型的視窗、太小又漏掉關鍵段落,這也正是官方示範與社群討論裡反覆調校的兩個參數。內部文件若需要版本管理,也可以先整理成 OKF 知識包,再由檢索管線讀取。
程式碼檢索是另一條被官方重點打磨的路。MTEB Code 從 68.76 到 78.68 的進步,對應的實際工作是:在本地把整個程式碼庫建成向量索引,讓開發者用自然語言問「處理快取的函式在哪裡」,或讓 coding agent 在每次改檔前先檢索相關程式碼。官方開發者指南的示範就是用 270M 純文字配置索引 Hugging Face transformers 的完整程式碼庫,再交給 Gemma 4 26B A4B 當檢索代理。
檢索當然不是只有向量一條路。向量檢索擅長「內容相近」的比對,但當答案需要把多份文件之間的關係串起來時,以實體與關係為結構的知識圖譜檢索是互補做法,站上的知識圖譜解析對兩種典範的取捨有完整討論。若你關心的是 AI 搜尋如何採用網站內容,頁面能否被索引、是否足以支持答案,以及最後是否被引用,這些不同層次的條件整理在GEO 生成式引擎最佳化指南。
向量維度怎麼選:MRL 截斷的省法與代價
EmbeddingGemma 2 支援 Matryoshka Representation Learning(MRL),白話說就是:768 維的輸出向量可以事後直接砍掉尾端,只保留前 512、256 或 128 維,而前面的維度已經保留了大部分語意資訊。這對向量資料庫的儲存成本影響很大,官方試算以 bfloat16 儲存 100 萬個向量,768 維約 1.5GB,截到 128 維只要約 250MB,等於最高 6 倍的儲存節省。這裡只計向量數值,未含資料庫索引、原文與其他中繼資料。
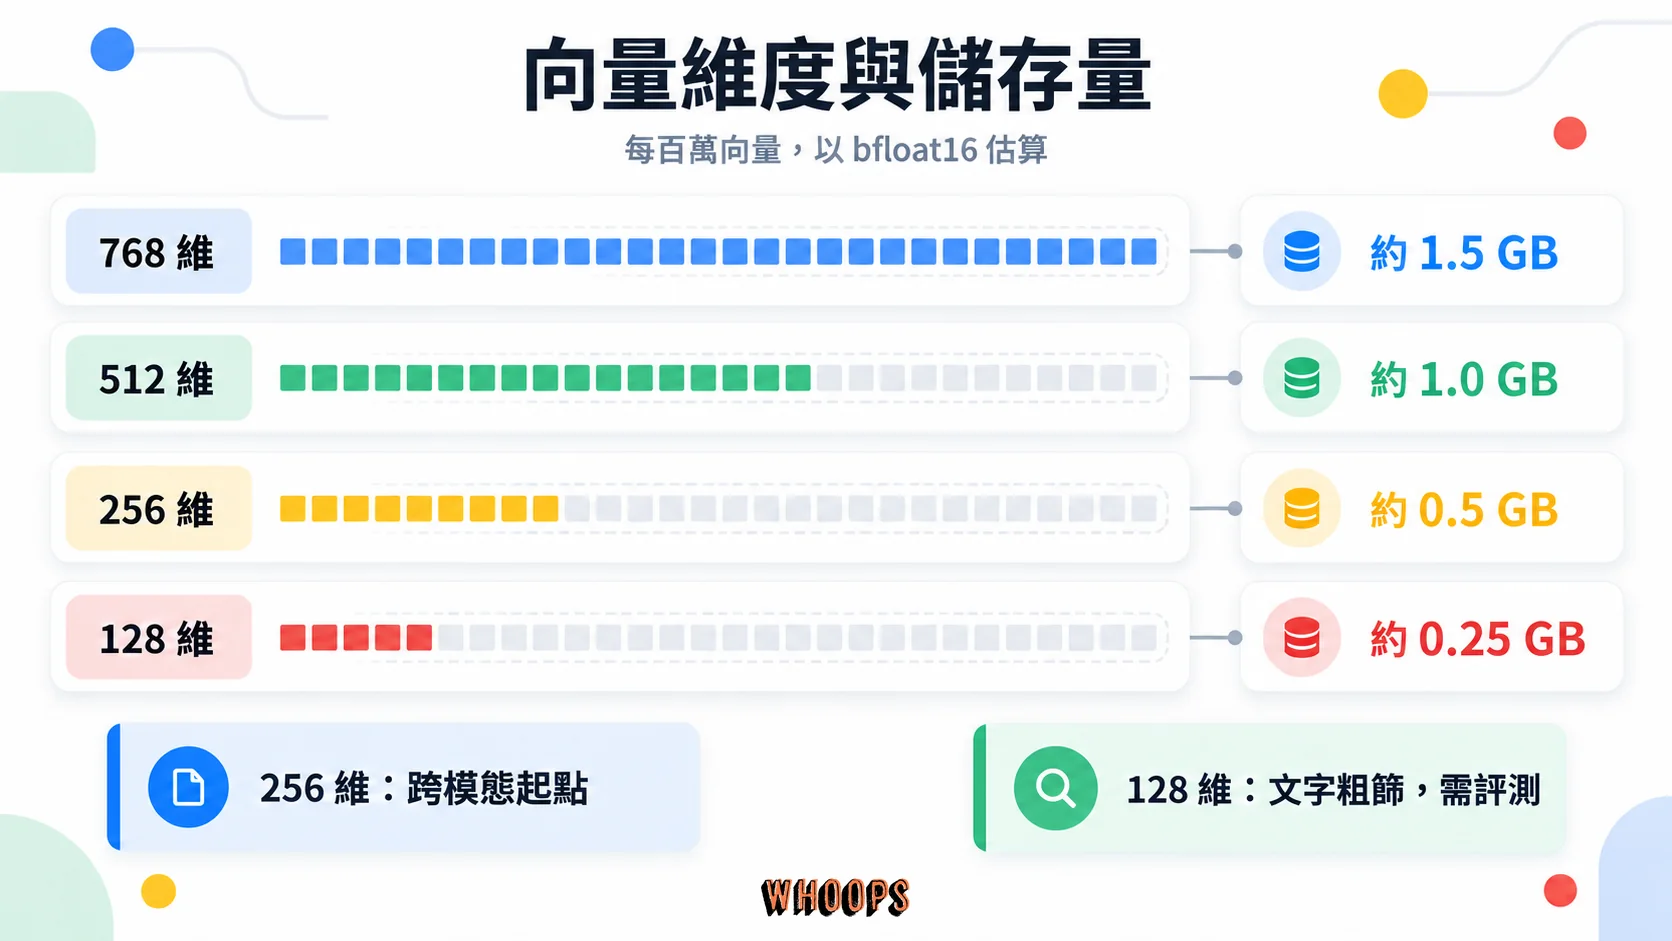
代價要誠實看。官方數字是截到 256 維時品質接近無損,影像、影片與語音任務大約保留 95% 的表現;截到 128 維時文字與程式碼還有約 90%,但多模態品質會明顯退化,官方建議 128 維留給大規模純文字索引,或當成粗篩、再對候選重排的兩階段做法。各維度的實際分數變化如下,儲存量是以 bfloat16 儲存一百萬個向量的換算值:
| 輸出維度 | MTEB 多語言 | MTEB Code | MMEB 總分 | 儲存量(每百萬向量) |
|---|---|---|---|---|
| 768(原生) | 61.36 | 78.68 | 59.01 | 約 1.5GB |
| 512 | 61.17 | 77.24 | 58.38 | 約 1.0GB |
| 256 | 60.41 | 76.18 | 56.24 | 約 500MB |
| 128 | 57.89 | 71.41 | 45.65 | 約 250MB |
從這張表可以直接讀出決策:砍到 256 維時,多語言檢索只掉 0.95 分,程式碼檢索掉 2.5 分,換到 3 倍的儲存節省,對多數文字應用是划算的交易;多模態應用則要看 MMEB 那欄,128 維時 59.01 掉到 45.65,這就是官方說「明顯退化」的具體數字。工程上還有兩個規則要記住:截斷後的向量必須重新做 L2 正規化,而且查詢與文件的維度必須一致,混用不同維度的向量比對出來的相似度沒有意義。完整的維度對照與程式寫法,官方開發者指南有逐項說明。
在哪裡取得:Hugging Face、Ollama 與其他管道
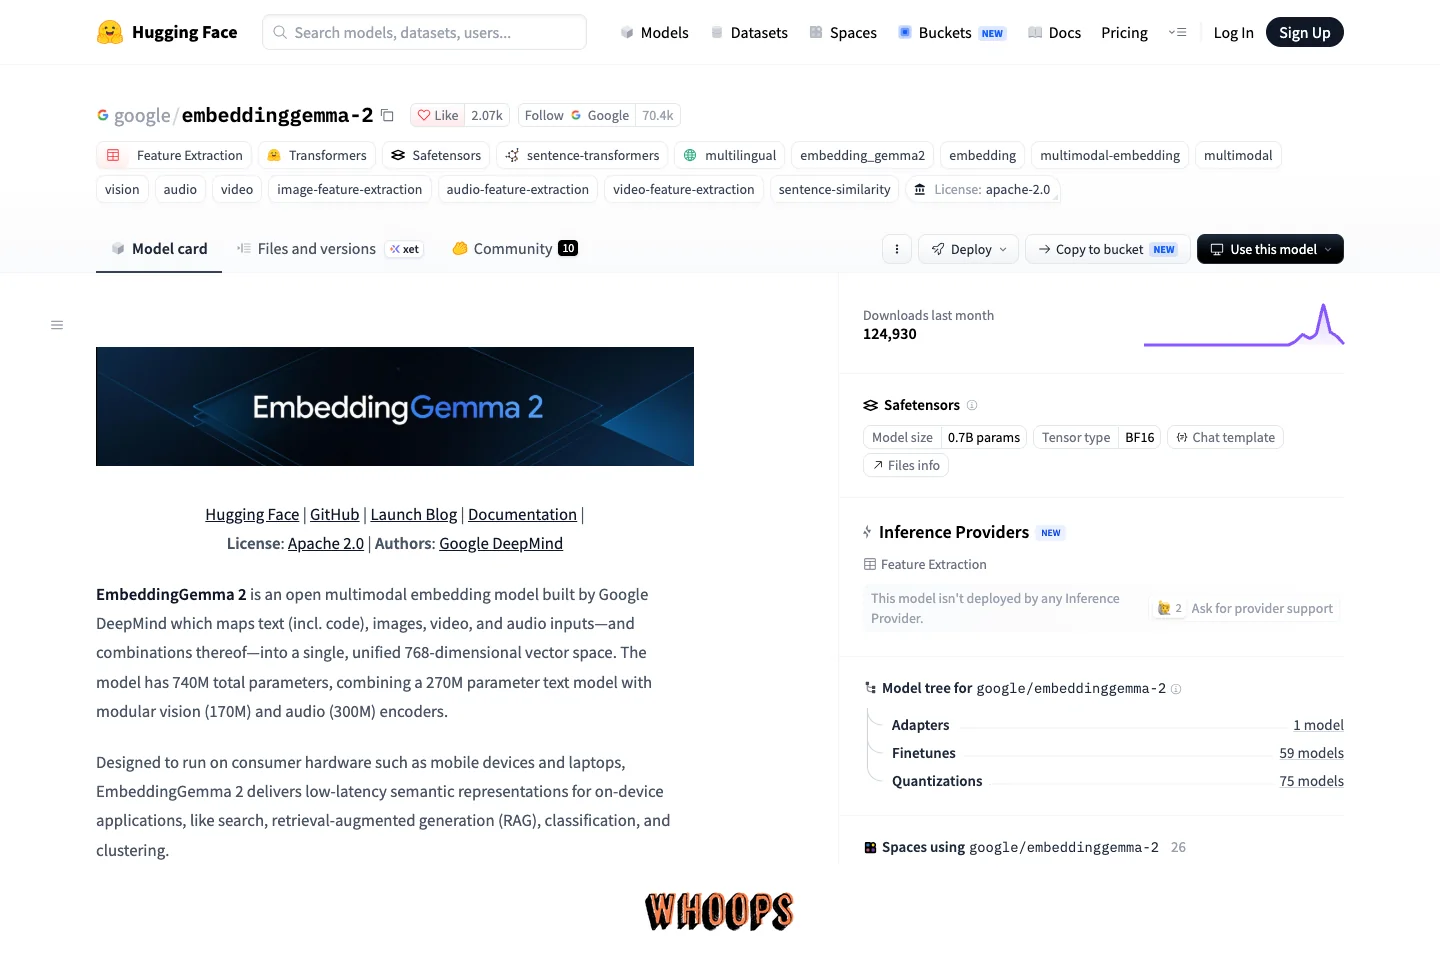
官方權重位於 Hugging Face 的 google/embeddinggemma-2 儲存庫,提供 safetensors 格式、BF16 精度;Kaggle 上也有同名模型頁。Google 的發布公告則把 Gemini Enterprise Agent Platform Model Garden 列為即將上架的管道。Hugging Face 也能查到社群維護的量化版本與微調分支,下載時應確認來源、格式與執行框架。
Ollama 的官方模型頁提供 ollama pull embeddinggemma-2,文字請求可透過 /api/embed 或客戶端的 embed() 取得向量。270m、440m、570m 與 740m 標籤的下載大小約為 378MB、714MB、990MB 與 1.3GB。目前這個模型的Ollama 多模態實作採 MLX runner,使用前需確認執行版本與硬體支援;圖片與音訊輸入也有各自的 API 格式。Ollama 頁面雖顯示 256K 上下文,Google 模型卡定義的原生視窗仍為 8,192 token,切塊時應以模型規格為準。
其他工具鏈的支援相當整齊:llama.cpp 的 GGUF 權重由 ggml 專案維護,伺服器端部署可用 vLLM 與 SGLang,Apple Silicon 有 MLX,桌面圖形介面有 LM Studio,瀏覽器內能用 transformers.js 搭 WebGPU 直接跑,甚至有零設定的網頁示範。行動裝置與邊緣部署走 Google AI Edge 體系,LiteRT Community 帳號提供預量化的 .litertlm 單檔套件,Android 的 ML Kit 支援則在官方時程的未來幾週內推出。向量儲存方面,Qdrant 官方也發了整合說明。模型的產品定位與技術問答,Google DeepMind 的模型頁整理得最完整。
怎麼開始用:用 Python 產生第一個嵌入向量
官方開發者指南採用 sentence-transformers 6.1.0 以上搭配 transformers。以下範例只載入 270M 文字配置,並在 CPU 上明確使用 float32;這是未量化的 Python 路徑,記憶體用量不等於前述 Pixel 的 191MB 測量值。
pip install -U "sentence-transformers[image,audio,video]>=6.1.0" transformersimport torch
from sentence_transformers import SentenceTransformer
model = SentenceTransformer(
"google/embeddinggemma-2",
device="cpu",
config_kwargs={"vision_config": None, "audio_config": None},
model_kwargs={"torch_dtype": torch.float32},
)
# 查詢端與文件端使用不同的任務前綴
query = model.encode("如何快取 API 回應", prompt_name="SearchQuery")
docs = model.encode([
"API 回應快取的三種策略",
"資料庫索引的建立方法",
], prompt_name="Document")
print(model.similarity(query, docs))文字檢索的查詢與文件應使用不同的任務前綴(prompt_name);省略前綴仍能執行,但品質會降低。文件沒有標題時,Document 會加上 title: none | text:;已有標題則自行格式化成 title: 標題 | text: 內文,不要再重複加 Document。圖片、影片與音訊可用對應鍵值輸入;混合文字與媒體時,再於文字中加入 <|image|>、<|video|>、<|audio|> 占位符。影片預設每秒取 1 格,音訊使用 16kHz 單聲道;若要截斷到 256 維,編碼時搭配 truncate_dim=256 與 normalize_embeddings=True。
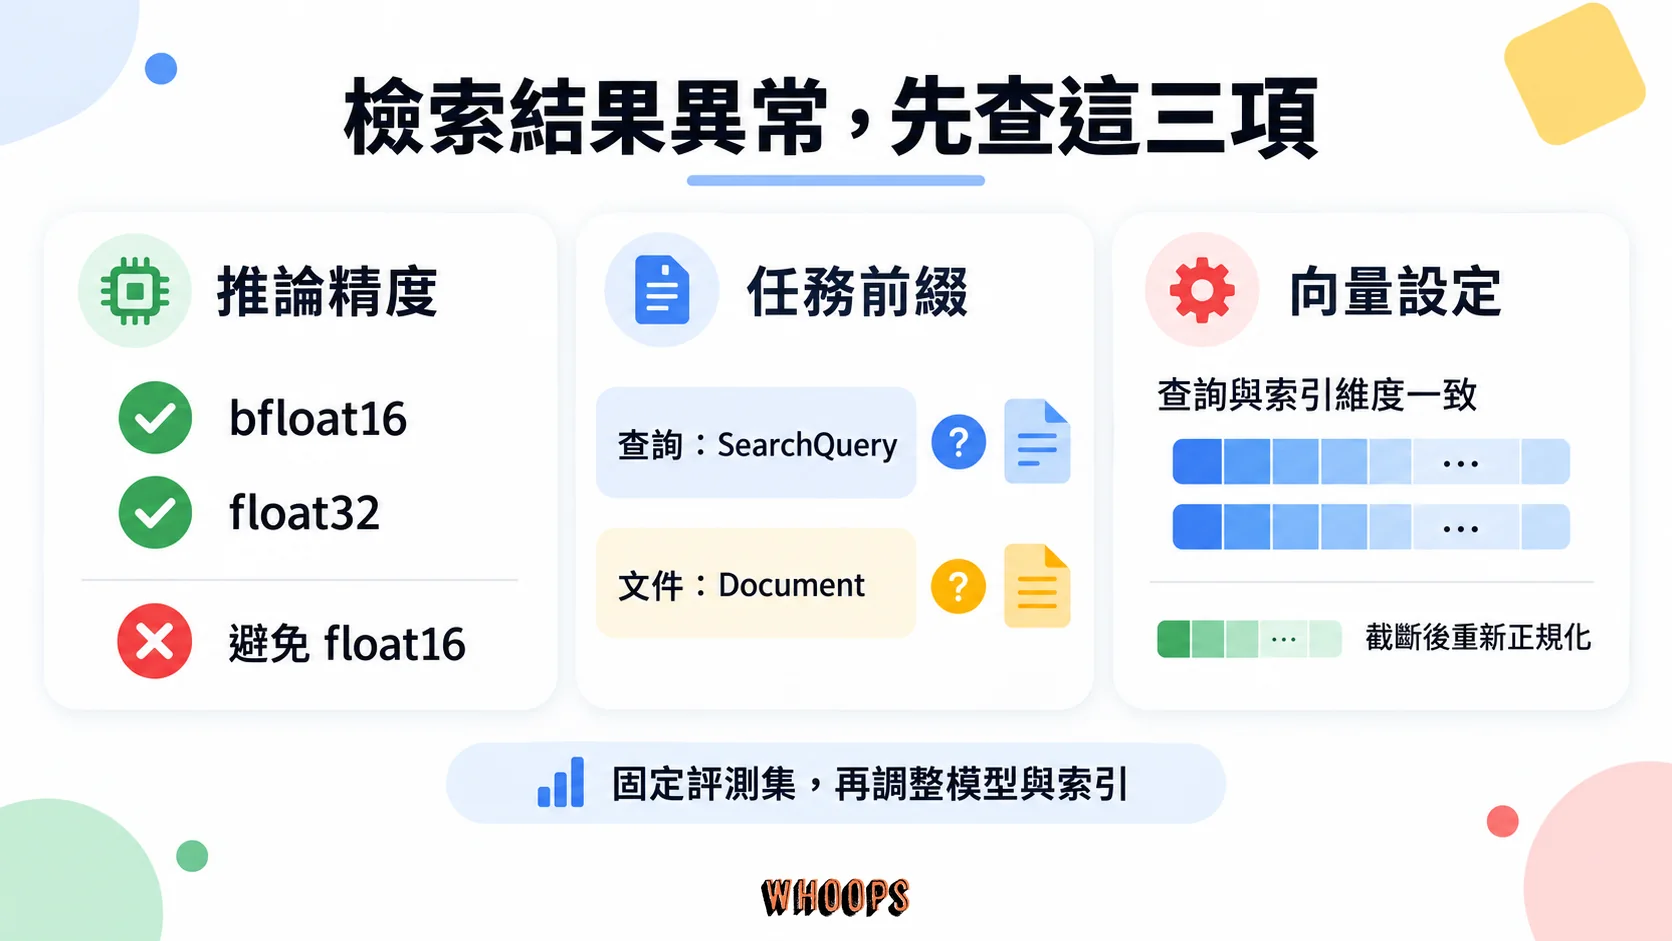
推論時使用 bfloat16 或 float32,避免 float16。官方警告 float16 可能產生 NaN 或無聲的品質退化,讓程式仍可執行卻得到錯誤的檢索結果。完整的 API、多模態範例與 RAG 快速上手 Notebook,都在Google AI 開發者文件的 EmbeddingGemma 專區,文件本身就提供中文版介面。
微調與中文場景:什麼時候值得自己訓一版
官方提供了兩條微調路線:用 sentence-transformers 做文字與多模態微調的正式指南,以及效率導向的 Unsloth 微調文件,後者用較低的顯示卡記憶體就能跑完實驗,適合快速試驗任務前綴與資料組合。通用模型不可能對每個領域的詞彙分布都公平,當你的語料混合了大量繁中口語、產品型號或行業術語,而通用版本的召回分數不滿意時,就是動手微調的時機。
中文支援屬於原生能力的一部分:模型理解 100 種以上語言,訓練資料橫跨超過 140 種,但官方模型卡也指出各語言表現可能不同,目前列的是整體多語言基準,不能直接代表台灣繁中語料的品質。若資料包含繁中口語、產品型號或專業術語,先用自己的查詢與正確文件建立評測集,再比較微調前後的召回結果。
台灣開發者的下載與離線情境
Ollama 的 270M 配置下載大小約 378MB,全模態約 1.3GB。模型、執行框架與所需依賴下載完成後,可在支援的本地環境離線計算嵌入。雲端嵌入 API 需要連線並傳送輸入,費用依服務方案與使用量而定;本地執行則能讓嵌入計算保留在自己的裝置上。
離線情境在台灣的實際樣貌很多。會議錄音與逐字稿檢索、公司內部知識庫、法務與醫療文件、不想上雲的客戶資料庫,這些場景的共同點是資料不能出機器,卻仍然需要語意搜尋。把 EmbeddingGemma 2 當檢索層、Gemma 4 當生成層,就能組出完全本地的知識助理。台灣媒體也注意到這個趨勢:TechNEWS 從Mac 上的離線 AI 應用角度報導了這波模型落地,iThome 也有對應的消息整理,國外開發者圈的主討論則集中在 Reddit 的 LocalLLaMA 社群,該討論串有繁體中文翻譯版本可以直接讀。
限制與注意事項:動手前該知道的事
精度限制再強調一次:只能用 bfloat16 或 float32 推論,float16 會產生 NaN 或靜默退化。維度選擇上,128 維會明顯傷害多模態品質,跨模態應用建議停在 256 維以上。任務前綴不是可選的裝飾,省略會直接降低文字嵌入品質。
模型本身沒有做生成式安全對齊,官方要求使用時遵守 Gemma 的禁止用途政策,應用層的防護由開發者自己負責;把它接進會影響人的決策流程時,分類與路由結果要保留人工覆核的空間。能力邊界方面,官方 model card 誠實列了幾條:訓練資料帶有的偏見與缺口會反映在輸出、跨語言表現不一致、開放式任務與諷刺細膩語意的辨識是弱項。訓練資料截止於 2025 年 1 月,對嵌入模型的影響比對聊天模型小(嵌入看的是語意結構而非時事),但拿它處理新詞密集的內容時仍要留意。基準分數全部來自官方評測,獨立第三方的大型橫評還在路上。
常見問題
EmbeddingGemma 2 是什麼?
它是 Google DeepMind 在 2026 年 10 月 6 日發布的開源多模態嵌入模型,Apache 2.0 授權,總參數 740M,把文字、程式碼、圖片、影片與音訊映射到同一個 768 維向量空間,設計目標是在手機與筆電上直接執行語意搜尋與檢索。它不做生成,負責的是檢索與比對這一側。
EmbeddingGemma 2 有 2B 版本嗎?
沒有。「2」是第二代的意思,不是參數量。實際的配置只有 270M、440M、570M、740M 四種。會查到「2b」通常是兩個混淆:把早年 Gemma 2B 生成式語言模型誤當嵌入模型,或把版本號誤讀成 2B 參數。
EmbeddingGemma 2 跟第一代差在哪?
第一代是 308M 的純文字模型,基於 Gemma 3,上下文 2K token;第二代基於 Gemma 4,加入視覺與音訊編碼器,上下文放大到 8K token,程式碼檢索分數從 68.76 提升到 78.68,而且純文字負載反而從 300M 級降到 270M,授權也改為更寬鬆的 Apache 2.0。
什麼時候用 270M 配置就夠?
只做文字與程式碼的搜尋、RAG 或知識庫檢索時,270M 已包含所需模組,不必載入視覺與音訊編碼器。官方量化配置在 Pixel 11 Pro 的文字權重約占 191MB 活躍記憶體。它與全模態配置共用同一個向量空間;在相同模型權重、任務前綴與輸出維度下,只增加編碼器不必重算既有文字向量。
在 Hugging Face 和 Ollama 上怎麼下載?
Hugging Face 上搜 google/embeddinggemma-2,用 sentence-transformers 或 transformers 載入;Ollama 則執行 ollama pull embeddinggemma-2,之後用 /api/embed 或客戶端的 embed() 方法取向量。Ollama 的 270M 標籤下載量約 378MB,全模態 1.3GB。
EmbeddingGemma 2 可以完全離線使用嗎?
可以。權重下載完成後,嵌入計算全部在本機執行,在支援的執行環境中不需要連線或雲端 API 金鑰。把它配上 Gemma 4 當生成層,可以組成完全離線的檢索問答管線,適合會議錄音、內部文件這類資料不能外送的場景。
EmbeddingGemma 2 支援中文嗎?
支援。官方標示理解 100 種以上語言,訓練資料橫跨超過 140 種,但各語言表現可能不同。公開模型卡的整體多語言分數不能代替繁中語料評測;應先用自己的查詢與文件測召回品質,再決定是否微調。
需要什麼硬體?手機跑得動嗎?
官方在 Google Pixel 11 Pro 的量化配置中,測得純文字權重約 191MB 活躍記憶體、全模態約 567MB;這些不是每台手機或整個應用的通用用量。MacBook M5 Pro GPU 的每張圖片嵌入約 37.3 毫秒,是每張圖最多 70 個視覺 token 的測量設定。正式產品仍應在目標裝置、輸入長度與執行框架下測速與評估記憶體。
EmbeddingGemma 2 怎麼微調?
官方提供兩條路線:sentence-transformers 的文字與多模態微調指南,適合正式流程;Unsloth 的效率導向文件,用較低記憶體就能快速跑完多輪實驗。建議先固定任務前綴與評測集,再動資料,每輪變因保持單一,分數才有解讀意義。
為什麼不能用 float16 跑 EmbeddingGemma 2?
官方明確警告 float16 會產生 NaN 或無聲的品質退化,可用精度只有 bfloat16 與 float32。結果可能不會拋出例外,卻讓檢索品質退化;如果嵌入結果異常,第一步先檢查推論精度設定。
EmbeddingGemma 2 可以商用嗎?
可以。它採 Apache 2.0 授權,可商用、修改與再散布;再散布時須遵守授權副本、修改聲明及保留適用聲明/NOTICE 等條件。Google 模型卡也要求部署遵守 Gemma 的禁止用途政策。
EmbeddingGemma 2 和 Gemini Embedding 有什麼關係?
兩者出自同一套技術:Google 在公告中說明 EmbeddingGemma 2 與 Gemini Embedding 系列基於相同的研究基礎。差別在 Gemini Embedding 是雲端 API 服務,EmbeddingGemma 2 是開放權重的本地模型,定位在裝置端與隱私優先的場景。

討論與提問