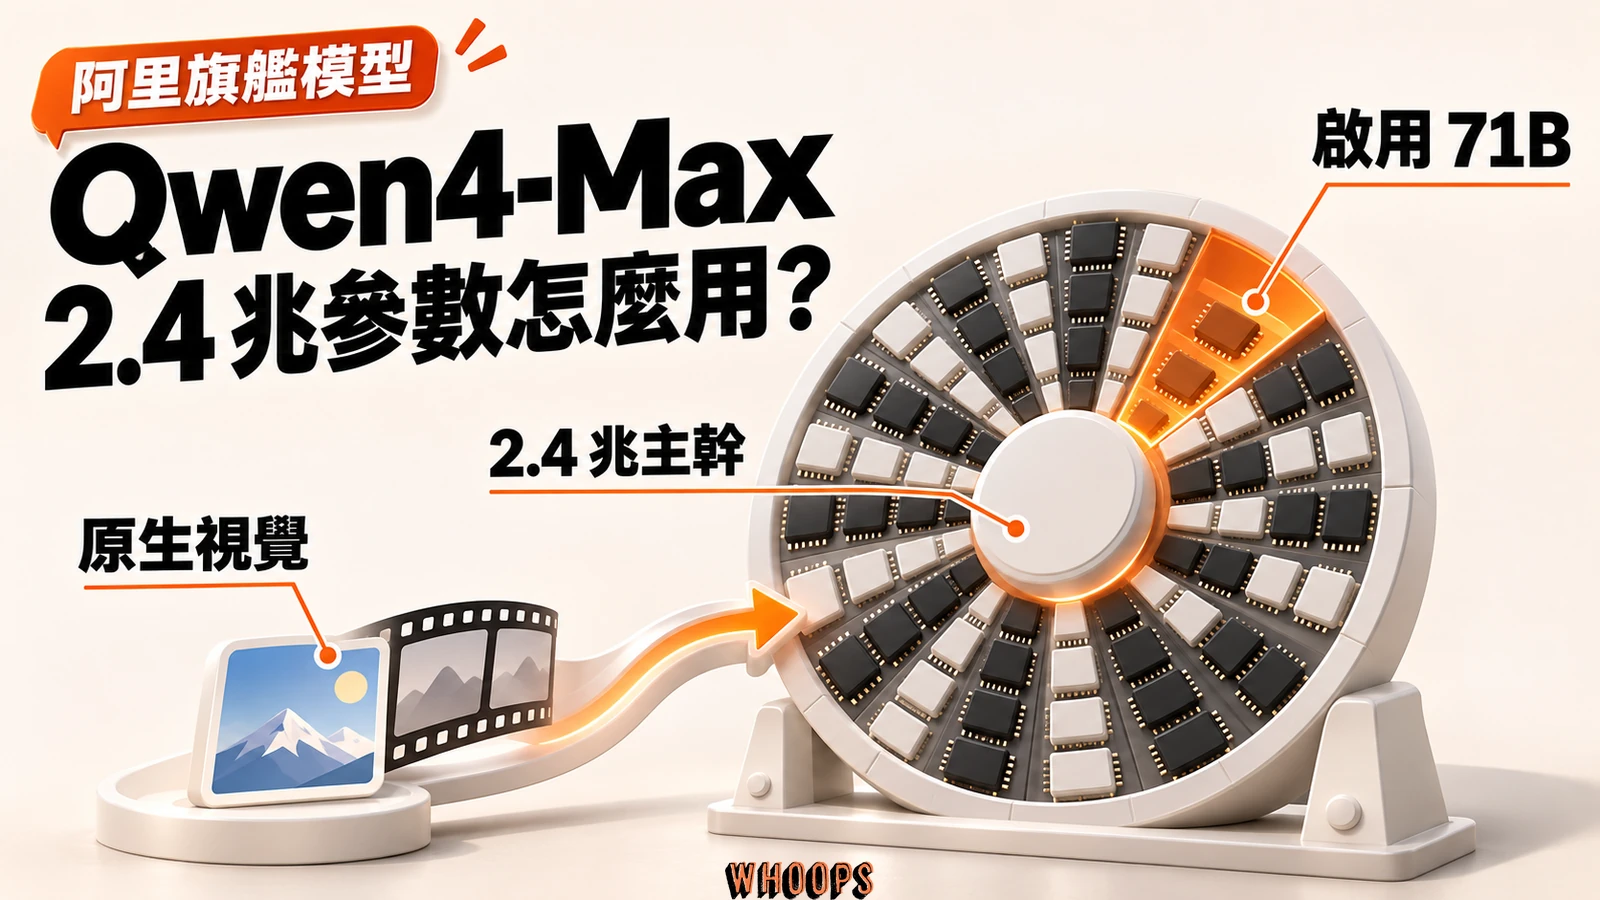
Qwen4-Max 是阿里巴巴在 2026 年 11 月 16 日發布的旗艦多模態模型。它有 2.4 兆主幹參數,採稀疏 MoE 架構,每個 Token 啟用約 710 億(71B)參數。模型可直接讀取文字、圖片與影片,輸出文字,上下文視窗為 100 萬 Token。
台灣開發者可用 Alibaba Cloud Model Studio 新加坡區接入 qwen4-max。每百萬 Token 輸入 1.5 美元、輸出 4.5 美元。可重用的輸入前綴若命中快取,該部分每百萬 Token 為 0.075 美元。偏好包月的團隊可評估 QwenCloud 的 Token Plan。
2.4 兆參數怎麼花:每個 Token 只動用 710 億
Qwen 團隊的發布文把參數分為 2.4 兆(2.4T)主幹、每個 Token 啟用的 71B,以及額外 328B 的 N-gram Embedding。稀疏 MoE 會針對每個 Token 選擇要執行的專家網路,因此啟用參數比同樣採 2.4 兆主幹的 Qwen3.8-Max 少約 25%。
新架構在注意力、殘差與嵌入三個環節升級。每四層之中,三層 Gated DeltaNet 把歷史資訊壓縮成固定大小的狀態,一層 Qwen Sparse Attention 以輕量索引器在區塊粒度挑出相關上下文,長序列的注意力開銷跟著下降。Gated Residual 把殘差流拆成四條平行分支,靠動態讀寫閘門強化跨層資訊流。N-gram Embedding 在第二層以查表方式補上局部 Token 模式的表徵,幾乎不加運算量就擴大模型容量。
328B 的 N-gram Embedding 在第二層用查表補入局部 Token 模式。Qwen 說明,這項設計增加模型容量,額外計算開銷很小。對要估價的團隊,每個 Token 的啟用參數可用來理解架構差異,實際帳單則取決於輸入、快取命中和輸出用量。
2.4 兆規模的預訓練全程沒有出現 loss spike,損失曲線穩定下降,官方把平穩歸功於架構與訓練改善。在知識、程式、問答與 STEM 四類內部評測中,Qwen4-Max-Base 的 BPB(每位元組位元數)是五個受測模型中最低,比 Qwen3.8-Max-Base 低約 5% 至 13%。BPB 是越低越好的基座指標,數字低代表模型對知識的編碼更緊湊,跨領域一致下降比單點高分更有說服力。受測組合包含 GLM-5.3 與 Kimi-K3.1-Pro 兩個後訓練版本,官方註明後訓練會影響與基座模型的比較,其中 GLM-5.3 靠後訓練衝高表現的開放權重路線先前已完整解析過。
| 項目 | 規格 |
|---|---|
| 參數結構 | 2.4 兆主幹;每 Token 動用 71B;另含 328B N-gram Embedding |
| 上下文視窗 | 1,000,000 Token |
| 最大輸入 | 991,808 Token(思考模式 983,616) |
| 最大輸出 | 131,072 Token;思考模式下思維鏈加回答合計 262,144 |
| 輸入輸出模態 | 輸入文字、圖片、影片;輸出文字 |
| 思考強度 | low、high、xhigh 三段,預設 high,thinking_budget 預設 131072 |
| API 介面 | OpenAI Chat Completions、Responses、Anthropic Messages、DashScope |
| 快取 | 顯式與隱式快取,TTL 支援 5 分鐘與 1 小時 |
| 服務區域 | 北京、新加坡、維吉尼亞、法蘭克福、東京、香港 |
| 免費額度 | 新加坡區符合資格的新用戶有 100 萬 Token,效期 90 天 |
原生視覺與百萬上下文能處理哪些資料?
原生視覺是 Max 系列首見的能力,輸入端直接接受圖片與影片,輸出為文字,看懂影像不再需要外接另一套視覺模型。能力矩陣同步列出深度思考、流式輸出、網路搜尋、平行工具呼叫、Function Calling、結構化輸出與前綴補全,顯式與隱式快取也內建,思維鏈支援摘要與加密回傳。
Model Studio 規格表列出各模式的輸入和輸出上限。一般模式的最大輸入為 991,808 Token,最大輸出為 131,072 Token。思考模式的最大輸入為 983,616 Token,思考過程加回答的輸出上限為 262,144 Token。規劃長請求時也要留出回答空間。API 能回傳思維鏈摘要及密文,支援的介面可在多輪對話帶回密文接續推理。
長文件可以先試著在一次請求放入待查內容,再依實際 Token 用量決定是否分段。合約審閱或掃描文件問答可以要求模型對每一項結論列出頁碼或原始段落,讓人工能逐項核對。
Qwen 團隊以一個重症醫療案例展示文字與影像混合輸入。模型在單次對話讀取數十份檢驗單、上萬字病程紀錄與 1,433 張原始影像,把六天病情整理成時間軸。這是廠商報告的單一案例,臨床使用仍需獨立驗證並由專業人員審閱。
法律與金融端走同一套長文件邏輯。預 IPO 盡職調查案例中,模型把客戶分批交付的 198 份格式混亂底稿依實質內容重編歸類為 14 個目錄,主動比對工商登記、智財、司法與信用公開紀錄,交付 86 頁、逾 6 萬字且附底稿引用的報告。投研案例呼叫 90 個 MCP 工具抓取 A 股與港美股等市場資料,產出儲存格可回溯源頭的 Excel 與簡報。
影音創作端與萬鏡一刻合作,走分鏡腳本、靜態資產、白模預演、運鏡渲染到剪輯成片的端到端工作流。知識以文字提示或參考圖注入生成模型,參數化白模鎖住幾何、比例與空間關係,相機路徑與事件時間軸都能精準控制,最終成品因此可預期、可解釋。
長影片可以在同一條 API 裡做重點擷取、逐段摘要和問答。掃描版 PDF 則可把頁面轉成圖片再送出,讓模型看到版面、表格與手寫註記。導入前用實際文件核對頁碼、欄位和數字,尤其是跨頁表格。
從遊戲引擎到汽車產線:官方示範的五種工作
Work360 是 Qwen 自建的產業基準,涵蓋 26 個一級領域、182 個二級子領域與 721 個細分方向。官方報告中,Qwen4-Max 得 52.69 分,前代 Qwen3.8-Max 得 47.74 分,單一任務平均費用由 4.43 美元降至 1.67 美元,減少 62%。在同一基準,xhigh 與 high 的 Token 用量分別少約 24% 和 35%。Terminal-Bench 4.0 的降幅分別約為 48% 與 49%。
Token efficiency and cost: Qwen4-Max outperforms Qwen3.8-Max with fewer tokens.
— Qwen (@Alibaba_Qwen) November 16, 2026
三維創作與遊戲開發是官方著墨最多的示範。Qwen4-Max 能操作 Blender 串起幾何建模、場景搭建、材質與燈光渲染,也能駕馭 Unity、Unreal Engine 與 Godot,從一句自然語言需求做出可安裝的 Android 遊戲,開發途中會實際執行遊戲、依畫面回饋調整鏡頭與打擊感。過去要看到這種成品,得像 Claude Opus 5.5 搭配 Blender 花 16 天做出的 3D 遊戲一樣動用長期專案,這次官方示範則由同一段對話驅動開發流程。
示範作品有三款。Unreal Engine 上的貓法師冒險與御劍飛行關卡展示戰鬥與探索玩法,Unity 6 的西湖主題賽車手遊支援漂移、氮氣與展翼飛行,並直接交付可安裝的 Android 版本。三款都是從自然語言需求出發、跑得起來的完整作品。
製造業案例給出最具體的數字。Qwen4-Max 在三豐智能裝備與統聯精密的產線上,從二維布局圖與製程參數建出三維產線、跑節拍模擬與 PLC 虛擬除錯,單一工件的加工編程人工投入從約 475 分鐘壓到 24 分鐘,減少約 95%,上機前就能從仿真發現過切與少切。
科學案例展示的是長程自主性。模型在深度原理的 Mira 平台連續 48 小時自主工作,從 270 萬個候選分子中設計出新型冷卻液分子,並調度自動化濕實驗室合成出實體樣品。藥物發現案例圍繞阿茲海默症的 NLRP3 發炎小體靶點,累積呼叫工具 454 次、完成 3,239 項計算評估、設計 24 個候選分子,最終分子的名目結合親和力約為專利起點的 3.6 倍。
Qwen 官方發布影片展示模型在工作與創作上的應用。
長任務若等全部做完才交付,方向有誤時就得重做。Qwen4-Max 提供分階段交付,讓使用者提早檢查成果。
Qwen 把分階段交付稱為 Live Delivery。模型先給可用首版,使用者可以在後續版本修正方向。Qwen-Live-Delivery-Plugin 是團隊釋出的外掛,可以用來評估這種工作方式,搭配站內的AI Agent 任務規劃理解工具與人員各自負責的步驟。阿里雲另在自家資源調度案例中回報,資料標註的模型呼叫排程成本平均降低 10.42%,GPU 線上分配的整機閒置容量提升 4.62%,CPU 離線重排的求解速度加快超過 14.61 倍。
API 價格拆解:輸入 1.5 美元、輸出 4.5 美元、快取命中 0.075 美元
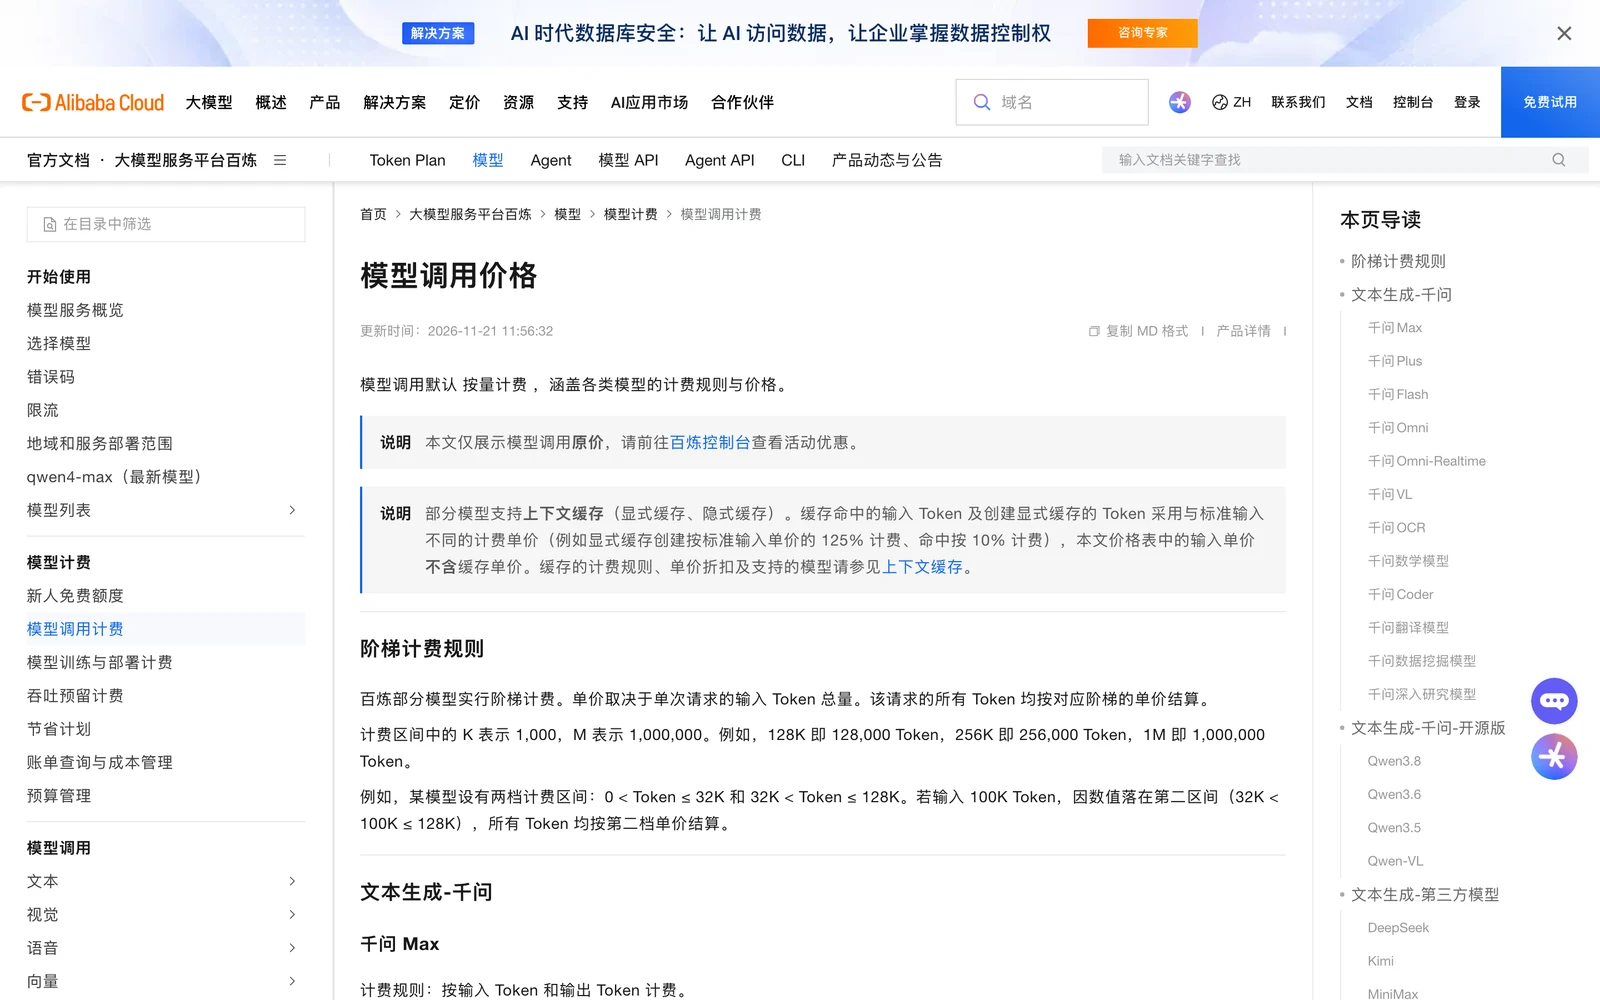
Model Studio 國際站新加坡區每百萬 Token 輸入 1.5 美元、輸出 4.5 美元,兩者都比 Qwen3.8-Max 的 2 美元與 6 美元低 25%。符合資格的新用戶有 100 萬 Token 免費額度,效期按開通、模型發布或申請通過日期中的較晚者起算 90 天。輸出費包含思維鏈與回答。
阿里雲中國站的北京區每百萬 Token 輸入人民幣 10 元、輸出 30 元,前代為 12 元與 36 元。北京區另支援 Batch File,輸入 5 元、輸出 15 元。Batch Chat 的限時半價與到期日以官方費率表為準。
| 計費項 | 國際站新加坡區 | 中國站北京區 |
|---|---|---|
| 輸入 | 1.5 美元 | 人民幣 10 元 |
| 輸出(思維鏈加回答) | 4.5 美元 | 人民幣 30 元 |
| 建立快取,TTL 5 分鐘 | 1.875 美元 | 人民幣 12.5 元 |
| 建立快取,TTL 1 小時 | 3 美元 | 人民幣 20 元 |
| 快取命中讀取 | 0.075 美元 | 人民幣 0.5 元 |
| Batch File 輸入/輸出 | 不支援 | 人民幣 5/15 元 |
| 免費額度 | 符合資格的新用戶有 100 萬 Token(90 天) | 依中國站帳號資格與控制台額度 |
成本結構最大的變化在快取。顯式快取支援在輸入前綴設斷點,前綴至少 1,024 Token,有效期可選 5 分鐘或 1 小時;寫入計價為輸入單價的約 125% 與 200%,命中後的讀取只要 0.075 美元,恰好是輸入單價的 5%。對反覆帶著同一份系統提示與參考文件工作的代理負載,這個數字直接決定月帳單的級距。
系統只為本次請求仍有設定的斷點續期。若改了斷點位置,舊前綴仍可能命中,但舊斷點的有效期不會延長。同一 TTL 下,已有且有效的前綴按讀取計價,新增部分按寫入計價。
假設每次任務輸入 60,000 Token,其中 40,000 Token 命中快取,另輸出 8,000 Token。每日 20 個任務、每月 30 天,共 600 個任務。下表按 OpenAI 標準費率與阿里雲新加坡區費率試算,僅計已命中或無快取的請求,首次寫入及到期後重建需另外計入。
| 情境 | 未快取輸入 | 快取讀取 | 輸出 | 單任務合計 | 月成本 |
|---|---|---|---|---|---|
| Qwen4-Max(40K 命中) | 0.030 | 0.003 | 0.036 | 0.069 | 41.40 |
| Qwen4-Max(無快取) | 0.090 | 0 | 0.036 | 0.126 | 75.60 |
| GPT-6.2 Sol(40K 命中) | 0.040 | 0.004 | 0.080 | 0.124 | 74.40 |
在上述命中率和用量下,Qwen4-Max 的試算月成本由 75.60 美元降至 41.40 美元,減少約 45%。同負載的 GPT-6.2 Sol 按短上下文標準費率計為 74.40 美元。試跑時可記錄回應的快取讀取與寫入 Token,拿實際命中率重算。
新加坡區依 Model Studio 月消費設定三段每分鐘 Token 上限,依序為 500 萬、1,000 萬與 2,000 萬。官方級距分界為 8,000 和 140,000 美元。跨區部署時應另外查目標區域的每分鐘請求數與 Token 上限。
接入實務:四種介面、三段思考強度
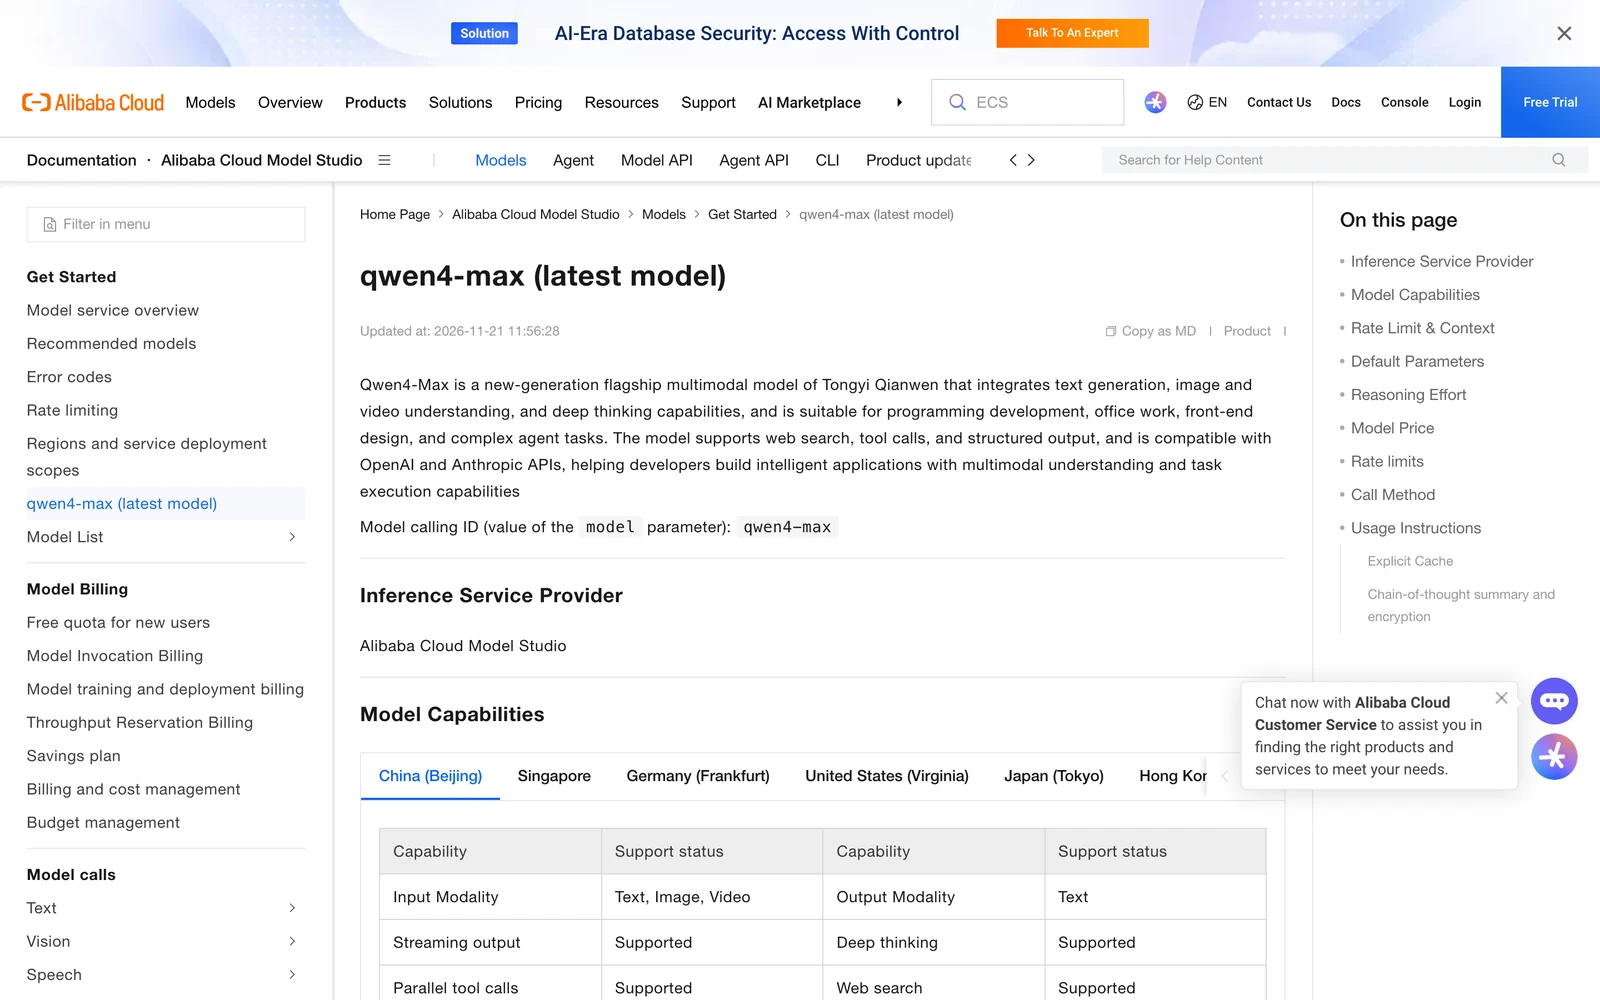
qwen4-max 支援 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages 與 DashScope。沿用 Claude 生態工具時,可以從 Model Studio 的 Anthropic 相容端點開始,切換金鑰後驗證工具呼叫、用量欄位和快取設定。
結構化輸出支援 JSON Object 與 JSON Schema 兩種模式,前綴補全讓固定骨架的請求可以重複利用開頭。流式輸出在四種介面都可用,用量欄位分列輸入、輸出與快取明細,把這些欄位接進成本看板,命中率與單位成本就有即時數字可看。
思考強度有 low、high 與 xhigh,預設 high。Chat Completions 和 DashScope 使用 reasoning_effort,Responses 使用 reasoning.effort,Anthropic Messages 則使用 output_config.effort。Chat Completions、Responses 和 DashScope 也接受 minimal、medium、max,依序對應 low、high、xhigh。模型頁的 thinking_budget 預設為 131,072 Token。
摘要、抽取或格式轉換可從 low 跑一批樣本。跨文件推理或複雜除錯則可以比較 high 和 xhigh 的正確率、延遲與輸出用量。輸出費包含思維鏈,記錄這三項數字才能比較每件任務的成本。
以 OpenAI SDK 的 Chat Completions為例。先在新加坡區建立工作空間,測試文字請求,再逐步加入圖片或影片。
- 註冊 Alibaba Cloud 國際站帳號,綁定信用卡,選新加坡區。
- 開通 Model Studio,在 API Key 管理頁建立金鑰。
- 依控制台顯示的工作空間端點設定 Base URL。官方的新加坡範例是
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1,model 填qwen4-max。 - 先送一個短文字請求,確認回覆與用量欄位。控制台顯示符合資格時,可用 100 萬 Token 免費額度測試工作流。
- 長文件代理開顯式快取斷點,定期看命中率欄位。
限流時以指數退避重試。上線前設定用量告警,留意免費額度用完後的按量費用。
批次推理依區域提供。北京區支援 Batch File 和 Batch Chat,新加坡區目前不支援。需要在離峰批次處理時,先核對資料可用區域與對應費率。
安全表現與資料治理邊界
安全是 Qwen4-Max 發布文著墨極重的一章。軟體工程訓練在功能性檢查外新增程式安全檢測,Last Secure Code Bench 的無安全提示程式重建與功能漏洞雙重檢驗中,函式級功能與安全雙通過率從前代的 22.0% 升到 31.8%,函式、檔案與原始碼庫三種粒度同時產出安全程式碼的比例從 8% 升到 14.7%。注入、記憶體安全與越權存取是改善最大的三類風險。
網路安全與 CBRN 的訓練資料經過用途篩選,保留漏洞驗證、偵測與修復等防禦任務,剔除攻擊用途資料;內部專家審查含完整思維鏈的長程軌跡後,未發現可規模化的網路攻擊能力。治理面以阿里的六項人工智慧發展原則貫穿模型生命周期,倫理聲明同時寫明高影響場景不取代專業判斷,使用圖片與影片需取得當事人授權。
台灣怎麼用:三條入口與付費路線
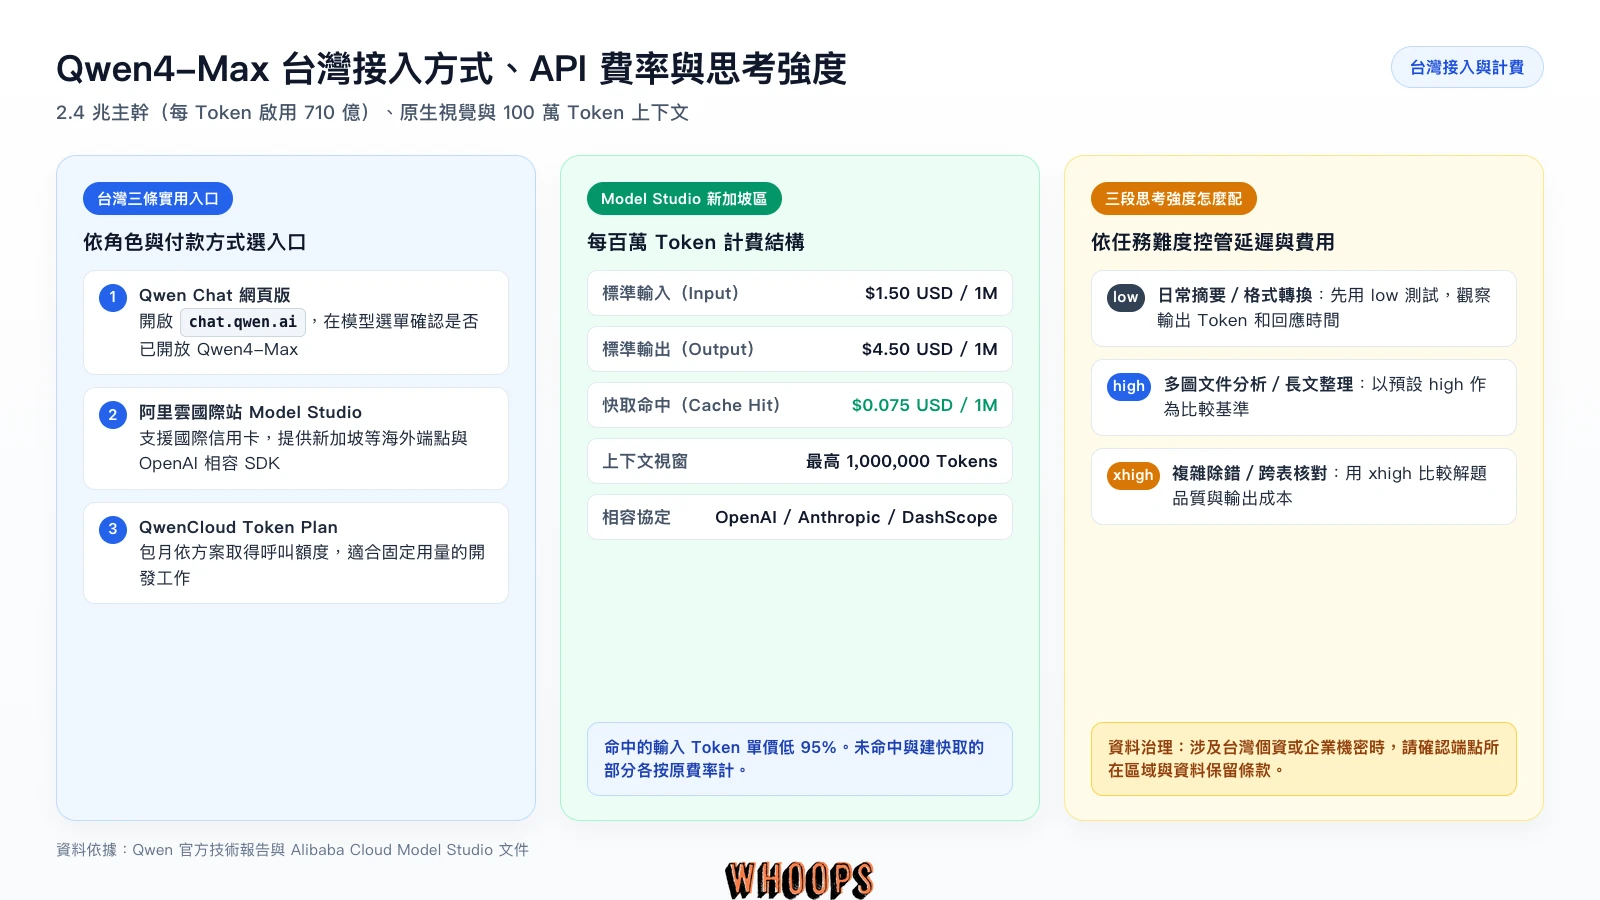
台灣有三個常用入口。試用可先打開 Qwen Chat,登入後確認模型選單是否已開放 Qwen4-Max。固定月用量的團隊可查看 QwenCloud Token Plan。需要整合 API 時,可在 Alibaba Cloud 國際站 Model Studio開通新加坡區,以美元按量計費。11 月 16 日正式版與發布前限 Token Plan 的預覽版是不同模型 ID。
應用端入口官方列了四個:手機的 Qwen App、編碼代理 Qoder、辦公場景的 QwenWork 與開發者沙盒 Qwen Studio。Qoder 與模型層共同設計的關係寫進了發布文,模型、代理框架與產品三層一起調校,這是阿里與多數模型廠不同的耦合深度。Qwen App 與 QwenWork 的開放範圍依市場而異,跨區使用前先查官方公告。
做概念驗證時,先用新加坡區可用的免費額度估算每日用量。用量穩定後,再用實際請求數和快取命中率比較按量計費與 Token Plan。企業若需統編或正式採購文件,開通前先向國際站確認帳務資料。
付款與帳務有兩個實務細節。國際站以信用卡扣款,收據與消費明細可直接在控制台下載;資料處理位置跟著所選區域走,打新加坡區端點,請求就由新加坡的服務回應,合約有資料駐留要求的專案,開通前先與法務確認區域選擇。高敏感文件上傳前做去識別化,是任何雲端模型都適用的前置動作。
與同級旗艦對照:Sol、Kimi、Carbon 怎麼選
以每百萬 Token 比較,GPT-6.2 Sol 的標準 API 費率與 Kimi K3.1 Pro 的標準版價格都是輸入 2 美元、輸出 10 美元。Qwen4-Max 新加坡區是輸入 1.5 美元、輸出 4.5 美元。若應用常輸出長報告或大段程式碼,可先用同一批任務比較各模型消耗的總 Token 和交付品質。
| 模型 | 輸入 | 輸出 | 上下文 | 權重 |
|---|---|---|---|---|
| Qwen4-Max | 1.5 | 4.5 | 100 萬 Token | 閉源,小模型將開源 |
| GPT-6.2 Sol | 2 | 10 | 105 萬 Token | 閉源 |
| Kimi K3.1 Pro | 2 | 10 | 100 萬 Token | 官方預告將開源 |
Kimi K3.1 Pro 官方預告將釋出完整權重,對需要私有部署的團隊是 Qwen4-Max 給不了的選項。Qwen 的籌碼在價格與中文語感,Qwen3.8 開源版又仍可自行部署,兩家等於把開源與閉源的路線分工拉成互補,想要更低單價的中文字模型,DeepSeek V4.1-Flash 的十月改版也值得對照。
Gemini 4 Carbon 的優惠價與開放時程適合用來比較 Google 生態的接入選項。已整合 OpenAI 或 Google 工具的團隊,換模型時還要測試工具呼叫、回傳欄位與既有評測。若工作負載是用 AI 整理公開網站內容,也可參考 Whoops 的 AI 搜尋引用優化服務,核對來源能否被讀取、理解和引用。
評測引用也交代了來源。APEX-Agents 的分數引自 Mercor 排行榜,AA-Briefcase 與 AutomationBench-AA 引自 Artificial Analysis,CodeArena 與 AgentArena 引自 Arena 平台,這份註腳讓自測結果有第三方錨點可以對照。
Qwen 團隊已預告 Qwen4 家族的小尺寸模型會陸續開放權重,實際上架與授權以 Qwen 的 Hugging Face 組織為準。採購前可挑一組自己的長文件、程式和圖文任務,分別記錄正確率、輸出用量和快取命中率,再用同一組輸入比較其他模型。
Qwen4-Max 常見問題
Qwen4-Max 有免費額度嗎?
符合資格的新用戶可在 Model Studio 新加坡區使用 100 萬 Token 免費額度。依官方費率表,90 天效期以開通 Model Studio、模型發布或申請通過三者中較晚的日期起算。可用餘額以控制台顯示為準。
台灣使用需要中國手機號或人民幣付款嗎?
可從 Alibaba Cloud 國際站註冊及設定信用卡付款。Model Studio 新加坡區以美元計價,每百萬 Token 輸入 1.5 美元、輸出 4.5 美元。實際付款條件和收據資訊以帳號所在市場的控制台為準。
Qwen4-Max 會開源嗎?Hugging Face 上找得到嗎?
Qwen4-Max 的權重目前未公開。Qwen Team 預告會陸續開放 Qwen4 家族的小尺寸模型,公開權重與授權條件以 Qwen 官方公告和 Hugging Face 組織上架資訊為準。
Claude 生態的工具能直接換到 Qwen4-Max 嗎?
可以透過 Model Studio 的 Anthropic Messages 相容端點接入。更新 Base URL、DashScope API Key 和模型 ID 後,先測試工具呼叫與用量欄位。思考強度用 output_config.effort 設定,可填 low、high 或 xhigh。
快取要多少 Token 才生效?計費怎麼算?
顯式快取的前綴至少要有 1,024 Token。Model Studio 新加坡區以每百萬 Token 計,建立 5 分鐘快取為 1.875 美元,1 小時為 3 美元,命中讀取為 0.075 美元。每次請求保留最多 4 個有效斷點,每個斷點往前最多查找 20 個內容塊。
已經在用 Qwen3.8-Max,值得換到 Qwen4-Max 嗎?
如果工作需要圖片、影片或長文件,值得以原樣本測試。Model Studio 新加坡區輸入與輸出單價比 Qwen3.8-Max 各降 25%。先比較任務成功率和 Token 用量,再決定是否切換。
支援微調或私有部署嗎?
Model Studio 的能力表將 Qwen4-Max 的微調與模型部署列為不支援。需要自行部署的團隊可等 Qwen4 系列公開相應權重和授權。批次推理有區域差異,北京區支援 Batch File 與 Batch Chat,新加坡區目前不支援。
討論與提問