DeepSeek App API 讓 deepseek-flash 在對話中搜尋網頁、閱讀指定連結和使用上傳檔案。 DeepSeek 於 2026 年 11 月 13 日公布這批應用 API。要讓模型在回答過程中自行查資料,可宣告內建工具。若要控制查詢、排序和快取,可直接呼叫 Search、Fetch 與 OCR。語音則由 ASR 轉寫、TTS 朗讀。
自 11 月 18 日中午起,DeepSeek 內建搜尋與開頁按模型 Token 計費。獨立的 Search 與 Fetch 各為每千次成功請求 0.75 美元,檔案解析和語音另按頁數、字元或音訊長度收費。下方列出三種聊天協定、工具的啟用條件,以及每天 1,000 則語音提問的月費試算。
DeepSeek App API 支援哪三種通訊協定?
應用工具目前透過 DeepSeek-V4.1-Flash-1017 提供,請求的模型名稱填 deepseek-flash。Messages 相容 Anthropic 格式,Responses 與 Chat Completions 採 OpenAI 相容格式。啟用內建工具後,DeepSeek 服務端負責工具呼叫與上下文組裝,客戶端處理回傳內容和引用顯示。
DeepSeek 在官方貼文也列出這次開放的功能,並附上可匯入對話紀錄的開源範例。
The full DeepSeek App experience, now via API
— DeepSeek (@deepseek_ai) November 13, 2026
模型規格沿用既有版線:1M Token 上下文、最大輸出 384K、帳號併發上限 2,500,舊名 deepseek-v4-flash 與 deepseek-v4-flash-vision-exp 仍被接受,但底層已改由 V4.1-Flash-1017 供應並按 Flash 牌價計費。這個模型的改版內容與跑分細節,可對照先前整理的DeepSeek V4.1-Flash-1017 完整解析。
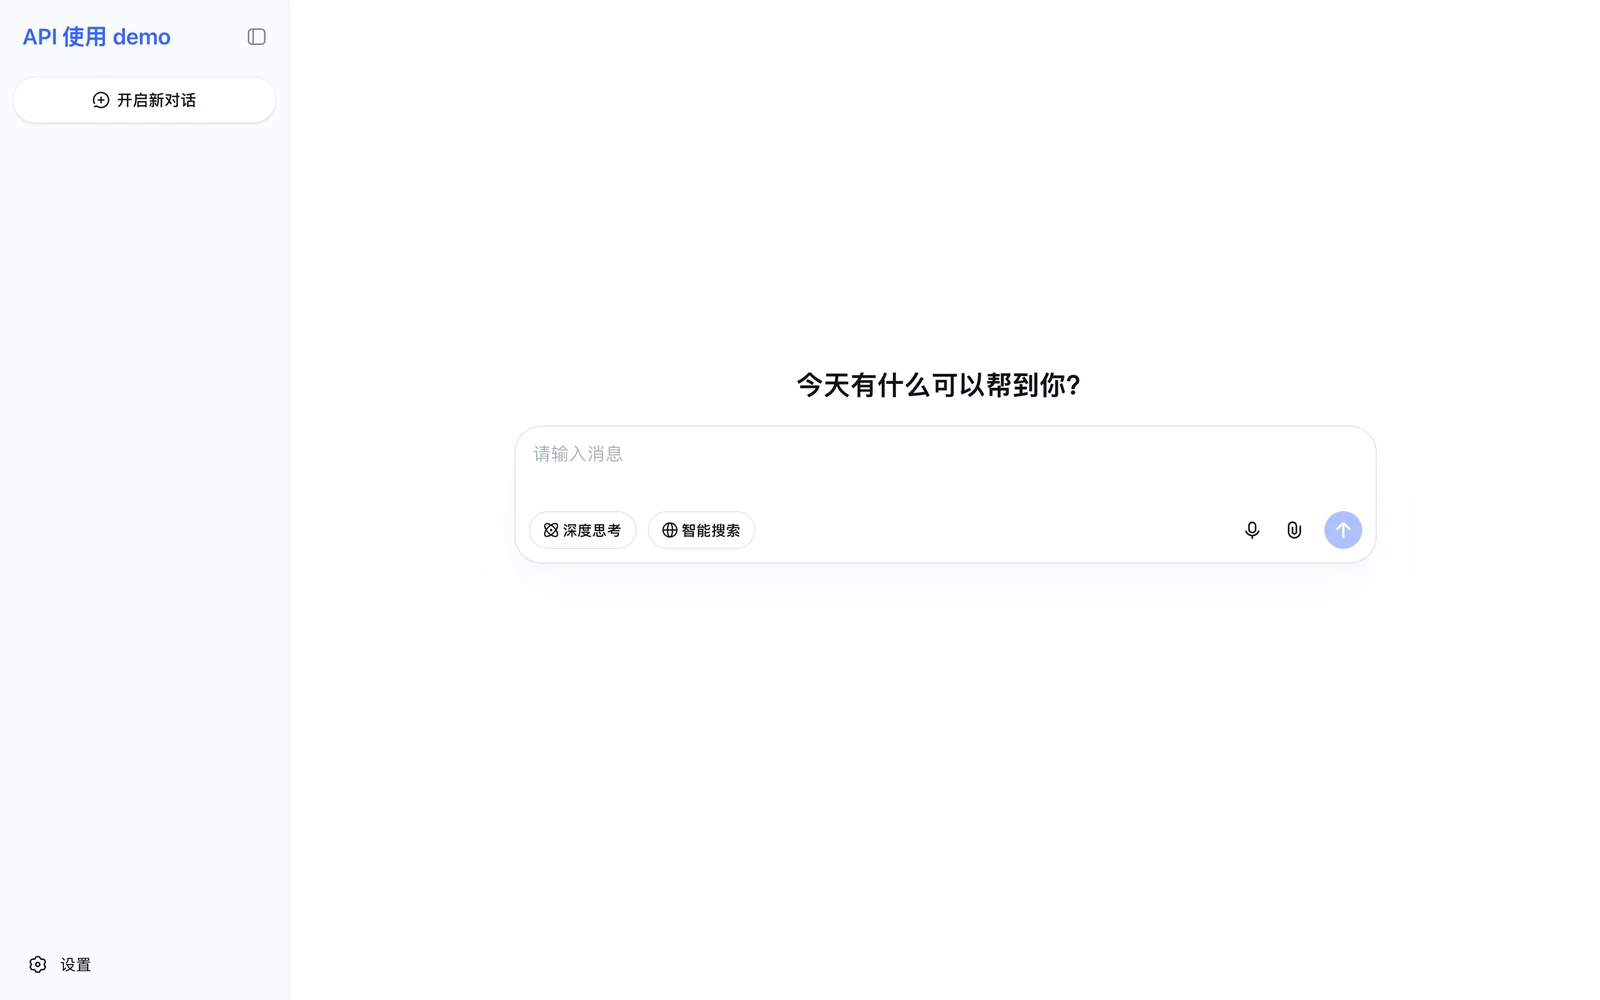
可在官方 Chat Demo 的設定頁填入 DeepSeek API Key。開源範例的原始碼也包含匯入 DeepSeek Chat 匯出紀錄的功能。範例將金鑰和對話資料存於本機瀏覽器,工具請求仍會送到 DeepSeek API。
兩個收尾用的小參數也一併開放。title 設為 enabled 時,模型會跟著答案寫出一段短標題,供對話列表顯示,回應最多多等 5 秒等標題送達,不另計費,官方建議只在對話的第一則請求開啟。使用者中繼標記則把當前日期與使用者所在位置、語言傳給模型,問天氣或時效性問題時,答案會對準使用者所在的時區與地點。
| 通訊協定 | 端點 | 相容格式 |
|---|---|---|
| Messages | https://api.deepseek.com/anthropic/v1/messages | Anthropic |
| Responses | https://api.deepseek.com/responses | OpenAI Responses |
| Chat Completions | https://api.deepseek.com/chat/completions | OpenAI Chat |
Web search 與深度思考搜尋:宣告工具即啟用
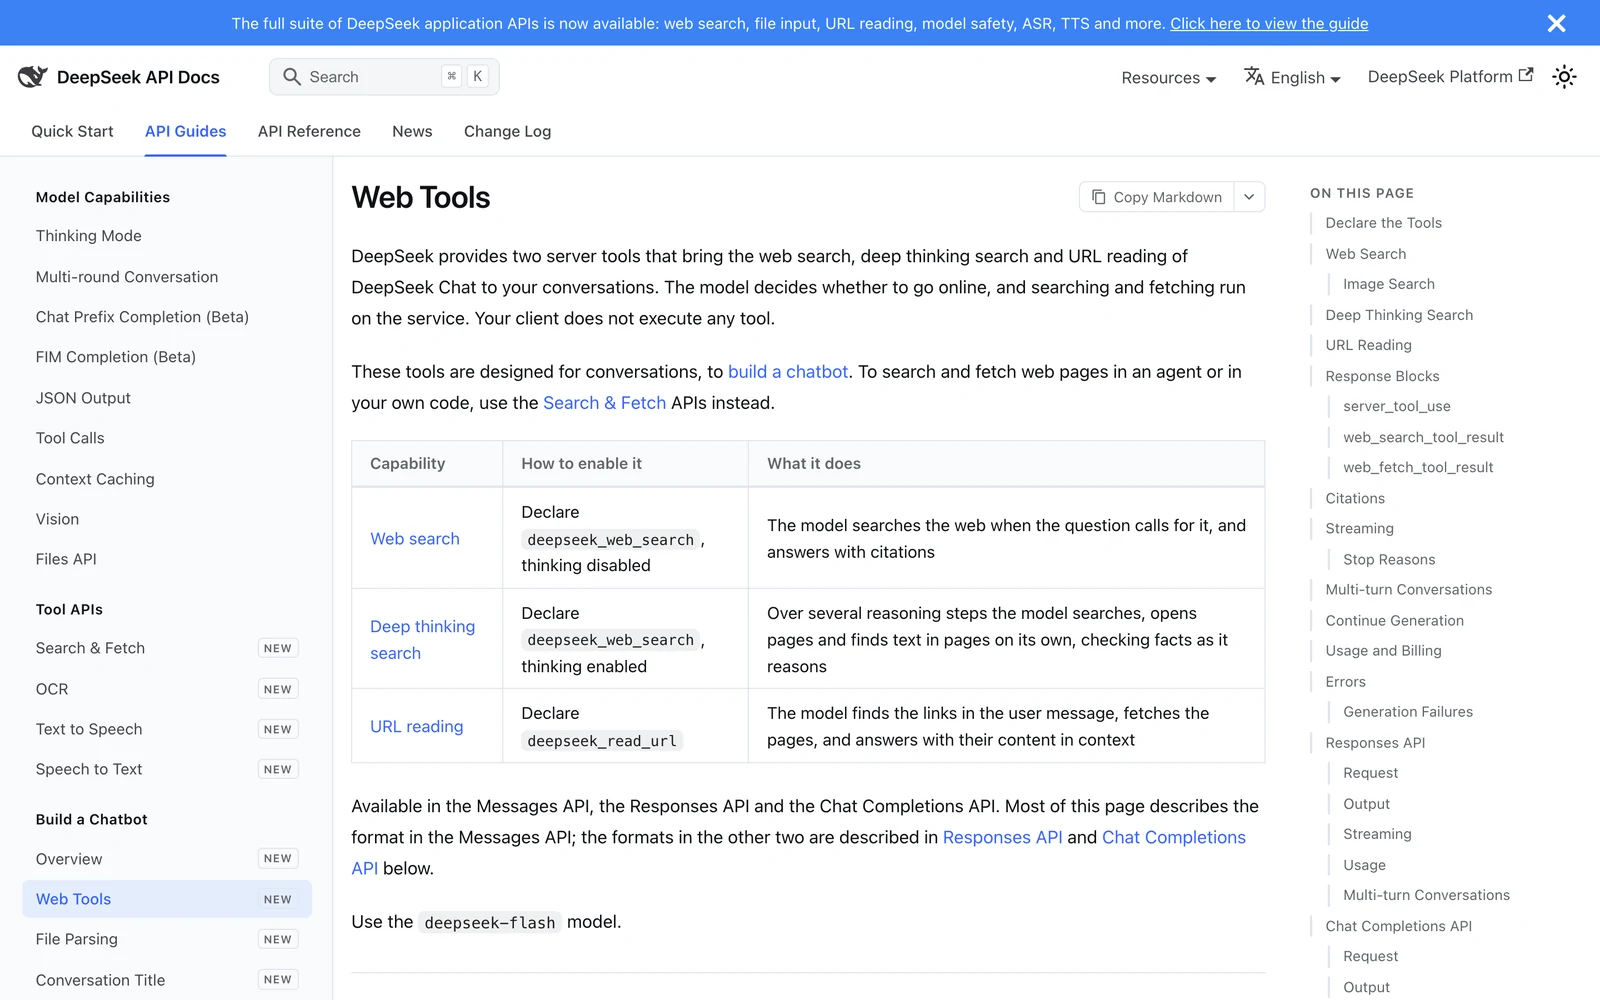
在 tools 宣告 deepseek_web_search 後,思考模式會決定搜尋方式。依官方 Web Tools 指南,關閉 thinking 時,模型按需發出網路搜尋並在回答附上引用。開啟 thinking 時,模型可在同一輪中多次搜尋、開頁與在頁面內找字,約可發出 20 次工具呼叫。
圖片搜尋也由 deepseek_web_search 提供。使用者訊息含圖片時,模型可用圖找圖。一般模式的 kind 是 image_search,深度思考搜尋則是 deep_image_search。結果可以附上原始網站的 image_url,前端需處理圖片失效或未提供的情況。
官方文件以查詢冰島人口示範一般網路搜尋。這次請求送出兩組查詢並回傳三筆結果,答案帶引用,共用 1,905 個輸入 Token 和 72 個輸出 Token。短題先用一般搜尋,只有需要開啟多個頁面核對的題目再啟用深度思考搜尋。
tool_choice 設為 none 會關閉內建搜尋及 URL 閱讀。直接在 tool_choice 指定其中一個內建工具會回 HTTP 400。宣告內建工具、把 safety_check.level 設為 high 或開啟 title 時,服務端會忽略 temperature 和 top_p 等取樣參數。max_tokens 限制單一推理步驟的輸出,整輪用量要讀最後的 usage。
串流回應由幾種內容區塊組成:thinking 對應可折疊的思考面板,server_tool_use 搭配 web_search_tool_result 對應一次搜尋步驟,答案的 text 區塊帶 citations 引用標記。usage 裡另附 web_search_requests、tool_search 等服務端工具用量欄位,對帳很方便。多輪對話要把前一輪回覆原樣傳回,搜尋結果與思考內容不會進入後續輪次的上下文,只有答案文字會。
收尾狀態有三種,前端都要接。end_turn 代表答案完整;max_tokens 代表輸出被切斷,或搜尋與閱讀後上下文耗盡;refusal 代表內容審查攔下回應。搜尋期間串流只送 keep-alive 註解,非串流請求會先收到換行字元再等 JSON 本體,用戶端與中間代理的逾時要按這個節奏放寬,message_start 裡的用量只涵蓋第一個推理步驟,最終帳要看 message_delta。
引用標記的渲染規則前端要先知道。引用隨 citations_delta 事件掛在所在文字區塊上,一個區塊的引用屬於該區塊自己的文字,同一個網址在同一區塊最多出現一次,被引用的文字是答案本身而非來源引文,引用回傳時會被服務端忽略。歷史對話裡帶有工具區塊的紀錄,也能直接送進沒有宣告這些工具的請求,整理對話存檔時不必先剝掉工具區塊。
在這種聊天整合中,模型會決定何時搜尋、開頁及引用。應用程式要處理串流、引文與工具錯誤。若還要讓系統使用自訂工具或管理工作步驟,可接著看AI Agent 如何協調模型、工具和權限。
URL 閱讀:只看最後一則訊息,前 10 個連結為限
deepseek_read_url 負責 URL 閱讀,對應 App 裡貼連結就能問的體驗。服務只檢查最後一則使用者訊息裡的網址,重複網址只算一次,最多取前 10 個不同網址,哪些要讀由模型決定,宣告這個工具後使用者訊息裡的連結會被抓進來當回答素材。
它與深度思考搜尋互斥。thinking 開啟且宣告了 deepseek_web_search 時,該輪走深度搜尋,不再逐一讀連結;連結閱讀只發生在 thinking 關閉,或只宣告 deepseek_read_url 的場合。同一輪讀多個頁面時每頁分到的篇幅變少,長頁面會被截斷,關鍵資料放在愈前面的頁面愈保險。
URL 閱讀區塊把頁面文字加密後放在 signature,另提供網址、標題和發布日期供顯示。多輪對話要原樣傳回該區塊,服務端才會恢復頁面內容。簽名無效時,請求仍可成功,該頁內容會略過。頁面未通過安全審查會回 url_not_allowed,頁面不可達可能回 url_not_accessible,未完成的工具呼叫則回 unavailable。
檔案輸入:purpose 決定模型看不看得到圖表
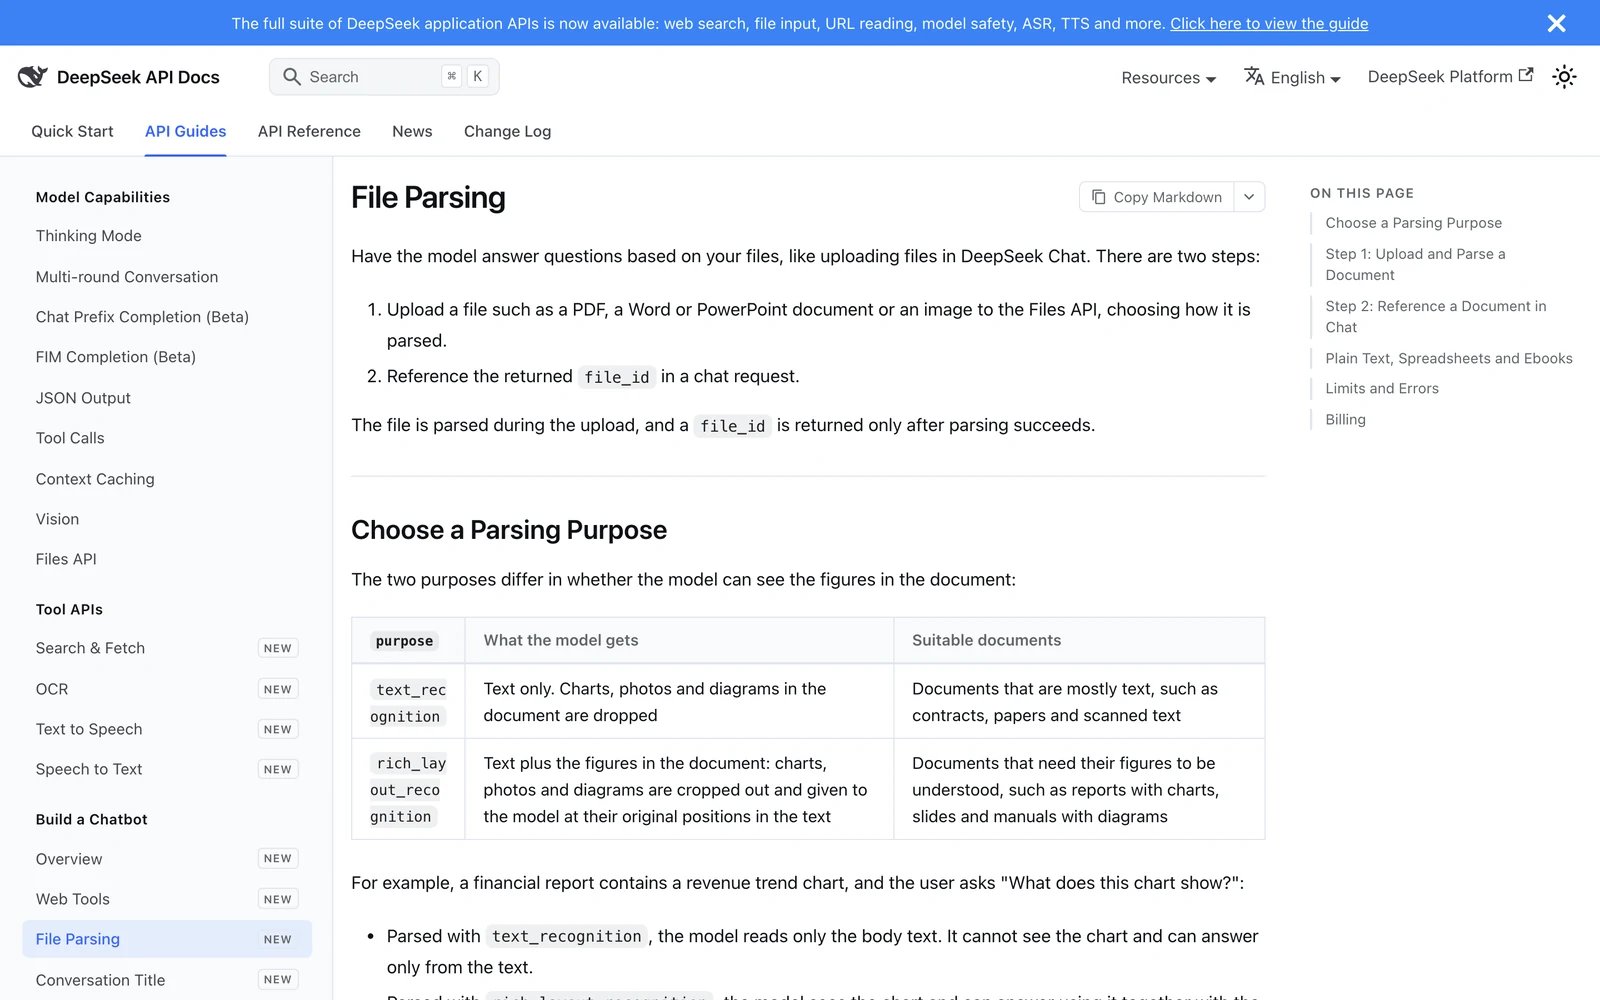
檔案輸入走兩步:先把 PDF、Word、PowerPoint 或圖片以指定 purpose 上傳到 Files API 進行解析,成功後拿到 file_id,再在三種協定的聊天請求裡引用。兩種 purpose 的差別在圖表:text_recognition 只取文字,圖表、照片與示意圖全部丟棄;rich_layout_recognition 會把圖表裁切出來,連同原始位置一起餵給模型。
官方給的例子是財報:問這張圖顯示什麼,用純文字模式解析時模型只讀得到正文,用 rich layout 模式才看得到營收趨勢圖。裁切由服務自動偵測,不保證每張圖都被切出來,切出來的圖會計入每則請求的圖片數上限,不需要看圖就選純文字,省 Token 也省限制。
兩個細部限制容易踩到。以這兩種 purpose 上傳的文件不能當圖片用,放進 image 區塊會回 HTTP 400;開啟安全審查後,rich layout 裁出來的圖片會像請求裡其他圖片一樣送審,沒過的照樣觸發拒答。文件只能靠 file_id 引用,把檔案內容或檔案網址直接塞進請求都不支援。
純文字檔、試算表與電子書不必解析:purpose 設 user_data 上傳,XLSX、XLS、EPUB、MOBI 會在上傳時轉成 Markdown,原始檔上限 32 MiB、內文上限 8 MiB,這類上傳不計費。需要解析的文件上限是 100 MiB 與 1,000 頁,單一請求最多引用 20 份文件、合計文字 8 MiB,超限直接回 HTTP 400,文件不會被靜默截斷。
計費發生在上傳那一刻,按頁數計一次,解析失敗不收費,之後每次引用只按模型輸入價計 Token,不會重複收解析費。跨輪對話裡,被引用文件的完整解析內容會一直留在上下文,上下文裝不下時請求直接回 400,文件不會被偷偷截斷,長文件要自己規劃分批問答的節奏。原始檔與解析結果都不能下載,備份要自己留本機副本,Messages 協定引用文件要加 anthropic-beta: files-api-2025-04-14 標頭,漏了會被拒。
對外服務如何處理 safety_check 與拒答?
DeepSeek 要求對外提供服務的應用啟用安全審查。在請求中把 safety_check.level 設為 high,服務會檢查輸入和輸出。檢出高風險內容時,可能回 HTTP 400 的 Content Exists Risk,或在生成過程以 refusal 收尾。各地適用的審查、登記和生成內容標示義務仍由服務提供者評估。
refusal 的收尾形式依協定不同:Messages 回 stop_reason 為 refusal,Responses 回 status 為 incomplete 加 content_filter,Chat Completions 回 finish_reason 為 content_filter。串流模式下已送出的文字收不回來,用戶端收到 refusal 要自行把畫面上的答案換成拒答訊息,回應也不會說明具體拒絕原因,只能從被擋圖片的路徑提示反推。
帳務上,安全審查的 Token 按輸出價計費,金額反映在 safety_tokens 欄位;輸入端審查沒過、請求回 400 時,輸入 Token 仍按快取命中價計費。宣告了網搜工具但沒開 safety_check 的請求也可能以 refusal 收尾,風控與工具是兩條獨立的線,開了審查不代表工具被限縮,反之亦然。圖片沒過審時,回應會直接點名被擋的圖片位置,例如 messages.1.content.0,位置訊息出現在 Messages 的 stop_details.explanation、Responses 的 refusal 內容與 Chat Completions 的 message.refusal,除錯時按協定對應欄位找。
語音雙向:TTS 朗讀與 ASR 轉寫
TTS 有全文與串流兩種模式:全文模式 POST 到 /v1/tools/tts,整段文字放 JSON 送上、音訊串流回來;串流模式走 WebSocket,文字可以分塊送,模型還在生成時就能邊送邊出音,適合邊生成邊朗讀的產品形態。聲音有 stella(女聲,預設)與 tide(男聲)兩種,沒有語言參數,語言從文字自動判斷,支援華語、英語等十種語言,粵語、日韓語與東南亞語系都涵蓋。
輸出格式為 wav,或 24kHz 的 16 位元單聲道 pcm,WebSocket 另有 opus 可選;filter_markdown 預設開啟,會先剝掉 Markdown 格式再朗讀。音訊合成途中失敗時回應會被切斷,收到比預期短的音訊要當失敗處理,WebSocket 工作階段 60 秒沒收到文字就結束,期間伺服器每 25 秒發一次 ping。
ASR 會把收到的整份音檔轉成文字,一次回傳轉寫與 duration_ms。輸入支援 16 位元 PCM WAV 或 Ogg Opus,WAV 有 8,000 Hz 到 48,000 Hz 共七種取樣率。官方列出 21 種語言,包括中文、粵語、英文、日語與韓語,語言由服務辨識,帳號最多同時處理 50 個請求。
| 項目 | TTS | ASR |
|---|---|---|
| 模式 | 全文 HTTP、串流 WebSocket | 整檔上傳,不支援串流 |
| 語言 | 10 種,從文字自動判斷 | 21 種,從音訊自動判斷 |
| 聲音或聲道 | stella 女聲(預設)、tide 男聲 | 立體聲只辨識左聲道 |
| 輸出或輸入格式 | HTTP 用 WAV 或 PCM,WebSocket 用 PCM 或 Opus | 16 位元 PCM WAV、Ogg Opus |
| 計價單位 | 計費字元(中文字算 2) | 音訊秒數,不滿 1 秒算 1 秒 |
語音來回的產品形態,與全雙工語音對話的GPT-Live是兩種做法:DeepSeek 走辨識加合成兩段式,斷句、輪替與延遲控制權都在你自己的管線裡,要更像真人通話,就得自己補中斷搶話與情境判斷這層邏輯。
獨立工具 API:Search、Fetch 與 OCR 給自建管線
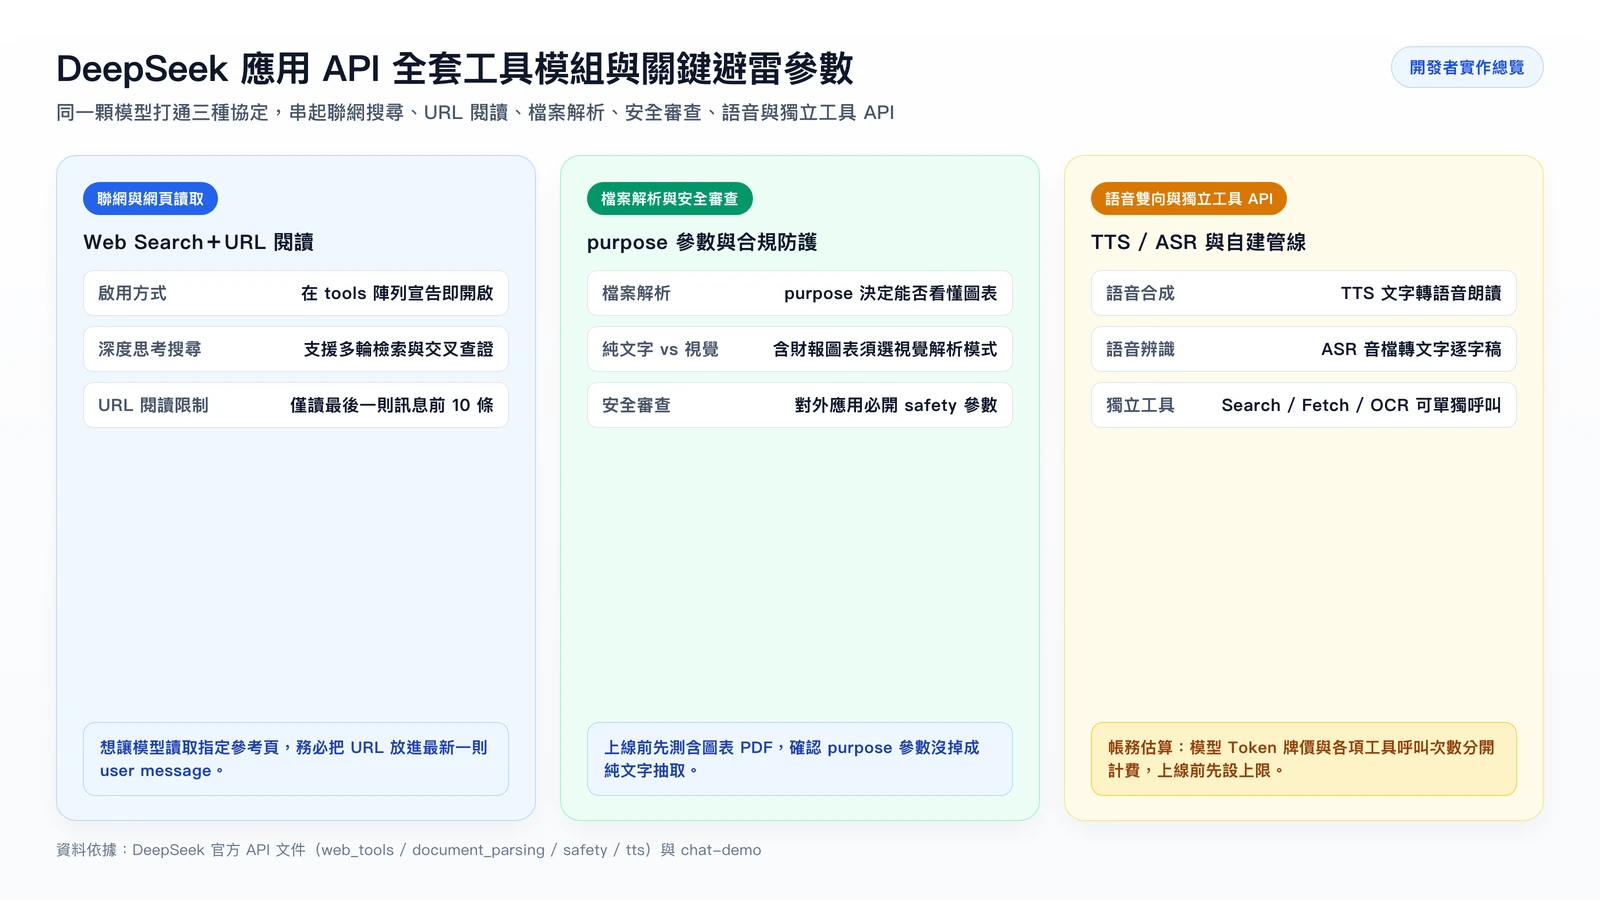
內建工具服務對話,獨立 API 服務程式。Search 與 Fetch API 的端點在 /v1/tools/search 與 /v1/tools/fetch,用同一把 API key 的 Bearer 驗證,搜尋引擎為 DeepSeek 自研。Search 查網頁回結構化結果,Fetch 抓單一頁面轉成 Markdown,回傳欄位含標題、本文與發布時間,進向量庫前幾乎不用再寫清洗器,這組合是代理與 RAG 應用取活資料的基本零件,查詢、排序與快取策略都由你決定。
Search 的查詢支援 site:、排除詞、精確片語、lang:、after:、before: 等算子,結果筆數 1 到 50 筆,need_content 打開才附頁面本文。請求可帶上使用者的原始問題提升查詢理解,也可傳一個 IP 位址讓結果在地化,查在地商家或區域新聞時很實用。每筆結果帶 rerank_score(0 到 3,1.5 以上算高品質)與 authority(0 到 4,3 以上算高權威),做來源篩選很直接;Fetch 的網址上限 8,192 字元。Search API 目前不支援圖片搜尋,圖搜仍只在內建工具裡有。
OCR API 把 PDF、Office 文件與圖片逐頁轉文字,端點 /v1/tools/ocr,同樣有 text_recognition 與 rich_layout_recognition 兩種 purpose,檔案上限 100 MiB、1,000 頁。識別結果保留 ref 與 box 座標特殊標記,座標按頁面寬高正規化到 0 至 1000,可以自己定位文字位置與裁切圖片,帳號同時識別中上限 15 個。
選內建還是獨立,看控制權需求。要重現 App 對話體驗就用內建工具,要自組檢索層、接進自己的代理環境(例如DeepSeek Harness這類控制平面)就用獨立 API,兩者的計價單位也不同,帳務面下一節展開。
帳務全貌:Token 牌價、工具計價與每月試算
DeepSeek 官方定價載明,2026 年 11 月 18 日 12:00(台灣與北京同為 UTC+8)起,模型呼叫的內建搜尋與開頁按回傳內容所占的 Token 計費。直接呼叫獨立 Search 或 Fetch API,各為每千次成功請求 0.75 美元。只需取得檢索結果時,可以獨立呼叫工具,省去同一請求的模型推理成本。
| 項目 | 計價單位 | 牌價 | 限時價 |
|---|---|---|---|
| Search API | 每 1,000 次成功請求 | 0.75 | 無 |
| Fetch API | 每 1,000 次成功請求 | 0.75 | 無 |
| 檔案解析與 OCR | 每 1,000 頁 | 0.225 | 無 |
| 文字轉語音 | 每 10,000 個計費字元 | 0.45 | 0.225(半價) |
| 語音轉文字 | 每小時音訊 | 0.116 | 0.058(半價) |
| 計費項 | 離峰 | 尖峰 |
|---|---|---|
| 輸入(快取命中) | 0.003 | 0.006 |
| 輸入(快取未命中) | 0.15 | 0.30 |
| 輸出(含安全審查 Token) | 0.60 | 1.20 |
模型尖峰為台灣時間週一至週五 09:00–12:00 與 14:00–18:00,中國法定假日屬離峰。以官方一般網搜範例的 1,905 個未命中輸入 Token、72 個輸出 Token 計,離峰約 0.00033 美元,尖峰約 0.00066 美元。深度思考搜尋可能多次開頁,實際費用以該輪最後回傳的用量為準。
用一個對外語音客服的情境算每月帳:每日 1,000 則語音提問、每則 18 秒;模型每日 1,000 輪對話,每輪輸入 9,000 Token,其中 4,000 快取命中,輸出 1,600 Token;每輪回覆 200 個中文字朗讀。全按離峰與限時價計,費用從儲值餘額扣,有贈送餘額時優先扣贈送。
| 分項 | 用量與單價 | 每日成本 | 每月成本 |
|---|---|---|---|
| 語音轉文字 | 18,000 秒(5 小時)× 0.058 | 0.290 | 8.70 |
| 文字轉語音 | 400,000 計費字元(40 單位)× 0.225 | 9.000 | 270.00 |
| 模型輸入(快取未命中) | 5.0M Token × 0.15 | 0.750 | 22.50 |
| 模型輸入(快取命中) | 4.0M Token × 0.003 | 0.012 | 0.36 |
| 模型輸出 | 1.6M Token × 0.60 | 0.960 | 28.80 |
| 合計 | 以上五項加總 | 11.012 | 330.36 |
每月 330.36 美元的試算中,TTS 占 270 美元,約為總額的 82%。如果把每則朗讀從 200 字縮到 100 字,其他用量相同,按限時價每月可少 135 美元。把模型批次工作排到離峰,可降低模型 Token 費用。大型語言模型指南說明 Token 和上下文長度如何影響推理。
官方把語音費率標為限時半價,定價頁尚未列出結束時間。若按牌價編列預算,在同樣用量和模型離峰的假設下,TTS 與 ASR 合計每月 557.40 美元,加上模型費用共 609.06 美元。
誰該現在採用:三種已就緒的產品形態
第一種是自建聊天客戶端。官方聊天機器人指南加開源示範已涵蓋網搜、檔案、語音、對話標題與安全審查的完整組裝,訊息編輯、重新生成、續寫、對話改名刪除、Markdown 與 Mermaid 渲染、中英文介面與深淺色主題都做給你了。把 repo 拿來換皮接自己的會員系統,短期就能出內部測試版。對外服務記得開 safety_check 的 high 檔,並把 refusal 處理寫進前端卸載邏輯。
第二種是語音入口的客服與助理:ASR 轉寫、模型回答、TTS 朗讀三段式管線每段有獨立計價與併發上限,TTS 與 ASR 各 50 個進行中請求,做即時通話要自己控制往返延遲與搶話中斷。第三種是把 Search、Fetch、OCR 接進既有代理框架當檢索層,自研搜尋引擎的 rerank 分數與權威分層可直接當來源篩選訊號,模型層再交給 deepseek-flash 或其他後端。
從既有 OpenAI 或 Anthropic 格式的程式搬移時,先更換 base URL、API Key 與模型名稱,再逐項測試內建工具參數、串流欄位和拒答處理。用相同問題比較兩邊的來源、延遲與實際費用,再決定要遷移哪些流量。
上線前先記錄一般搜尋與深度搜尋的實際用量、確認前端能處理各協定的拒答狀態,並測試失敗的檔案解析在帳上如何記錄。若應用需要自訂檢索,可對照Microsoft Web IQ 的搜尋與網頁擷取端點。若你管理希望被搜尋工具找到並引用的網站,AI 搜尋引用與內容優化服務涵蓋可擷取的回答結構與來源標示。
DeepSeek 應用 API 常見問題
DeepSeek App 和 DeepSeek App API 有什麼不同?
DeepSeek App 提供官方的對話介面。DeepSeek App API 可把網路搜尋、URL 閱讀、文件與語音接到自己的產品。API 依 Token、頁數、字元或音訊秒數計價,開發者負責介面、資料留存和對外服務的內容審查。
申請 API key 要付費嗎?有免費額度嗎?
可到 DeepSeek 開放平台建立 API Key。定價頁未列出這批應用 API 的一般免費額度,使用費從儲值餘額或贈送餘額扣抵,有贈送餘額時優先使用。
帶密碼的 PDF 或加密文件可以解析嗎?
不行,檔案解析與 OCR 的錯誤清單都明列開啟密碼的文件無法處理,要先用原密碼解密成一般檔案再上傳,掃描檔也建議先確認沒有夾鎖。AZW3 與有 DRM 保護的電子書同樣不支援,XLSX、XLS、EPUB、MOBI 走 user_data 免解析上傳,上傳時自動轉成 Markdown,純文字檔與原始碼檔也走同一條路,這類上傳全部不收解析費。
TTS 的計費字元怎麼算?
中文字每字算 2 個計費字元,字母、數字與空格各算 1 個,200 個中文字的回覆等於 400 個計費字元,報價與預估要先按這個口徑換算。單次請求上限 10,000 個計費字元、內容 64 KiB,超過就分次送。限時價每萬字元 0.225 美元,一則 200 字回覆的朗讀成本約 0.009 美元,年度預算改按牌價 0.45 美元估一倍。
ASR 一次可以傳多長的音檔?
ASR 單檔上限 8 MiB、時長上限 120 秒,上傳須在 10 分鐘內完成。整檔送出後才回傳文字與音訊毫秒數,更長的音檔需先分段。立體聲只辨識左聲道,若需轉寫右聲道,先將它另存為單聲道。計費以秒為單位,不滿一秒進位。
台灣時間的尖峰時段是幾點?
模型 Token 尖峰為台灣時間週一至週五 09:00–12:00 與 14:00–18:00,中國法定假日除外。其餘時段適用模型離峰費率。TTS 和 ASR 另有官方限時價格,不隨模型尖離峰切換。
上傳後斷線,檔案解析或 OCR 會被取消嗎?
不會,兩者都在服務端跑到底,解析成功就計費並出現在檔案列表,進行中的 OCR 辨識照樣占用帳號 15 個識別名額之一。要避免誤費,上傳前先檢查格式與頁數,解析失敗的文件不收費,修好後重送即可;原始檔與解析結果都無法下載,本機要自留副本,資料留存政策也要自己規劃。
討論與提問